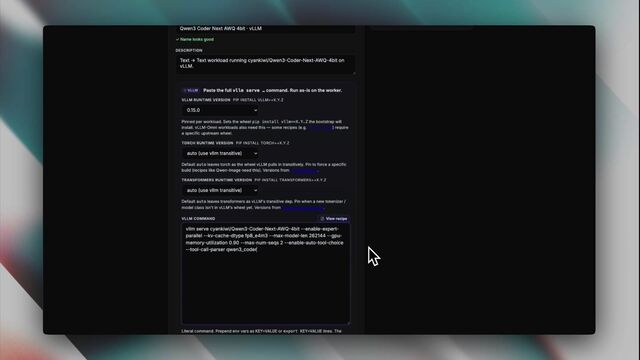
Un ChatGPT privé pour cinquante équipes, et une seule facture à répartir
Comment un assistant d'IA privé sert cinquante équipes via une seule adresse, et comment son coût horaire fixe devient une facture par équipe.
Annonces d'InferenceKey, commentaires sur l'actualité de l'IA et résumés d'articles qui valent la lecture.
Comment un assistant d'IA privé sert cinquante équipes via une seule adresse, et comment son coût horaire fixe devient une facture par équipe.
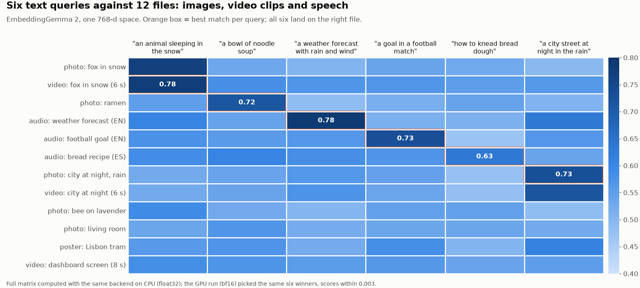
EmbeddingGemma 2 de Google place texte, images, vidéo et audio dans un même espace de recherche. Chargé en 1,4 GB sur notre RTX 2000 Ada de 16 GB.
Kandinsky 6.0 génère des clips de 5 s avec son synchronisé, sous MIT. Minutes par clip sur sept GPU, et pourquoi chaque run publié passe par l'offload.
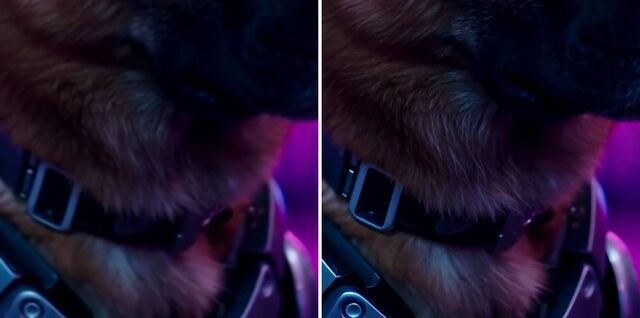
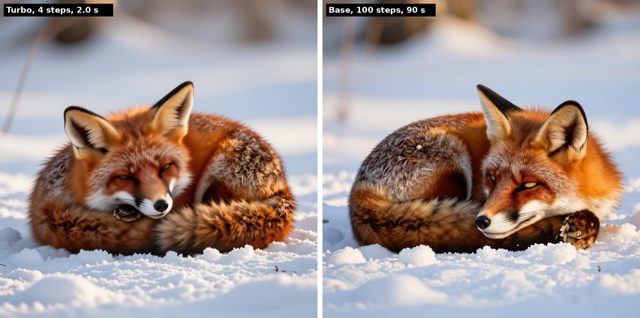
Iris-3B, modèle d'image ouvert, dessine lui-même ses pixels. Nous avons lancé sa version rapide Turbo sur InferenceKey : environ 2 s par image sur une A40.
AREX-2 de BAAI (Apache-2.0) reprend l'architecture de Qwen3.8-27B. Nos runs sglang du modèle de base : VRAM, quants, GPU, et ce qui n'est pas testé.
Qwen3 Coder Next (80B, AWQ 4 bits) sur vLLM, une A100 80 Go à $1.79/h, une clé d'API pour un développeur, Claude Code branché. Commandes, chiffres, limites.