Hy-Nomas garde un monde vidéo stable sur une carte de 24 GB, mais ignore la météo
Hy-Nomas sur une RTX 4090 : 88 à 94 s par tour de 5 s, une scène qui tient sur 3 tours, et 1 changement de scène sur 4 suivi.
Cinq secondes de vidéo, environ quatre-vingt-dix secondes de travail GPU, et un renard qui est toujours le même renard trois appels plus tard. Voilà Hy-Nomas, le nouveau modèle de monde vidéo ouvert de Tencent Hunyuan, qui tourne sur une seule RTX 4090 de 24 GB de notre cloud avec la recette à une carte des auteurs eux-mêmes. Le lancement par défaut demande huit GPU. La version à une carte a fonctionné, avec un pic à 18,5 GiB, et a gardé la scène stable sur trois tours. Il est aussi sous Apache-2.0, libre d'usage commercial. Si vous déployez des modèles, cela veut dire un monde que vous pilotez par texte, appel après appel, sur une carte que vous pouvez louer à l'heure. Ce qu'il ne fait pas encore bien, c'est obéir : un changement de scène sur quatre a abouti. Utilisez-le pour prototyper des scènes qui doivent rester cohérentes d'un tour à l'autre, et testez vos propres prompts avant de compter sur lui pour changer la météo.
Un modèle vidéo qui se souvient de ce qu'il a dessiné
La plupart des modèles vidéo ouverts prennent une consigne, rendent un clip et l'oublient. Hy-Nomas travaille par tours. Chaque tour ajoute cinq secondes à la même scène, avec une nouvelle instruction en texte. Avant de dessiner le morceau suivant, il relit ses notes sur tout ce qu'il a déjà dessiné. Cette mémoire est tout l'intérêt : le personnage, le chemin et la lumière passent d'un appel au suivant.
L'article est paru le 27 octobre, signé par 39 auteurs. Le modèle lit les instructions avec un modèle ouvert emprunté, Qwen2.5-VL-7B. Les poids et le code sont sur Hugging Face et GitHub.
Le téléchargement est plus petit qu'il n'y paraît. Le dépôt complet fait 196 GB, mais la recette à une carte n'en lit que trois parties, environ 35 GB.
La recette à une carte fonctionne, environ 18 fois plus lentement que le temps réel
À côté du lancement sur huit GPU, les auteurs publient une deuxième recette, pensée pour une seule RTX 4090. Elle compresse les grosses parties et les range dans la mémoire principale de la machine, en ne passant chacune sur le GPU que pour son étape. L'article ne donne aucune vitesse pour elle. C'était notre question.
| Monde du renard, une RTX 4090 | Temps GPU | Pic de mémoire GPU |
|---|---|---|
| Tour 1 : le renard suit le chemin | 88,4 s | 17,4 GiB |
| Tour 2 : des fleurs bleues s'ouvrent | 93,1 s | 17,6 GiB |
| Tour 3 : neige, le renard s'arrête | 88,2 s | 17,9 GiB |
Une fois chaud, chaque segment de 5 secondes a pris de 88 à 94 secondes. Si ce rythme tient, un monde d'une minute, c'est douze tours et environ 18 minutes de travail GPU. Le premier appel après un démarrage à froid a pris jusqu'à 138 secondes.
La scène a tenu. Le renard a gardé son pelage, sa taille et sa démarche. Les arbres et la lumière n'ont pas bougé. Dans un deuxième monde, un gardien de phare a gardé son ciré et sa lanterne d'un appel à l'autre. Chaque appel était une requête séparée, à une minute et demie d'intervalle, et le résultat se regardait quand même comme une seule prise.
C'est aussi reproductible. Les mêmes tours avec la même seed ont donné des fichiers vidéo identiques à l'octet près sur quatre exécutions, sur une seule machine. Pour une équipe, un rapport de bug peut contenir les entrées exactes et reproduire le clip exact.
Le pilotage est le point faible : les fleurs oui, la neige et les tempêtes non
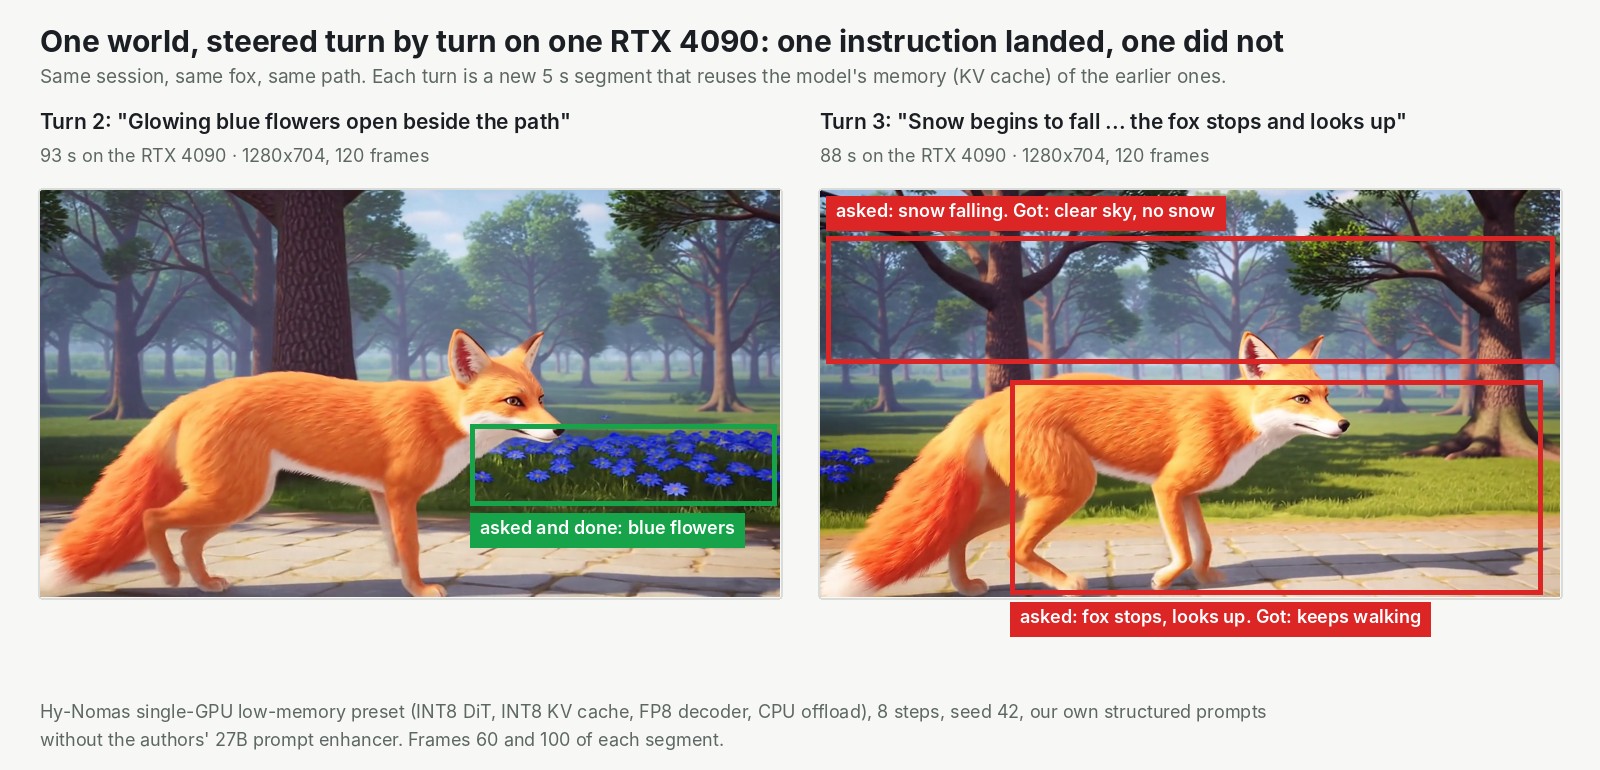
Hy-Nomas a ajouté l'objet que nous avions demandé. Au tour deux, des fleurs bleues sont apparues à côté du chemin pendant que le renard passait. Les changements de toute la scène ne sont jamais venus. La neige n'est pas tombée, même avec une formulation plus appuyée, et la tempête du monde du gardien n'est jamais arrivée. Cela fait un changement de scène sur quatre. Le renard a aussi continué de marcher quand on lui a demandé de s'arrêter et de lever la tête, et le gardien n'a jamais levé sa lanterne.
On aurait dit un groupe qui tient le groove pendant trois morceaux et rate le changement de tonalité annoncé par le chanteur. Une piste : nous avons écrit nos prompts à la main, sans Nomas-PE, le réécrivain bien plus gros que la démo des auteurs passe sur chaque instruction. Nous n'avons pas testé s'il règle la météo, alors prenez ça comme une hypothèse.
Pour qui, et sur quelle carte
Si vous prototypez des scènes, des idées de jeu ou de courtes séquences qui doivent rester cohérentes, essayez-le. Si vous avez besoin du temps réel, cherchez ailleurs. Si vous avez besoin que le modèle obéisse à des changements sur toute la scène, testez d'abord vos propres prompts.
La carte compte plus que d'habitude. Une vraie RTX 4090 de 24 GB a fonctionné, et la même carte limitée à 20 GiB a passé deux tours. Limitée à 16 GiB, elle a manqué de mémoire avant de dessiner quoi que ce soit. Une partie de la recette ne tourne que sur la génération Ada de NVIDIA, la famille de la RTX 4090, donc une RTX 5090 plus récente ou une A40 plus ancienne devrait échouer, même si nous ne les avons pas essayées. La mémoire principale grimpe aussi, environ 5,9 GiB pour chaque tranche de 5 secondes de monde.
Sur notre plateforme, un petit programme sur mesure (notre enveloppe autour du service de génération des auteurs eux-mêmes) a gardé un monde en mémoire entre les appels. Chaque appel envoie un tour et récupère un MP4 de 5 secondes. Cela veut dire qu'une carte sert un monde, et un utilisateur, à la fois.
La limite honnête : nous avons testé deux mondes courts, le plus long de trois tours ou 15 secondes de vidéo, une seed par monde, sans trajectoires de caméra, et le logiciel de notre plateforme tournait sur notre propre serveur, donc le service hébergé lui-même n'est pas testé ici.
Lisez le test complet, avec chaque mesure de temps, l'échelle de mémoire et les correctifs dont nous avons eu besoin, dans l'article Research sur Hy-Nomas.