Sage-A1.5 fait tourner un agent de recherche sur une carte de 24 GB ; laissez son mode de vérification éteint pour les recherches simples
Sage-A1.5 sur une RTX 4090 : 136 tokens/s, une question de recherche juste en 3 essais sur 3, et un mode de vérification qui prend 2,2 fois plus de temps.
Un agent de recherche ouvert, qui découpe une question, envoie des assistants chercher et rédige la réponse, peut-il tenir sur une seule carte de jeu ? Avec Sage-A1.5, oui. Nous avons servi le nouveau modèle de 35B du Shanghai AI Laboratory sur une seule RTX 4090 de notre cloud, avec le fichier compressé des auteurs eux-mêmes et llama.cpp standard. Il écrivait environ 136 tokens par seconde et a bien répondu à notre question de recherche en trois parties lors des trois essais. Chaque appel d'outil est sorti exactement au format dont notre code avait besoin. Si vous déployez des modèles, cela veut dire un agent sous licence commerciale gratuite, sur une carte de 24 GB que vous contrôlez, avec les outils qui tournent dans votre propre code. Un interrupteur demande de l'attention : son nouveau Verification Mode a donné les mêmes bonnes réponses sur les questions faciles, mais a pris 2,2 fois plus de temps et deux fois plus de tokens. Laissez-le éteint pour les recherches simples et testez-le sur vos cas difficiles.
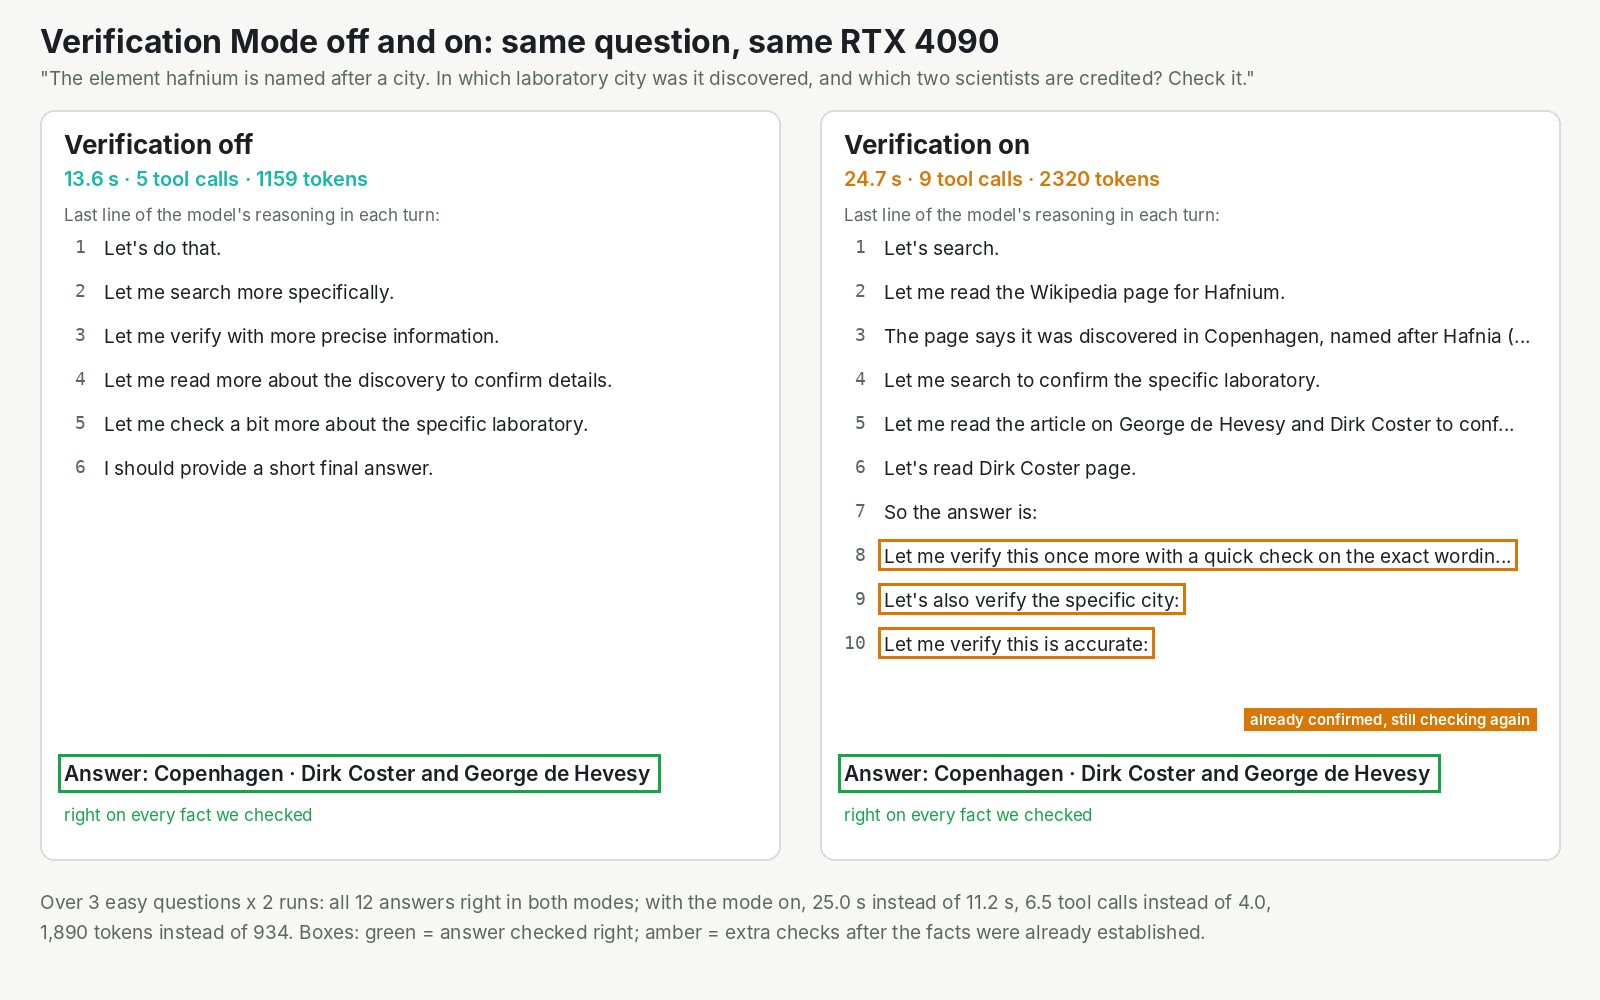
Une question, posée deux fois sur la même carte. Les deux réponses étaient justes. Avec le mode allumé, le modèle revérifiait des faits qu'il avait déjà lus.
Un gros modèle qui travaille comme un petit
Sage-A1.5 est un modèle mixture-of-experts : imaginez 256 spécialistes et un généraliste toujours présent dans la pièce. Pour chaque mot qu'il écrit, il consulte 8 spécialistes pendant que les autres attendent. Ainsi, sur 35 milliards de paramètres, seuls environ 3 milliards travaillent à chaque étape, d'après la page du projet. La vitesse suit les 3 milliards, et la facture de mémoire suit les 35. C'est comme ça qu'il tient sur une carte de 24 GB.
Il a été construit par le Shanghai AI Laboratory à partir de deux modèles antérieurs : le modèle ouvert de 35B de l'équipe Qwen et Agents-A1, l'agent du labo publié en juin. L'article, signé par Wenjie Lou et 98 co-auteurs, est paru le 20 octobre. Le modèle complet et le fichier compressé, d'environ 22 GB, sont tous deux sous Apache-2.0, libres d'usage commercial, sans formulaire à remplir. Le mérite du modèle leur revient. Notre part a été le déploiement, les questions et les outils, et les mesures.
Deux modes, que vous activez vous-même, en font un agent. Agentic Orchestration lui donne un outil pour distribuer des tâches, il peut donc envoyer trois assistants à la bibliothèque en même temps. Verification Mode est une ligne dans ses instructions qui lui demande de vérifier son propre travail avant de répondre.
Ce que notre test a trouvé
La question de recherche était la nôtre : combien d'années se sont écoulées entre les découvertes du hafnium, du rhénium et du technétium. À chaque essai, le modèle a distribué trois tâches en même temps, une par élément. Trois sous-agents ont cherché dans des pages Wikipédia en direct grâce à deux outils que nous avons écrits, puis ont fait leur rapport. Le modèle principal a ensuite rédigé la réponse : 1923, 1925 et 1937, 14 ans du premier au dernier. Juste dans 3 essais sur 3.
Un essai prenait 72 secondes avec le réglage par défaut de notre plateforme, une requête à la fois, parce que les sous-agents faisaient la queue. Avec deux à la fois, il a pris 50 et 56 secondes. Ce réglage par défaut reste à une.
C'est le Verification Mode qui a réservé la surprise. Sur trois questions faciles, posées deux fois chacune, les 12 réponses étaient justes, mode éteint comme allumé :
| Éteint | Allumé | |
|---|---|---|
| Réponses justes | 6 sur 6 | 6 sur 6 |
| Temps moyen | 11,2 s | 25,0 s |
| Tokens écrits en moyenne | 934 | 1 890 |
Le travail en plus, c'était surtout de la répétition : des tours "Let me verify" alors que les faits étaient déjà confirmés. Cela ne contredit pas les auteurs. Ils rapportent que le mode fait passer leur score sur BrowseComp, un test de faits difficiles à trouver sur le web, de 72,5 % à 82,9 %. C'est sur les questions difficiles qu'un second regard paie.
À qui ça s'adresse
- Les équipes qui veulent un agent qui cherche, lit et fait son rapport sur leur propre matériel. Il a tourné sur une seule RTX 4090 à pleine vitesse, en utilisant 21,3 des 23,5 GiB de la carte avec nos réglages.
- Quiconque tient à la précision sur les questions difficiles. Essayez le Verification Mode sur vos propres cas difficiles, pas sur les recherches simples.
- Les équipes qui ont besoin de réponses de chat rapides. Cherchez ailleurs. Une définition de deux phrases a pris 14,4 secondes, parce qu'il a d'abord raisonné sur 1 905 tokens.
- Les équipes sur des cartes de 16 GB ou moins. Attendez-vous à une fraction de la vitesse. Quand nous avons simulé une carte de 16 GB sur la même 4090, il a tourné environ 5,6 fois plus lentement, et il lui faut beaucoup de mémoire centrale.
Sur InferenceKey, il servait 104 secondes après l'appel de déploiement, sur le llama.cpp que notre plateforme fournit déjà. Un accroc se cache dans la fiche du modèle : sa commande utilise un réglage de raisonnement, deepthink, que llama.cpp n'a pas, et le serveur s'arrête au démarrage. Écrivez deepseek à la place. Statut : corrigé dans notre exemple, toujours présent dans la fiche des auteurs.
La limite honnête : nous avons posé une poignée de questions faciles, appuyées sur Wikipédia, un agent à la fois, donc ceci vérifie la mécanique, pas l'étendue de ses capacités de recherche.
Le test complet
L'article Research contient les vérifications sur les longs prompts et la vision, l'échelle de mémoire GPU, les benchmarks des auteurs, chaque point encore rugueux avec son statut et l'exemple SDK qui pose la même question sur votre propre carte. Lisez le test complet de Sage-A1.5 dans l'article Research.