Sage-A1.5 betreibt einen Recherche-Agenten auf einer 24-GB-Karte; den Prüfmodus bei Nachschlagefragen auslassen
Sage-A1.5 auf einer RTX 4090: 136 Tokens/s, eine Recherchefrage in 3 von 3 Läufen richtig und ein Prüfmodus, der 2,2-mal so lange braucht.
Kann ein offener Recherche-Agent, einer, der eine Frage aufteilt, Helfer zum Suchen losschickt und die Antwort schreibt, auf einer einzigen Gaming-Karte leben? Mit Sage-A1.5 ja. Wir haben das neue 35B-Modell des Shanghai AI Laboratory auf einer RTX 4090 in unserer Cloud bereitgestellt, mit der komprimierten Datei der Autoren und Standard-llama.cpp. Es schrieb etwa 136 Tokens pro Sekunde und beantwortete unsere dreiteilige Recherchefrage in allen drei Testläufen richtig. Jeder Tool-Aufruf kam genau in dem Format heraus, das unser Code brauchte. Wenn Sie Modelle deployen, heißt das: ein Agent mit einer kostenlosen kommerziellen Lizenz, auf einer 24-GB-Karte, die Sie selbst kontrollieren, und die Tools laufen in Ihrem eigenen Code. Ein Schalter braucht Vorsicht: Der neue Verification Mode lieferte bei einfachen Fragen dieselben richtigen Antworten, brauchte aber 2,2-mal so lange und doppelt so viele Tokens. Lassen Sie ihn bei Nachschlagefragen aus und testen Sie ihn an Ihren schwierigen Fällen.
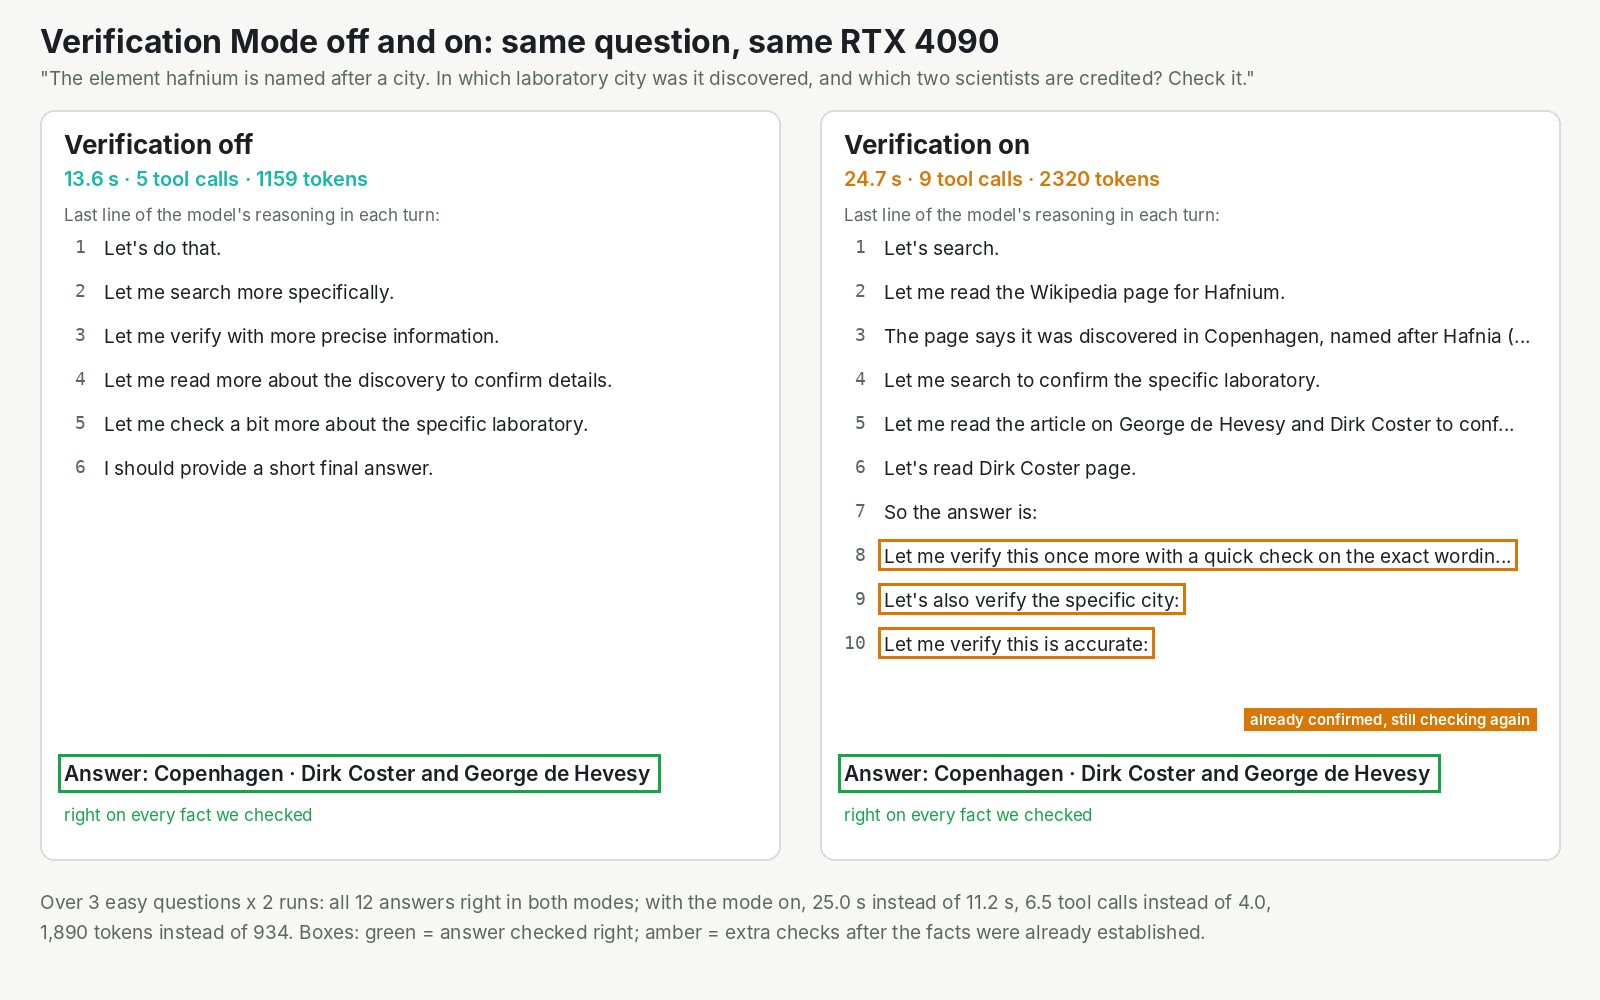
Eine Frage, zweimal auf derselben Karte gestellt. Beide Antworten waren richtig. Mit eingeschaltetem Modus prüfte das Modell immer wieder Fakten, die es schon gelesen hatte.
Ein großes Modell, das wie ein kleines arbeitet
Sage-A1.5 ist ein Mixture-of-Experts-Modell: Stellen Sie sich 256 Spezialisten vor und einen Generalisten, der immer im Raum ist. Für jedes Wort, das es schreibt, fragt es 8 Spezialisten, während der Rest wartet. Von 35 Milliarden Parametern arbeiten deshalb laut Projektseite bei jedem Schritt nur etwa 3 Milliarden. Die Geschwindigkeit richtet sich nach den 3 Milliarden, die Speicherrechnung nach den 35. So passt es auf eine 24-GB-Karte.
Gebaut hat es das Shanghai AI Laboratory aus zwei früheren Modellen: dem offenen 35B-Modell des Qwen-Teams und Agents-A1, dem eigenen Agenten des Labors, der im Juni erschienen ist. Das Paper von Wenjie Lou und 98 Mitautoren erschien am 20. Oktober. Das vollständige Modell und die komprimierte Datei, etwa 22 GB, stehen beide unter Apache-2.0, frei für kommerzielle Nutzung, ohne Formular. Das Verdienst für das Modell gehört ihnen. Unser Teil war das Deployment, die Fragen und Tools und die Messungen.
Zwei Modi, die Sie selbst einschalten, machen es zum Agenten. Agentic Orchestration gibt ihm ein Tool, um Aufgaben zu verteilen, sodass es drei Assistenten gleichzeitig in die Bibliothek schicken kann. Verification Mode ist eine Zeile in seinen Anweisungen, die ihm sagt, seine eigene Arbeit vor der Antwort zu prüfen.
Was unser Test ergeben hat
Die Recherchefrage war unsere: Wie viele Jahre lagen zwischen den Entdeckungen von Hafnium, Rhenium und Technetium? In jedem Lauf verteilte das Modell drei Aufgaben gleichzeitig, eine pro Element. Drei Sub-Agenten durchsuchten live Wikipedia-Seiten über zwei Tools, die wir geschrieben haben, und meldeten sich zurück. Das führende Modell schrieb dann die Antwort: 1923, 1925 und 1937, 14 Jahre vom ersten bis zum letzten. Richtig in 3 von 3 Testläufen.
Ein Lauf dauerte 72 Sekunden mit der Voreinstellung unserer Plattform von einer Anfrage gleichzeitig, weil die Sub-Agenten in der Schlange warteten. Mit zwei gleichzeitig dauerte er 50 und 56 Sekunden. Die Voreinstellung ist weiterhin eins.
Beim Verification Mode lag die Überraschung. Bei drei einfachen Fragen, jede zweimal gestellt, waren alle 12 Antworten richtig, mit ausgeschaltetem wie mit eingeschaltetem Modus:
| Aus | An | |
|---|---|---|
| Richtige Antworten | 6 von 6 | 6 von 6 |
| Durchschnittliche Zeit | 11,2 s | 25,0 s |
| Durchschnittlich geschriebene Tokens | 934 | 1.890 |
Die Mehrarbeit war vor allem Wiederholung: Runden mit "Let me verify", nachdem die Fakten schon bestätigt waren. Das widerspricht den Autoren nicht. Sie berichten, dass der Modus ihren Wert auf BrowseComp, einem Test zu schwer auffindbaren Fakten im Web, von 72,5 % auf 82,9 % hebt. Bei schwierigen Fragen zahlt sich ein zweiter Blick aus.
Für wen das interessant ist
- Teams, die einen Agenten auf eigener Hardware suchen, lesen und berichten lassen wollen. Er lief auf einer RTX 4090 mit voller Geschwindigkeit und belegte mit unseren Einstellungen 21,3 der 23,5 GiB der Karte.
- Alle, denen Genauigkeit bei schwierigen Fragen wichtig ist. Probieren Sie den Verification Mode an Ihren eigenen schwierigen Fällen aus, nicht bei Nachschlagefragen.
- Teams, die schnelle Chat-Antworten brauchen. Schauen Sie sich anderswo um. Eine Definition in zwei Sätzen dauerte 14,4 Sekunden, weil es vorher 1.905 Tokens lang nachdachte.
- Teams mit Karten mit 16 GB oder weniger. Rechnen Sie mit einem Bruchteil der Geschwindigkeit. Als wir auf derselben 4090 eine 16-GB-Karte simuliert haben, lief es etwa 5,6-mal langsamer, und es braucht reichlich Arbeitsspeicher.
Auf InferenceKey lief es 104 Sekunden nach dem Deploy-Aufruf, auf dem llama.cpp, das unsere Plattform schon mitliefert. Eine Unebenheit steckt in der Model Card: Ihr Befehl nutzt eine Reasoning-Einstellung, deepthink, die llama.cpp nicht kennt, und der Server beendet sich beim Start. Schreiben Sie stattdessen deepseek. Status: in unserem Beispiel behoben, in der Card der Autoren noch vorhanden.
Die ehrliche Grenze: Wir haben eine Handvoll einfacher Fragen gestellt, die sich mit Wikipedia beantworten lassen, mit einem Agenten nach dem anderen. Das prüft also die Mechanik, nicht die Breite seiner Recherche.
Der vollständige Test
Der Research-Beitrag hat die Prüfungen mit langen Prompts und Bildern, die Stufen des GPU-Speichers, die Benchmarks der Autoren, jede Unebenheit mit ihrem Status und das SDK-Beispiel, das dieselbe Frage auf Ihrer eigenen Karte stellt. Lesen Sie den vollständigen Test von Sage-A1.5 im Research-Beitrag.