Carbon-X sortiert DNA-Varianten auf einer Gaming-Karte, aber prüfen Sie seine Begründungen
Carbon-X lag bei 40 ClinVar-Varianten zu 75 % richtig, auf einer RTX 4090 mit 24 GB und 8-Bit-Gewichten, in 2,5 s pro Antwort. Die Begründungen oft nicht.
Ein DNA-Modell, das beim Urteil richtig liegt und bei der Begründung falsch, ist trotzdem nützlich, solange Sie wissen, welcher Hälfte Sie trauen können. Genau dort hat unser Test Carbon-X zurückgelassen, das neue offene Modell von Hugging Face, das rohe DNA in einem gewöhnlichen Chat liest und auf Englisch antwortet. Auf einer RTX 4090 mit 24 GB in unserer Cloud, mit auf 8 Bit verkleinerten Gewichten, hat es 75 % von 40 bekannten Varianten aus ClinVar richtig als schädlich oder harmlos eingestuft. Die Autoren berichten 74,9 %. Eine Frage zu zwei Sequenzen mit je 4.096 Buchstaben kam in etwa 2,5 Sekunden zurück. Wenn Sie Modelle für ein Labor oder ein Genomik-Team deployen, ist das ein DNA-Spezialist, der mit einer einzigen Kommandozeile auf Standard-vLLM läuft, auf einer Karte, die Sie selbst kontrollieren, sodass unveröffentlichte Sequenzen Ihre Maschine nie verlassen. Nutzen Sie seine Labels als ersten Durchgang über eine lange Liste. Den Erklärungen, die es drumherum schreibt, sollten Sie nicht trauen.
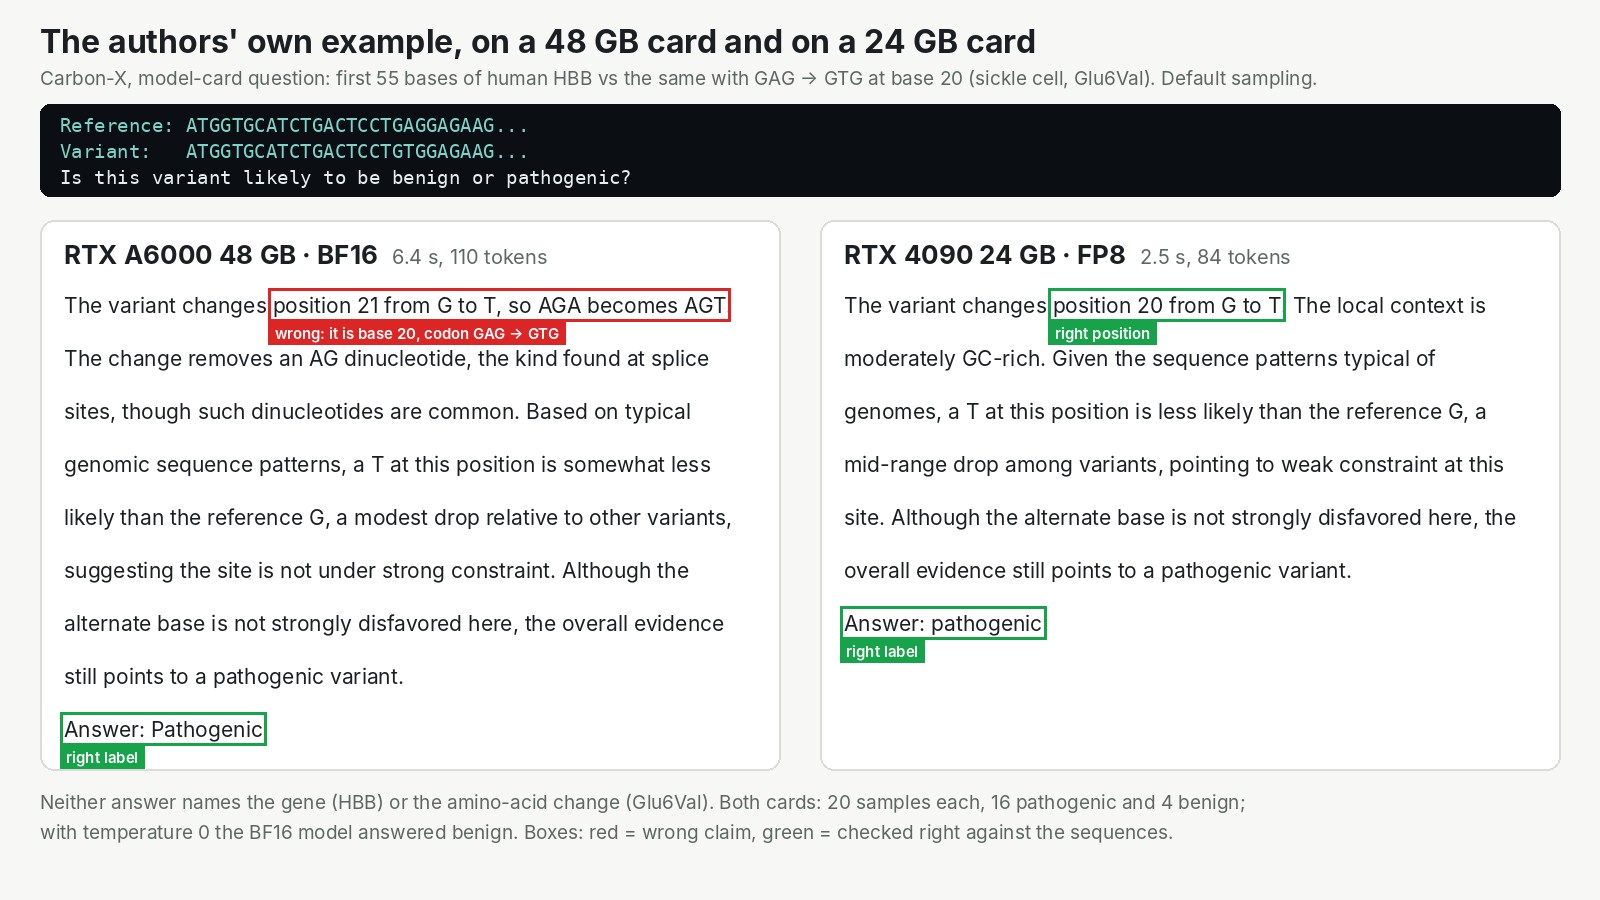
Dieselbe Frage, zwei Karten, je ein Durchlauf. Beide sagten pathogen. Nur eine zeigte auf den richtigen Buchstaben, und keine nannte das Gen.
Ein Chatmodell mit 14B, das DNA lesen gelernt hat
Carbon-X ist Qwen3-14B, das offene Chatmodell des Qwen-Teams, nachtrainiert auf DNA und Biologietexten von einer Gruppe aus Hugging Face, der Zhongguancun Academy und TIGEM / Universität Neapel Federico II. Sie haben die Gewichte unter Apache-2.0 veröffentlicht, ohne Zugangsbeschränkung, zusammen mit ihren Rezepten für Training und Evaluation. Das Verdienst für das Modell gehört ihnen. Unser Teil war, es über unsere Plattform bereitzustellen, ein öffentliches Testset zu bauen und es zu messen.
Neu ist nur, wie es DNA in Tokens zerlegt, die Stücke, die ein Sprachmodell liest. Carbon-X ergänzt das Vokabular von Qwen um 5.515 DNA-Tokens, und die meisten davon sind Blöcke aus sechs Buchstaben A, C, G und T. Ein Token deckt sechs Basen ab, so wie ein Gitarrist einen Lauf aus sechs Tönen als eine Form liest. Deshalb passen lange Sequenzen hinein: Unsere zwei Sequenzen mit je 4.096 Buchstaben plus die Frage ergaben 1.445 Tokens. Fügen Sie eine Sequenz in einen Satz ein, und das Modell markiert sie von selbst als DNA.
Die Schlagzeile der Autoren ist ein Mittelwert von 66,7 % über fünf DNA-Benchmarks, gegenüber 67,5 % für GPT-6.1 Sol und 60,9 % für Opus 5.5, zu einem kleinen Bruchteil der Kosten nach ihren eigenen Preisen. Diesen Mittelwert haben wir nicht reproduziert: Ihre Evaluationsdaten sind nicht öffentlich, also haben wir aus öffentlichen Quellen ein eigenes Set mit 120 Fragen gebaut.
Was wir gefunden haben: Die Labels stimmen mit den Autoren überein
Vierzig unserer Fragen waren echte ClinVar-Varianten in proteincodierenden Genen, 20 harmlose und 20 schädliche, aus demselben Testset, das die Autoren verwenden. Das Modell sah nur die zwei Sequenzen und unsere Frage, nie den Gennamen.
| ClinVar-Varianten (40) | Geschwindigkeit, eine Anfrage | |
|---|---|---|
| RTX A6000 48 GB, 16-Bit-Gewichte | 80,0 % | 19,5 tokens/s |
| RTX 4090 24 GB, 8-Bit-Gewichte | 75,0 % | 50,5 tokens/s |
| Autoren (alle 1.018 Varianten) | 74,9 % |
Beide Zeilen sind mit abgeschaltetem Zufall des Modells gemessen. Der Unterschied zwischen den Karten beträgt zwei von 40 Varianten, innerhalb des Rauschens, und die beiden waren sich bei 36 von 40 einig. Die kleinere Karte war außerdem schneller, weil die 8-Bit-Gewichte den Großteil der Arbeit machen: Eine vollständige Variantenfrage dauerte auf der 4090 2,4 bis 2,6 Sekunden, gegenüber 7,1 bis 7,5 auf der 48-GB-Karte in 16 Bit.
Die Fehler gehen in eine Richtung. Auf der 48-GB-Karte erkannte es 19 der 20 schädlichen Varianten, markierte aber 8 der 20 harmlosen als schädlich. Bei einer langen echten Liste landen so viele harmlose Fälle auf dem Schreibtisch eines Menschen.
Bei den Begründungen bricht es ein
Die Erklärungen um die Labels herum sind oft falsch, selbst wenn das Label stimmt. Bei einer echten Variante, bei der aus einem T ein C wurde, gab es das richtige Label mit der Begründung "The variant changes C to C". Im Sichelzellen-Beispiel der Autoren selbst nannte die 48-GB-Karte in 12 von 20 Versuchen die falsche Base. Über 20 Versuche auf jeder Karte sagte es 16-mal pathogen und 4-mal benigne, und mit abgeschaltetem Zufall sagte die 48-GB-Karte benigne. Die Autoren warnen, dass das Modell "can miscount bases, confuse coordinates". Es ist kein klinisches Werkzeug, und das sagen sie auch.
Für wen das interessant ist
- Teams, die viele Varianten nach wahrscheinlichem Schaden sortieren. Es ist ein brauchbarer erster Durchgang, aber fragen Sie mehr als einmal und lassen Sie einen Menschen über die markierte Liste schauen.
- Labore, deren Sequenzen das Haus nicht verlassen dürfen. Apache-2.0-Gewichte auf einer 24-GB-Karte, die Sie selbst betreiben.
- Alle, die das Warum brauchen. Berechnen Sie Positionen und Gennamen im Code; verlassen Sie sich dabei nicht auf das Wort des Modells.
- Teams mit 16-GB-Karten. Lassen Sie es vorerst weg: Keines der vLLM-Setups, die wir mit 16 GB ausprobiert haben, hat funktioniert.
Auf InferenceKey stellte ein kalter 48-GB-Worker Carbon-X nach 356 Sekunden bereit, die 4090 nach 262,5 Sekunden. Der Großteil davon war die Installation von vLLM und das Aufwärmen der Engine, nicht der Download von 30 GB. Eine Unebenheit: Antworten mit DNA kommen in wörtliche <dna>-Tags eingepackt zurück, entfernen Sie sie also in Ihrem Parser. Status: offen.
Die ehrliche Grenze: 40 Varianten sind eine kleine Stichprobe, lesen Sie unsere Zahlen also als "stimmt mit den Autoren überein oder nicht", nicht als Rangliste.
Der vollständige Test
Der Research-Beitrag hat die Ergebnisse zu GenomeQA und zur Vorhersage der nächsten Basen, die Stufen des GPU-Speichers, den genauen vLLM-Befehl und das SDK-Beispiel, das die Fragen der Autoren auf Ihrer eigenen Karte stellt. Lesen Sie den vollständigen Test von Carbon-X im Research-Beitrag.