Carbon-X clasifica variantes de ADN en una tarjeta gaming, pero revisa sus razones
Carbon-X acertó el 75 % de 40 variantes de ClinVar en una RTX 4090 de 24 GB con pesos de 8 bits, a 2,5 s por respuesta. Sus explicaciones fallaban a menudo.
Un modelo de ADN que acierta el veredicto y se equivoca en el razonamiento sigue siendo útil, siempre que sepas de qué mitad fiarte. Ahí dejó nuestra prueba a Carbon-X, el nuevo modelo abierto de Hugging Face que lee ADN en bruto dentro de un chat normal y responde en inglés. En una RTX 4090 de 24 GB de nuestra nube, con los pesos reducidos a 8 bits, clasificó bien como dañinas o inofensivas el 75 % de 40 variantes conocidas de ClinVar. Los autores dan un 74,9 %. Una pregunta sobre dos secuencias de 4.096 letras volvió en unos 2,5 segundos. Si despliegas modelos para un laboratorio o un equipo de genómica, esto es un especialista en ADN que funciona con vLLM de serie y una sola línea de comandos, en una tarjeta que controlas tú, así que las secuencias sin publicar nunca salen de tu máquina. Usa sus etiquetas como primera criba de una lista larga. No te fíes de las explicaciones que escribe alrededor.
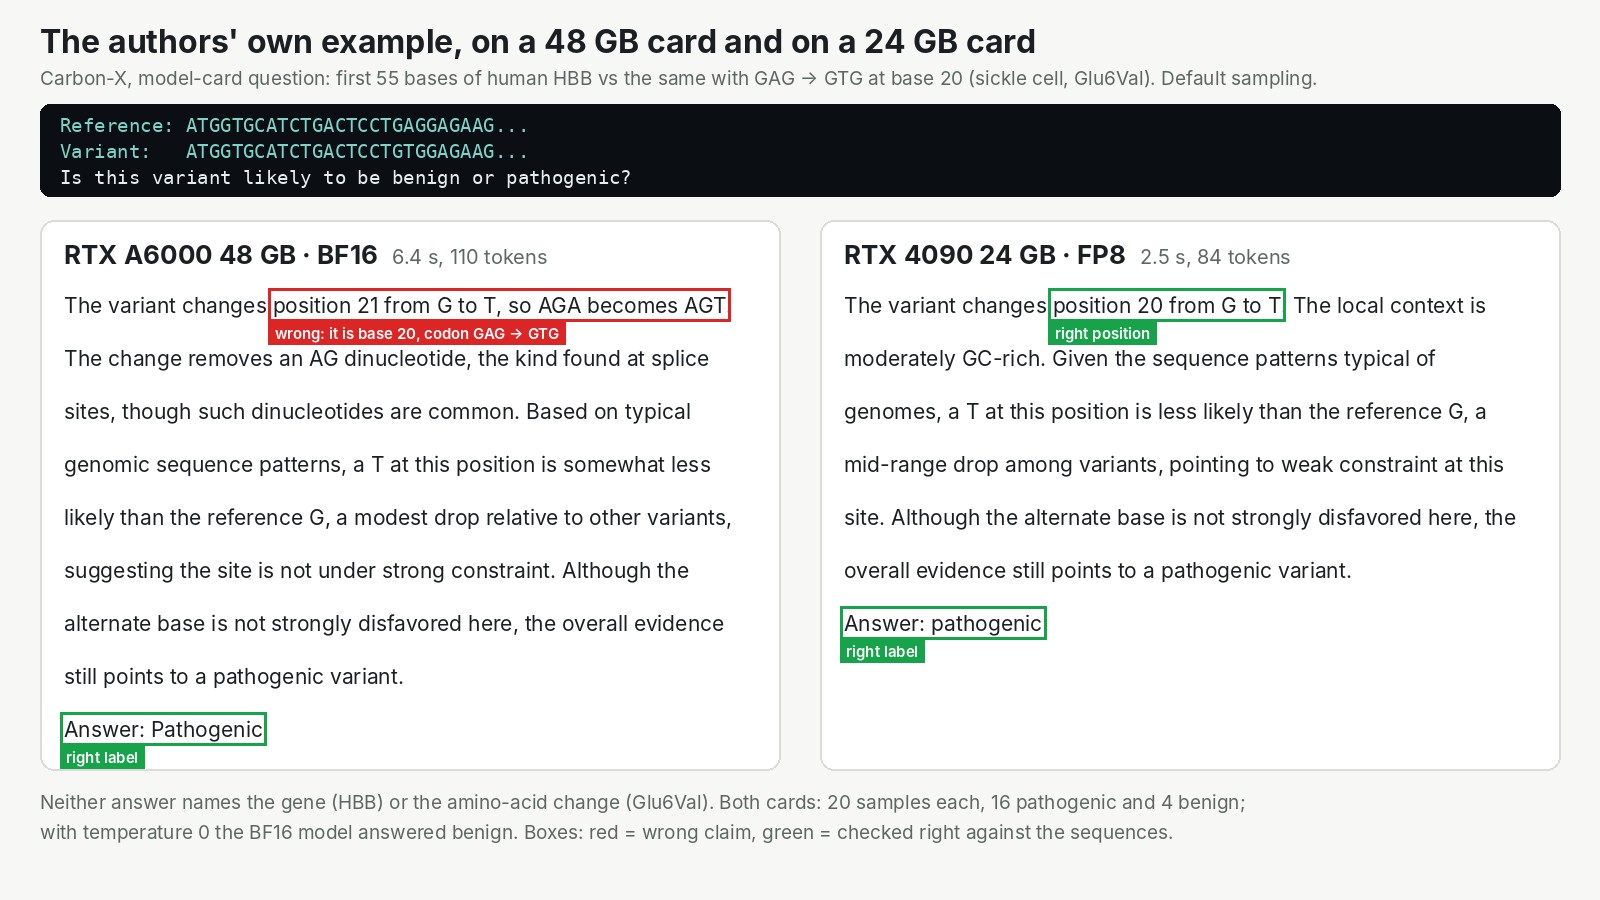
La misma pregunta, dos tarjetas, una ejecución en cada una. Las dos dijeron patogénica. Solo una señaló la letra correcta, y ninguna nombró el gen.
Un modelo de chat de 14B que aprendió a leer ADN
Carbon-X es Qwen3-14B, el modelo de chat abierto del equipo de Qwen, reentrenado con ADN y textos de biología por un grupo de Hugging Face, Zhongguancun Academy y TIGEM / Universidad de Nápoles Federico II. Publicaron los pesos bajo Apache-2.0, sin acceso restringido, junto con sus recetas de entrenamiento y de evaluación. El mérito del modelo es suyo. Nuestra parte fue servirlo con nuestra plataforma, montar un conjunto de pruebas público y medirlo.
La única pieza nueva es cómo corta el ADN en tokens, los trozos que lee un modelo de lenguaje. Carbon-X añade 5.515 tokens de ADN al vocabulario de Qwen, y la mayoría son bloques de seis letras de A, C, G y T. Un token cubre seis bases, igual que un guitarrista lee una escala de seis notas como una sola forma. Por eso entran secuencias largas: nuestras dos secuencias de 4.096 letras más la pregunta se quedaron en 1.445 tokens. Pega una secuencia dentro de una frase y el modelo la marca como ADN por su cuenta.
La cifra estrella de los autores es una media del 66,7 % en cinco benchmarks de ADN, frente al 67,5 % de GPT-6.1 Sol y el 60,9 % de Opus 5.5, a una pequeña fracción del coste según sus propios precios. No reprodujimos esa media: sus datos de evaluación no son públicos, así que construimos nuestro propio conjunto de 120 preguntas a partir de fuentes públicas.
Lo que encontramos: las etiquetas coinciden con las de los autores
Cuarenta de nuestras preguntas eran variantes reales de ClinVar en genes que codifican proteínas, 20 inofensivas y 20 dañinas, del mismo conjunto de prueba que usan los autores. El modelo solo vio las dos secuencias y nuestra pregunta, nunca el nombre del gen.
| Variantes de ClinVar (40) | Velocidad, una petición | |
|---|---|---|
| RTX A6000 48 GB, pesos de 16 bits | 80,0 % | 19,5 tokens/s |
| RTX 4090 24 GB, pesos de 8 bits | 75,0 % | 50,5 tokens/s |
| Autores (las 1.018 variantes) | 74,9 % |
Las dos filas son con la aleatoriedad del modelo desactivada. La diferencia entre las tarjetas es de dos variantes de 40, dentro del ruido, y las dos coincidieron en 36 de 40. La tarjeta pequeña además fue más rápida, porque los pesos de 8 bits hacen casi todo el trabajo: una pregunta de variante completa tardó entre 2,4 y 2,6 segundos en la 4090, frente a 7,1 a 7,5 en la tarjeta de 48 GB con 16 bits.
Los errores se inclinan hacia un lado. En la tarjeta de 48 GB detectó 19 de las 20 variantes dañinas, pero marcó como dañinas 8 de las 20 inofensivas. En una lista real larga, eso son muchos casos inofensivos que acaban en la mesa de una persona.
Donde falla es en las razones
Las explicaciones alrededor de las etiquetas a menudo están mal, incluso cuando la etiqueta es correcta. En una variante real en la que una T pasaba a C, dio la etiqueta correcta con la justificación "The variant changes C to C". En el propio ejemplo de anemia falciforme de los autores, la tarjeta de 48 GB nombró la base equivocada en 12 de 20 intentos. En 20 intentos en cada tarjeta dijo patogénica 16 veces y benigna 4, y con la aleatoriedad desactivada la tarjeta de 48 GB dijo benigna. Los autores avisan de que el modelo "can miscount bases, confuse coordinates". No es una herramienta clínica, y ellos lo dicen.
A quién le interesa
- Equipos que ordenan muchas variantes por su probable daño. Es una primera criba útil, pero muestrea más de una vez y deja a una persona revisando la lista marcada.
- Laboratorios cuyas secuencias no pueden salir del edificio. Pesos Apache-2.0 en una sola tarjeta de 24 GB que ejecutas tú.
- Quien necesite el porqué. Calcula las posiciones y los nombres de genes con código; no te fíes de lo que diga el modelo.
- Equipos con tarjetas de 16 GB. Por ahora, déjalo pasar: ninguna de las configuraciones de vLLM que probamos con 16 GB funcionó.
En InferenceKey, un worker de 48 GB en frío estaba sirviendo Carbon-X en 356 segundos, y la 4090 en 262,5 segundos. Casi todo ese tiempo fue instalar vLLM y calentar el motor, no la descarga de 30 GB. Una aspereza: las respuestas con ADN vuelven envueltas en etiquetas <dna> literales, así que quítalas en tu parser. Estado: abierto.
El límite honesto: 40 variantes es una muestra pequeña, así que lee nuestras cifras como "coincide con los autores o no", no como una clasificación.
Lee la prueba completa
El post de Research tiene los resultados de GenomeQA y de predicción de las siguientes bases, la escalera de memoria de GPU, el comando exacto de vLLM y el ejemplo del SDK que hace las preguntas de los autores en tu propia tarjeta. Lee la prueba completa de Carbon-X en el post de Research.