Un ChatGPT privado para cincuenta equipos, y una factura que se puede repartir
Cómo un asistente de IA privado atiende a cincuenta equipos desde una sola dirección y cómo su coste fijo por hora se convierte en una factura por equipo.
Anuncios de InferenceKey, comentarios sobre noticias de IA y resúmenes de papers que merece la pena leer.
Cómo un asistente de IA privado atiende a cincuenta equipos desde una sola dirección y cómo su coste fijo por hora se convierte en una factura por equipo.
EmbeddingGemma 2 de Google pone texto, imágenes, vídeo y audio en un mismo espacio de búsqueda. Cargó en 1,4 GB en nuestra RTX 2000 Ada de 16 GB.
Kandinsky 6.0 genera clips de 5 segundos con audio sincronizado bajo MIT. Minutos por clip en siete GPUs, y por qué todas las pruebas usan offload.
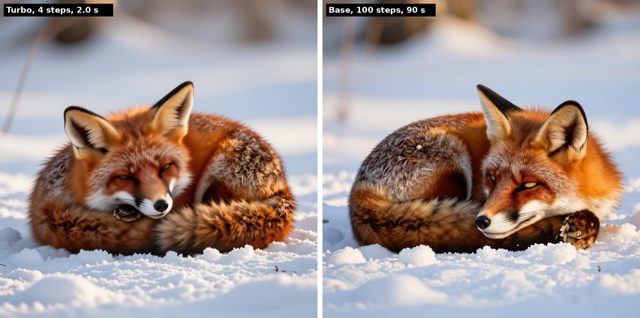
Iris-3B es un modelo de imagen abierto que dibuja los píxeles él mismo. Probamos su versión Turbo en InferenceKey: unos 2 s por imagen en una A40.
AREX-2 de BAAI (Apache 2.0) comparte arquitectura con Qwen3.8-27B. Qué dicen nuestras pruebas con sglang sobre su VRAM, cuants y GPUs, y qué no se ha probado.
Qwen3 Coder Next (80B, AWQ 4-bit) en vLLM, una A100 80 GB a $1.79/h, una API key para un desarrollador y Claude Code apuntando a ella. Comandos y límites.