NitroFusion2 saca un borrador de 1024px en 0,78 s de GPU, pero revisa la ortografía
Un modelo abierto de imagen que dibuja en uno o dos pasos: 0,78 s de GPU por imagen de 1024px en una RTX 4090, pero el texto pequeño hay que revisarlo.
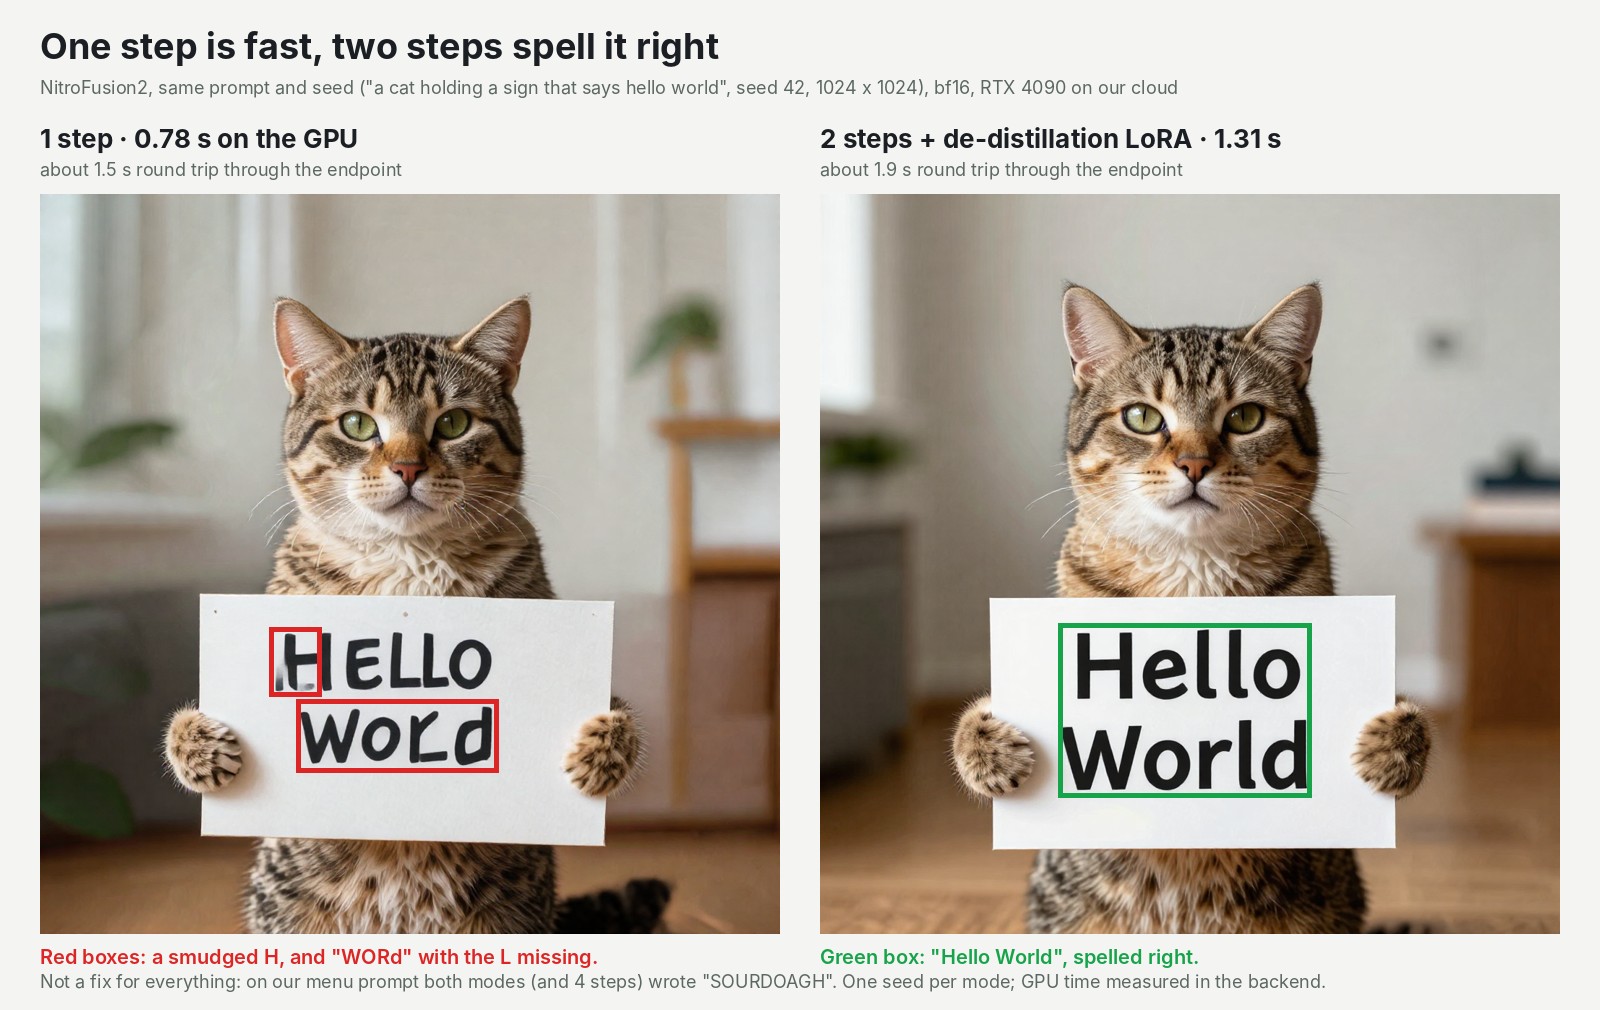
¿Cuántas imágenes puede dibujar una tarjeta en un minuto? Con NitroFusion2 en una sola RTX 4090 de nuestra nube, unas 40, a 1024 x 1024 y a través de una API de verdad. Cada una cuesta 0,78 segundos de GPU. NitroFusion2 es un modelo abierto nuevo que hace en una o dos pasadas lo que su modelo de origen, Z-Image-Turbo, hace en ocho. Para quien despliega modelos de imagen, eso cambia la factura de las previsualizaciones: un borrador nuevo cada segundo y medio, en tu propia GPU. Incluso funciona en una tarjeta real de 16 GB, a unos 4 segundos por imagen. La pega es la ortografía. En un paso, el modelo escribió "HELLO WORd" en el cartel de un gato; en dos pasos acertó con "Hello World". Lo que puedes hacer hoy con él: un paso para borradores, dos para cualquier cosa con texto corto, y la letra pequeña fuera de la imagen.
Un alumno que aprendió a saltarse siete pasadas
Un modelo de imagen como este parte de ruido aleatorio y lo va limpiando en pasadas. Cada pasada, un "paso", ejecuta una vez la red entera de 6,2B parámetros sobre la imagen. Z-Image-Turbo, el modelo abierto del laboratorio Tongyi-MAI, hace ocho.
Dar-Yen Chen y Yi-Zhe Song, del grupo SketchX de la Universidad de Surrey, entrenaron una versión alumna que llega en una o dos. Su artículo salió el 3 de noviembre, y el entrenamiento se centra en las palabras del prompt. Los pesos y el código son Apache-2.0. Para dos pasos recomiendan un pequeño complemento de 0,38 GB que hace que la primera pasada sea mitad Z-Image-Turbo, para corregir algunos defectos. También publican copias comprimidas, de 2,0 GB a 7,2 GB, junto al fichero completo de 12,3 GB. Lo vimos en el vídeo de noticias de AI Search del 8 de noviembre.
Los autores hablan claro sobre el precio que se paga. En su prueba de texto largo dentro de imágenes, un paso saca 43 sobre 100, dos pasos 76, y Z-Image-Turbo a ocho pasos 92. El artículo lo llama "a substantial gap" en el renderizado de texto. Son sus benchmarks; no los hemos repetido.
Lo que medimos: la velocidad está resuelta, la ortografía es lo que decide
Servimos NitroFusion2 como API en una RTX 4090 y pedimos imágenes de 1024 x 1024, de una en una, todas con semilla 42. Medimos el modelo contra sí mismo, no contra el original de ocho pasos.
| 1024 x 1024, de una en una | Un paso | Dos pasos |
|---|---|---|
| Tiempo de GPU, RTX 4090, fichero completo de 12,3 GB | 0,78 a 0,82 s | 1,32 a 1,33 s |
| Ida y vuelta a través de la API | 1,45 a 1,50 s | 1,95 a 2,00 s |
| Tarjeta real de 16 GB, copia de 5 GB | unos 4,0 s | unos 7,3 s |
Cada paso extra añade algo más de medio segundo. La ida y vuelta (enviar la petición, codificar la imagen, recibirla) añade unos dos tercios de segundo, así que a un paso la fontanería cuesta casi lo mismo que el dibujo. A través de la API eso son unas 40 imágenes por minuto a un paso y 30 a dos.
Las palabras deciden qué ajuste usar. Los titulares grandes aguantaron en un paso: un cartel de un tranvía de Lisboa salió con "LISBOA" y "Tram 28 - every 12 minutes" bien escritos. La letra pequeña no aguantó con ningún número de pasos que probamos. Una carta de cafetería en pizarra pedía "SOURDOUGH" y salió "SOURDOAGH" a uno, dos y cuatro pasos, y a dos pasos sin el complemento. Los precios y las demás palabras de la carta estaban bien. Cuatro pasos, el máximo que acepta el modelo, tardaron unas tres veces más que uno y no lo arreglaron.
Qué tarjeta necesita
El fichero de 12,3 GB es solo parte de la carga. El lector de texto de Z-Image-Turbo, la parte que lee el prompt, añade unos 8 GB, así que la configuración completa necesita una tarjeta de 24 GB para quedarse entera en la GPU. En una tarjeta de 16 GB, la copia de 5 GB de los autores es la que deja sitio. Una RTX 2000 Ada real de 16 GB, una tarjeta de estación de trabajo pequeña de 70 vatios, la ejecutó con todo dentro de la tarjeta a unos 4 segundos por imagen, con menos de medio gigabyte libre. Mover el fichero completo dentro y fuera de la memoria del sistema también funciona con un límite de 16 GB, pero a 14 a 19 segundos por imagen. Con un presupuesto de 8 GB falla: el lector de texto solo ya lo llena.
En InferenceKey, una máquina con GPU recién pedida estaba lista para servir a los 67 segundos, contando la configuración, la descarga y la carga. Nada de lo que viene incluido sirve este modelo, así que escribimos un pequeño fichero de Python que le dice a la plataforma cómo cargarlo; la plataforma en sí no necesitó ningún cambio. Una trampa: el probador de imágenes del panel empieza en 20 pasos, y NitroFusion2 rechaza cualquier cosa por encima de 4. Ponlo en 1 o 2 pasos y la guía (guidance) en 0.
A quién le interesa
- Equipos que necesitan previsualizaciones en directo, miniaturas o borradores: un paso, menos de un segundo de GPU, en una tarjeta que controlas tú.
- Imágenes con texto corto y grande que llegan a clientes: dos pasos, y revisarlas.
- Cartas, etiquetas, precios, letra pequeña: ninguno de los dos. Pon tú el texto encima, o prueba Z-Image-Turbo a ocho pasos.
- Una tarjeta de 16 GB: la copia de 5 GB, entera dentro de la tarjeta.
El límite, sin rodeos: usamos una semilla por prompt y una petición cada vez, y nuestra 4090 era la versión de 48 GB limitada para comportarse como la tarjeta habitual de 24 GB, así que los resultados de calidad son una comprobación de comportamiento, no un benchmark.
Los tiempos, la escala de memoria de 24 GB a 8 GB y todas las muestras están en la prueba completa de NitroFusion2.