NitroFusion2 entwirft ein 1024-px-Bild in 0,78 s GPU-Zeit, aber prüfen Sie die Rechtschreibung
Ein offenes Bildmodell, das in ein oder zwei Schritten zeichnet: 0,78 s GPU-Zeit pro 1024-px-Bild auf einer RTX 4090, aber kleine Schrift prüfen.
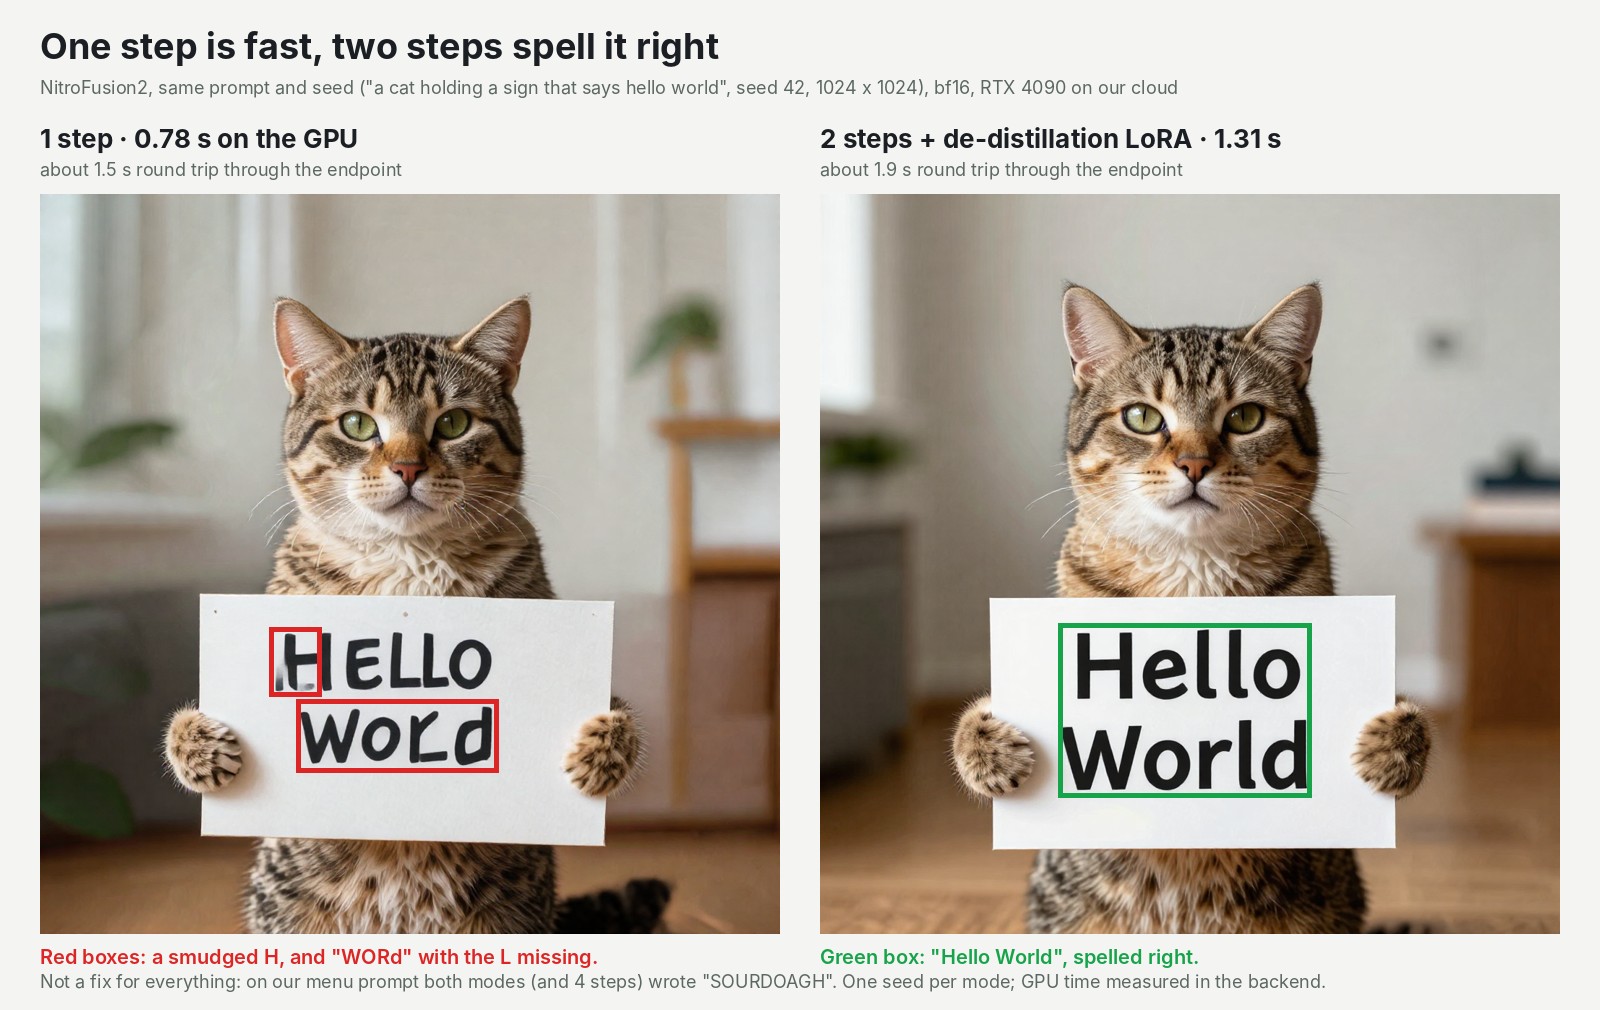
Wie viele Bilder zeichnet eine einzige Karte in einer Minute? Mit NitroFusion2 auf einer einzelnen RTX 4090 in unserer Cloud etwa 40, bei 1024 x 1024 und über eine echte API. Jedes kostet 0,78 Sekunden GPU-Zeit. NitroFusion2 ist ein neues offenes Modell, das in einem oder zwei Durchgängen schafft, wofür sein Vorgänger Z-Image-Turbo acht braucht. Für alle, die Bildmodelle betreiben, ändert das die Rechnung für Vorschauen: alle anderthalb Sekunden ein frischer Entwurf, auf der eigenen GPU. Es läuft sogar auf einer echten 16-GB-Karte, mit etwa 4 Sekunden pro Bild. Der Haken ist die Rechtschreibung. In einem Schritt schrieb das Modell "HELLO WORd" auf das Schild einer Katze; in zwei Schritten kam "Hello World" heraus. Was Sie heute damit anfangen können: einen Schritt für Entwürfe, zwei für alles mit kurzem Text, und Kleingedrucktes aus dem Bild heraushalten.
Ein Schüler, der gelernt hat, sieben Durchgänge zu überspringen
Ein Bildmodell wie dieses beginnt mit zufälligem Rauschen und räumt es in Durchgängen auf. Jeder Durchgang, ein "Schritt", schickt das gesamte Netz mit 6,2 Milliarden Parametern einmal über das Bild. Z-Image-Turbo, das offene Modell des Tongyi-MAI-Labors, macht acht davon.
Dar-Yen Chen und Yi-Zhe Song von der SketchX-Gruppe der University of Surrey haben eine Schülerversion trainiert, die mit einem oder zwei auskommt. Ihr Paper erschien am 3. November, und das Training konzentriert sich auf die Wörter des Prompts. Gewichte und Code stehen unter Apache-2.0. Für zwei Schritte empfehlen sie einen kleinen Zusatz von 0,38 GB, der den ersten Durchgang zur Hälfte zu Z-Image-Turbo macht, um einige Fehler auszubügeln. Außerdem liefern sie komprimierte Kopien von 2,0 GB bis 7,2 GB neben der vollen Datei mit 12,3 GB. Entdeckt haben wir es im News-Video von AI Search vom 8. November.
Die Autoren sind offen, was den Preis angeht. In ihrem Test für langen Text in Bildern erreicht ein Schritt 43 von 100 Punkten, zwei Schritte 76 und Z-Image-Turbo mit acht Schritten 92. Das Paper spricht bei der Textdarstellung von "a substantial gap". Das sind ihre Benchmarks; wir haben sie nicht nachgemessen.
Was wir gemessen haben: Die Geschwindigkeit steht fest, die Rechtschreibung entscheidet
Wir haben NitroFusion2 als API auf einer RTX 4090 bereitgestellt und Bilder in 1024 x 1024 angefordert, eines nach dem anderen, alle mit Seed 42. Wir haben das Modell gegen sich selbst gemessen, nicht gegen das Original mit acht Schritten.
| 1024 x 1024, ein Bild nach dem anderen | Ein Schritt | Zwei Schritte |
|---|---|---|
| GPU-Zeit, RTX 4090, volle 12,3-GB-Datei | 0,78 bis 0,82 s | 1,32 bis 1,33 s |
| Hin und zurück über die API | 1,45 bis 1,50 s | 1,95 bis 2,00 s |
| Echte 16-GB-Karte, 5-GB-Kopie | etwa 4,0 s | etwa 7,3 s |
Jeder zusätzliche Schritt kostet etwas mehr als eine halbe Sekunde. Der Weg hin und zurück (Anfrage senden, Bild kodieren, zurückbekommen) kostet etwa zwei Drittel einer Sekunde, bei einem Schritt kostet die Leitung also fast so viel wie das Zeichnen. Über die API sind das etwa 40 Bilder pro Minute bei einem Schritt und 30 bei zwei.
Die Wörter entscheiden, welche Einstellung Sie nehmen. Große Überschriften hielten in einem Schritt: Ein Straßenbahnplakat aus Lissabon kam mit "LISBOA" und "Tram 28 - every 12 minutes" richtig geschrieben heraus. Kleingedrucktes hielt bei keiner Schrittzahl, die wir probiert haben. Eine Kreidetafel-Speisekarte eines Cafés verlangte "SOURDOUGH" und bekam "SOURDOAGH", bei einem, zwei und vier Schritten und auch bei zwei Schritten ohne den Zusatz. Die Preise und die übrigen Wörter auf der Karte stimmten. Vier Schritte, das Maximum, das das Modell annimmt, dauerten etwa dreimal so lange wie einer und behoben den Fehler nicht.
Welche Karte es braucht
Die 12,3-GB-Datei ist nur ein Teil der Last. Der Textleser von Z-Image-Turbo, also der Teil, der den Prompt liest, bringt etwa 8 GB dazu, sodass der komplette Aufbau eine 24-GB-Karte braucht, um ganz auf der GPU zu bleiben. Auf einer 16-GB-Karte ist die 5-GB-Kopie der Autoren diejenige, die Platz lässt. Eine echte RTX 2000 Ada mit 16 GB, eine kleine Workstation-Karte mit 70 Watt, hat sie mit allem auf der Karte ausgeführt, mit etwa 4 Sekunden pro Bild und weniger als einem halben Gigabyte Reserve. Die volle Datei zwischen Grafikspeicher und Arbeitsspeicher hin und her zu schieben funktioniert unter einer 16-GB-Grenze auch, aber mit 14 bis 19 Sekunden pro Bild. Ein Budget von 8 GB reicht nicht: Der Textleser allein füllt es.
Auf InferenceKey war eine frische GPU-Maschine 67 Sekunden nach unserer Anfrage bereit, inklusive Einrichtung, Download und Laden. Nichts Eingebautes stellt dieses Modell bereit, also haben wir eine kleine Python-Datei geschrieben, die der Plattform sagt, wie sie es laden soll; die Plattform selbst brauchte keine Änderung. Eine Falle: Der Bildtester im Dashboard startet mit 20 Schritten, und NitroFusion2 lehnt alles über 4 ab. Stellen Sie 1 oder 2 Schritte ein und die Guidance auf 0.
Für wen das interessant ist
- Teams, die Live-Vorschauen, Thumbnails oder Entwürfe brauchen: ein Schritt, unter einer Sekunde GPU-Zeit, auf einer Karte unter Ihrer Kontrolle.
- Bilder mit kurzem, großem Text, die an Kunden gehen: zwei Schritte, und prüfen Sie sie.
- Speisekarten, Etiketten, Preise, Kleingedrucktes: keins von beiden. Setzen Sie den Text selbst darüber, oder probieren Sie Z-Image-Turbo mit acht Schritten.
- Eine 16-GB-Karte: die 5-GB-Kopie, komplett auf der Karte.
Die ehrliche Grenze: Wir haben einen Seed pro Prompt und eine Anfrage auf einmal verwendet, und unsere 4090 war die 48-GB-Version, begrenzt auf das Verhalten der üblichen 24-GB-Karte. Lesen Sie die Qualitätsergebnisse also als Verhaltensprüfung, nicht als Benchmark.
Die Zeiten, die Speicherleiter von 24 GB hinunter bis 8 GB und jedes Beispielbild finden Sie im vollständigen NitroFusion2-Test.