NitroFusion2 esquisse une image de 1024px en 0,78 s de GPU, mais vérifiez l'orthographe
Un modèle d'image ouvert qui dessine en un ou deux pas : 0,78 s de GPU par image 1024px sur une RTX 4090, mais le petit texte est à vérifier.
Combien d'images une seule carte peut-elle dessiner en une minute ? Avec NitroFusion2 sur une seule RTX 4090 de notre cloud, environ 40, en 1024 x 1024 et à travers une vraie API. Chacune coûte 0,78 seconde de GPU. NitroFusion2 est un nouveau modèle ouvert qui fait en un ou deux passages ce que son parent, Z-Image-Turbo, fait en huit. Pour ceux qui déploient des modèles d'image, cela change la facture des aperçus : un nouveau brouillon toutes les secondes et demie, sur votre propre GPU. Il tourne même sur une vraie carte de 16 GB, à environ 4 secondes par image. Le hic, c'est l'orthographe. En un pas, le modèle a écrit "HELLO WORd" sur la pancarte d'un chat ; en deux pas, il a obtenu "Hello World". Ce que vous pouvez en faire aujourd'hui : un pas pour les brouillons, deux pour tout ce qui contient un texte court, et pas de petits caractères dans l'image.
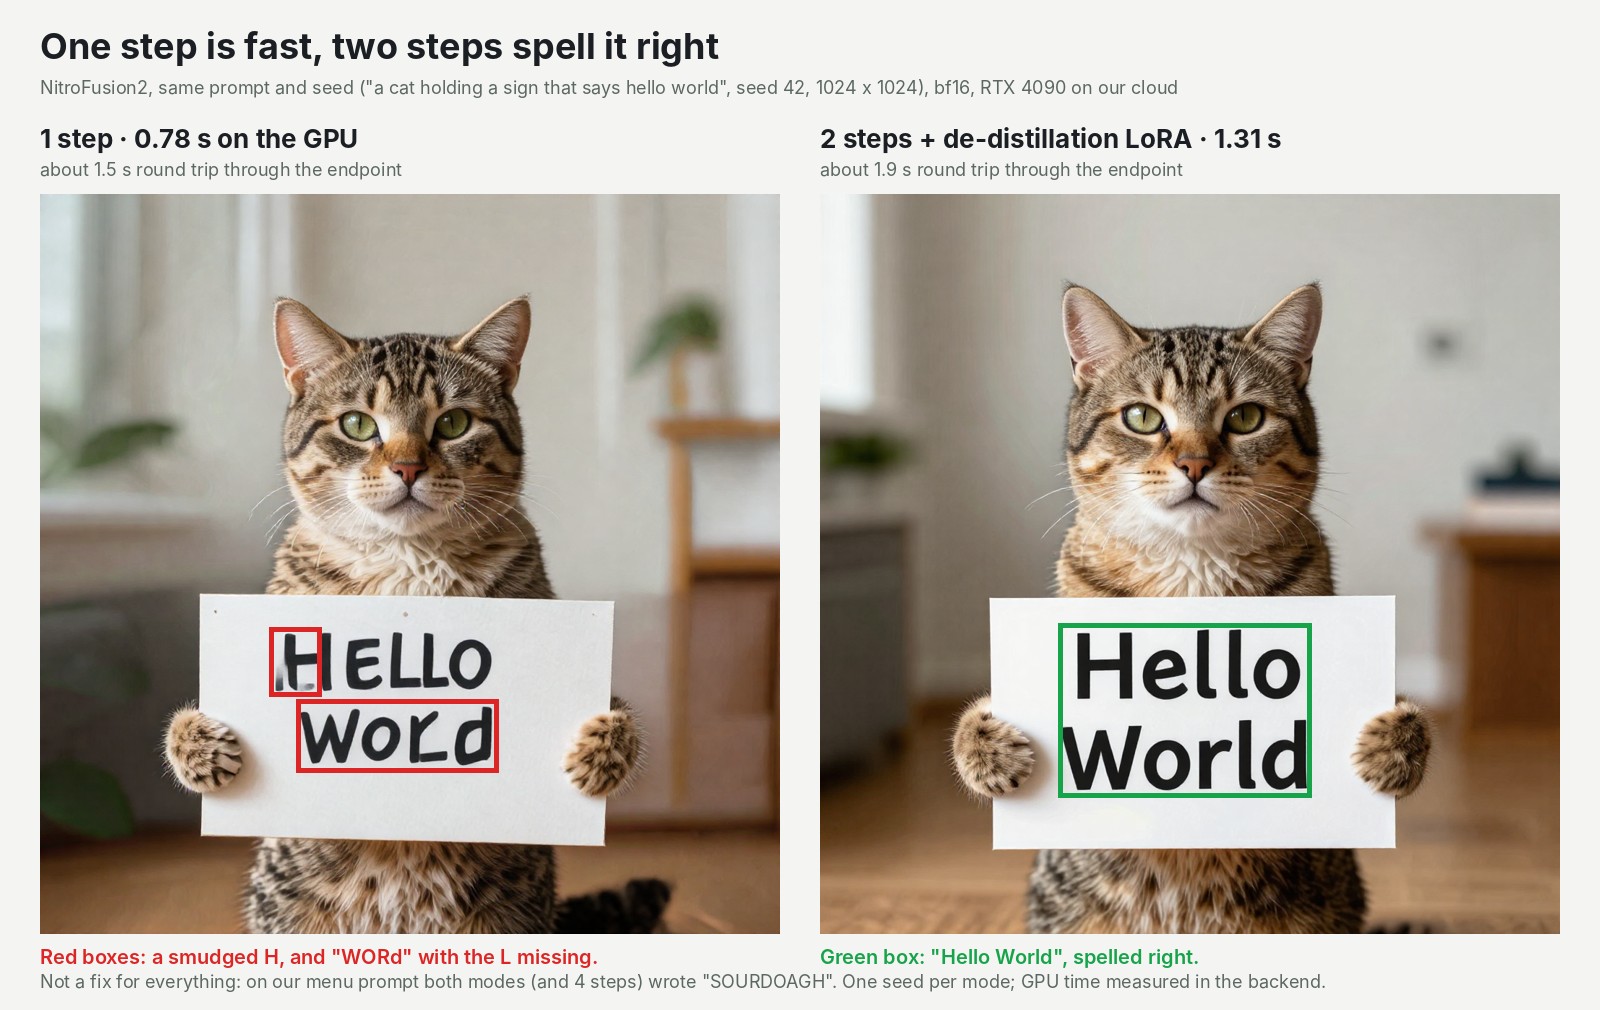
Un élève qui a appris à sauter sept passages
Un modèle d'image comme celui-ci part d'un bruit aléatoire et le nettoie en plusieurs passages. Chaque passage, un "pas", fait tourner une fois tout le réseau de 6,2B paramètres sur l'image. Z-Image-Turbo, le modèle ouvert du laboratoire Tongyi-MAI, en fait huit.
Dar-Yen Chen et Yi-Zhe Song, du groupe SketchX de l'Université du Surrey, ont entraîné une version élève qui y arrive en un ou deux. Leur article est sorti le 3 novembre, et l'entraînement se concentre sur les mots de la consigne. Les poids et le code sont sous Apache-2.0. Pour deux pas, ils recommandent un petit module complémentaire de 0,38 GB qui fait du premier passage un passage à moitié Z-Image-Turbo, pour corriger certains défauts. Ils publient aussi des copies compressées, de 2,0 GB à 7,2 GB, à côté du fichier complet de 12,3 GB. Nous l'avons repéré dans la vidéo d'actualités d'AI Search du 8 novembre.
Les auteurs sont francs sur le compromis. Sur leur test de texte long dans les images, un pas obtient 43 sur 100, deux pas 76, et Z-Image-Turbo à huit pas 92. L'article parle d'"a substantial gap" sur le rendu du texte. Ce sont leurs benchmarks ; nous ne les avons pas relancés.
Ce que nous avons mesuré : la vitesse est acquise, l'orthographe décide
Nous avons servi NitroFusion2 comme API sur une RTX 4090 et demandé des images en 1024 x 1024, une à la fois, toutes avec la graine 42. Nous avons chronométré le modèle contre lui-même, pas contre l'original à huit pas.
| 1024 x 1024, une image à la fois | Un pas | Deux pas |
|---|---|---|
| Temps de GPU, RTX 4090, fichier complet de 12,3 GB | 0,78 à 0,82 s | 1,32 à 1,33 s |
| Aller-retour par l'API | 1,45 à 1,50 s | 1,95 à 2,00 s |
| Vraie carte de 16 GB, copie de 5 GB | environ 4,0 s | environ 7,3 s |
Chaque pas supplémentaire ajoute un peu plus d'une demi-seconde. L'aller-retour (envoyer la requête, encoder l'image, la récupérer) ajoute environ deux tiers de seconde, donc à un pas la tuyauterie coûte presque autant que le dessin. Par l'API, cela fait environ 40 images par minute à un pas et 30 à deux.
Ce sont les mots qui décident du réglage. Les gros titres ont tenu en un pas : une affiche de tram de Lisbonne est sortie avec "LISBOA" et "Tram 28 - every 12 minutes" bien écrits. Les petits caractères n'ont tenu à aucun nombre de pas essayé. Un menu de café sur ardoise demandait "SOURDOUGH" et a obtenu "SOURDOAGH" à un, deux et quatre pas, et à deux pas sans le module complémentaire. Les prix et les autres mots du menu étaient justes. Quatre pas, le maximum que le modèle accepte, ont pris environ trois fois plus de temps qu'un seul et n'ont rien corrigé.
Quelle carte il lui faut
Le fichier de 12,3 GB n'est qu'une partie de la charge. Le lecteur de texte de Z-Image-Turbo, la partie qui lit la consigne, ajoute environ 8 GB, donc l'ensemble complet demande une carte de 24 GB pour rester sur le GPU. Sur une carte de 16 GB, c'est la copie de 5 GB des auteurs qui laisse de la place. Une vraie RTX 2000 Ada de 16 GB, une petite carte de station de travail de 70 watts, l'a fait tourner avec tout sur la carte à environ 4 secondes par image, avec moins d'un demi-gigaoctet de marge. Faire entrer et sortir le fichier complet de la mémoire système marche aussi sous un plafond de 16 GB, mais à 14 à 19 secondes par image. Un budget de 8 GB échoue : le lecteur de texte à lui seul le remplit.
Sur InferenceKey, une nouvelle machine GPU était prête à servir 67 secondes après la demande, installation, téléchargement et chargement compris. Rien d'intégré ne sert ce modèle, alors nous avons écrit un petit fichier Python qui indique à la plateforme comment le charger ; la plateforme elle-même n'a eu besoin d'aucun changement. Un piège : le testeur d'images du tableau de bord démarre à 20 pas, et NitroFusion2 refuse tout ce qui dépasse 4. Réglez-le sur 1 ou 2 pas et le guidage sur 0.
À qui ça s'adresse
- Les équipes qui ont besoin d'aperçus en direct, de miniatures ou de brouillons : un pas, moins d'une seconde de GPU, sur une carte que vous contrôlez.
- Les images avec un texte court et gros qui partent chez les clients : deux pas, et vérifiez-les.
- Menus, étiquettes, prix, petits caractères : ni l'un ni l'autre. Ajoutez le texte vous-même par-dessus, ou essayez Z-Image-Turbo à huit pas.
- Une carte de 16 GB : la copie de 5 GB, gardée entièrement sur la carte.
La limite, honnêtement : nous avons utilisé une graine par consigne et une requête à la fois, et notre 4090 était la version de 48 GB bridée pour se comporter comme la carte courante de 24 GB, donc lisez les résultats de qualité comme une vérification de comportement, pas comme un benchmark.
Les temps, l'échelle de mémoire de 24 GB à 8 GB et chaque échantillon se trouvent dans le test complet de NitroFusion2.