SenseNova Code2Video rend un brouillon de 12 secondes sur une seule carte de 24 GB, puis cale
Le modèle 27B de SenseTime qui fait la vidéo en code a rendu 12 s de brouillon en 10 min sur une RTX 4090, avec une erreur de mise en page, sans finir le film.
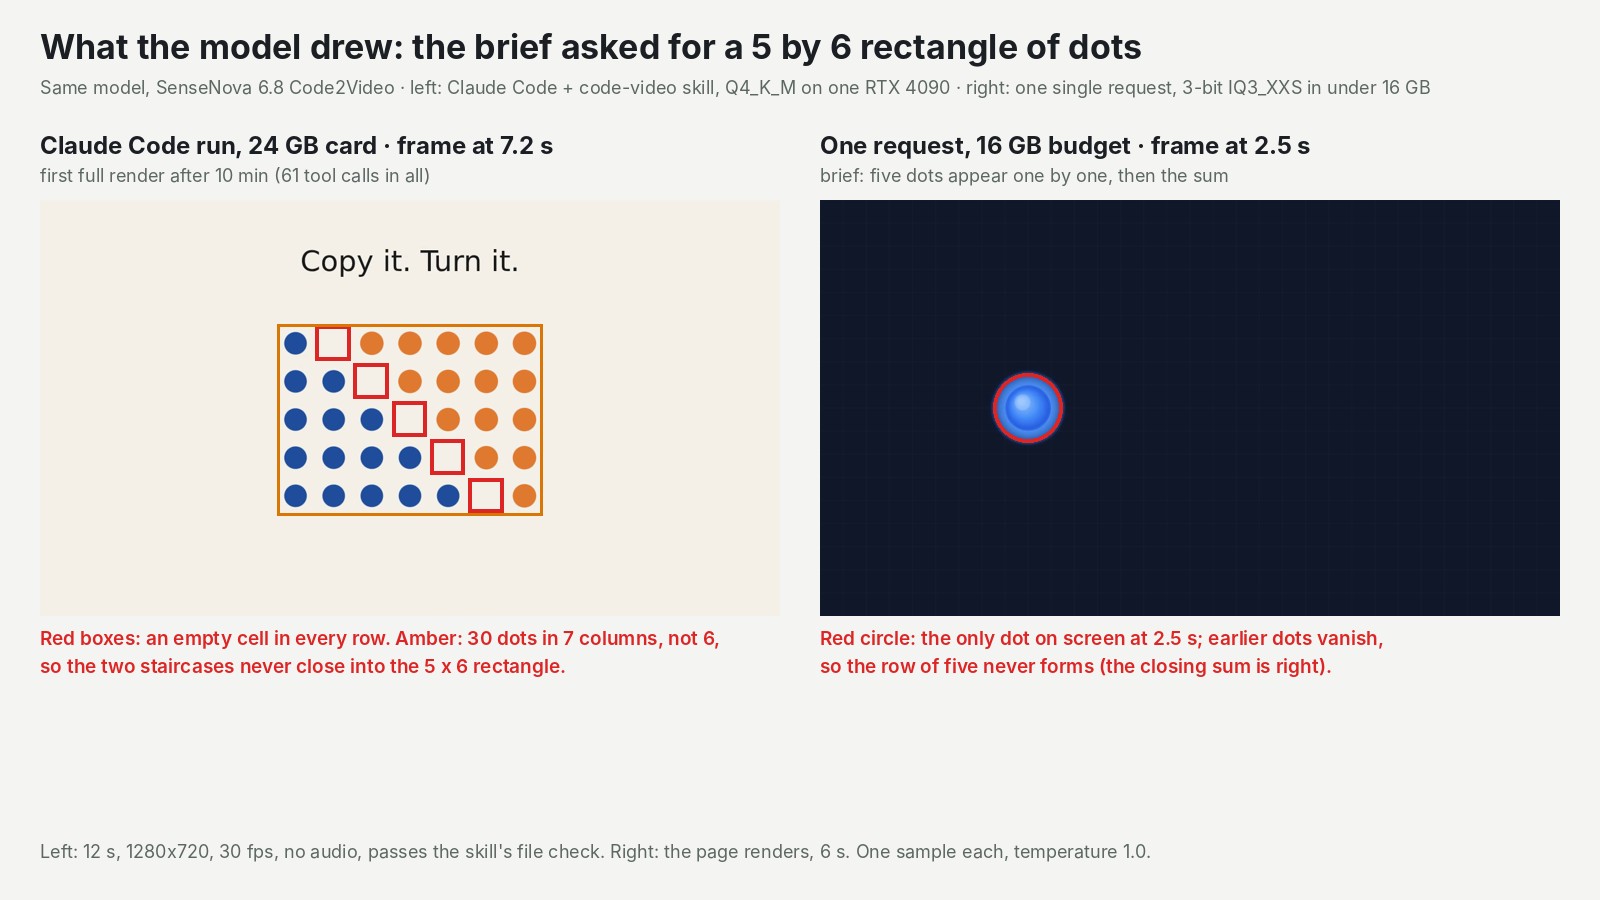
La légende à l'écran dit "5 rows × 6 columns = 30". Les points en dessous forment 5 rangées de 7, avec une case vide dans chaque rangée. Cette image vient d'un clip explicatif de 12 secondes que SenseNova 6.8 Code2Video, le modèle ouvert de 27B de SenseTime, a écrit, rendu et vérifié tout seul, piloté par Claude Code sur une seule RTX 4090 de 24 GB de notre cloud. Le brouillon complet était prêt en 10 minutes. Ce qui change pour ceux qui déploient des modèles : faire une vidéo ne demande plus de modèle vidéo. Un modèle texte et image que vous savez déjà servir écrit une page web qui dessine chaque image. Vous pouvez le faire tourner sur une seule carte de jeu, obtenir vite un premier jet et modifier n'importe quelle étiquette dans le code. Ce que vous ne pouvez pas encore faire, sur cette carte et avec nos réglages, c'est le laisser seul et revenir trouver un film terminé : notre essai de 40 minutes s'est achevé sans film.
Un modèle vidéo qui ne peint jamais un pixel
SenseNova 6.8 Code2Video ne dessine pas d'images. Ses auteurs le décrivent comme un modèle qui "builds and renders videos by generating executable code". Le clip est une page web où chaque instant correspond à exactement une image.
Chaque élément à l'écran est du code : vous changez une couleur ou une étiquette, et vous relancez le rendu. Et le texte sort orthographié exactement comme il est écrit, parce qu'il est tapé, pas dessiné.
SenseTime a publié le modèle sous licence ouverte, avec une skill Claude Code appelée code-video. La skill enseigne une boucle : planifier, écrire la page, rendre des images fixes, les regarder, corriger, puis rendre le film et lancer une vérification du fichier. Les auteurs font tourner le modèle en taille réelle sur quatre GPU avec une mémoire de travail de 512K tokens. Ils disent aussi clairement qu'il est "clearly behind the strongest proprietary models on visual polish and long-horizon reliability".
Notre question était plus modeste : une copie compressée, trois fois plus petite, peut-elle finir un clip court sur une seule carte de 24 GB ?
Notre test : la boucle marche, le seul fait qui compte, non
La consigne était un clip explicatif muet de 12 secondes intitulé "Half a Rectangle" : un escalier de points bleus montre 1 + 2 + 3 + 4 + 5 = 15, une copie orange pivote et le referme en un rectangle de 5 sur 6, soit 30 points. La moitié de 30, c'est 15.
Nous avons fait tourner la copie 4 bits de bartowski (17,2 GB) avec sa partie vision, pour que le modèle puisse voir ses propres images. Le modèle a écrit son plan à 5 minutes et avait rendu les 12 secondes complètes à 10. En chemin, il a lu 21 de ses propres images et corrigé ce qu'il y voyait. Le mouvement est propre et chaque mot à l'écran correspond à la consigne.
L'image casse pourtant le fait qui compte. Nous avons mesuré les centres des points : 7 colonnes, pas 6, donc les deux escaliers ne se referment jamais en rectangle. La vérification du fichier est passée quand même, parce qu'elle contrôle la résolution, la cadence et la durée, pas l'image.
Puis l'essai a manqué de place. Claude Code garde dans sa mémoire de travail tout ce que le modèle a lu et écrit, et quand elle est pleine à 80 %, il demande au modèle de résumer et de repartir de zéro. La nôtre contenait 98 304 tokens et s'est remplie au bout d'environ 19 minutes. Trois tentatives de résumé se sont chacune heurtées à notre plafond de 16 384 tokens par réponse, et ont pris les 21 dernières minutes. La limite de 40 minutes a tout arrêté, sans film final.
| Sur une seule RTX 4090 24 GB | Ce que nous avons vu |
|---|---|
| Premier rendu complet de 12 s | 10 minutes, une erreur de mise en page |
| Pic de mémoire de la carte, essai avec l'agent | 20,9 GiB |
| Film final en moins de 40 minutes | aucun, bloqué sur les résumés |
| Plus petite copie dont la page se rend | 3 bits, pic de 13,7 GiB, un seul point affiché à la fois |
Qui devrait s'y intéresser
- Les équipes qui font des vidéos explicatives et du motion design avec du texte exact. Ça vaut l'essai sur une carte de 24 GB : un brouillon complet en 10 minutes, et chaque étiquette modifiable dans le code.
- Ceux qui ont besoin d'une image juste du premier coup. Relisez chaque image vous-même.
- Ceux qui veulent un film terminé sans surveillance. Comptez des heures et beaucoup plus de mémoire de travail, comme les auteurs. Dans quatre de leurs six essais publiés, Claude Code a vidé une mémoire de travail de 167K à 492K tokens avec un plafond de réponse de 64K.
- Les équipes avec une carte de 16 GB. La copie 3 bits tient sur le papier, mais nous l'avons mesurée sur la 4090, pas sur une vraie carte de 16 GB, et son seul échantillon avait un bug.
Une dernière chose que vous rencontrerez sur notre plateforme : quand Claude Code envoyait une image, notre plateforme la supprimait ou la transmettait sous forme de texte. C'est corrigé dans notre version de test, pas encore sur le service hébergé, où les images arrivent toujours à l'aveugle.
La limite honnête : il s'agit d'un seul essai sur une seule consigne, avec une mémoire de travail et un plafond de réponse bien en dessous des réglages des auteurs. Cela montre ce que fait une seule carte avec cette configuration, pas ce dont le modèle est capable.
Les mesures au pixel, l'échelle de mémoire pour les cartes plus petites, la chronologie du blocage et l'exemple de SDK se trouvent dans le test complet de SenseNova Code2Video.