SenseNova Code2Video renderiza un borrador de 12 segundos en una tarjeta de 24 GB y luego se atasca
El modelo 27B de SenseTime de vídeo por código renderizó un borrador de 12 s en 10 minutos en una RTX 4090, con un fallo de maquetación, y no acabó el vídeo.
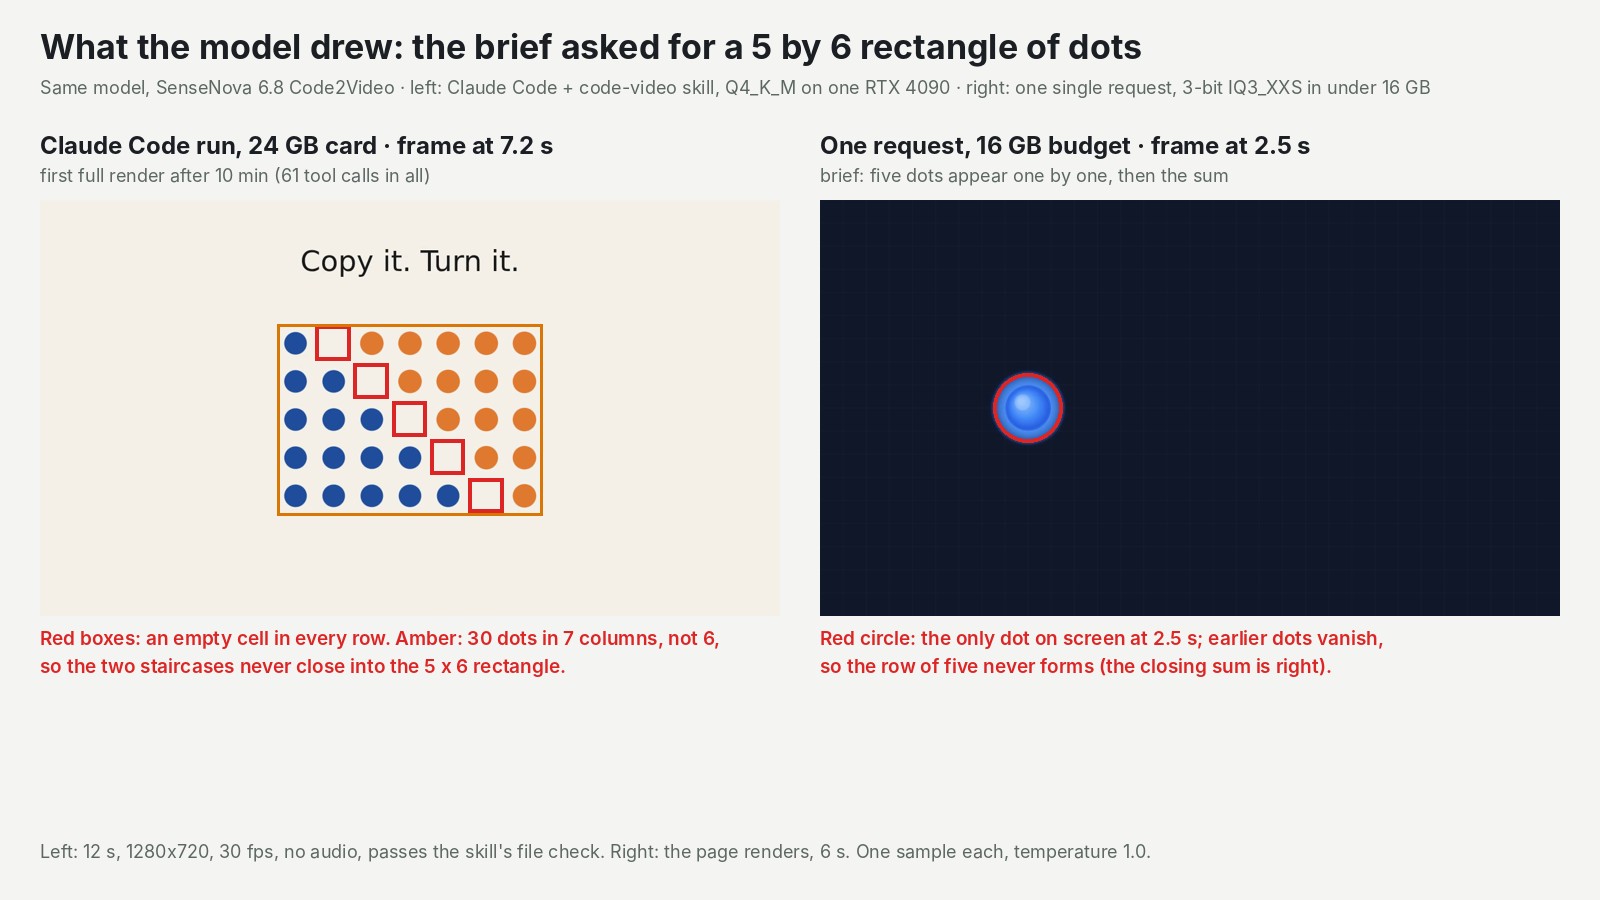
El rótulo en pantalla dice "5 rows × 6 columns = 30". Los puntos de debajo están en 5 filas de 7, con una celda vacía en cada fila. Ese fotograma sale de un clip explicativo de 12 segundos que SenseNova 6.8 Code2Video, el modelo abierto de 27B de SenseTime, escribió, renderizó y revisó por su cuenta, guiado por Claude Code en una sola RTX 4090 de 24 GB de nuestra nube. El borrador completo estuvo listo en 10 minutos. Lo que cambia para quien despliega modelos: hacer un vídeo ya no exige un modelo de vídeo. Un modelo de texto e imagen, de los que ya sabes servir, escribe una página web que dibuja cada fotograma. Puedes ejecutarlo en una tarjeta gaming, sacar un borrador rápido y editar cualquier rótulo en el código. Lo que todavía no puedes hacer, en esa tarjeta y con nuestra configuración, es dejarlo solo y volver a por un vídeo terminado: nuestra ejecución de 40 minutos acabó sin él.
Un modelo de vídeo que nunca pinta un píxel
SenseNova 6.8 Code2Video no dibuja imágenes. Sus autores lo describen como un modelo que "builds and renders videos by generating executable code". El clip es una página web en la que cada instante tiene exactamente una imagen.
Cada elemento en pantalla es código, así que cambias un color o un rótulo y vuelves a renderizar. Y el texto sale escrito exactamente como se pidió, porque se teclea, no se dibuja.
SenseTime publicó el modelo con licencia abierta, junto con una skill de Claude Code llamada code-video. La skill enseña un ciclo: planificar, escribir la página, renderizar fotogramas sueltos, mirarlos, corregir, y después renderizar el vídeo y pasar una comprobación del fichero. Los autores ejecutan el modelo completo en cuatro GPU con una memoria de trabajo de 512K tokens. También dicen sin rodeos que está "clearly behind the strongest proprietary models on visual polish and long-horizon reliability".
Nuestra pregunta era más modesta: ¿puede una copia comprimida, a un tercio del tamaño, terminar un clip corto en una sola tarjeta de 24 GB?
Nuestra prueba: el ciclo funciona, el único dato que importa no
El encargo era un clip explicativo mudo de 12 segundos llamado "Half a Rectangle": una escalera de puntos azules muestra 1 + 2 + 3 + 4 + 5 = 15, y una copia naranja gira y la cierra en un rectángulo de 5 por 6 con 30 puntos. La mitad de 30 es 15.
Usamos la copia de 4 bits de bartowski (17,2 GB) más su parte de visión, para que el modelo pudiera ver sus propios fotogramas. El modelo escribió su plan a los 5 minutos y tenía renderizados los 12 segundos completos a los 10. Por el camino leyó 21 de sus propios fotogramas como imágenes y corrigió lo que vio. El movimiento es limpio y cada palabra en pantalla coincide con el encargo.
Aun así, la imagen rompe el dato que importa. Medimos los centros de los puntos: 7 columnas, no 6, así que las dos escaleras nunca se cierran en el rectángulo. La comprobación del fichero pasó igualmente, porque mira la resolución, los fotogramas por segundo y la duración, no la imagen.
Después la ejecución se quedó sin sitio. Claude Code guarda en su memoria de trabajo todo lo que el modelo ha leído y escrito, y cuando llega al 80% le pide al modelo que resuma y empiece de cero. La nuestra admitía 98.304 tokens y se llenó tras unos 19 minutos. Los tres intentos de resumen chocaron con nuestro tope de 16.384 tokens por respuesta y se comieron los últimos 21 minutos. El límite de 40 minutos lo paró todo sin vídeo final.
| En una RTX 4090 de 24 GB | Lo que vimos |
|---|---|
| Primer render completo de 12 s | 10 minutos, un fallo de maquetación |
| Pico de memoria de la tarjeta, ejecución del agente | 20,9 GiB |
| Vídeo final en 40 minutos | ninguno, atascado en los resúmenes |
| Copia más pequeña cuya página se renderiza | 3 bits, pico de 13,7 GiB, solo se ve un punto cada vez |
A quién le interesa
- Equipos que hacen vídeos explicativos y motion graphics con texto exacto. Merece la pena probarlo en una tarjeta de 24 GB: un borrador completo en 10 minutos y cada rótulo editable en el código.
- Quien necesite la imagen bien a la primera. Revisa tú cada fotograma.
- Quien quiera un vídeo terminado sin supervisión. Cuenta con horas y con mucha más memoria de trabajo, como hacen los autores. En cuatro de sus seis ejecuciones publicadas, Claude Code vació una memoria de trabajo de 167K a 492K tokens con un tope de respuesta de 64K.
- Equipos con una tarjeta de 16 GB. La copia de 3 bits entra sobre el papel, pero la medimos en la 4090, no en una tarjeta real de 16 GB, y su única muestra tenía un fallo.
Una cosa más con la que te vas a topar en nuestra plataforma: cuando Claude Code enviaba un fotograma, nuestra plataforma descartaba la imagen o la pasaba como texto. Está corregido en nuestra versión de pruebas, todavía no en el servicio alojado, donde los fotogramas siguen llegando a ciegas.
El límite honesto: fue un solo intento con un solo encargo, con una memoria de trabajo y un tope de respuesta muy por debajo de la configuración de los autores, así que muestra lo que hace una tarjeta con esta configuración, no lo que puede hacer el modelo.
Las medidas en píxeles, la escala de memoria para tarjetas más pequeñas, la cronología del atasco y el ejemplo con el SDK están en la prueba completa de SenseNova Code2Video.