Qwen3.5-0.8B con el 0,016 % de sus pesos editados corta casi todos sus bucles de razonamiento: 62 % de aciertos frente a 8 %
Misma RTX 4090, mismos 50 problemas: el Qwen3.5-0.8B editado acertó el 62 %, el base el 8 %, con el 96 % de sus respuestas en bucle hasta el límite.
Un modelo de razonamiento pequeño que nunca termina es una plaza de GPU ocupada sin respuesta al final. Eso es lo que hizo Qwen3.5-0.8B en el 96 % de nuestros problemas de matemáticas: dio vueltas en círculo hasta que el límite de 32.768 tokens (los tokens son trozos de palabras) lo cortó. Después servimos una copia editada del mismo modelo, en la que otra IA había cambiado el 0,016 % de los pesos, sin ningún entrenamiento. La misma RTX 4090 de nuestra nube, los mismos 50 problemas, la misma configuración: la copia editada acertó el 62 % frente al 8 %, y solo el 20 % de sus respuestas llegó al límite. Si sirves modelos de razonamiento pequeños en tus propias GPU, esto va tanto de tiempo de tarjeta como de precisión. El fichero editado se carga y se sirve con el mismo comando que el modelo base, así que probarlo es cambiar un fichero. Probamos matemáticas con el razonamiento activado, y nada más.
Un grupo que no encuentra el final de la canción
Qwen3.5-0.8B es un modelo abierto pequeño con unos 0,8B números aprendidos (los pesos). Antes de responder escribe un borrador: piensa en voz alta y luego da el resultado. La propia ficha del modelo de Qwen avisa de que este tamaño es "más propenso a entrar en bucles de razonamiento" que sus hermanos. Todas las notas están en el tono, pero la canción no acaba hasta que alguien desenchufa.
El 2 de noviembre de 2026, Rikiya Takehi, Jayden Teoh, Alex Zhang y Omar Khattab, del MIT CSAIL, publicaron un artículo de blog sobre lo que llaman programación en el espacio de pesos. Un modelo grande al que llaman GPT-6 Astra recibió una herramienta para leer y cambiar los números del modelo pequeño, más problemas de práctica que no estaban en la prueba. Con un presupuesto de 50 ejecuciones de práctica, localizó los bucles en dos sitios dentro del modelo y borró ese patrón de 64 columnas de números en cada uno. Son 131.072 pesos, el 0,016 % del modelo.
En MATH-500, un conjunto estándar de 500 problemas de matemáticas de competición, los autores declaran un salto del 7,9 % al 48,1 % de aciertos, y las respuestas cortadas en el límite bajan del 93 % al 33,1 %. El usuario de Hugging Face akhaliq reconstruyó el fichero del modelo editado a partir del cambio publicado por los autores, volvió a ejecutar los 500 problemas y obtuvo un 51,0 % de aciertos, con un 31,6 % cortado en el límite. Vimos la noticia en el vídeo de noticias de AI Search del 8 de noviembre.
La edición no le enseña canciones nuevas al grupo. Le enseña dónde acaba la canción.
Nuestra prueba: 62 % de aciertos frente a 8 % en una RTX 4090
Ejecutamos los dos modelos en paralelo en una sola RTX 4090 de 24 GB de nuestra nube, cada uno detrás de su propio endpoint de API, sobre vLLM (el motor de servicio de código abierto que usó la repetición de akhaliq), con el borrador de razonamiento activado y la configuración de aleatoriedad de los autores. Las preguntas fueron los primeros 50 problemas de MATH-500 en el orden de la repetición de akhaliq, un intento cada uno, corregidos con el propio script de los autores.
| Editado | Base | |
|---|---|---|
| Aciertos | 31 de 50 (62 %) | 4 de 50 (8 %) |
| Cortadas en 32.768 tokens | 10 (20 %) | 48 (96 %) |
| Tokens medios por respuesta | 20.444 | 31.832 |
Nuestro 62 % está por encima de las dos cifras publicadas, y eso es la muestra pequeña hablando: en estos mismos 50 problemas, la repetición de akhaliq dio un 54 % de media. El 8 % y el 96 % del modelo base caen justo sobre las cifras de los autores.
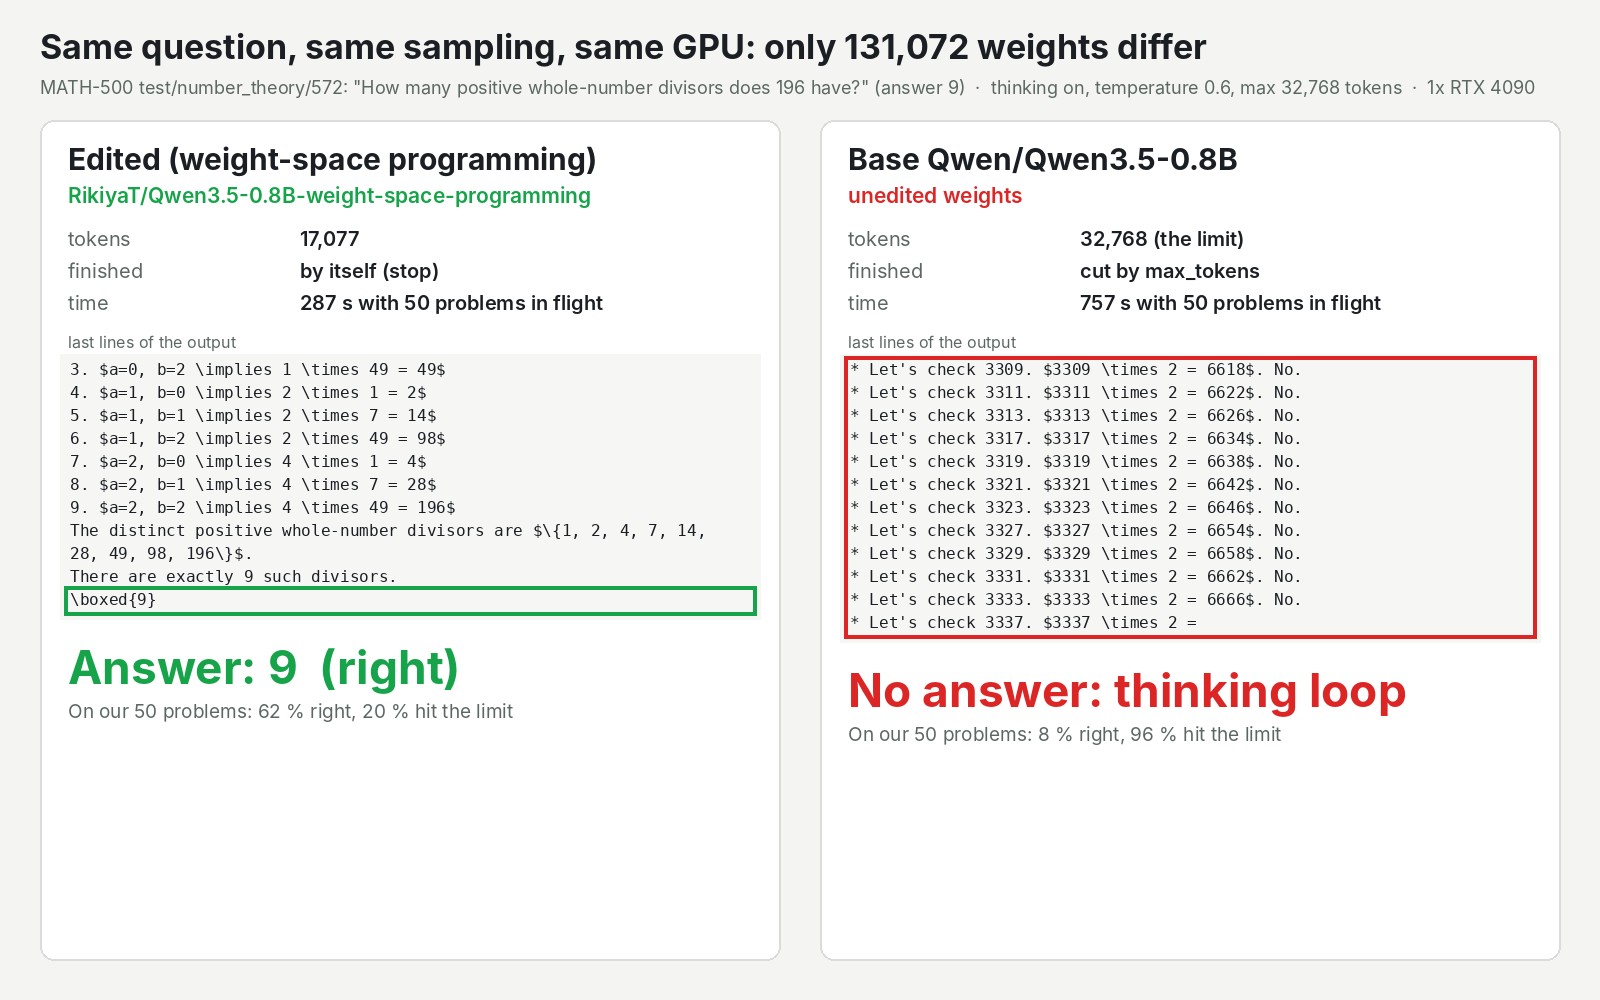
La imagen de arriba muestra la diferencia en una pregunta: ¿cuántos divisores tiene 196? La respuesta es 9. El modelo editado la encontró y paró. El modelo base empezó a enumerar números por encima de 3.300, uno a uno, y seguía cuando el límite lo cortó.
Por qué los bucles te cuestan tiempo de tarjeta
Una GPU sirve un número fijo de respuestas a la vez. Con el modelo base, casi todas esas plazas estaban atascadas en un bucle, hasta 12,6 minutos en la pregunta de los divisores, y normalmente acababan sin respuesta. Para los mismos 50 problemas, el modelo editado escribió 1,02 millones de tokens y el base 1,59 millones. Por respuesta correcta son unos 33.000 tokens frente a 398.000, aunque la cifra del base se apoya en solo 4 aciertos, así que tómala como aproximada.
El modelo editado no sale barato por respuesta: sigue escribiendo borradores largos, y una sola respuesta tarda alrededor de un minuto. Pero la mayoría de esos minutos acaban con un resultado.
Los dos modelos entran a la vez en una tarjeta de 24 GB, con 16,9 GiB usados en el pico, y los dos estaban listos 418 segundos después de pedirlos en una máquina en frío. Solo, el modelo editado dio los mismos 5 aciertos con un tope de memoria de 6 GB que pusimos en la 4090; con 4 GB no arrancó. Eran topes emulados, no tarjetas pequeñas de verdad.
A quién le importa, y quién debería esperar
- Equipos que ya sirven Qwen3.5-0.8B con razonamiento activado para matemáticas: prueba el cambio. Mismo tamaño, misma licencia Apache-2.0, mismo motor.
- Equipos que quieren las mejores matemáticas de un modelo diminuto: tómalo como un arreglo, no como una mejora. Saca lo que el modelo ya sabía.
- Equipos con otro modelo pequeño que entra en bucle: esto es un método publicado con registros, no un producto. Los autores lo probaron en Gemma 3 270M, que rara vez entra en bucle (el 8,5 % de sus respuestas llega al límite), y se quedó entre el 6,8 % y el 7,7 % en MATH-500. En sus palabras: "Editar los pesos podía quitar un obstáculo que ocultaba una capacidad, pero no podía añadir una capacidad que al modelo le faltaba."
- Equipos que prefieren quedarse con el modelo base: la ficha de Qwen sugiere un límite más bajo o cortar los bucles desde el stream. Eso hace que un bucle falle antes. No lo hemos probado, así que pruébalo antes de cambiar ficheros.
El límite honesto: ejecutamos 50 problemas una vez cada uno, solo matemáticas con el razonamiento activado, así que no hemos comprobado en el fichero editado el chat, el seguimiento de instrucciones, el razonamiento desactivado ni las imágenes, y aun editado, una quinta parte de sus respuestas siguió entrando en bucle.
Los topes de memoria, los tiempos, el problema de streaming con el que te vas a encontrar y el ejemplo del SDK que ejecuta los dos modelos en tu propia GPU están en la prueba completa de la edición de pesos de Qwen3.5-0.8B.