Qwen3.5-0.8B avec 0,016 % de ses poids modifiés sort de la plupart de ses boucles de réflexion : 62 % de bonnes réponses contre 8 %
Même RTX 4090, mêmes 50 problèmes de maths : Qwen3.5-0.8B modifié répond juste à 62 %, la base à 8 %, avec 96 % de ses réponses bloquées en boucle.
Un petit modèle de raisonnement qui ne termine jamais, c'est une place de GPU occupée sans réponse au bout. C'est ce qu'a fait Qwen3.5-0.8B sur 96 % de nos problèmes de maths : il a tourné en rond jusqu'à ce que la limite de 32 768 tokens (les tokens sont des morceaux de mots) le coupe. Nous avons ensuite servi une copie modifiée du même modèle, dans laquelle une autre IA avait changé 0,016 % des poids, sans aucun entraînement. Même RTX 4090 sur notre cloud, mêmes 50 problèmes, mêmes réglages : la copie modifiée a donné 62 % de bonnes réponses contre 8 %, et seules 20 % de ses réponses ont atteint la limite. Si vous servez de petits modèles de raisonnement sur vos propres GPU, c'est une histoire de temps de carte autant que de précision. Le fichier modifié se charge et se sert avec la même commande que le modèle de base, donc l'essayer revient à remplacer un fichier. Nous avons testé les maths avec la réflexion activée, et rien d'autre.
Un groupe qui ne trouve pas la fin du morceau
Qwen3.5-0.8B est un petit modèle ouvert d'environ 0,8 milliard de nombres appris (les poids). Avant de répondre, il écrit un brouillon : il réfléchit à voix haute, puis donne le résultat. La fiche du modèle publiée par Qwen prévient elle-même que cette taille est "more prone to entering thinking loops" que ses grands frères. Chaque note est juste, mais le morceau ne s'arrête jamais tant que personne ne débranche la prise.
Le 2 novembre 2026, Rikiya Takehi, Jayden Teoh, Alex Zhang et Omar Khattab, du MIT CSAIL, ont publié un billet de blog sur ce qu'ils appellent la programmation dans l'espace des poids. Un grand modèle qu'ils appellent GPT-6 Astra a reçu un outil pour lire et modifier les nombres du petit modèle, ainsi que des problèmes d'entraînement absents du test. Avec un budget de 50 essais d'entraînement, il a localisé les boucles à deux endroits du modèle et a effacé ce schéma de 64 colonnes de nombres dans chacun. Cela fait 131 072 poids, soit 0,016 % du modèle.
Sur MATH-500, un jeu standard de 500 problèmes de maths de concours, les auteurs annoncent un passage de 7,9 % à 48,1 % de bonnes réponses, et les réponses coupées à la limite tombent de 93 % à 33,1 %. L'utilisateur de Hugging Face akhaliq a reconstruit le fichier du modèle modifié à partir de la modification publiée par les auteurs, a relancé les 500 problèmes et a obtenu 51,0 % de bonnes réponses, avec 31,6 % coupées à la limite. Nous avons repéré l'histoire dans la vidéo d'actualité AI Search du 8 novembre.
La modification n'apprend pas de nouveaux morceaux au groupe. Elle lui montre où le morceau se termine.
Notre test : 62 % de bonnes réponses contre 8 % sur une RTX 4090
Nous avons fait tourner les deux modèles côte à côte sur une seule RTX 4090 de 24 GB de notre cloud, chacun derrière son propre endpoint d'API, sur vLLM (le moteur de service open source utilisé par la reproduction d'akhaliq), avec le brouillon de réflexion activé et les réglages d'aléatoire des auteurs. Les questions étaient les 50 premiers problèmes de MATH-500 dans l'ordre de la reproduction d'akhaliq, un seul essai chacun, notés avec le script des auteurs.
| Modifié | Base | |
|---|---|---|
| Bonnes réponses | 31 sur 50 (62 %) | 4 sur 50 (8 %) |
| Coupées à 32 768 tokens | 10 (20 %) | 48 (96 %) |
| Tokens moyens par réponse | 20 444 | 31 832 |
Nos 62 % dépassent les deux chiffres publiés, et c'est le petit échantillon qui parle : sur ces mêmes 50 problèmes, la reproduction d'akhaliq tournait en moyenne à 54 %. Les 8 % et 96 % du modèle de base tombent pile sur les chiffres des auteurs.
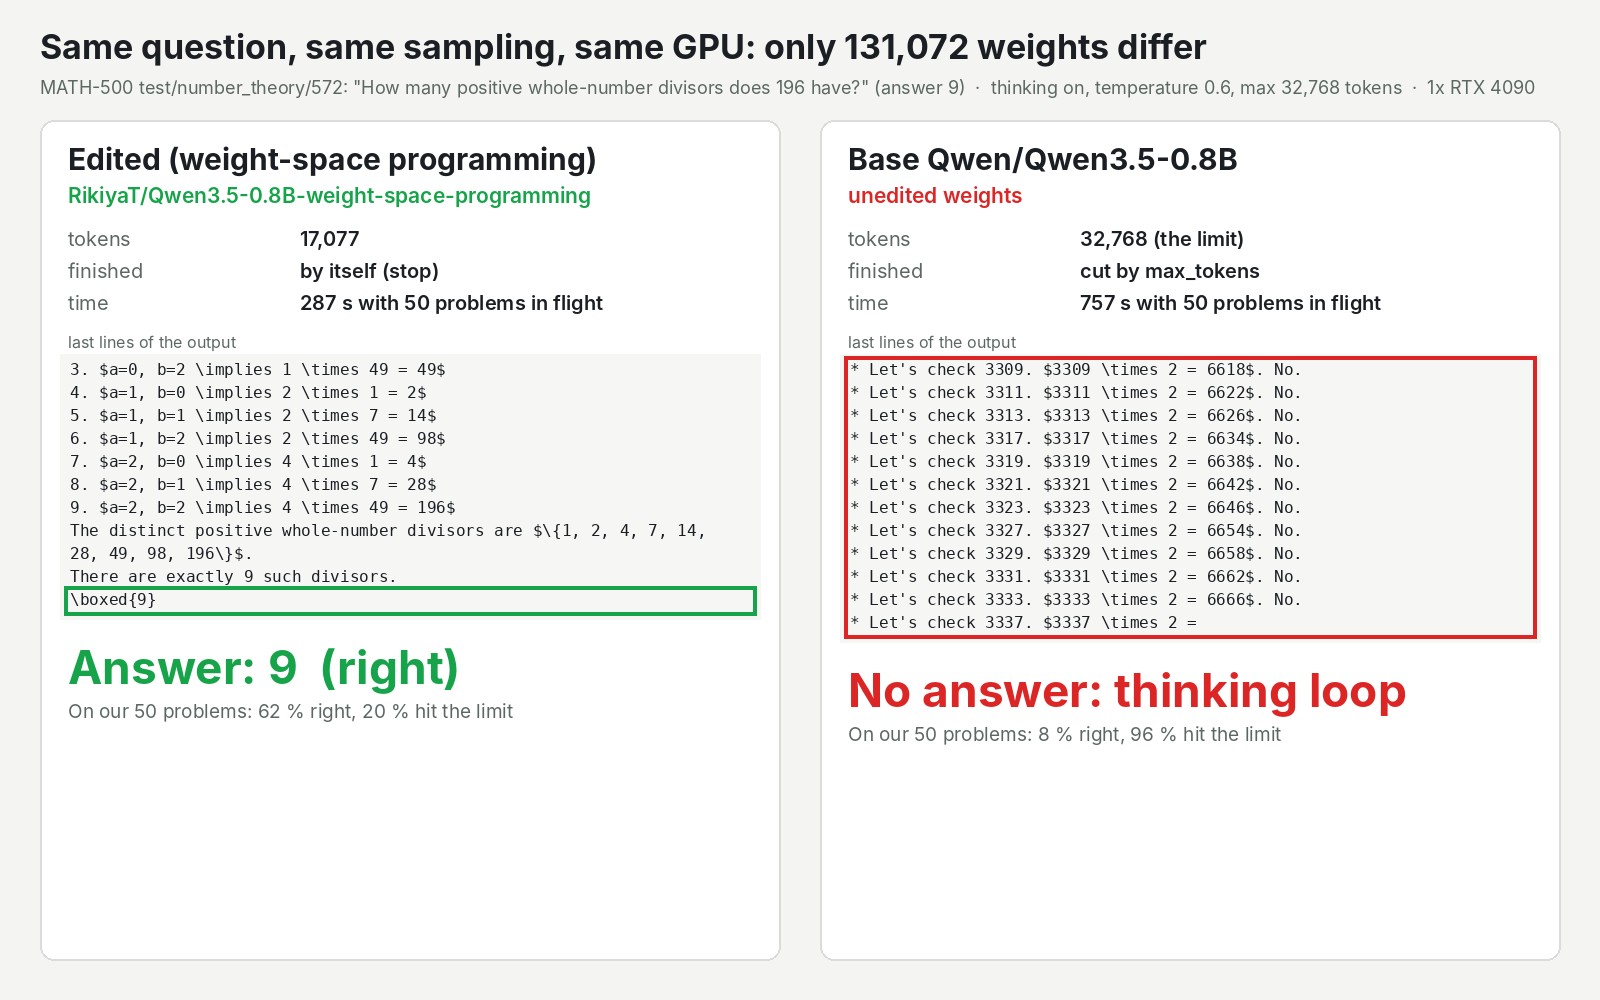
L'image ci-dessus montre l'écart sur une question : combien 196 a-t-il de diviseurs ? La réponse est 9. Le modèle modifié l'a trouvée et s'est arrêté. Le modèle de base s'est mis à énumérer des nombres au-delà de 3 300, un par un, et continuait encore quand la limite l'a coupé.
Pourquoi les boucles vous coûtent du temps de carte
Un GPU sert un nombre fixe de réponses à la fois. Avec le modèle de base, presque toutes ces places étaient coincées dans une boucle, jusqu'à 12,6 minutes sur la question des diviseurs, et finissaient le plus souvent sans réponse. Pour les mêmes 50 problèmes, le modèle modifié a écrit 1,02 million de tokens et le modèle de base 1,59 million. Par bonne réponse, cela donne environ 33 000 tokens contre 398 000, mais le chiffre du modèle de base ne repose que sur 4 bonnes réponses, donc prenez-le comme un ordre de grandeur.
Le modèle modifié n'est pas bon marché à faire tourner par réponse : il écrit toujours de longs brouillons, et une seule réponse prend environ une minute. Mais la plupart de ces minutes se terminent par un résultat.
Les deux modèles tiennent en même temps sur une seule carte de 24 GB, avec 16,9 GiB utilisés au pic, et tous deux étaient prêts 418 secondes après que nous les avons demandés sur une machine à froid. Seul, le modèle modifié a encore donné les 5 mêmes bonnes réponses sous un plafond de mémoire de 6 GB que nous avons fixé sur la 4090 ; à 4 GB, il n'a pas démarré. Il s'agissait de plafonds émulés, pas de vraies petites cartes.
Qui devrait s'y intéresser, et qui devrait attendre
- Les équipes qui servent déjà Qwen3.5-0.8B avec la réflexion activée pour des maths : essayez le remplacement. Même taille, même licence Apache-2.0, même moteur.
- Les équipes qui veulent les meilleures maths possibles d'un tout petit modèle : voyez-le comme une correction, pas comme une amélioration. Il fait ressortir ce que le modèle savait déjà.
- Les équipes avec un autre petit modèle qui boucle : c'est une méthode publiée avec ses journaux, pas un produit. Les auteurs l'ont essayée sur Gemma 3 270M, qui boucle rarement (8,5 % des réponses atteignent la limite), et il est resté entre 6,8 % et 7,7 % sur MATH-500. Selon leurs propres mots : "Editing weights could remove an obstacle that hid an ability, but it could not add an ability the model lacked."
- Les équipes qui préfèrent garder le modèle de base : la fiche de Qwen suggère une limite plus basse ou l'arrêt des boucles depuis le flux. Cela fait échouer une boucle plus tôt. Nous ne l'avons pas essayé, donc testez-le avant de remplacer les fichiers.
La limite honnête : nous avons lancé 50 problèmes une seule fois chacun, uniquement des maths avec la réflexion activée, donc nous n'avons vérifié ni le chat, ni le suivi d'instructions, ni la réflexion désactivée, ni les images sur le fichier modifié, et même modifié, un cinquième de ses réponses a encore bouclé.
Les plafonds de mémoire, les temps, le problème de streaming que vous allez rencontrer et l'exemple de SDK qui fait tourner les deux modèles sur votre propre GPU se trouvent dans le test complet de la modification des poids de Qwen3.5-0.8B.