Qwen3.5-0.8B mit 0,016 % bearbeiteten Gewichten beendet die meisten Denkschleifen: 62 % richtig gegen 8 %
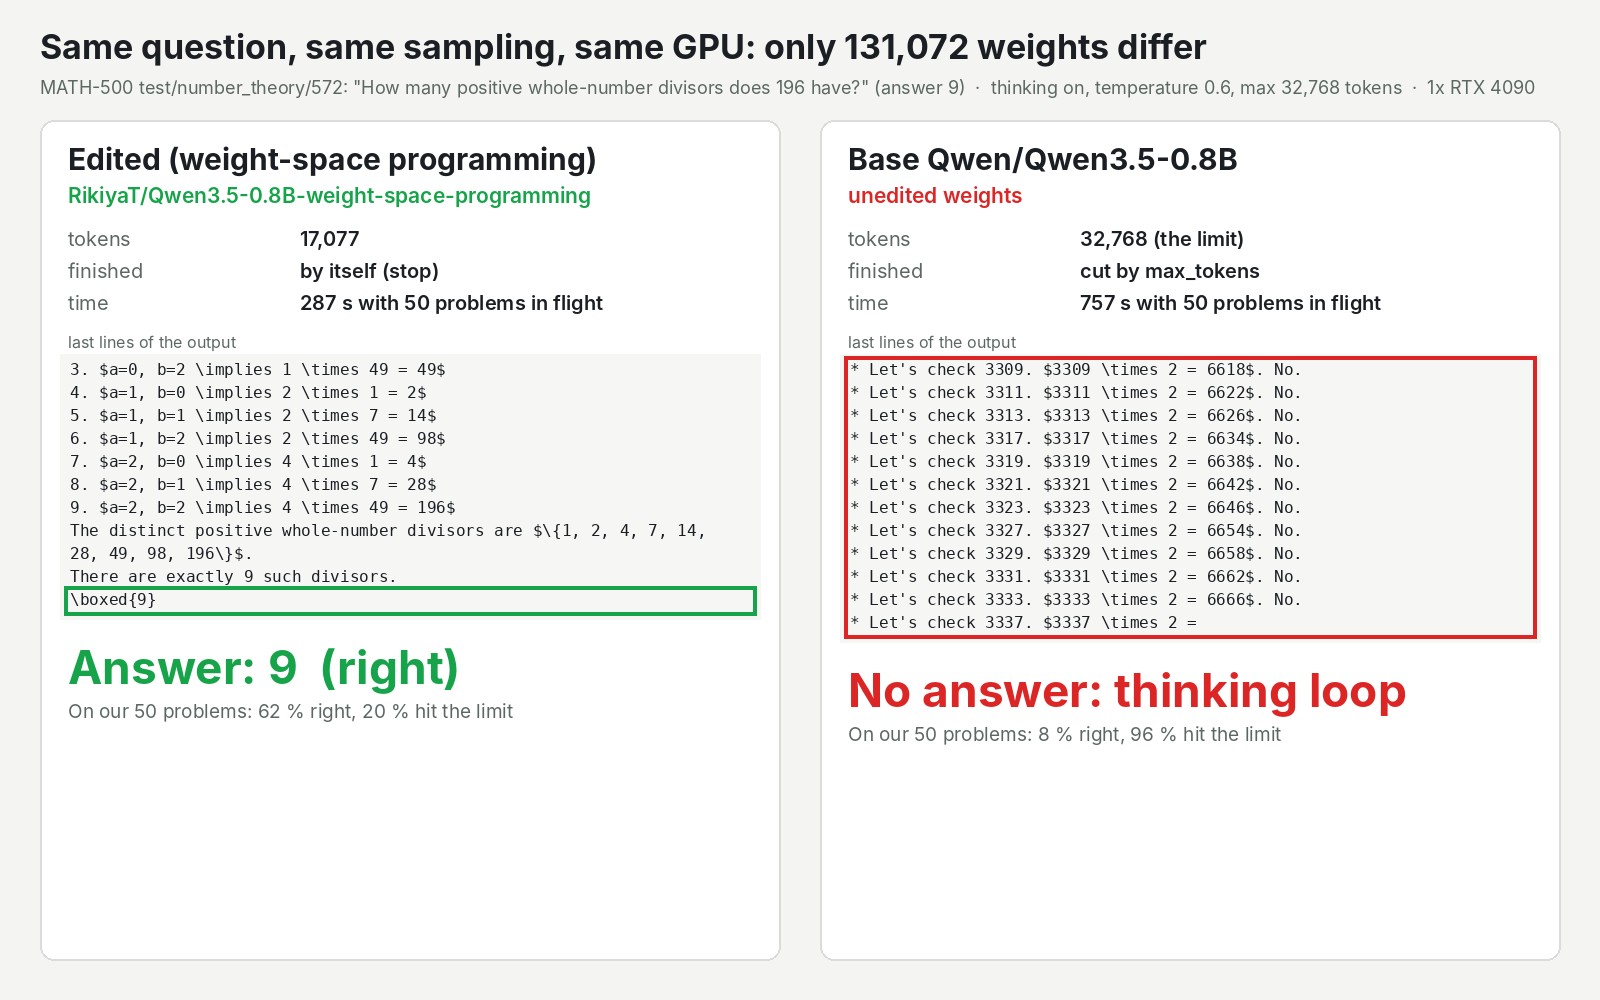
Dieselbe RTX 4090, dieselben 50 Matheaufgaben: Das bearbeitete Qwen3.5-0.8B lag zu 62 % richtig, die Basis zu 8 %, da 96 % ihrer Antworten bis zum Limit liefen.
Ein kleines Reasoning-Modell, das nie fertig wird, ist ein GPU-Slot, an dessen Ende keine Antwort steht. Genau das tat Qwen3.5-0.8B bei 96 % unserer Matheaufgaben: Es dachte im Kreis, bis das Limit von 32.768 Tokens (Tokens sind Wortstücke) es abschnitt. Dann haben wir eine bearbeitete Kopie desselben Modells betrieben, in der eine andere KI 0,016 % der Gewichte geändert hatte, ganz ohne Training. Dieselbe RTX 4090 in unserer Cloud, dieselben 50 Aufgaben, dieselben Einstellungen: Die bearbeitete Kopie lag zu 62 % richtig gegen 8 %, und nur 20 % ihrer Antworten liefen ins Limit. Wer kleine Reasoning-Modelle auf eigenen GPUs betreibt, für den geht es hier um Kartenzeit genauso wie um Genauigkeit. Die bearbeitete Datei lädt und läuft mit demselben Befehl wie das Basismodell, ausprobieren heißt also: eine Datei austauschen. Getestet haben wir Mathe mit eingeschaltetem Thinking, sonst nichts.
Eine Band, die den Schluss nicht findet
Qwen3.5-0.8B ist ein kleines offenes Modell mit etwa 0,8 Milliarden gelernten Zahlen (den Gewichten). Bevor es antwortet, schreibt es einen Notizblock: Es denkt laut und liefert dann das Ergebnis. Qwens eigene Modellkarte warnt, diese Größe sei "more prone to entering thinking loops" als ihre Geschwister. Jede Note sitzt, aber der Song endet erst, wenn jemand den Stecker zieht.
Am 2. November 2026 veröffentlichten Rikiya Takehi, Jayden Teoh, Alex Zhang und Omar Khattab vom MIT CSAIL einen Blogpost über das, was sie Weight-Space Programming nennen. Ein großes Modell, das sie GPT-6 Astra nennen, bekam ein Tool, um die Zahlen des kleinen Modells zu lesen und zu ändern, dazu Übungsaufgaben, die nicht im Test vorkamen. Mit einem Budget von 50 Übungsläufen führte es die Schleifen auf zwei Stellen im Modell zurück und löschte dort jeweils das Muster aus 64 Spalten von Zahlen. Das sind 131.072 Gewichte, 0,016 % des Modells.
Auf MATH-500, einem Standardsatz von 500 Wettbewerbs-Matheaufgaben, berichten die Autoren einen Sprung von 7,9 % auf 48,1 % richtige Antworten, während der Anteil der am Limit abgeschnittenen Antworten von 93 % auf 33,1 % fiel. Der Hugging-Face-Nutzer akhaliq hat die bearbeitete Modelldatei aus der veröffentlichten Änderung der Autoren nachgebaut, alle 500 Aufgaben erneut laufen lassen und 51,0 % richtig erreicht, mit 31,6 % am Limit abgeschnitten. Entdeckt haben wir die Geschichte im News-Video von AI Search vom 8. November.
Die Bearbeitung bringt der Band keine neuen Songs bei. Sie zeigt ihr, wo der Song endet.
Unser Test: 62 % richtig gegen 8 % auf einer RTX 4090
Wir haben beide Modelle nebeneinander auf einer einzigen RTX 4090 mit 24 GB in unserer Cloud betrieben, jedes hinter einem eigenen API-Endpunkt, auf vLLM (der Open-Source-Serving-Engine, die auch akhaliqs Nachlauf verwendet hat), mit eingeschaltetem Thinking-Notizblock und den Zufallseinstellungen der Autoren. Die Fragen waren die ersten 50 MATH-500-Aufgaben in der Reihenfolge von akhaliqs Nachlauf, ein Versuch pro Aufgabe, bewertet mit dem Skript der Autoren.
| Bearbeitet | Basis | |
|---|---|---|
| Richtig | 31 von 50 (62 %) | 4 von 50 (8 %) |
| Abgeschnitten bei 32.768 Tokens | 10 (20 %) | 48 (96 %) |
| Tokens pro Antwort im Schnitt | 20.444 | 31.832 |
Unsere 62 % liegen über beiden veröffentlichten Werten, und das liegt an der kleinen Stichprobe: Bei denselben 50 Aufgaben kam akhaliqs Nachlauf im Schnitt auf 54 %. Die 8 % und 96 % des Basismodells liegen genau auf den Werten der Autoren.
Das Bild oben zeigt den Unterschied an einer Frage: Wie viele Teiler hat 196? Die Antwort ist 9. Das bearbeitete Modell fand sie und hörte auf. Das Basismodell fing an, Zahlen jenseits von 3.300 eine nach der anderen aufzuzählen, und war noch dabei, als das Limit es abschnitt.
Warum die Schleifen Sie Kartenzeit kosten
Eine GPU bedient eine feste Zahl von Antworten gleichzeitig. Beim Basismodell steckte fast jeder dieser Plätze in einer Schleife fest, bei der Teiler-Frage bis zu 12,6 Minuten lang, und endete meist ohne Antwort. Für dieselben 50 Aufgaben schrieb das bearbeitete Modell 1,02 Millionen Tokens, das Basismodell 1,59 Millionen. Pro richtiger Antwort sind das etwa 33.000 Tokens gegen 398.000, wobei der Wert des Basismodells auf nur 4 richtigen Antworten beruht, nehmen Sie ihn also als grobe Größe.
Billig pro Antwort ist das bearbeitete Modell nicht: Es schreibt immer noch lange Notizblöcke, und eine einzelne Antwort dauert etwa eine Minute. Aber die meisten dieser Minuten enden mit einem Ergebnis.
Beide Modelle passen gleichzeitig auf eine Karte mit 24 GB, mit 16,9 GiB in der Spitze, und beide waren 418 Sekunden, nachdem wir sie auf einer kalten Maschine angefordert hatten, bereit. Allein lieferte das bearbeitete Modell auch unter einer Speichergrenze von 6 GB, die wir auf der 4090 gesetzt hatten, dieselben 5 richtigen Antworten; bei 4 GB startete es nicht. Das waren emulierte Grenzen, keine echten kleinen Karten.
Für wen das relevant ist und wer warten sollte
- Teams, die Qwen3.5-0.8B schon mit eingeschaltetem Thinking für Mathe betreiben: Probieren Sie den Austausch. Dieselbe Größe, dieselbe Apache-2.0-Lizenz, dieselbe Engine.
- Teams, die aus einem winzigen Modell das beste Mathe herausholen wollen: Sehen Sie es als Reparatur, nicht als Upgrade. Es bringt zum Vorschein, was das Modell schon konnte.
- Teams mit einem anderen kleinen Modell, das in Schleifen läuft: Das ist eine veröffentlichte Methode mit Logs, kein Produkt. Die Autoren haben sie an Gemma 3 270M ausprobiert, das selten in Schleifen läuft (8,5 % der Antworten erreichten das Limit), und es blieb auf MATH-500 zwischen 6,8 % und 7,7 %. In ihren Worten: "Editing weights could remove an obstacle that hid an ability, but it could not add an ability the model lacked."
- Teams, die lieber beim Basismodell bleiben: Qwens Karte schlägt ein niedrigeres Limit vor oder das Abbrechen von Schleifen aus dem Stream. Damit scheitert eine Schleife früher. Wir haben das nicht ausprobiert, testen Sie es also, bevor Sie Dateien austauschen.
Die ehrliche Grenze: Wir haben 50 Aufgaben je einmal laufen lassen, nur Mathe mit eingeschaltetem Thinking. Chat, Befolgen von Anweisungen, ausgeschaltetes Thinking und Bilder haben wir an der bearbeiteten Datei also nicht geprüft, und selbst bearbeitet lief noch ein Fünftel ihrer Antworten in Schleifen.
Die Speichergrenzen, die Zeiten, das eine Streaming-Problem, auf das Sie stoßen werden, und das SDK-Beispiel, das beide Modelle auf Ihrer eigenen GPU betreibt, stehen im vollständigen Test der Gewichtsbearbeitung von Qwen3.5-0.8B.