Ein privates ChatGPT für fünfzig Teams und eine Rechnung, die sich aufteilen lässt
Ein privater KI-Assistent bedient fünfzig Teams über eine Adresse, und seine festen Stundenkosten werden zur Rechnung pro Team. Eine Demo, mit Grenzen.
Ankündigungen von InferenceKey, Kommentare zu KI-News und Zusammenfassungen lesenswerter Paper.
Ein privater KI-Assistent bedient fünfzig Teams über eine Adresse, und seine festen Stundenkosten werden zur Rechnung pro Team. Eine Demo, mit Grenzen.
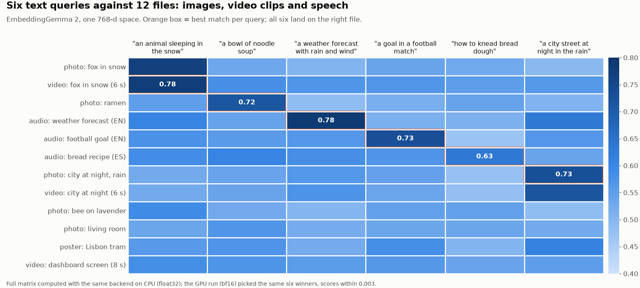
Googles EmbeddingGemma 2 legt Text, Bilder, Video und Audio in einen Suchraum. Auf unserer RTX 2000 Ada mit 16 GB belegte es 1.4 GB.
Kandinsky 6.0 erzeugt 5-Sekunden-Clips mit synchronem Ton unter MIT. Minuten pro Clip auf sieben GPUs, und warum jeder Lauf Offload nutzt.
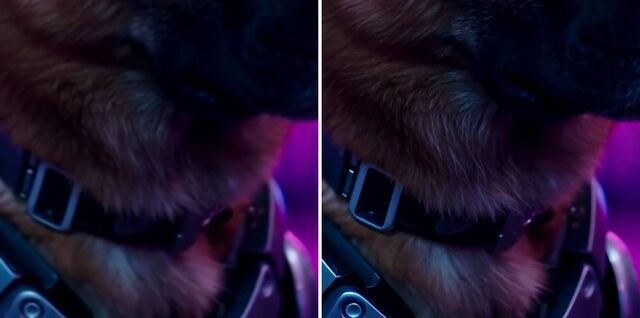
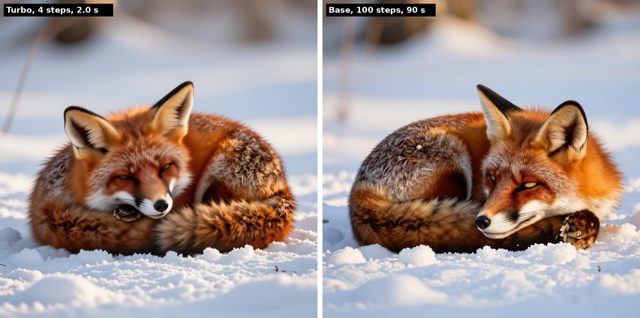
Iris-3B ist ein offenes Bildmodell, das die Pixel selbst zeichnet. Wir haben die schnelle Turbo-Version auf InferenceKey betrieben: etwa 2 s pro Bild, A40.
BAAIs AREX-2 (Apache 2.0) teilt die Architektur von Qwen3.8-27B. Was unsere sglang-Läufe dazu sagen: VRAM, Quants, GPUs, und was ungetestet ist.
Qwen3 Coder Next (80B, AWQ 4-bit) auf vLLM, eine A100 80 GB für $1.79/h, ein API-Key für einen Entwickler und Claude Code. Befehle, Zahlen, Grenzen.