Ein privates ChatGPT für fünfzig Teams und eine Rechnung, die sich aufteilen lässt
Ein privater KI-Assistent bedient fünfzig Teams über eine Adresse, und seine festen Stundenkosten werden zur Rechnung pro Team. Eine Demo, mit Grenzen.
Wenn ein Unternehmen beschließt, seinen eigenen KI-Assistenten zu betreiben, gilt die erste Sorge meist dem Modell: Ist ein offenes Modell gut genug? Die schwierigeren Fragen kommen oft erst, wenn der Assistent läuft: Wie lässt man weitere Teams rein, wenn die Maschinen voll sind, und wie sagt man der Finanzabteilung, welches Team was ausgegeben hat?
Diese Demo beantwortet beides: wie ein privater Assistent von einem Team auf fünfzig wachsen kann, ohne neu gebaut zu werden, und wie seine Kosten dabei fest, planbar und nach Teams aufgeteilt bleiben.
Das Video (2:47, mit Sprecherstimme) begleitet Nexora, ein mittelgroßes Unternehmen, das wir erfunden haben. Nexora will seine Verträge, Support-Tickets und Finanzprognosen nicht an einen öffentlichen KI-Dienst schicken, also betreibt es in der Geschichte seinen eigenen Assistenten auf zehn gemieteten Maschinen in Frankfurt, jede mit einer Nvidia H100 (einem KI-Chip der Oberklasse), und liefert ihn mit InferenceKey aus. Jede Abteilung ruft dasselbe Modell mit ihren eigenen Keys auf.
Die Sprecherstimme spielt das Szenario ganz ernsthaft durch, deshalb sagen wir es gleich vorweg: Die Maschinen in diesem Video sind simuliert. Das Panel, die Keys, die Warteschlange und die Abrechnung sind das echte Produkt. Die zehn „H100-Server“ sind Programme im Testmodus, die sich wie GPU-Server verhalten, aber mit Fülltext antworten, statt ein Modell laufen zu lassen. Der Abschnitt über die Grenzen sagt, was das für jede einzelne Zahl bedeutet.
Das hat das Panel gezeigt:
| Was | In der Demo |
|---|---|
| Keys, einer pro Team oder Anwendungsfall | 50 |
| Was jeder Key erreicht | 1 Adresse, den Firmenchat |
| Maschinen, die das Modell ausliefern | 10, alle online, 0 Warnungen |
| Dauerlast aus dem Testskript | etwa 4.200 Anfragen pro Minute |
| Kosten für zehn Maschinen, den ganzen Monat eingeschaltet | etwa $17.500, egal wie viel Traffic |
| Erfasste Kosten, solange die Demo-Flotte existierte | $326,97 für 134,53 Maschinenstunden, aufgeteilt nach Key |
Die Idee, die den Rest einfach macht
Eine gemietete GPU-Maschine wird pro Stunde abgerechnet, wie ein Proberaum. Du zahlst für den Raum, ob die Band einen Song spielt oder vierzig. Eine öffentliche KI-API ist das Gegenteil: Sie rechnet pro Wort ab, also kostet jede zusätzliche Frage mehr. Abos pro Nutzer verstecken das, bis jemand an ein Nutzungslimit stößt.
Das ändert, was „Kosten im Griff behalten“ bedeutet. Mit eigenen Maschinen steht die Rechnung für den Monat vorher fest. In dieser Demo sind es zehn Maschinen zu je $1.750 im Monat, also etwa $17.500 im Monat oder $24,31 pro Stunde, egal wie viel die Teams tippen. Zwei Dinge bleiben zu managen: die Maschinen auszulasten, denn eine Leerlaufstunde kostet genauso viel wie eine volle, und zu wissen, wer sie genutzt hat, damit jedes Team seinen Anteil sieht. Der Rest der Demo zeigt genau diese zwei Dinge auf dem Bildschirm.
Ein Key pro Team
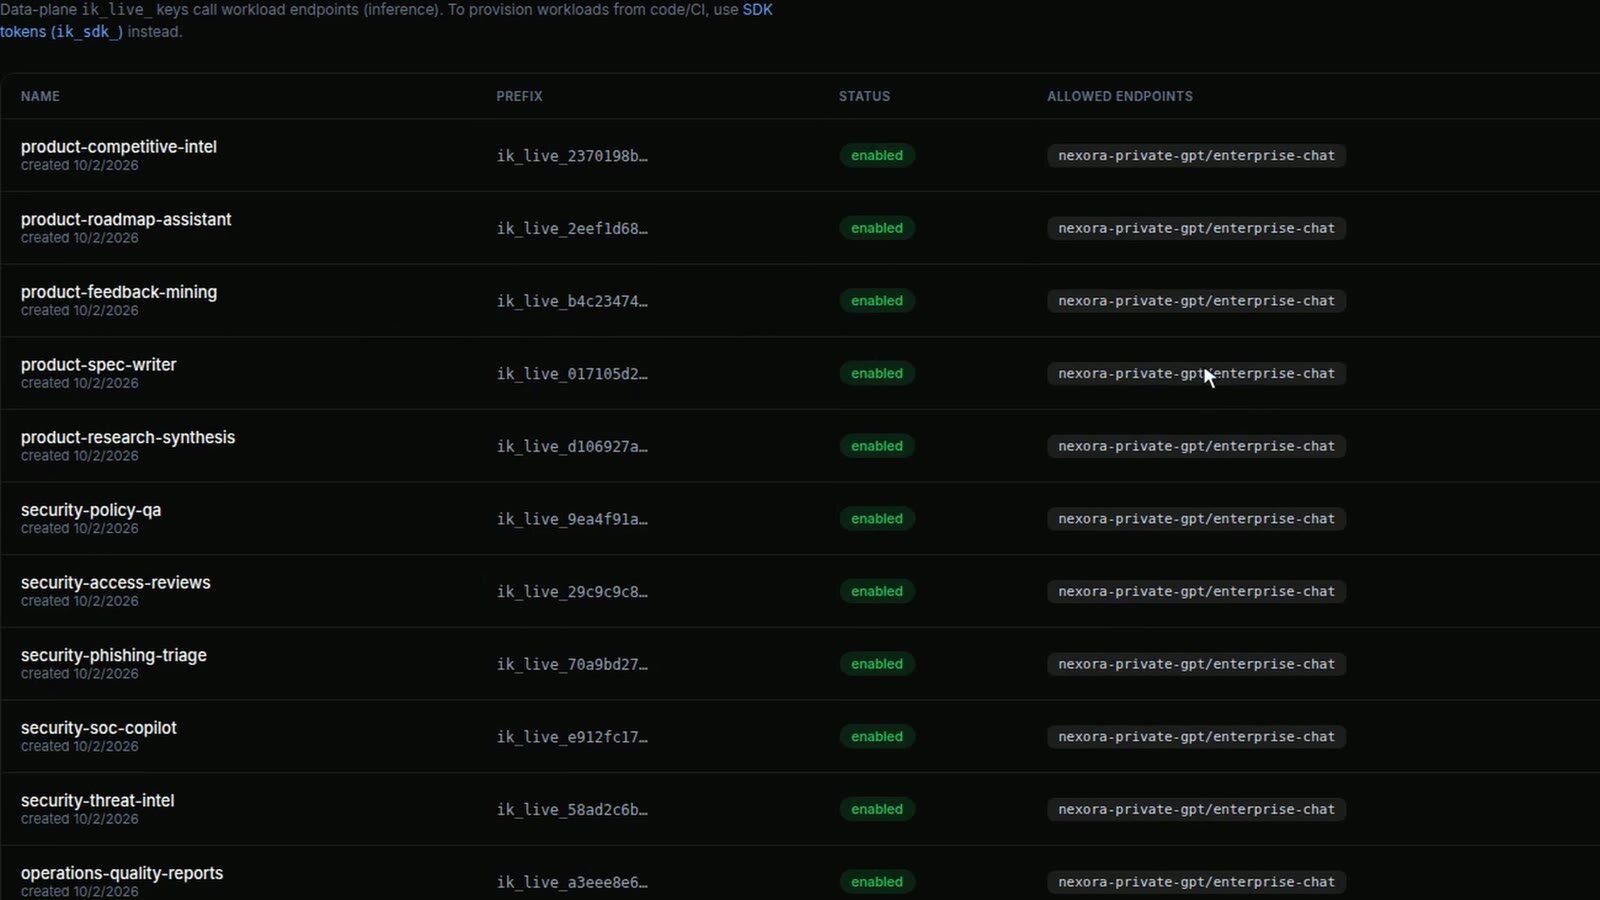
Ein Key ist ein Passwort, mit dem ein Programm den Assistenten aufruft. Jedes Team bekommt seinen eigenen, und oft bekommt auch jeder Anwendungsfall innerhalb eines Teams einen: Das Produktteam hat Keys für Wettbewerbsanalyse, die Roadmap und Spezifikationen, Security hat einen eigenen Satz, und so weiter über Operations, Finanzen, Support und Personal. Insgesamt fünfzig. Jeder Key öffnet eine einzige Tür, die Adresse des Firmenchats, ein geleakter Key kommt also an nichts anderes heran, was Nexora auf der Plattform betreibt.
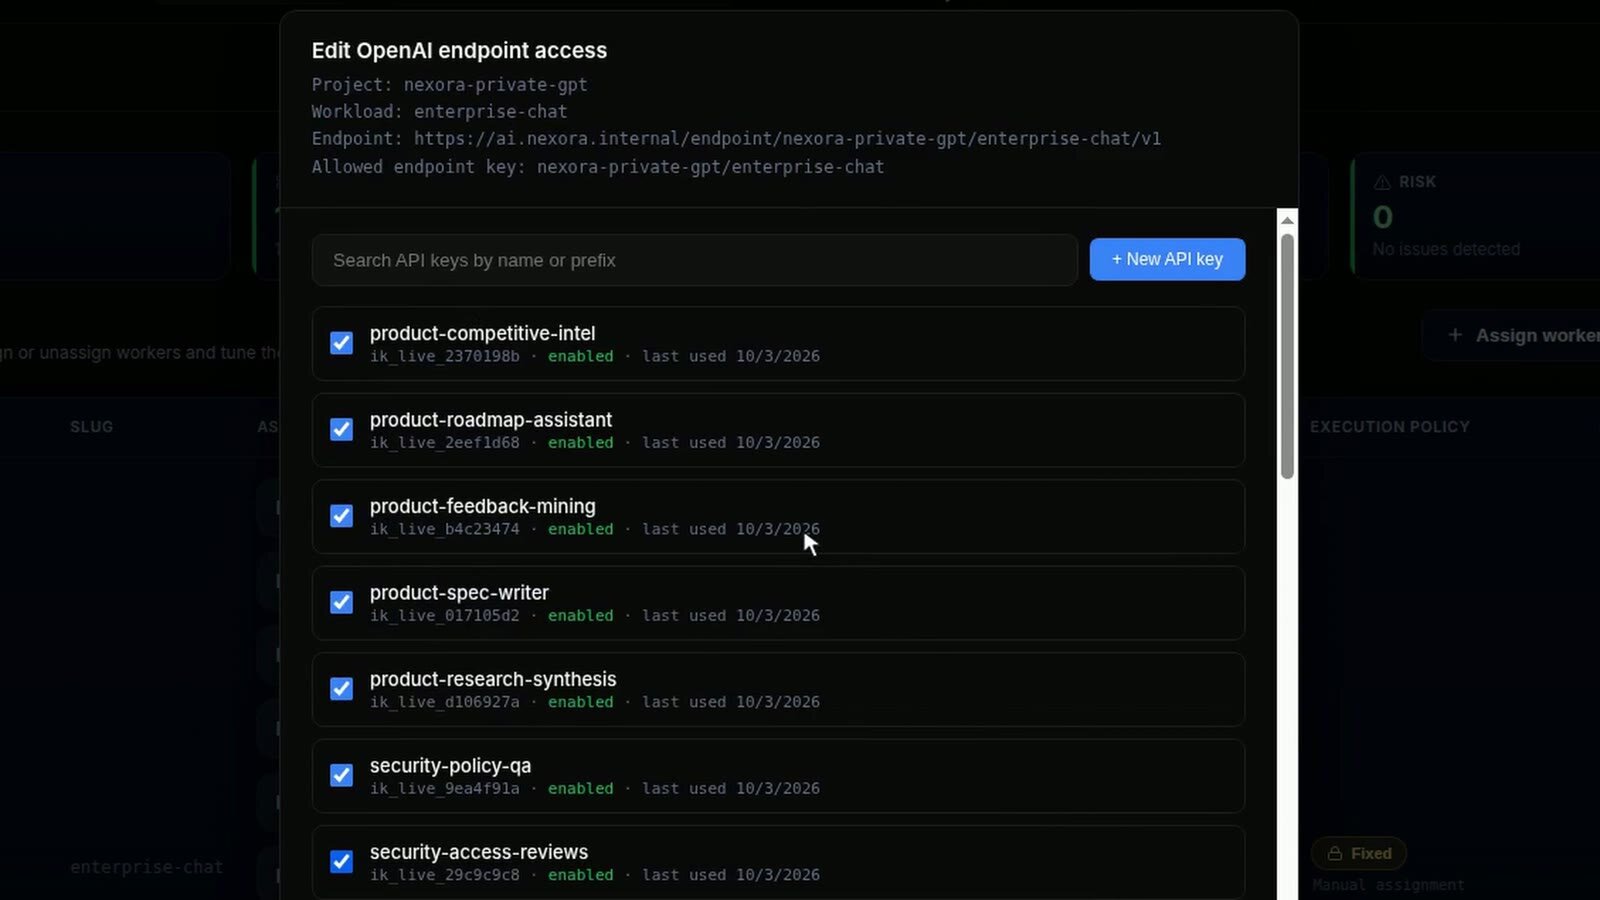
Der Zugang ist eine Liste von Checkboxen an dieser Adresse. In dieser Demo gibt es kein Chatfenster: Die Adresse spricht dasselbe Format wie die OpenAI-API, also kann jede Chat-App und jedes interne Tool, das schon mit OpenAI funktioniert, sie nutzen, wenn man Adresse und Key austauscht. Ein Team hinzufügen heißt, einen Key anzulegen und anzuhaken. Ein Team entfernen heißt, den Haken rauszunehmen oder seinen Key zu deaktivieren.
Ein Modell, zehn Maschinen
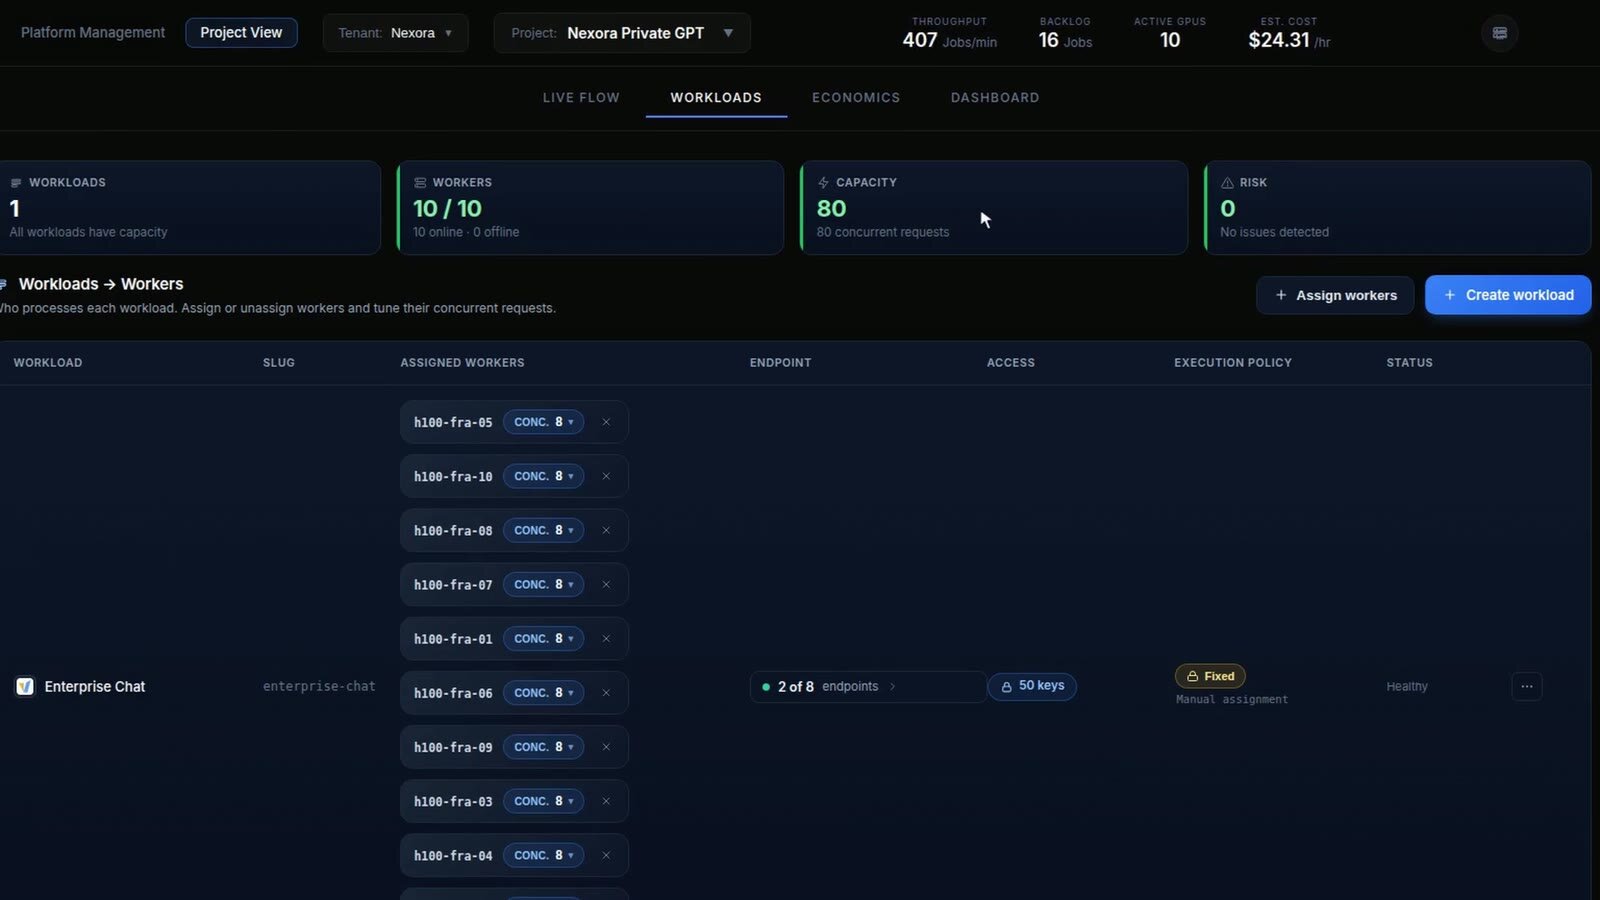
Hinter dieser Adresse läuft ein Modell, der Firmenchat. Zehn Maschinen liefern es aus (in der Geschichte jede mit ihrer eigenen Kopie des Modells), und das Panel nennt jede Maschine einen Worker. Jeder Worker nimmt acht Anfragen gleichzeitig an, die Flotte kann also an 80 Anfragen auf einmal arbeiten.
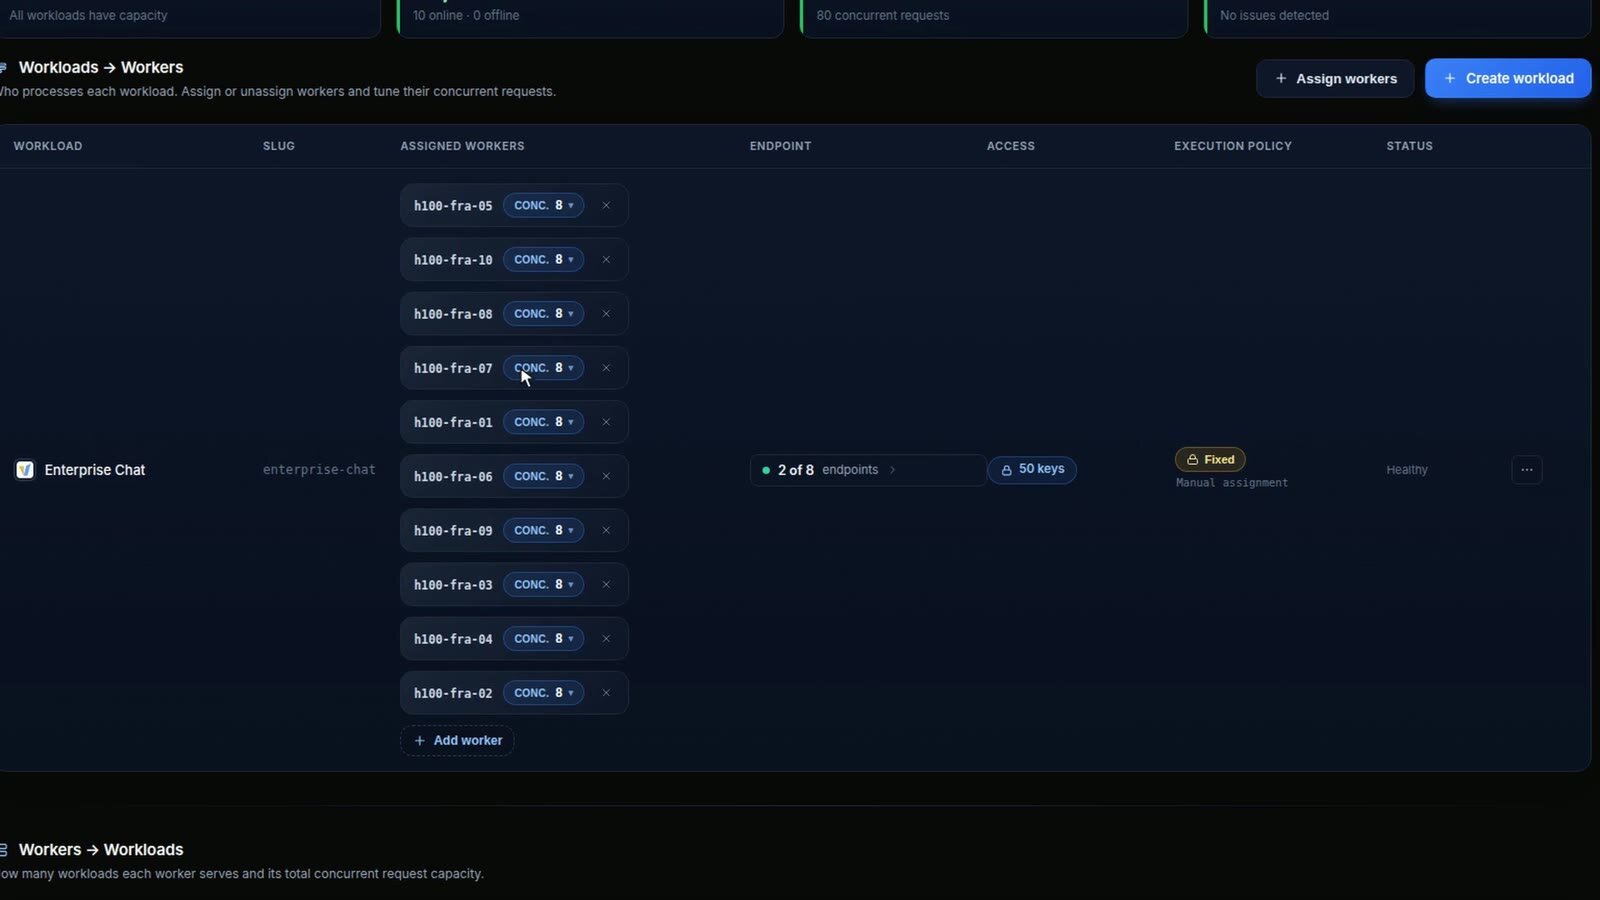
In dieser Zeile wächst du. Am ersten Tag sind es vielleicht ein Team, ein Key und eine oder zwei Maschinen. Jedes neue Team bringt einen Key und einen Haken dazu. Wenn die Warteschlange zu wachsen beginnt, setzt der Button „Add worker“ unter der Liste eine weitere Maschine auf das Modell: Du wählst eine registrierte Maschine oder deployst eine neue Cloud-GPU und legst fest, wie viele Anfragen sie gleichzeitig annimmt. Eine weitere Maschine wie diese zehn bringt acht gleichzeitige Anfragen mehr, für weitere $1.750 im Monat. Die Teams behalten ihren Key und ihre Adresse. Die Rechnung wächst also in Stufen, die du wählst, Maschine für Maschine, und nur, wenn die Warteschlange danach verlangt. In dieser Aufnahme haben wir den Button nicht gedrückt. Eine Maschine unter Live-Traffic hinzuzufügen ist ein Video, das wir noch aufnehmen müssen.
Die Last verteilt sich von selbst
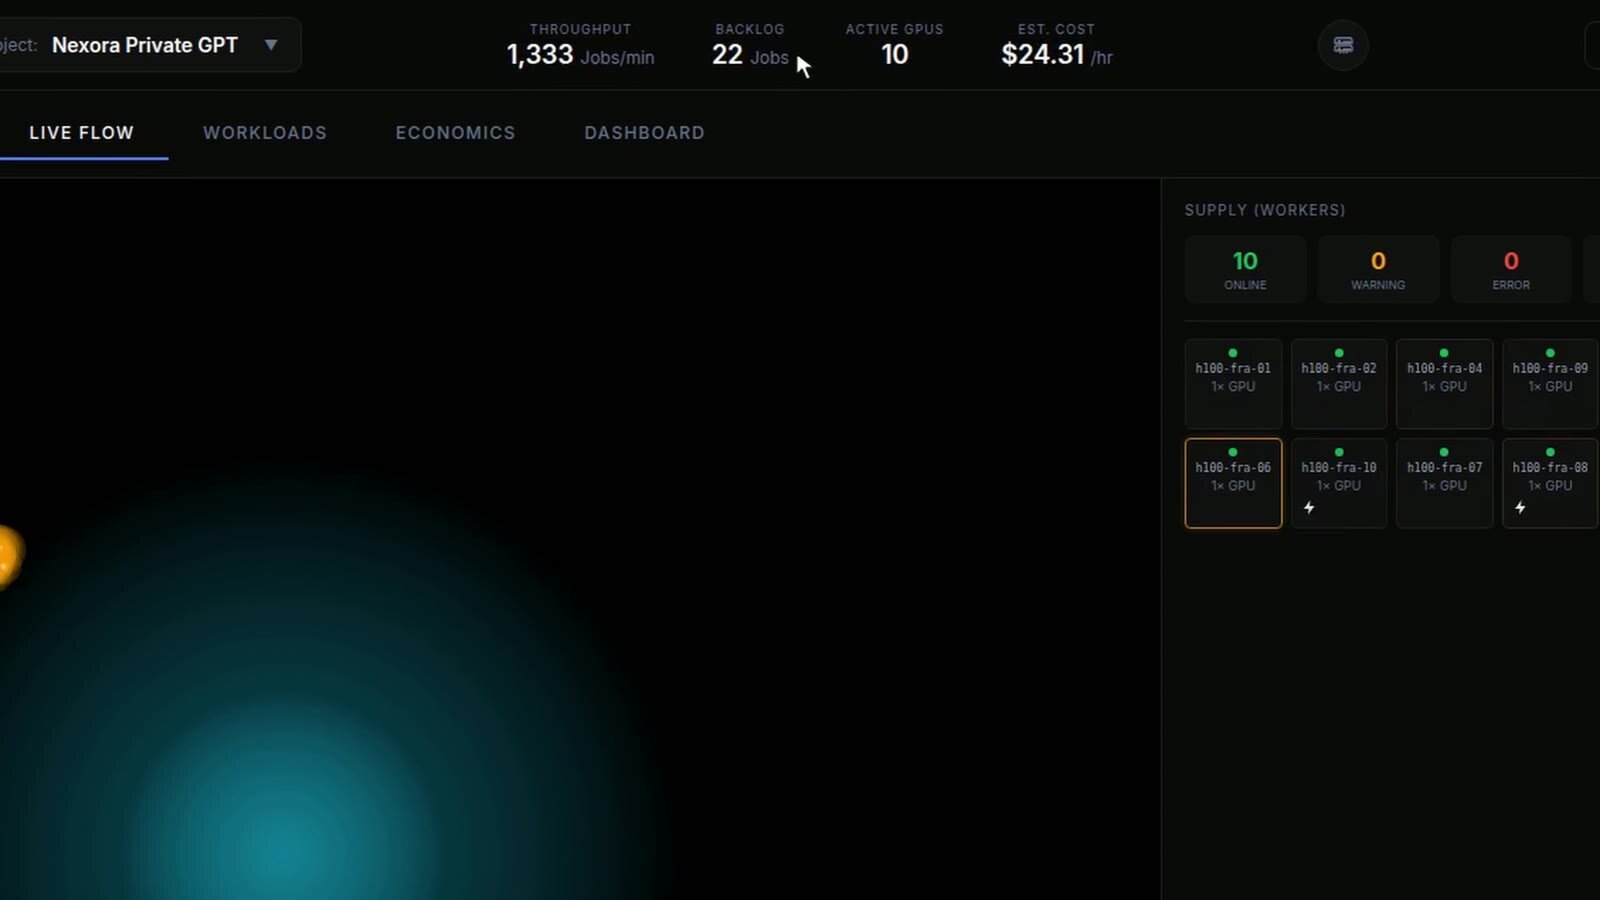
Das Testskript hielt eine Dauerlast von etwa 70 Anfragen pro Sekunde, rund 4.200 pro Minute, verteilt auf die fünfzig Keys, wobei ein paar Teams deutlich mehr los hatten als der Rest. Der Zähler in der oberen Leiste zeigt in diesem Screenshot weniger an, weil er jedes Mal bei null anfängt, wenn eine Seite geöffnet wird. Daneben: zwischen 8 und 28 Anfragen, die darauf warten, dranzukommen, zehn aktive Maschinen und $24,31 pro Stunde.
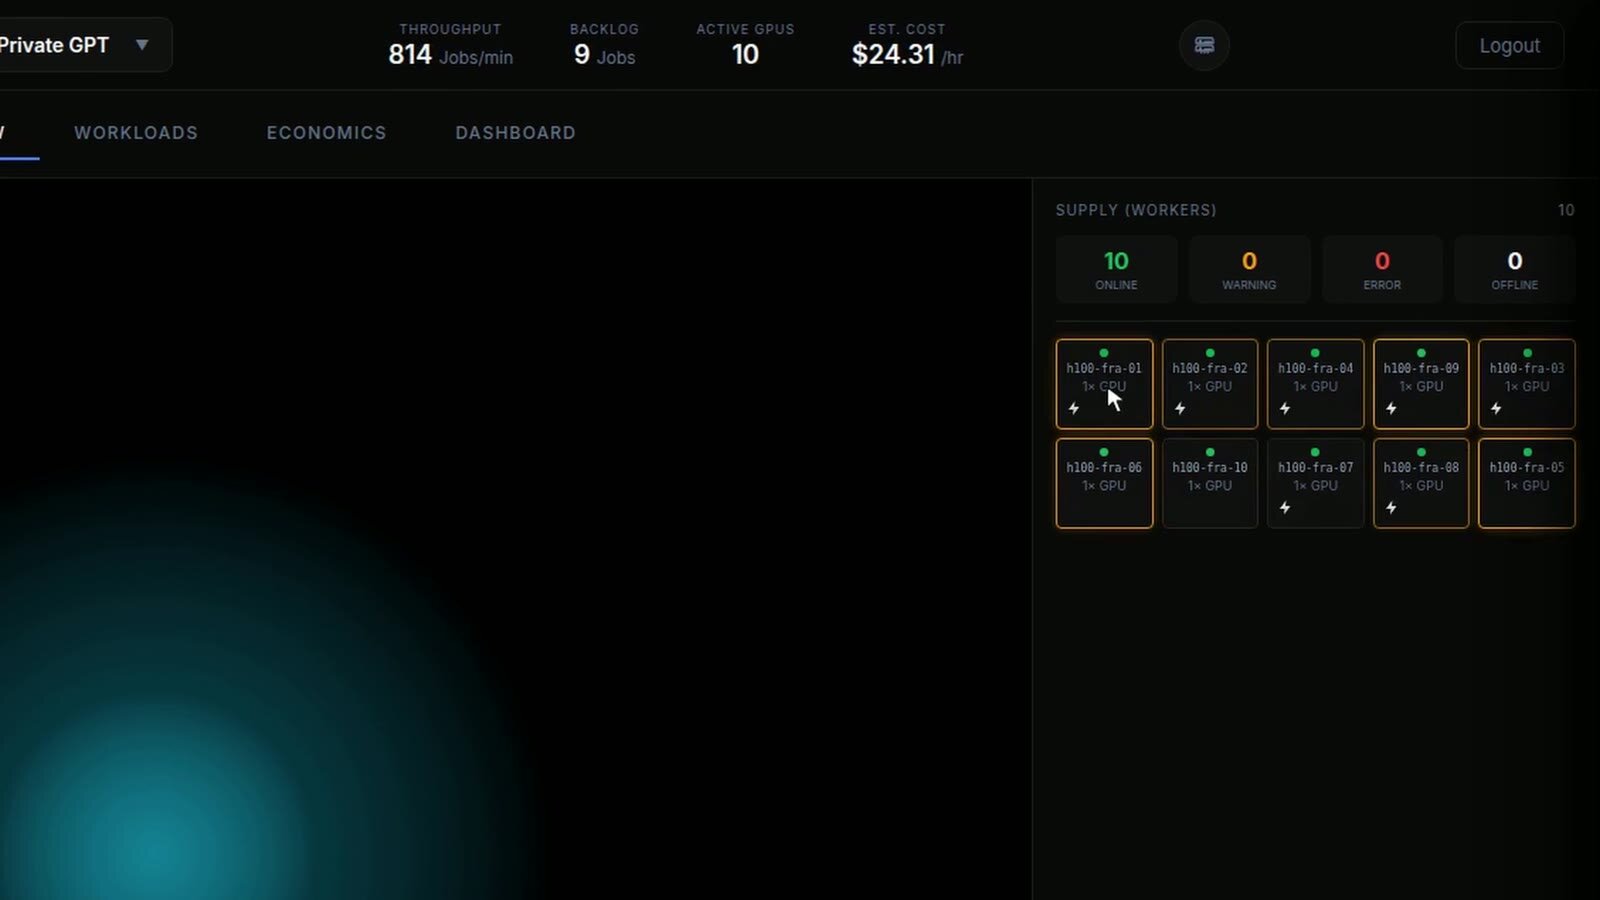
Das Supply-Panel zeigt die zehn Maschinen. Die hervorgehobenen arbeiten in diesem Moment an einer Anfrage, und die Hervorhebung springt von einer zur nächsten, während Anfragen eintreffen. Du wählst, welche Maschinen das Modell ausliefern, aber nicht, welche Maschine welche Anfrage übernimmt: Die Anfragen von fünfzig Teams landen in einer Warteschlange, und die Maschine, die gerade einen freien Platz hat, nimmt die nächste.
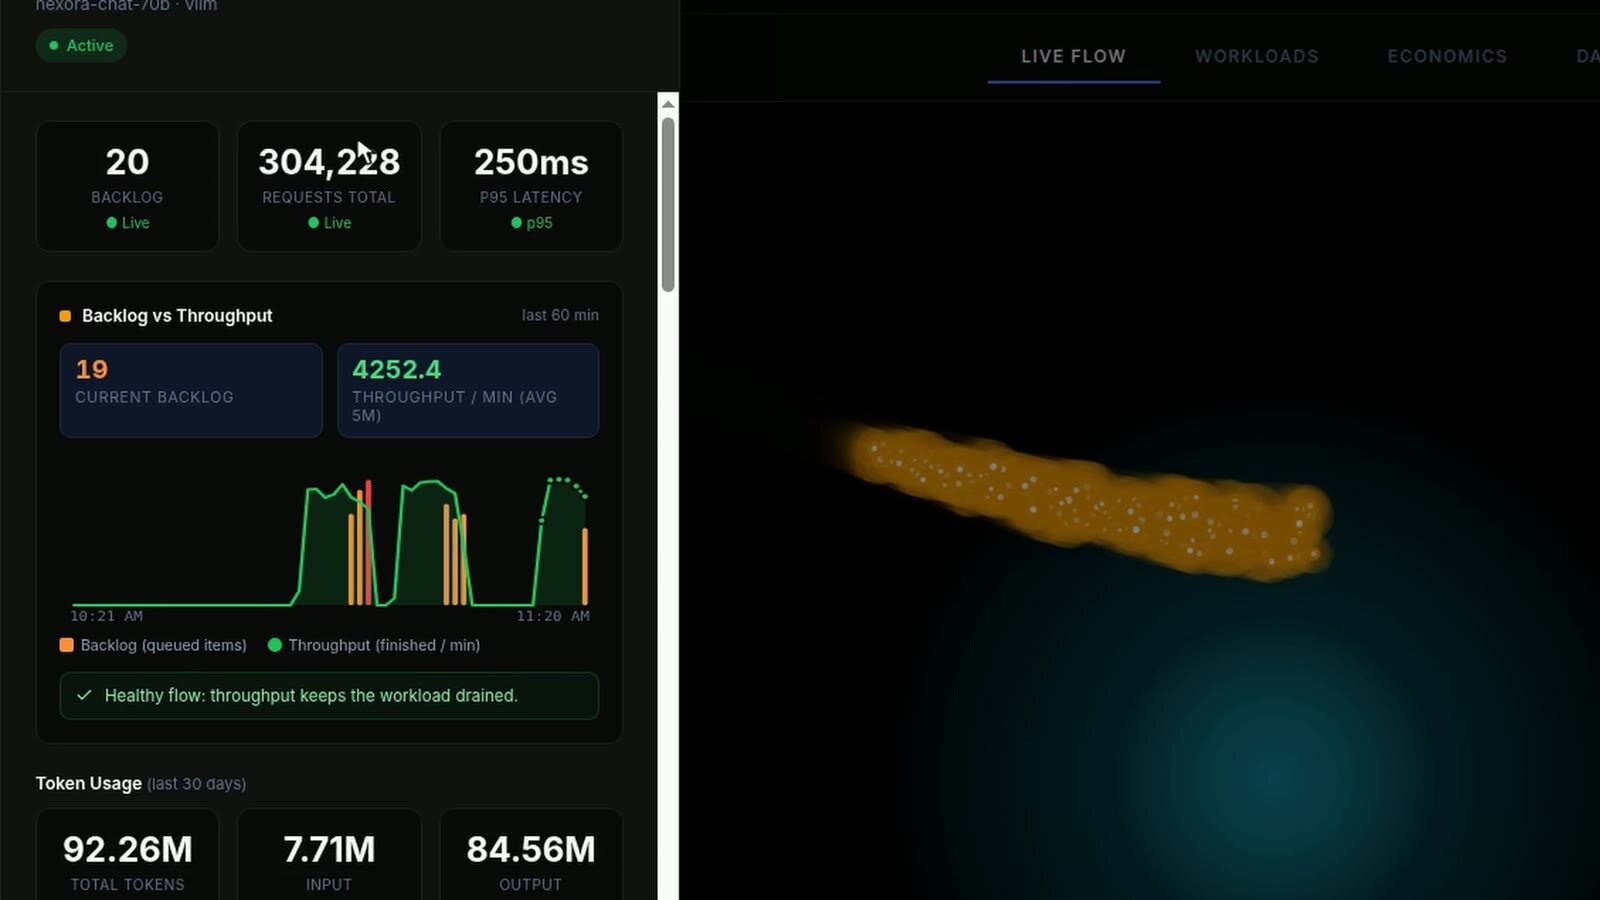
Öffne das Modell, und das Panel beantwortet die Frage, die ein Operator als Erstes stellt: Ist die Warteschlange unter Kontrolle? Das Diagramm zeigt zwei Dinge: wie viele Anfragen warten (Balken) und wie viele pro Minute erledigt werden (Linie), im Schnitt 4.252 über die letzten fünf Minuten. Unter dem Diagramm steht „Healthy flow“, solange die Warteschlange in den letzten Minuten nicht gewachsen ist. Fängt sie an zu wachsen, wechselt das Label auf „At risk“ oder „Critical“, das Zeichen, dass das Modell eine weitere Maschine braucht.
Die Rechnung, pro Team
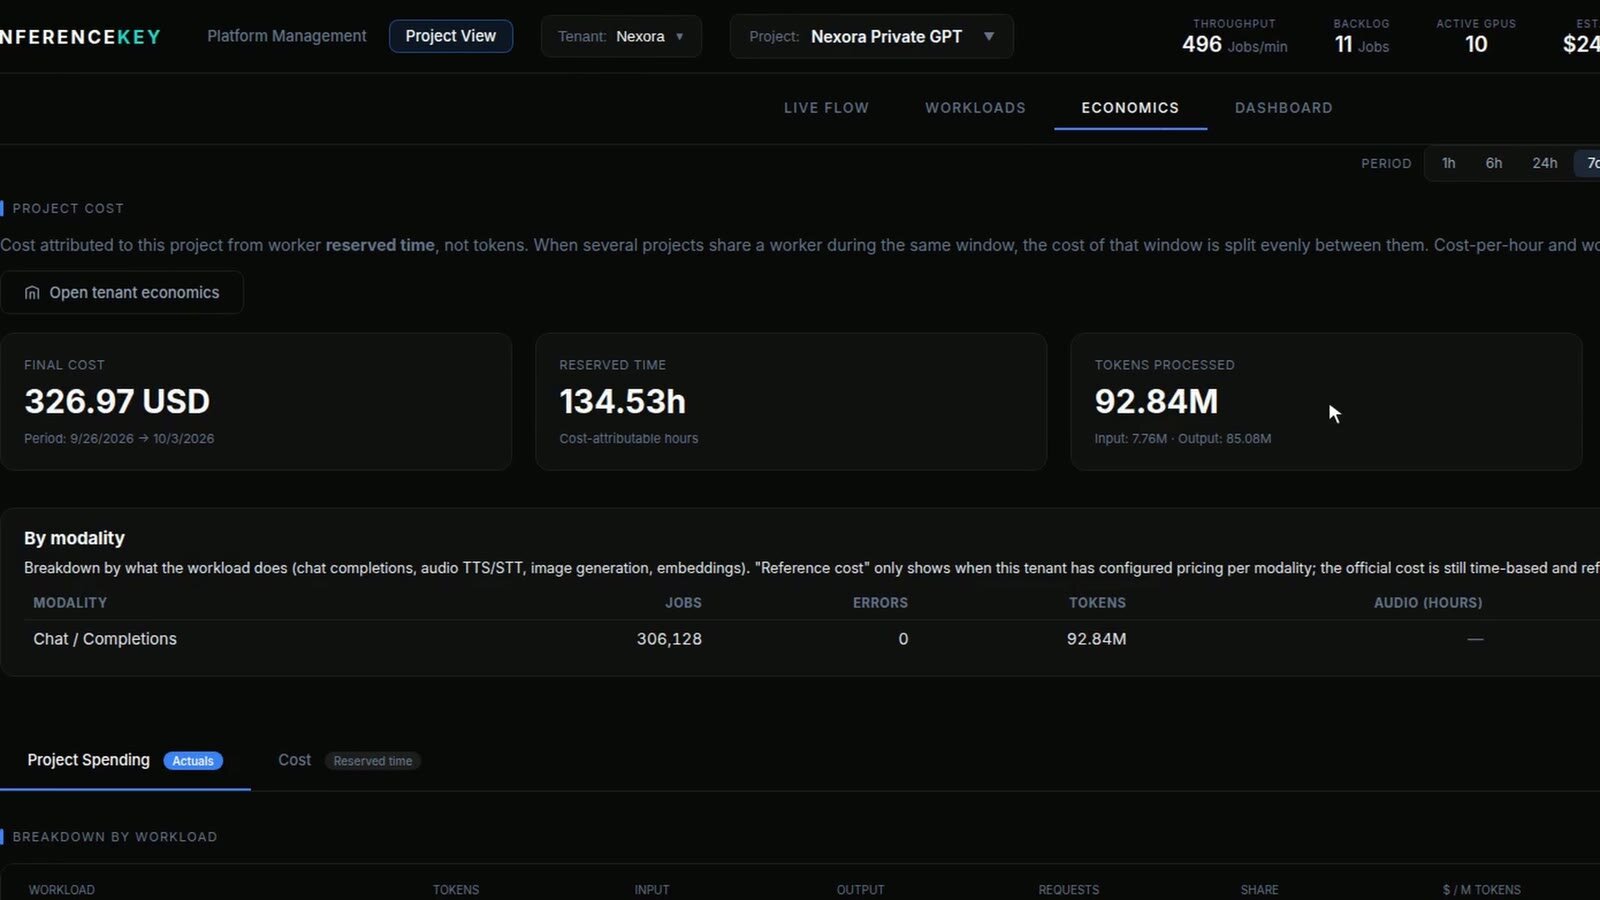
Economics ist der Bildschirm, der die Finanzabteilung interessiert. Das Panel nimmt die Stunden, für die jede Maschine für dieses Projekt reserviert war, und multipliziert sie mit dem Preis dieser Maschine. Nichts wird aus Wortzahlen geschätzt.
Die Zeitraumauswahl sagt sieben Tage, aber die Demo-Flotte existierte nur einen Teil eines Tages: 134,53 Maschinenstunden, etwa dreizehneinhalb pro Maschine. Diese Stunden kosteten $326,97. In dieser Zeit erzeugte der Testtraffic 306.128 Anfragen und 92,84 Millionen Tokens (ein Token ist ungefähr ein Dreiviertelwort). Geteilt durch seine konstante Rate kommt der Traffic auf etwas mehr als eine Stunde dieser dreizehneinhalb, die meisten bezahlten Stunden waren also Leerlauf. Deshalb misst der Wert von $3,51 pro Million Tokens im Panel vor allem Leerlauf, und er ist kein Preis, den man mit einer öffentlichen API vergleichen sollte. Halte dieselben Maschinen beschäftigt, und dieselben Stunden verteilen sich auf viel mehr Wörter: Das ist der Hebel, an dem du drehst.
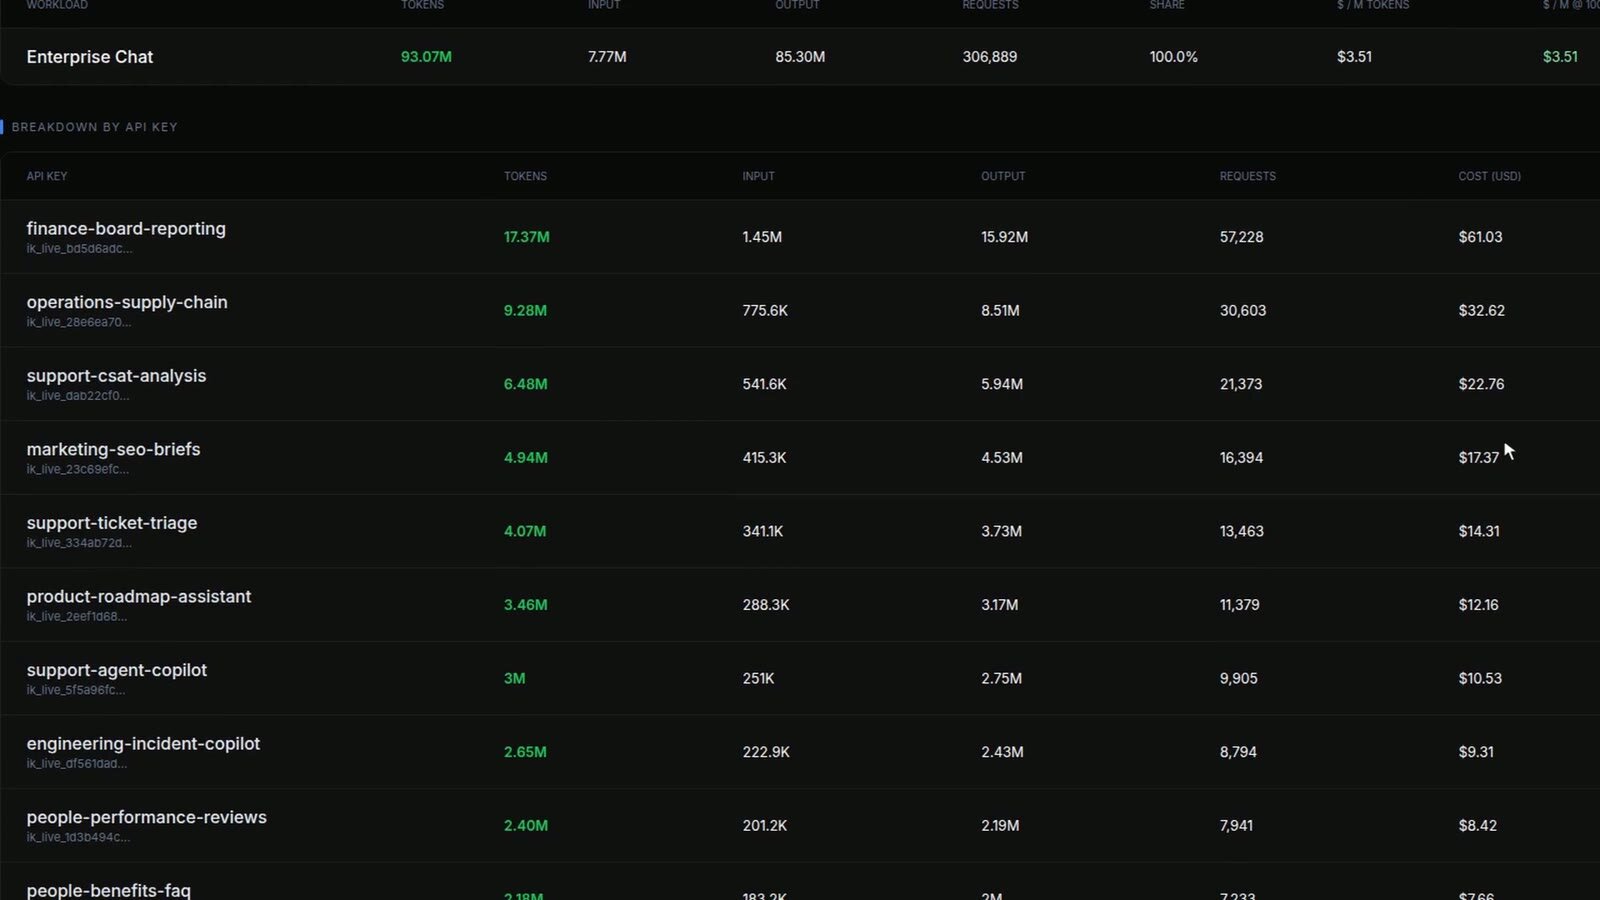
Dann werden die Kosten nach Key aufgeteilt, im Verhältnis zu den Tokens, die jeder Key verbraucht hat. Das Board-Reporting der Finanzabteilung hat 18,7 % der Tokens verbraucht, also trägt es 18,7 % der Kosten: $61,03 zu diesem Zeitpunkt. Supply Chain $32,62. Die Analyse der Kundenzufriedenheit $22,76. Marketing $17,37. Es gibt fünfzig Zeilen, eine pro Key, und sie aktualisieren sich, während der Traffic läuft. Liefe die Flotte den ganzen Monat mit demselben Mix, trüge das Board-Reporting der Finanzabteilung etwa $3.300 der $17.500.
Das funktioniert wie das Mischpult bei einem Gig: Fünfzig Kanäle laufen auf einen Master, und du siehst trotzdem, welches Mikro zu laut ist. Die Finanzabteilung muss nichts von GPUs verstehen, um das zu lesen. Es ist eine Liste von Teams mit einer Zahl neben jedem.
Was das beweist und was nicht
Es beweist die Teile, die nicht von der GPU abhängen. Jeder der fünfzig Keys kam nur an den Firmenchat heran. Zehn Worker teilten sich die Last aus einer Warteschlange, ohne dass jemand Anfragen von Hand verteilt hätte. Das Panel hielt seine Zahlen bei etwa 4.200 Anfragen pro Minute live, und die Rechnung ergab sich aus Maschinenstunden und wurde pro Key aufgeteilt, ohne dass jemand eine Tabelle exportieren musste.
Es beweist nicht, wie schnell ein echtes Modell antwortet oder wie viele Menschen zehn echte H100 bedienen können. Die zehn „H100“ waren zehn Prozesse im Testmodus auf einer gewöhnlichen Maschine. Die Antwortzeit von 250 ms auf dem Bildschirm stammt aus diesem Testmodus, genauso wie die Geschwindigkeit jeder Antwort und die 0 Fehler: Diese Worker können nicht so ausfallen, wie eine echte GPU ausfallen kann. Die Tokens werden auf Fülltext gezählt, der Anteil jedes Teams folgt also dem Traffic-Mix des Skripts, nicht echten Antwortlängen. Das Skript hat nie mehr als 32 Anfragen gleichzeitig geschickt, die Flotte hat ihre 80 also nie erreicht. Nexora ist erfunden, und $1.750 im Monat pro Maschine ist ein Mietpreis, den wir konfiguriert haben, kein Angebot.
Wie viele Menschen eine echte Maschine verkraftet, hängt vom Modell ab, von der Länge der Antworten und davon, wie die Leute es nutzen. Dafür braucht es eine Messung auf echten GPUs, und diese Demo ist keine.
Für Engineers
- Setup. Ein Projekt, ein Workload (
enterprise-chat, im Panel als vLLM-Workloadnexora-chat-70bbeschriftet, obwohl im Testmodus kein vLLM läuft), zehn Workern zugewiesen (h100-fra-01bish100-fra-10) mit fester manueller Zuweisung und einer Concurrency von je 8, also 80 Slots. Fünfzig Data-Plane-Keys (ik_live_), jeder auf den Endpointnexora-private-gpt/enterprise-chatbeschränkt. Der Endpoint ist OpenAI-kompatibel (.../enterprise-chat/v1). - Traffic. Ein Skript schickt Chat-Anfragen von den fünfzig Keys mit Zipf-Gewichten (wenige Keys dominieren, Long Tail), 32 Streams mit 0,2 s Abstand, etwa 70 Anfragen pro Sekunde. Der Workload-Drawer zeigte 4.252 erledigte pro Minute (Mittel über 5 Minuten). Der Zähler im Header zählt die
finished-Events, die der offene Tab in den letzten 60 s empfangen hat, und startet bei jedem Seitenaufruf neu, seine Werte in der Aufnahme (0 bis etwa 3.700) sind also Rampen, nicht die Last. Rückstau im Header: 8 bis 28. - Worker. Worker im Testmodus auf einem Host (Treiber gemeldet als
0.0.mock): echte Registrierung, echtes Abholen von Jobs aus der gemeinsamen Warteschlange, echter Telemetriepfad, generierte Ausgabe. Latenz (p95 250 ms), Geschwindigkeit (142 Tokens pro Sekunde pro Anfrage), Token-Zahlen und die 0 Fehler sind Eigenschaften des Testmodus. - Healthy flow. Der Drawer stuft den Workload als gesund ein, solange der Rückstau über die letzten vollständigen Minuten (bis zu 5) nicht um mehr als max(2, 25%) gewachsen ist und der Durchsatz über null liegt. Ein schrumpfender Rückstau bei steigendem Durchsatz zeigt „Recovering“, ein wachsender Rückstau „At risk“, oder „Critical“, wenn auch der Durchsatz fällt.
- Kostenmodell. Projektkosten = reservierte Worker-Stunden × konfigurierter Stundenpreis jedes Workers. Reservierte Zeit ist Kalenderzeit, solange der Worker dem Projekt zugewiesen ist, und Zeitfenster, die sich mehrere Projekte teilen, werden gleichmäßig aufgeteilt. Hier: 134,53 h × $2,4306/h ($1.750 / 720 h) = $326,97. Zehn Worker kosten $24,31/h, etwa $17.500 im Monat, wenn sie nie stoppen. Reservierte Stunden laufen weiter auf, solange die Worker zugewiesen bleiben, bei $24,31/h etwa ein Cent alle 1,5 Sekunden, Screenshots im Abstand von Sekunden unterscheiden sich also um ein paar Cent.
- Pro Key. Die Kosten jedes Keys sind sein Anteil an den Tokens des Projekts mal die Projektkosten: finance-board-reporting hatte im Frame 09 17,37M von 93,07M Tokens, 18,7 % der Projektkosten zu diesem Zeitpunkt, $61,03.
- Stückkosten. $3,51 pro Million Tokens in der Workload-Tabelle, über ein Zeitfenster, in dem sich der Traffic bei seiner konstanten Rate auf ungefähr 72 Minuten von 13,5 Stunden pro Worker summiert. Bei Abrechnung pro Stunde sinkt dieser Wert, wenn die Auslastung steigt. Bei echten Modellen entscheidet die Token-Rate pro Maschine.
- Nicht im Video. Ein elfter Worker unter Traffic, ein Worker, der mitten unter Last ausfällt, und ein Key, der deaktiviert wird, während seine Kostenzeile aufhört zu wachsen.
Die Keys, Scopes und Umgebungsvariablen sind in Tokens & API keys dokumentiert.