AstaBrief-8B: ein Forschungsbericht mit Quellenangaben aus deinen eigenen Quellen, auf einer GPU mit 24 GB
AstaBrief-8B von Ai2 macht aus einer Frage und deinen Auszügen einen Bericht mit Quellen. Wir haben es auf einer 24-GB-GPU getestet und jedes Zitat gezählt.
„Note that the current year is 2025.“ (Beachte, dass das aktuelle Jahr 2025 ist.) Diese Zeile steht mitten in einer einseitigen Textdatei, die das Allen Institute for AI (Ai2) neben seinem neuen Modell veröffentlicht hat. Die Datei enthält genau die Anweisungen, mit denen AstaBrief-8B trainiert wurde, und die Model Card sagt es unverblümt: Mit einem anderen Prompt bekommst du womöglich „degraded or inconsistent behavior“ (schlechteres oder uneinheitliches Verhalten). Also lässt du die Datei, wie sie ist, die 2025 eingeschlossen, und füllst zwei Lücken: deine Frage und die Passagen aus Papers oder Dokumenten, die deine eigene Suche gefunden hat. Heraus kommt ein Bericht in Abschnitten, mit einer kurzen Zusammenfassung pro Abschnitt und einer Quellenangabe nach jeder Aussage. Glaubt das Modell dann, es sei noch 2025? In unseren Berichten hat es nie ein falsches Jahr behauptet. Ob es Papers von 2025 für die neuesten Arbeiten überhaupt hält, haben wir allerdings nicht getestet.
Neu ist nicht die Größe, denn ein Modell mit 8 Milliarden Parametern passt schon länger auf eine Karte mit 24 GB. Neu ist das Training. AstaBrief ist ein offenes Modell dieser Größe, trainiert für eine einzige Aufgabe, den Schreibschritt von „Deep Research“ (KI-Werkzeuge, die Dutzende Quellen lesen und dir einen Bericht liefern), mit einem festen Prompt, und Ai2 hat veröffentlicht, wie es gegen das eigene, langsamere mehrstufige System abschneidet. Wir haben es auf einer einzelnen NVIDIA-Karte mit 24 GB laufen lassen und jede Quellenangabe gezählt, die es geschrieben hat. Das nimmst du mit:
| Was | Ergebnis |
|---|---|
| Modell | AstaBrief-8B von Ai2: das offene Modell Qwen3-8B von Alibaba (8 Milliarden Parameter), nachtrainiert, um Berichte mit Quellenangaben zu schreiben. Die Gewichte lassen sich frei herunterladen und kommerziell nutzen (Lizenz Apache 2.0). Der von Ai2 empfohlene Prompt ist nur für nichtkommerzielle Nutzung freigegeben (siehe unten). Ein Download von 16.4 GB |
| Note von Ai2 bei 100 echten Forschungsfragen | 87.0 von 100, gegen 77.3 für das Ausgangsmodell |
| Unsere GPU | eine NVIDIA RTX A5000, eine Karte mit 24 GB |
| Belegter Speicher | in der Spitze etwa 22 GB von 24 GB |
| Tempo für einen Bericht | etwa eine Minute (40 bis 65 s), mit etwa 39 Tokens pro Sekunde (ein Token ist ungefähr drei Viertel eines Wortes) |
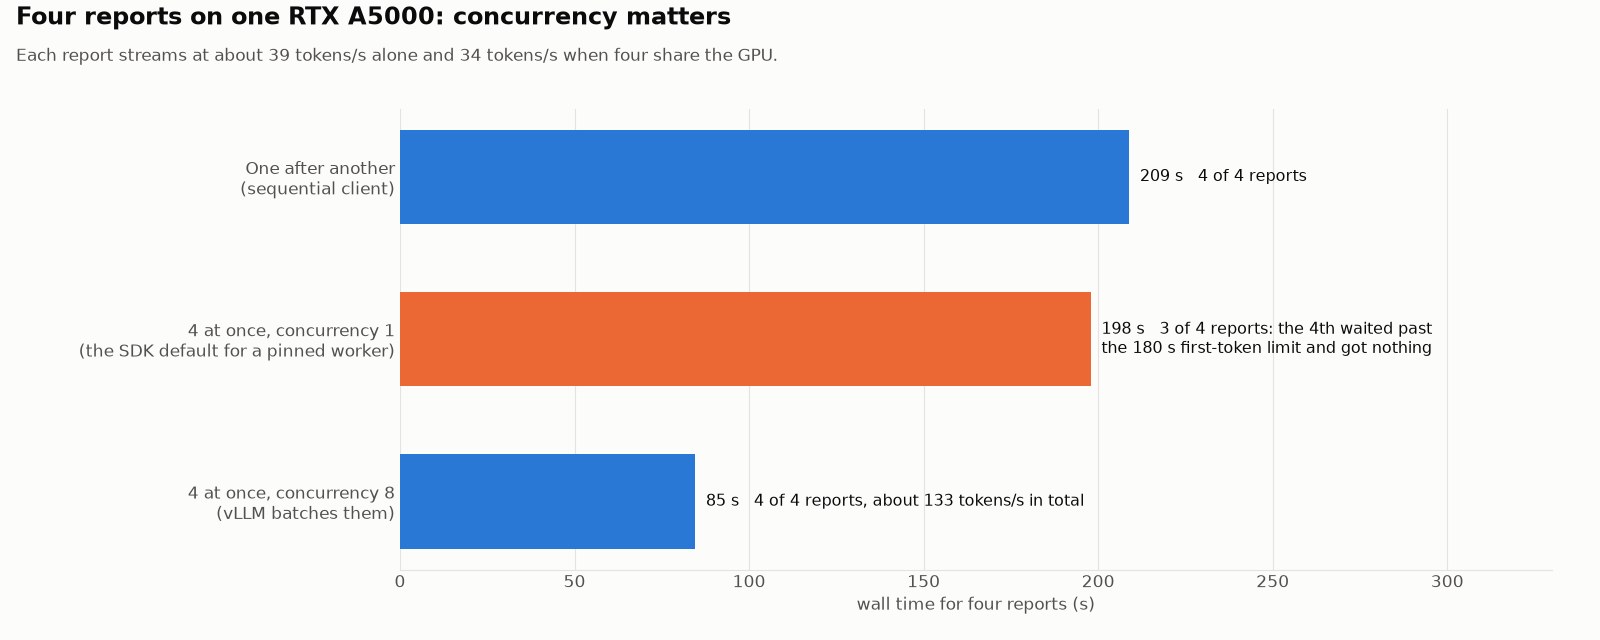
| Vier Berichte gleichzeitig | 85 s für alle vier, gegen 209 s nacheinander |
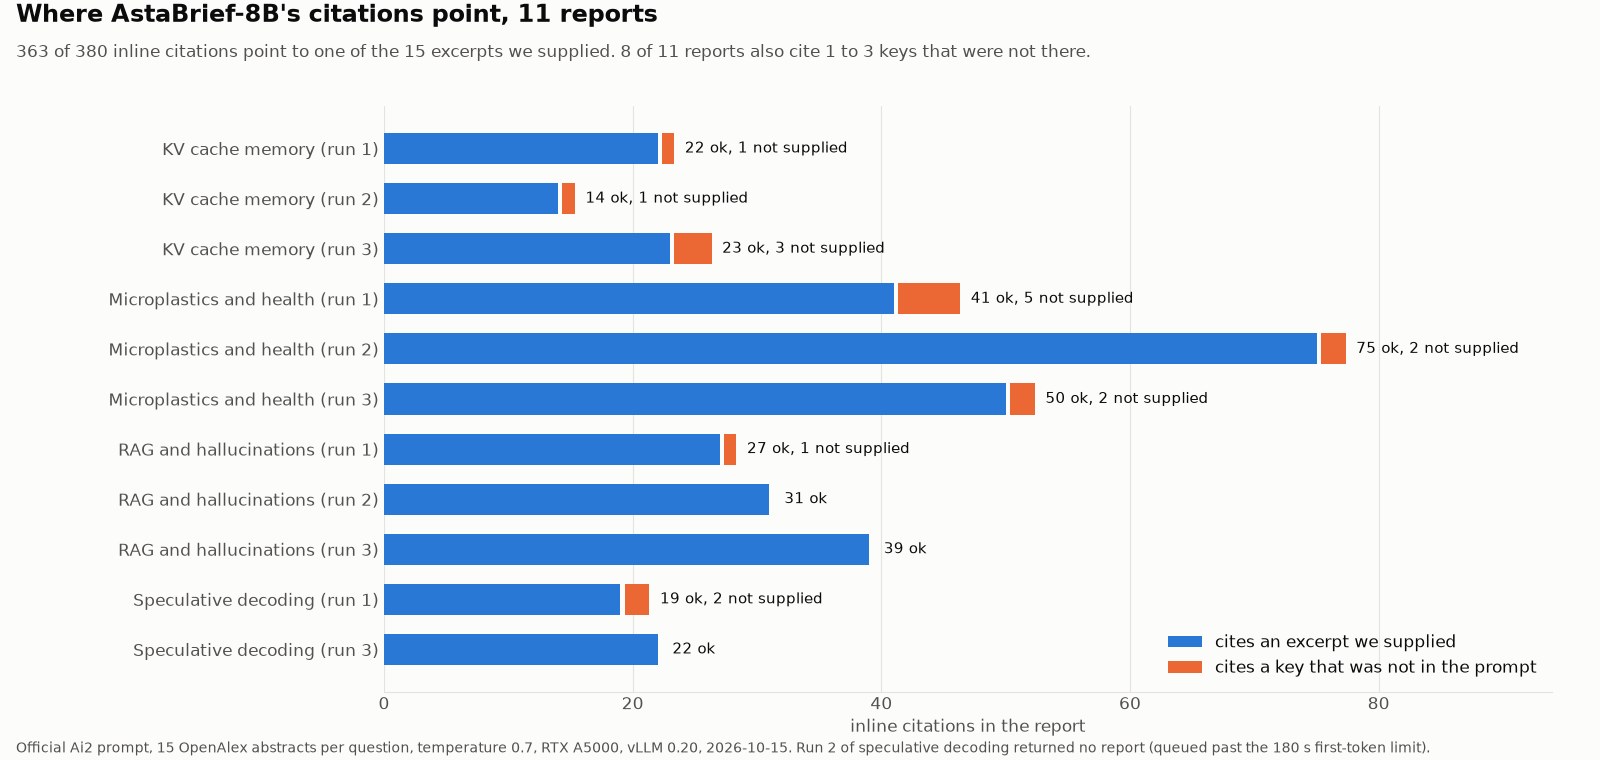
| Geprüfte Quellenangaben | 363 von 380 verweisen auf eine Passage, die wir mitgegeben haben (95.5%) |
| Der Haken | 8 von 11 Berichten zitieren zusätzlich 1 bis 3 Quellen, die nicht im Prompt standen |
Eine Prüfung mit offenem Buch und Seitenzahlen
Am einfachsten stellst du dir AstaBrief als Prüfung mit offenem Buch vor, bei der jeder Satz eine Seitenzahl tragen muss. Du gibst dem Modell das Buch: 15 kurze Auszüge, jeder mit einem Label aus einer ID, dem Erstautor, dem Jahr und der Zitationszahl (wie viele andere Papers dieses Paper zitieren). Das Modell schreibt seine Antwort und setzt nach jeder Aussage das Label des verwendeten Auszugs in eckige Klammern. Sagt es etwas, das nicht im Buch steht, soll es das laut Prompt als „(LLM Memory)“ markieren, also als eigene Erinnerung des Modells.
Diese Trennung macht die Ausgabe überprüfbar. Ein Label in Klammern passt entweder zu einem Auszug, den du mitgegeben hast, oder eben nicht. Um das zu prüfen, musst du das Paper nicht verstehen. Du brauchst nur die Liste der Labels, die du geschickt hast.
Was Ai2 veröffentlicht hat
Am 2. Oktober hat Ai2 AstaBrief als Open Source veröffentlicht, das Modell hinter dem „Fast mode“ der Berichtsfunktion in Asta, seinem Forschungsassistenten. Daneben behält Asta einen „Thinking mode“, der mit Claude läuft. Die ältere Pipeline arbeitet in Stufen: Sie fasst die gefundenen Ausschnitte zusammen, gruppiert sie und schreibt dann. AstaBrief überspringt die Mitte und schreibt den ganzen Bericht in einem Durchgang. Über die komplette Asta-Pipeline hat Ai2 im Schnitt 51.1 s pro Bericht im Fast mode gemessen, gegen 178.5 s im Thinking mode.
Ai2 ist von Qwen3-8B ausgegangen und hat ihm etwa 47,000 Beispielberichte gezeigt, geschrieben von den eigenen bestehenden Werkzeugen auf Modellen von Claude und OpenAI, zu Fragen aus echten Anfragen in den Logs von Asta. Danach hat es ihm etwa 6,000 Berichtspaare gezeigt, jeweils einen besseren und einen schlechteren, ausgewählt von zwei KI-Bewertern, und ein Paar nur behalten, wenn beide Bewerter sich einig waren. Laut Ai2 war das stabiler und billiger als die Alternativen, und der größte Gewinn kam daher, Beispielberichte mit wenigen Quellenangaben wegzuwerfen.
Bevor du etwas darauf baust, solltest du die geteilte Lizenzlage kennen. Das Modell lässt sich ohne Anfrage herunterladen und kommerziell nutzen (Apache 2.0), aber die Anweisungsdatei und die Paare aus besserem und schlechterem Bericht sind nur für nichtkommerzielle Nutzung freigegeben (CC-BY-NC-4.0), und Ai2 beschreibt das Modell als gedacht für Forschung und Lehre. Weil die Anweisungsdatei nichtkommerziell ist, liefern wir keine Kopie davon in unserem Code mit: Unser Beispielskript lädt sie bei jedem Lauf von Ai2 herunter. An ihren Bedingungen ändert das nichts. Wer das Skript ausführt, nutzt den Prompt unter der nichtkommerziellen Lizenz von Ai2.
Ai2 liefert auch das Argument, es im eigenen Haus zu betreiben. Im Blog heißt es, offene Gewichte erlauben Institutionen, AstaBrief auf ihrer eigenen Infrastruktur zu betreiben, „which is necessary when research questions reveal sensitive or unpublished work“ (was nötig ist, wenn Forschungsfragen sensible oder unveröffentlichte Arbeiten preisgeben), und es hat einen Beispiel-Workflow veröffentlicht, den Forschende anpassen können, um Berichte aus ihren eigenen PDFs zu erstellen.
Wie gut es ist, nach den Zahlen von Ai2
Ai2 hat es mit 100 Forschungsfragen aus der Informatik bewertet, die echte Nutzer geschrieben haben. AstaBrief-8B kommt auf 87.0 von 100, gegen 77.3 für das unveränderte Qwen3-8B, und der Gewinn liegt vor allem bei den Quellenangaben. Ai2 prüft, ob jede Aussage von den Quellen, die der Bericht dafür angibt, vollständig gestützt wird: Das gilt bei AstaBrief für etwa 78 von 100 Aussagen, gegen etwa 65 beim unveränderten Modell. Und von den angegebenen Quellen stützen etwa 9 von 10 die Aussage wirklich, vorher waren es etwa 3 von 4. Der einzige Wert, der gesunken ist, und zwar ganz leicht, ist das Maß von Ai2 dafür, wie viel von jeder Antwort beim Thema bleibt: vorher 90.6, nachher 89.0.
Im direkten Vergleich von Ai2 mit dem Bericht seines langsameren mehrstufigen Systems wurde der Bericht von AstaBrief bei etwa 7 von 10 Testfragen bevorzugt (und bei etwas mehr als der Hälfte eines separaten Fragensets, das Ai2 während der Entwicklung genutzt hat). Bewertet hat diesen Vergleich ein KI-Modell, und die Tabelle in der Model Card sagt nicht, welches. Ai2 selbst nennt das Ergebnis „competitive with“ (konkurrenzfähig mit). Ein anderes Ai2-Modell derselben Größe, DR-Tulu-8B, schneidet im selben Test etwas besser ab, und in einem zweiten Test landet AstaBrief auf dem letzten Platz der drei, mit etwa 54 gegen 56 und 60. In einer kleinen Studie mit drei Forschenden wurde DR-Tulu insgesamt bevorzugt, während zwei der drei AstaBrief bei der Genauigkeit der Quellenangaben vorgezogen haben.
Ai2 nennt auch eine Grenze, die seine Werte nicht erfassen: Ein Modell kann die richtige Studie zitieren und trotzdem übertreiben, was sie gefunden hat.
So läuft es auf InferenceKey
Die Karte und die Software
Für die Software, die es betreibt, sieht AstaBrief-8B aus wie jedes andere Qwen3-Modell. Es läuft also auf vLLM, dem Open-Source-Server, der in InferenceKey eingebaut ist, ohne eigenen Code. Wir haben bei RunPod eine NVIDIA RTX A5000 gemietet, eine Workstation-Karte mit 24 GB, in derselben Speicherklasse wie eine RTX 4090 für Gaming. Unsere Software braucht einen aktuellen NVIDIA-Treiber, also haben wir nur Maschinen gemietet, die einen hatten. Das ist unsere Anforderung, nicht die des Modells.
Das Modell belegt 16.4 GB der 24 GB der Karte. Wir haben jede Anfrage auf bis zu etwa 16,000 Tokens begrenzt (Frage, Auszüge und Bericht zusammen), die Länge, die Ai2 in seiner letzten Trainingsrunde verwendet hat. Damit bleibt Platz für zwei Anfragen dieser vollen Länge gleichzeitig, oder für etwa vier in der Größe, die wir tatsächlich geschickt haben (jeweils grob 7,000 Tokens, Frage plus Bericht).
Die Schritte
Unser SDK-Beispiel (ein fertiges Python-Skript, das die Bibliothek von InferenceKey nutzt) erledigt alles in einem Skript: Es sagt InferenceKey, dass das Modell auf deiner GPU-Maschine laufen soll, wartet, bis das Modell bereit ist, baut den Prompt von Ai2 aus deiner Frage und deinen Auszügen, fordert einen Bericht an und fährt das Modell am Ende wieder herunter. Der Kern davon:
MODEL = "allenai/AstaBrief_8B"
COMMAND = f"vllm serve {MODEL} --max-model-len 16384 --dtype bfloat16"

spec = WorkloadSpec(
    name="AstaBrief-8B cited reports (vLLM)",
    slug="astabrief-8b",
    model=MODEL,
    backend=Backend.VLLM,
    command=COMMAND,
    task_type="text2text",
    worker_id=os.environ["IK_WORKER_ID"],
    execution_policy=ExecutionPolicy.FIXED,
    execution_policy_config={"replicas": 1},
)
ref = mgmt.ensure(spec)
mgmt.wait_until_ready(ref.workload_slug, timeout=1800)
out = DataClient.from_env().endpoint(ref.workload_slug).generate_text(
    messages=[{"role": "user", "content": build_prompt(query, references)}],
    temperature=0.7, max_tokens=4096,
)
Das Skript holt die Anweisungen von Ai2 und gibt jedem deiner Auszüge dieselbe Art von Label, die das Modell im Training gesehen hat: eine ID, den Autor, das Jahr und die Zitationszahl. Führ python main.py für die sechs mitgelieferten Beispielauszüge aus, oder python main.py my_references.json für deine eigenen. Das Modell antwortet im selben Format wie der Dienst von OpenAI, sodass Code, den dein Team schon für OpenAI geschrieben hat, mit einer geänderten Adresse damit sprechen kann.
Den Test haben wir mit einer privaten Kopie von InferenceKey gefahren, nie mit dem Live-Dienst. Um echtes Material zu nutzen, haben wir 4 Fragen gestellt (drei dazu, wie man KI-Modelle schneller und zuverlässiger macht, eine zu Mikroplastik und Gesundheit) und jeder davon die Zusammenfassungen von 15 Papers aus OpenAlex mitgegeben, einem freien Katalog von Forschungsarbeiten.
Was wir gemessen haben
Ein Bericht dauert etwa eine Minute (41.5 bis 64.7 s allein auf der Karte). Das Modell auf einer frisch gemieteten Maschine zu starten ist eine einmalige Wartezeit von etwa vier Minuten (245.7 s), davon mehr als die Hälfte (137 s) für die Installation der Serving-Software. Der Download des Modells dauerte 18 s, der Start noch einmal etwa eineinviertel Minuten. In der Spitze belegte die Karte etwa 22 ihrer 24 GB.
Ein Bericht beginnt anderthalb Sekunden nach deiner Anfrage zu erscheinen, und ein typischer Bericht hat 1,600 bis 2,400 Tokens, grob ein paar Seiten.
Kann eine Karte mehrere Berichte gleichzeitig schreiben? Ja. Vier zusammen geschickte Berichte waren in 85 s fertig, gegen 209 s nacheinander. Jeder einzelne Bericht dauerte etwas länger (52 bis 85 s statt 42 bis 65 s), aber alle vier waren in weniger als anderthalb Minuten fertig. Die Berichte waren von Lauf zu Lauf nicht identisch, lies das also als faires Bild, nicht als exakte Zeitmessung.
Dafür brauchte es eine Einstellung: wie viele Anfragen das Modell gleichzeitig annehmen darf (im Diagramm „concurrency“ genannt). Unsere stand anfangs auf eins, und beim ersten Versuch haben sich die vier Berichte angestaut: 198 s, und ein Bericht ging verloren (siehe unten).
Die Seitenzahlen prüfen
Zurück zur Prüfung mit offenem Buch. Über 11 Berichte (einer davon bei der Grenze von 4,096 Tokens abgeschnitten) hat das Modell 380 Quellenangaben geschrieben, und 363 davon, 95.5%, verweisen auf einen Auszug, den wir mitgegeben haben. Das Buch hat es auch gut genutzt: Jeder Bericht stützte sich auf 11 bis 15 seiner 15 Quellen.
Mit den übrigen 17 musst du planen. In 8 der 11 Berichte hat das Modell 1 bis 3 Labels zitiert, die nicht im Prompt standen. Einige sind ein mitgeliefertes Paper mit verstümmeltem Label: Ein Paper von Thapliyal aus 2025 kam ohne das W am Anfang seiner ID zurück, mit geänderter letzter Ziffer und einer Zitationszahl von 111 statt 45 (die Zahl der Papers, die es zitieren). Andere sind Papers aus dem Gedächtnis des Modells, etwa ein Paper von Derraik aus 2002 mit 2,594 Zitationen, geschrieben in genau demselben Labelformat wie die echten Auszüge und nicht als „(LLM Memory)“ markiert. Den eigenen Mechanismus des Prompts für diese Markierung hat das Modell in 11 Berichten einmal genutzt.
Wir haben auch Abweichungen in Details gesehen. Ein Bericht hatte die Zitationszahl eines Papers falsch (wie viele andere Papers es zitieren): Er schrieb 25 statt 27, siebenmal hintereinander. Im kurzen Beispiellauf wurde aus „one eighth“ (einem Achtel) der Kosten „1/4 cost“, und der Bericht fügte einen Abschnitt ganz ohne Quellenangabe hinzu. Genau vor dieser Grenze hat Ai2 gewarnt: die richtige Quelle neben einer Aussage, die nicht ganz das sagt, was in der Quelle steht.
Die praktische Antwort ist billig. Da jedes Label, das du geschickt hast, bekannt ist, können ein paar Zeilen Code jede Klammer im Bericht markieren, die zu keinem davon passt, bevor ein Mensch ihn liest. Zahlen, die aus den Auszügen stammen, verdienen so oder so einen zweiten Blick durch einen Menschen: Die Quellenangaben zu prüfen bleibt deine Aufgabe.
Das Demovideo
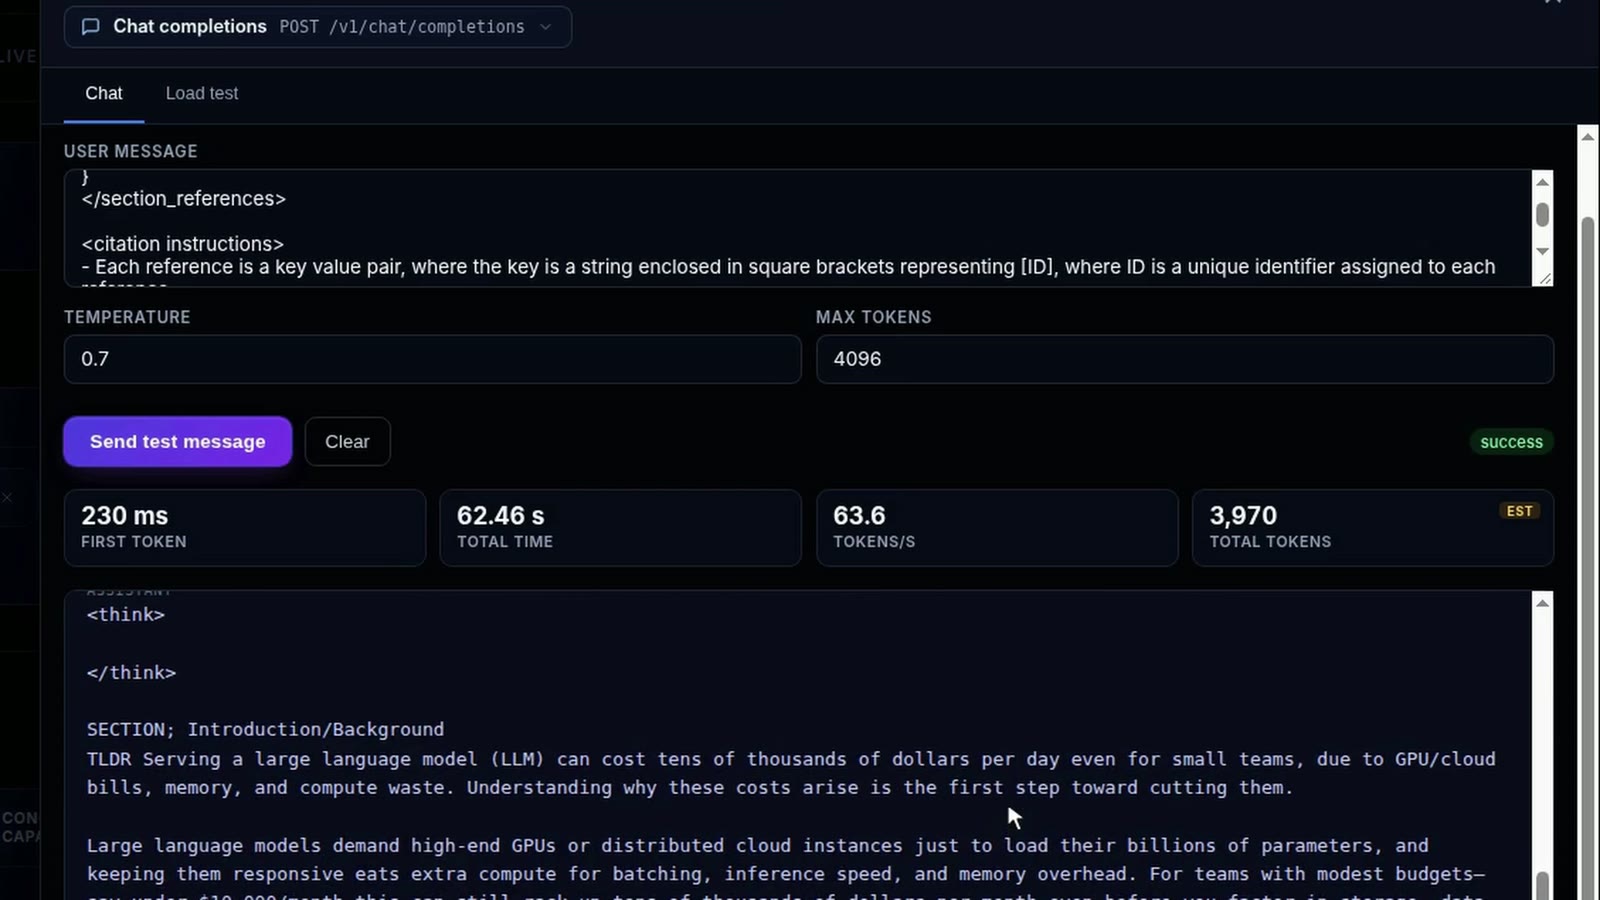
Das Video zeigt das Modell, wie es auf der RTX A5000 im Dashboard von InferenceKey läuft, den Prompt von Ai2, gefüllt mit den sechs Beispielauszügen im eingebauten Testbildschirm, und den Bericht, wie er Abschnitt für Abschnitt erscheint. Mit nur den sechs kurzen Beispielauszügen zum Lesen statt fünfzehn erschienen die ersten Wörter in weniger als einer Viertelsekunde (230 ms), und der ganze Bericht dauerte etwa eine Minute (62.46 s).
Was schiefging
Zwei Probleme lagen bei uns, in der Plattform. Für das erste gibt es heute einen Workaround, für das zweite noch keinen Fix.
- Ein Modell, das an eine GPU gebunden ist, nimmt nur eine Anfrage auf einmal an. Wenn unser SDK ein Modell an eine bestimmte GPU-Maschine bindet, lässt die Plattform dieses Modell nur eine Anfrage auf einmal annehmen. Auf jedem anderen Weg hinzugefügt, nimmt es standardmäßig bis zu 20. Deshalb haben sich die vier Berichte oben angestaut. Das ist unser Bug, und ein einziger Aufruf der Einstellungen behebt ihn heute (Details unter „Für Engineers“).
- Langes Warten endet in einer leeren Antwort. Eine Anfrage, die mehr als 3 Minuten auf ihr erstes Wort wartet, wird mit einer leeren Antwort und ohne Fehler geschlossen, während die GPU den Bericht für niemanden weiterschreibt (in unserem Fall noch 107 s). Sie sollte einen klaren Fehler zurückgeben und den Job abbrechen. Dafür haben wir noch keinen Fix.
Der Rest geht auf das Konto des Modells oder des Mietmarkts. Die Ausgabe braucht eine leichte Reinigung, bevor jemand sie liest. Jeder Bericht beginnt mit einem leeren „thinking“-Tag, wie ihn Qwen3-Modelle schreiben, wenn Thinking eingeschaltet ist (das Abschalten haben wir nicht getestet), und die Abschnittszusammenfassungen sind etwas anders markiert, als der Prompt verlangt. Beides lässt sich mit ein paar Zeilen Code leicht entfernen. Als wir unsere Quellenlabels auf reine Zahlen umgestellt haben, hörte das Modell auf, einen Buchstaben davon wegzulassen, aber es schrieb immer noch falsche Labels für zwei mitgelieferte Papers, die Labelprüfung ist also nicht optional. Unsere Laufnotizen verzeichnen außerdem einen Rest des Markups der Trainingsdaten mitten in einem Bericht. Das haben wir nicht nachgeprüft, aber ein einfacher Aufräumfilter lohnt sich.
Wer was gemacht hat
Das Asta-Team von Ai2 hat AstaBrief gebaut und veröffentlicht: die Trainingsdaten aus Astas eigenen Logs und Pipelines, die zwei Trainingsrunden mit dem eigenen Open-Source-Trainingscode (open-instruct) auf 8 der großen Rechenzentrums-GPUs von NVIDIA (H100), die Evaluation und den Prompt. Ihre Trainingsberichte stammten aus Pipelines, die auf Modellen von Anthropic und OpenAI liefen, die konkurrierenden Berichte der zweiten Runde stammten auch von DeepSeek-Modellen, und GPT-4.1 und DeepSeek-R1 dienten als Bewerter. Ai2 hat außerdem den Beispiel-Workflow für Berichte aus deinen eigenen PDFs veröffentlicht und das Argument dafür geliefert, das Modell auf deiner eigenen Infrastruktur zu betreiben. Das Qwen-Team hat Qwen3-8B trainiert, die Basis, auf der alles steht. Das vLLM-Projekt liefert es ohne Änderungen aus. Hugging Face hostet die Gewichte und den Prompt, OpenAlex hat uns die Abstracts für echte Auszüge geliefert, und RunPod hat uns die Karte vermietet. Auf die Veröffentlichung sind wir in einem Video von AI Search gestoßen.
Unser Teil war, es auf InferenceKey zusammenzusetzen, das SDK-Beispiel zu schreiben, es von Anfang bis Ende auf einer Karte mit 24 GB laufen zu lassen, Tempo und Speicher zu messen und jede Quellenangabe in den Berichten zu zählen.
Was du mitnehmen kannst
Wenn du schon einen Suchschritt über deine eigenen Dokumente hast, ist AstaBrief-8B ein Berichtsschreiber, den du daneben auf einer Karte mit 24 GB laufen lassen kannst, etwa eine Minute pro Bericht und mehrere gleichzeitig. Unser Beitrag zu EmbeddingGemma 2 deckt diese Suchseite ab. Wie Ai2 selbst argumentiert, ist der Grund, das selbst zu betreiben, Kontrolle: Frage, Auszüge und Bericht bleiben auf einer Maschine, die du wählst. Für ein Unternehmen hängt eine Bedingung daran. Der von Ai2 empfohlene Prompt ist nur für nichtkommerzielle Nutzung lizenziert, ein kommerzielles Produkt braucht also entweder eine Prüfung dieser Lizenz oder einen eigenen Prompt im selben Format, und die Model Card warnt, dass sich das Modell mit einem anderen Prompt schlechter verhalten kann.
Die Grenzen, klar gesagt. Unser Test war klein: 4 Fragen, je 15 Abstracts, 11 Berichte (einer bei der Grenze von 4,096 Tokens abgeschnitten). Wir haben die Berichte nicht bewertet und sie auf unseren Fragen nicht mit einem anderen Modell verglichen. Die Qualitätszahlen oben sind die von Ai2, und sie stammen nur aus Fragen zur Informatik. Drei unserer vier Fragen betrafen ebenfalls KI und Computing, nur eine (Mikroplastik) lag außerhalb dieses Felds, über andere Themen können wir also nichts sagen. Die Eingaben waren kurze Abstracts öffentlicher Papers, nicht die internen Unternehmensdokumente, für die das gedacht ist. Unsere 15 Auszüge pro Frage füllten weniger als ein Drittel des Platzes, den wir erlaubt hatten (etwa 5,000 von 16,000 Tokens), wie es sich mit viel längeren Eingaben verhält, wissen wir also nicht.
Wir haben geprüft, dass jede Quellenangabe auf einen Auszug verweist, den wir geschickt haben. Wir haben nicht geprüft, ob jeder Satz sagt, was in seinem Auszug steht. 95.5% heißt also, dass die Quellenangaben echt sind, nicht dass die Aussagen stimmen. Die Abweichungen oben sind das, was uns unterwegs aufgefallen ist, keine Prüfung Zeile für Zeile.
Und das Modell schreibt selbstbewusste Quellenangaben, die du prüfen musst. Eines der Labels, die es geschrieben hat, lautet [4411306415 | Thapliyal et al. | 2025 | Citations: 111]. Der Auszug, den wir geschickt hatten, war [W4411306417 | Thapliyal et al. | 2025 | Citations: 45]. Würde das deinen Lesern auffallen?
Für Engineers
Modell (Model Card, SFT-Checkpoint, Ai2-Blog, config.json, DPO-Daten, Basis Qwen3-8B). HF-Repo allenai/AstaBrief_8B, sha 6a34f54d..., zuletzt geändert am 2026-10-03, license:apache-2.0, nicht gated, 1,979 Downloads im letzten Monat und 66 Likes, als wir es abgerufen haben. Abstammung: Qwen3-8B-Base, Qwen3-8B, AstaBrief_8B_SFT (SFT auf AstaBrief_SFT_Mix), AstaBrief_8B (Offline-DPO auf AstaBrief_DPO_Mix), beide Stufen in open-instruct auf 8x H100. Qwen3ForCausalLM, 36 Layer, hidden 4096, intermediate 12288, 32 Query-Heads und 8 KV-Heads, head_dim 128, max_position_embeddings 40960, rope_theta 1,000,000, kein rope_scaling, vocab 151936, bfloat16. generation_config.json: temperature 0.6, top_k 20, top_p 0.95. Das Beispiel der Card nutzt temperature 0.7, top_p 0.95, max_tokens 4096, stop_token_ids=[eos]. Vier safetensors-Shards, 16,381,516,824 Bytes, dazu vier doppelte Shards pytorch_model-*.bin und nur eine pytorch_model.bin.index.json.
Training. SFT: 5 Epochen, LR 5e-06, Warmup 0.03, Grad Accumulation 4, maximale Sequenzlänge 32,768, BF16. DPO: 7 Epochen, LR 5e-06 linear, Warmup 0.1, DPO-Norm-Loss, beta 10, Batch pro Gerät 1, Grad Accumulation 8, maximale Sequenzlänge 16,000, BF16. Die Zahl von 16K gehört also zur DPO-Stufe, nicht zum ganzen Training. Blog: etwa 90K Anfragen aus gefilterten Asta-Logs, 47K SFT-Beispiele aus ScholarQA-Pipelines auf Basis von Claude 3.5 Sonnet, Claude 3.7 Sonnet, o3, o4-mini und GPT-4.1, etwa 6K DPO-Paare (ein Bericht aus dem Claude-gestützten ScholarQA, der konkurrierende aus o3, o4-mini, DeepSeek-V3 oder DeepSeek-R1, Gewinner von den zwei Judges gewählt, GPT-4.1 und DeepSeek-R1, nur bei Einigkeit behalten), 95% Übereinstimmung mit Menschen. Die Card des DPO-Datensatzes nennt 6.6k Instanzen, Anfragen aus OpenScholar und Asta ScholarQA bis Juni 2025, CC BY-NC 4.0, wobei Ausgaben von Drittmodellen den Bedingungen der Anbieter unterliegen.
Evaluation von Ai2. ScholarQA-CS2 Test (avg / ingredient recall / answer precision / citation precision / citation recall): Qwen3-8B 77.3 / 77.8 / 90.6 / 76.2 / 64.6, AstaBrief-8B-SFT 83.7 / 85.2 / 90.4 / 87.7 / 71.3, AstaBrief-8B 87.0 / 90.2 / 89.0 / 90.5 / 78.2. Vergleichstabelle (SQA-CS2 dev / test / DeepScholarBench): Asta ScholarQA 87.6 / 86.2 / 60.25, DR-Tulu-8B 86.5 / 88.8 / 56.26 (Win-Rate gegen Asta SQA 36% dev, 54% test), AstaBrief-8B 86.3 / 87.0 / 53.50 (55% dev, 72% test). Blog: Die Evaluationen liefen 2025 gegen die Frontier-Modelle jener Zeit, und die Metriken messen nicht, ob ein Bericht Reichweite und Stärke seiner Quellen einhält. Frühe Nutzung unter 374 Asta-Nutzern: 29.1% nutzten den Fast mode an zwei oder mehr Tagen, im Schnitt 3.67 Berichts-Threads, 23% wechselten nie zurück in den Thinking mode, positives Feedback 84.2% Fast gegen 85.2% Thinking (dünne Datenlage).
Prompt. sft_prompt.txt, 3,154 Bytes, Datensatz allenai/AstaBrief_prompts Revision 355b7a260fce95820a2bdf359ca1ddec920ee974, CC-BY-NC-4.0 (er enthält auch pairwise_judge_prompt.txt und query_filter_prompt.txt). Platzhalter [QUERY] und [SECTION_REFERENCES] in einem Block <section_references> aus Paaren "[ID]": "quote". Zitiert wird inline als [ID], eigenes Wissen als (LLM Memory). Jeder Abschnitt beginnt mit SECTION; plus Name, dann TLDR; und eine Zusammenfassung aus zwei Sätzen ohne Quellenangaben. Nur die Formate LIST oder SYNTHESIS. Eine Zitationszahl von 100 oder mehr erlaubt „notable“. Trainingskeys sehen aus wie [230644543 | Miguel et al. | 2020 | Citations: 5].
Unser Setup. RunPod NVIDIA RTX A5000 24 GB, SECURE Cloud (Miete etwa 0.27 USD pro Stunde), Image runpod/pytorch:1.0.7-cu1300-torch291-ubuntu2404-cluster. RTX 4090, RTX A5000 und RTX 3090 COMMUNITY antworteten mit 409 (nicht vorrätig). Treiber 580.159.04 (CUDA 13.0), Power-Limit 230 W, Compute Capability 8.6. Pods gefiltert mit allowed_cuda_versions 13.0 bis 13.4. Worker-Bootstrap 76 s nach dem POST des Pods. Lokaler InferenceKey-Manager, erreicht über HTTP- und TCP-Tunnel, Produktion nie angefasst. Backend: eingebautes vllm, vLLM 0.20.0 (Standard des Workers), torch 2.11.0+cu130. Befehl vllm serve allenai/AstaBrief_8B --max-model-len 16384 --dtype bfloat16 (gpu-memory-utilization 0.92 ist der effektive Wert, den der Worker anwendet, nicht Teil des Befehls). Das SDK-Skript löscht den Workload am Ende, außer bei IK_KEEP_ALIVE=1. Commit des SDK-Beispiels 728d890 auf inferencekey-sdk main (main.py, README.md, .env.example, requirements.txt, sample_references.json, .gitignore).
Zeit bis bereit. 245.7 s von ensure() bis bereit auf einem kalten Pod: vLLM-Installation 137 s (venv 8.1 GB), Download der Gewichte 17.94 s (nur safetensors), Laden der Gewichte 2.82 s, Laden des Modells 15.27 GiB in 21.90 s, Engine-Init 40.49 s (Kompilierung 23.42 s), vLLM bereit 91 s nach dem Start.
Speicher und Leistung. KV-Cache 4.6 GiB = 33,472 Tokens, maximale Concurrency 2.04x bei 16,384 Tokens pro Anfrage. vLLM-Prozess 21,850 MiB, Spitze der GPU insgesamt 22,069 MiB von 24,564. Spitzenleistung 230.07 W.
Pro Anfrage (offizieller Prompt, 15 OpenAlex-Abstracts pro Frage, temperature 0.7, max_tokens 4096, Streaming über das lokale Gateway, Tokens mit dem Tokenizer des Modells gezählt, weil der Stream kein usage mitlieferte, auch nicht mit stream_options.include_usage):
| Lauf | Prompt-Tok | Bericht-Tok | Erstes Token s | Gesamt s | Decode tok/s |
|---|---|---|---|---|---|
| Nacheinander, 4 Fragen | 4,374 bis 5,068 | 1,570 bis 2,444 | 1.37 bis 1.58 | 41.5 bis 64.7 | 38.7 bis 39.1 |
| 4 gleichzeitig, Concurrency 1 | 4,359 bis 5,053 | 1,472, 1,926, 4,096 (max_tokens erreicht), 0 | 1.22, dann 40.4 und 91.5 (angestaut) | 38.9 bis 197.9, einer leer bei 180.0 | 38.5 bis 39.0 |
| 4 gleichzeitig, Concurrency 8 | 4,359 bis 5,053 | 1,707 bis 2,874 | 0.37 bis 0.74 (Prefix-Caching) | 51.5 bis 84.6 | 33.4 bis 34.2 |
Unsere Prompts (4.4K bis 5.1K Tokens) blieben deutlich unter der Grenze von 16,384 Tokens, und in deren Nähe wurde nichts gemessen. Wall Time für vier Berichte: 209 s nacheinander, 198 s bei Concurrency 1 (3 von 4 geliefert), 85 s bei Concurrency 8. vLLM-Log während des Laufs mit Concurrency 8: Avg generation throughput 132.0 bis 136.0 tokens/s mit Running: 4 reqs. main.py mit den 6 Beispielauszügen (ohne Streaming): 40.9 s, 1,171 Prompt-Tokens, 1,563 Bericht-Tokens, 8 Abschnitte, 6 von 6 Quellen zitiert. Tester des Panels: erstes Token 230 ms, gesamt 62.46 s (seine 63.6 tokens/s und 3,970 Tokens insgesamt enthalten den geschätzten Prompt).
Quellenangaben. 11 Berichte (einer, Concurrency 1, bei max_tokens 4096 abgeschnitten), 380 Inline-Quellenangaben, 363 (95.5%) auf einen mitgelieferten Auszug. Pro Bericht, mitgeliefert/nicht mitgeliefert: 22/1, 14/1, 23/3, 41/5, 75/2, 50/2, 27/1, 31/0, 39/0, 19/2, 22/0. 8 von 11 Berichten zitieren Keys, die nicht im Prompt standen: 17 Markierungen, 11 verschiedene Keys. Verstümmelte Kopien mitgelieferter Papers: [4411306415 | Thapliyal et al. | 2025 | Citations: 111] für [W4411306417 | Thapliyal et al. | 2025 | Citations: 45], [4414281756 | Kadac-Czapska et al. | 2025 | Citations: 13] für [W4414281754 | Kadac-Czapska et al. | 2025 | Citations: 9] (beide im Lauf mit OpenAlex-IDs mit W-Präfix: W weggelassen, letzte Ziffer geändert), und, abgekürzt, Sheng et al. 2024 mit 160 Zitationen (Key 269117055) und Jiang et al. 2023 mit 20 Zitationen (Key 3664640) für die mitgelieferten Papers zu FlexGen und LLMLingua. Aus dem Gedächtnis, im selben Keyformat und nicht als LLM Memory markiert: Santhanam 2023 (163), Sharma 2023 (505), Jiang 2020 (1666), Daza 2021 (87), Sala-Newhausen 2020 (352), Derraik 2002 (2594), Antonini 2021 (102). Genutzte mitgelieferte Quellen pro Bericht: 11 bis 15 von 15. Eine Quellenangabe [LLM Memory] in 11 Berichten.
Format. Mit OpenAlex-IDs wie W4402683901 ließ das Modell beim Zitieren oft das W weg, deshalb nutzten die späteren Läufe numerische IDs. Das stoppte das fehlende W, nicht die falschen Keys: Die Läufe mit numerischen IDs erzeugten trotzdem die Keys Sheng 2024 und Jiang 2023 oben für mitgelieferte Papers. Jeder Bericht beginnt mit einem leeren Block <think>\n\n</think> (Qwen3-8B dokumentiert, dass der Block bei eingeschaltetem Thinking immer vorhanden ist, eventuell leer, und das Abschalten haben wir nicht getestet). 4 bis 8 Blöcke SECTION; pro Bericht. 0 von 12 gespeicherten Dateien enthalten TLDR; (eine Aufnahme im Tester zeigte es). Abweichende Metadaten: Nouri 2025 mit 25 Zitationen statt 27 zitiert (siebenmal in einem Bericht), Chen et al./80 für einen mitgelieferten Key Zixuan/25. Das Beispiel mit 6 Auszügen machte aus „one eighth“ „1/4 cost“ und „Up to 4x cheaper“ und fügte einen Abschnitt „Operational considerations“ ohne Quellenangabe hinzu. Unsere Laufnotizen verzeichnen ein Fragment [4]<Paper corpusId="2024" paperTitle="(2024)" isShortName></Paper> im Bericht der finalen Demoaufnahme. Frame für Frame haben wir das nicht nachgeprüft. Promptzeile „Note that the current year is 2025“: Ein grep über die gespeicherten Berichtsdateien (12 Benchmark-Berichte plus 2 Beispielläufe) fand keinen Satz, der das aktuelle Jahr nennt oder mit Jahren rechnet; 2025 und 2026 erscheinen nur als Erscheinungsjahre zitierter Papers (in Keys und in Nennungen aus Autor und Jahr wie „Wang et al. (2025)“). Auf weichere Formulierungen, die etwas als aktuell darstellen, nicht geprüft.
Probleme der Plattform. (1) ensure() mit einer worker_id legt die Zuweisung mit einem literalen max_in_flight von 1 an (insert_assignment_with_version(..., wid, 1) in crates/manager/src/services/workloads.rs), während der Standard der Assignments-API, DEFAULT_MAX_IN_FLIGHT, bei 20 liegt. Workaround: PATCH /api/projects/<pid>/assignments/<workload>/<worker> mit {"max_in_flight":8}, beantwortet mit 204. (2) Noch kein Workaround. STREAM_FIRST_TOKEN_TIMEOUT_MS = 180_000 in crates/manager/src/api/openai.rs: Ein angestauter Stream endete bei 180.02 s mit HTTP 200, ohne Inhalt und ohne finish_reason, und der Worker hat diesen Job trotzdem in 106,767 ms abgeschlossen. (3) Streams über das Gateway lieferten kein usage.
Testdaten. Die API von Semantic Scholar antwortete mit 429, also haben wir OpenAlex genutzt: Arbeiten mit Abstracts, ab 2019, mehr als 8 Zitationen, 15 pro Frage. Promptgrößen 4,359 bis 5,068 Tokens mit dem eigenen Tokenizer des Modells.
Video und Aufräumen. Demovideo: 1920x1080, 131.4 s. Aufräumen: Workload und Pod gelöscht (RunPod antwortet mit 404), Tunnel, NATS, Datenbank und der leere MinIO-Bucket entfernt.
Quellen: Model Card, Model Card von SFT, Ai2-Blog, Prompt, DPO-Daten, Qwen3-8B, SDK-Beispiel, Demovideo.