EmbeddingGemma 2: ein kleines offenes Modell, um Text, Fotos, Video und Sprache zu durchsuchen
Googles EmbeddingGemma 2 legt Text, Bilder, Video und Audio in einen Suchraum. Auf unserer RTX 2000 Ada mit 16 GB belegte es 1.4 GB.
Am Morgen des 14. Oktober, auf einer gemieteten Grafikkarte mit 16 GB in einem Rechenzentrum in Island, haben wir einen kleinen Suchindex auf Englisch gefragt: „how to knead bread dough“ (wie man Brotteig knetet). Im Index lagen zwölf Dateien und keine einzige Zeile Text: sechs Bilder, drei kurze Videoclips und drei Sprachaufnahmen. Von den zwölf Dateien ging es nur in einer um Brot, und genau die landete ganz oben: eine Aufnahme, in der eine Computerstimme ein Brotrezept auf Spanisch vorliest.
Das Modell, das hier sucht, ist EmbeddingGemma 2, das Google DeepMind am 6. Oktober veröffentlicht hat, unter der Lizenz Apache 2.0. Es verwandelt Text, Code, Bilder, Video und Audio in dieselbe Art von Zahlenliste, sodass eine einzige Suche von einem Satz zu einem Foto, einem Clip oder einer Aufnahme springen kann. Das ganze Modell ist ein Download von 1.5 GB.
Kurz gesagt: Ein Modell liest fünf Arten von Eingaben und legt sie alle in denselben Suchraum, und es ist leicht genug für eine günstige gemietete GPU. Der Haken ist eine einzige Einstellung: Lässt du es im falschen Zahlenformat laufen, werden die Ergebnisse schlechter, ohne dass ein Fehler kommt. Davor warnt die Model Card (die Dokumentation, die Google mit dem Modell veröffentlicht).
Das haben wir auf dieser GPU gemessen, bevor wir irgendetwas davon erklären:
| EmbeddingGemma 2 auf einer NVIDIA RTX 2000 Ada (16 GB) | |
|---|---|
| Was hineingeht | Text und Code, Bilder, Video, Sprache und anderes Audio, oder eine Mischung davon in einer Eingabe |
| Was herauskommt | eine Liste mit 768 Zahlen pro Eingabe, kürzbar auf 512, 256 oder 128 |
| Modellgröße | insgesamt 740 Millionen Parameter (die gelernten Zahlen im Modell, ein grobes Maß für seine Größe), 270 Millionen, wenn du nur Text brauchst |
| GPU-Speicher, Modell geladen | 1.4 GB (0.5 GB nur Text) |
| GPU-Speicher im geschäftigsten Moment | 1.5 GB für ein Bild, 2.6 GB für ein Dokument nahe der Maximallänge des Modells, etwa 10 GB für acht lange Dokumente auf einmal |
| Modellzeit pro Anfrage | 36 ms für eine Suchanfrage, 111 ms für ein Bild, 158 ms für 8.6 s Sprache, 307 ms für einen Clip von 6 s |
| Unser Suchtest | 6 von 6 Textanfragen fanden die richtige Datei unter 12 Fotos, Clips und Aufnahmen |
| Zeit von „starten“ bis zur ersten Antwort | 78 s beim ersten Mal, 12 s, wenn die Modelldatei (1.5 GB) schon auf der Maschine lag |
Eine Landkarte, auf der Ähnliches nah beieinander landet
Ein Embedding ist eine Art, alles auf eine Landkarte zu setzen. Das Modell liest einen Satz, ein Foto oder eine Aufnahme und gibt ihm eine Position, geschrieben als Liste von Zahlen (hier 768). Was dasselbe bedeutet, landet nah beieinander. Suchen ist dann einfach: Du setzt die Frage auf dieselbe Karte und nimmst, was am nächsten liegt. Genau das machen viele Systeme nach dem Muster „chatte mit deinen Dokumenten“ unter der Haube: Sie suchen zuerst die passendsten Abschnitte und reichen sie dann an einen Chatbot weiter.
Viele Embedding-Modelle zeichnen ihre Karte nur aus Text. EmbeddingGemma 2 setzt jede Art von Eingabe auf eine einzige Karte. Das Foto eines Fuchses, der im Schnee schläft, und der Satz „ein Tier, das im Schnee schläft“ landen nah beieinander, und ein Video von 6 Sekunden mit demselben Fuchs ebenfalls. Du kannst auch Dinge in einer Eingabe mischen: Das Beispiel der Model Card ist ein Produktangebot mit zwei Fotos und einem Video, das als eine einzige Position auf der Karte herauskommt, die du mit allem anderen vergleichen kannst.
Stell dir die Festplatte einer Band nach einer Tour vor: Probenaufnahmen, Fotos von Gigs, wacklige Handyvideos aus dem Van, eine Setlist, getippt in einer Notizen-App. Mit einer einzigen Karte sind „das Publikum singt den Refrain“ oder „der Van an der Grenze“ Fragen, die du an all das aus einem einzigen Textfeld stellen kannst, solange der Moment von einem Mikro oder einer Kamera eingefangen wurde.
Was Google veröffentlicht hat
Das Modell hat drei Teile, und du lädst nur die, die du brauchst. Der Textteil, der auch Code liest, ist ein 270M-Modell. Ein Leser für Bilder und Video bringt 170M dazu, ein Leser für Ton 300M, zusammen 740M. Wenn deine Suche nur Text betrifft, lässt du die anderen beiden weg und behältst ein 270M-Modell. Das ist kleiner als das erste EmbeddingGemma (308M, laut Googles Doku), das laut Google die Marke von 20 Millionen Downloads überschritten hat.
Jede Eingabe kann etwa 8,000 Tokens lang sein (ein Token ist ungefähr ein Wort oder ein Stück davon), viermal so viel wie in der ersten Version. Bilder, Video und Ton teilen sich dasselbe Budget: Standardmäßig passen laut Model Card etwa 29 Bilder, 58 Videoframes (einer pro Sekunde) oder etwa fünfeinhalb Minuten Audio in eine Eingabe. Es deckt mehr als 100 Sprachen ab, und in unserem Test hat eine spanische Aufnahme eine englische Frage beantwortet.
In Googles eigenen Tests ist es bei Text in vielen Sprachen so gut wie die erste Version (61.36 gegen 61.15) und etwa 14 % besser beim Finden von Code (78.68 gegen 68.76). Für die Werte bei Bild, Video und Ton gibt es keine frühere Version zum Vergleich. Die volle Tabelle steht im Abschnitt für Engineers.
Die Lizenz ist Apache 2.0, die kommerzielle Nutzung, Änderungen und Weiterverbreitung erlaubt. Google nennt sie „commercially permissive“, und das Repo auf Hugging Face ist offen, ohne Formular, das du unterschreiben musst.
Kleinere Zahlenlisten, fast dieselbe Suche
Jede Datei, die du indexierst, wird als ihre Zahlenliste gespeichert, und ein großer Index bedeutet eine große Rechnung für Speicher und Arbeitsspeicher. EmbeddingGemma 2 ist wie ein Satz Matroschkas trainiert (die Technik, Matryoshka Representation Learning, ist nach den russischen Puppen benannt): Die ersten 512, 256 oder 128 Zahlen jeder Liste sind eine kleinere Version der Karte, die immer noch funktioniert. Wer von 768 auf 128 Zahlen kürzt, speichert sechsmal weniger.
Die Model Card ist ehrlich, was den Preis angeht. Bis hinunter zu 256 Zahlen sind die Ergebnisse „close to lossless“ (nahezu verlustfrei): Der Textwert bewegt sich kaum (61.36 auf 60.41). Bei 128 hält Text noch stand, aber die Suche über Bilder und Video verliert fast ein Viertel ihres Werts (59.01 auf 45.65) und die Suche in gesprochenem Audio etwa ein Fünftel (69.54 auf 56.71). Die Model Card rät, 128 für reine Textarbeit zu nutzen. Als einfache Rechnung: Eine Million Dokumente mit je 768 Zahlen, gespeichert mit 4 Bytes pro Zahl, belegen etwa 3 GB, mit 256 Zahlen etwa 1 GB.
Die Einstellung, die scheitert, ohne es dir zu sagen
GPUs können Zahlen in einem kompakten Format speichern, um Speicher zu sparen. Das gängigste, float16, ist genau das, das du laut Model Card nie verwenden sollst: Die internen Zahlen des Modells wachsen darüber hinaus. Sein Schwesterformat bfloat16 braucht genauso viel Speicher und ist sicher. Das Format in voller Größe (float32) ist auch sicher, braucht aber doppelt so viel Speicher.
Das zählt auf älteren GPUs, denen das sichere Format fehlt: Dort zahlst du für das Format in voller Größe den doppelten Speicher. Unser Beispiel verlangt eine neuere NVIDIA-GPU mit dem sicheren Format, wie die RTX 2000 Ada, die wir genutzt haben. Der Code der Model Card wählt das sichere Format, wenn die GPU es unterstützt, und sonst das Format in voller Größe. Unser Backend macht es genauso und verwendet nie float16. Ältere GPUs haben wir nicht getestet, also prüf auf deiner, welches Format dein Code tatsächlich wählt.
Eine Sache haben wir nicht gemacht: Wir haben das Modell nie in float16 laufen lassen, um den Fehler selbst zu sehen. Alles, was wir gemessen haben, ist das sichere 16-Bit-Format auf der GPU oder das Format in voller Größe auf einem gewöhnlichen Prozessor. Die Warnung stammt von Google.
So läuft es auf InferenceKey
Kein fertiger Server, den wir ausprobiert haben, konnte dieses Modell schon vollständig betreiben, also haben wir selbst einen kleinen geschrieben und ihn auf InferenceKey laufen lassen. Hier sind die GPU, der Code, die Zahlen und was unterwegs kaputtging.
Die GPU und warum genau diese
Wir haben eine NVIDIA RTX 2000 Ada Generation mit 16 GB Speicher bei RunPod in Island gemietet. Sie ist eine kleine Workstation-GPU mit 70 Watt, und das reicht hier völlig: Das Modell lud in 1.4 GB und ließ den Großteil der 16 GB für lange Eingaben frei. Unsere erste Wahl, eine RTX A4000, war nicht verfügbar, also haben wir diese genommen.
Für deine eigene Rechnung: 100,000 Seiten mit je etwa 500 Tokens zu indexieren würde nach unserer Rechnung etwa 36 Minuten Modellzeit dauern (wir haben 32 solche Seiten in 0.69 Sekunden gemessen). Das zählt nur die Modellzeit, nicht die Zeit, um die Dateien zu schicken, die Maschine zu starten oder zwischen den Anfragen zu warten.
Warum ein Custom Backend
Ein Backend ist das Stück Code, das ein Modell einmal lädt und dann Anfragen beantwortet. Die fertigen Embedding-Backends von InferenceKey nehmen nur Text, und der Open-Source-Server vLLM kannte dieses Modell noch nicht, als wir nachgesehen haben (Version 0.31.0). Googles Launch-Post nennt mehrere dieser Werkzeuge als unterstützt, das kann sich also schnell ändern. Die Details stehen im Abschnitt für Engineers.
Also haben wir unser eigenes Backend in Python geschrieben, was InferenceKey zulässt. Das Paket hat etwa 6 KB, ohne Gewichte darin, und es lädt das Modell so, wie die Model Card es zeigt, in bfloat16. Für Text nimmt es dasselbe Anfrageformat wie die Embedding-API von OpenAI. Für Medien fügt es eine eigene einfache Form hinzu, sodass jedes Element Text, ein Foto, eine Aufnahme oder ein Clip sein kann, und es kann die kürzeren Listen zurückgeben. Eine fehlerhafte Eingabe bekommt einen klaren Fehler statt einer seltsamen Antwort.
Außerdem haben wir eine reine Textvariante veröffentlicht, die die Leser für Bild und Ton nie lädt. Sie belegte geladen 0.5 GB GPU-Speicher.
All das lief auf einer privaten Testkopie von InferenceKey, mit der gemieteten GPU, die sich zu ihr zurückverbindet, sodass nichts davon unseren Produktivdienst berührt hat. Der Firmenname im Video, Northwind Search, ist ein erfundener Demo-Account.
Die Schritte
Alles steckt im Beispiel in unserem SDK (dem Software-Kit, um InferenceKey aus Code zu steuern), embeddinggemma2-multimodal-embedding-custom-backend-private-nvidia. Du brauchst einen InferenceKey-Account mit einem NVIDIA-Worker (einer GPU-Maschine, die mit deinem Projekt verbunden ist), dessen GPU bfloat16 unterstützt. Die Datei .env des Beispiels listet die Schlüssel auf, die es liest. Das SDK wird lokal aus dem Repo gebaut:
cp .env.example .env        # SDK token, API key, project, worker id (tenant id and session token only for publish.py)
python -m venv .venv && . .venv/bin/activate
pip install maturin requests
( cd ../../bindings/python && maturin develop --release )
python publish.py           # packages backend.py and registers it as "embeddinggemma2-multimodal"
python main.py              # deploy, wait until ready, text search, then cross-modal search over ./media
main.py bittet InferenceKey um eine Kopie des Modells auf deinem Worker, wartet, bis sie ausliefert, führt eine Textsuche aus und ordnet dann Textanfragen gegen jedes Foto, jede Aufnahme und jeden Clip in ./media. Beim Beenden löscht es das laufende Modell (den Workload), außer du setzt IK_KEEP_ALIVE=1. Für die reine Textvariante: python publish.py --variant text, dann EG2_VARIANT=text python main.py. Unten siehst du, wie die Anfrage aussieht. Die gezeigte Adresse ist der gehostete InferenceKey-Dienst, den das Beispiel standardmäßig nutzt. Wir haben dieselbe Anfrage an unsere private Testkopie geschickt, nicht an diese Adresse.
curl https://cloud.inferencekey.com/endpoint/$INFERENCEKEY_PROJECT/embeddinggemma2-multimodal/v1/embeddings \
  -H "Authorization: Bearer $INFERENCEKEY_API_KEY" -H "Content-Type: application/json" \
  -d '{"model": "default", "input": ["an animal sleeping in the snow", {"image": "https://example.com/fox.jpg"}], "prompt_name": "SearchQuery", "dimensions": 256}'
Was wir gemessen haben
Start. Vom Deploy-Aufruf bis zur ersten möglichen Antwort vergingen auf einer frischen Maschine 78 Sekunden: 49 Sekunden, um die Python-Bibliotheken zu installieren, dann 29 Sekunden, um die Modelldatei mit 1.5 GB herunterzuladen und zu laden. Mit der Modelldatei schon auf der Maschine war ein frisches Deploy in 12 Sekunden bereit. Als wir eine neue Version unseres Backends veröffentlicht haben, hat InferenceKey das laufende Modell von selbst mit dem neuen Code neu gestartet, in 13 Sekunden.
Geschwindigkeit. Das sind die Zeiten, die die GPU-Maschine für jede Anfrage gebraucht hat, jeweils der mittlere Wert mehrerer Läufe:
- eine Suchanfrage: 36 ms
- 256 kurze Texte in einer Anfrage: 204 ms, etwa 1,250 Texte pro Sekunde (unsere Rechnung)
- 32 Dokumente mit etwa 500 Tokens (ungefähr je eine Seite) in einer Anfrage: 688 ms, also etwa 46 Seiten pro Sekunde (unsere Rechnung)
- 8.6 Sekunden Sprache: 158 ms
- ein Foto: 111 ms, und acht Fotos in einer Anfrage: 867 ms, etwa 9 Fotos pro Sekunde (unsere Rechnung)
- ein Videoclip von 6 Sekunden: 307 ms
- ein Satz, zwei Fotos und eine Aufnahme, gemischt in einer Eingabe: 232 ms
Die Liste auf 512, 256 oder 128 Zahlen zu kürzen, hat an der Geschwindigkeit nichts geändert (34 bis 35 ms für eine Anfrage). Es macht nur die Antwort kleiner beim Senden und Speichern.
Von unserem Schreibtisch aus gesehen dauerte jede Anfrage etwa eine Viertelsekunde länger als diese Zahlen. Diese zusätzliche Zeit ist die Strecke, nicht das Modell: Die Anfragen gingen von unserer Entwicklungsmaschine über die Testkopie von InferenceKey und einen Tunnel zu einer GPU in Island. Ein Deployment, das neben seinen Nutzern steht, würde das meiste davon nicht zahlen.
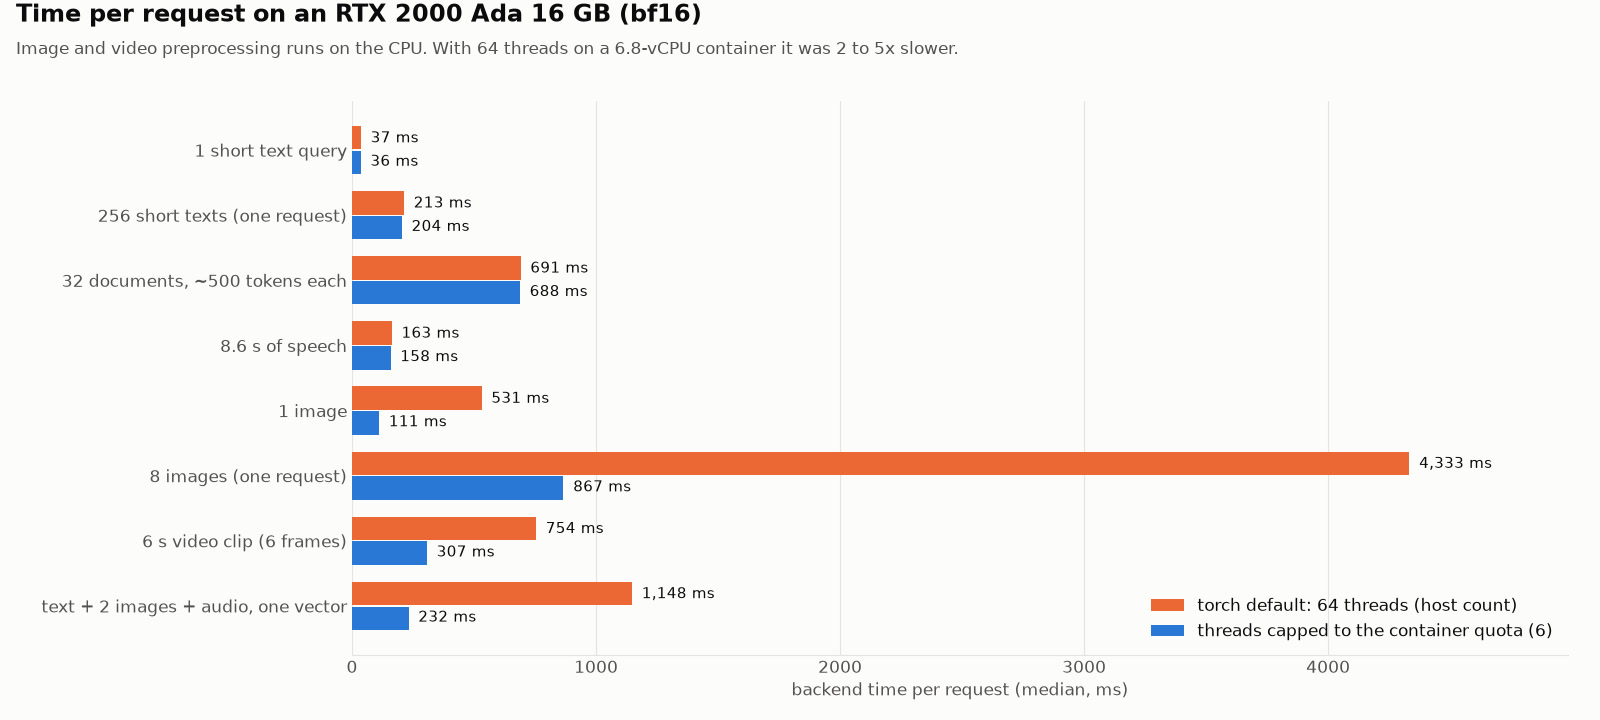
Blau ist das finale Backend. Orange ist die erste Version, vor dem CPU-Fix, der unter „Was schiefging“ beschrieben ist. Text und Sprache war das egal. Fotos und Video waren zwei- bis fünfmal langsamer.
Speicher. Das volle Modell belegte geladen 1.4 GB GPU-Speicher. Eine kurze Anfrage hat daran kaum etwas bewegt. Auf unserer GPU brauchte das Modell plus jeweils eine Eingabe nie mehr als 2.6 GB. Große Batches langer Dokumente sind die Ausnahme: Acht Dokumente mit 6,000 Tokens in einer Anfrage brauchten etwa 10 GB. Im Detail lag die Spitze bei 1.5 GB für ein Foto, 2.0 GB für acht Fotos, 2.6 GB für ein Dokument mit 8,000 Tokens und 3.3 GB für 32 Dokumente mit 500 Tokens. Auf einer GPU mit 16 GB passt das noch, aber das ist die Zahl, mit der du planen solltest, wenn du lange PDFs in großen Mengen indexierst. Die GPU hat nie mehr als 68 Watt gezogen.
Der Suchtest
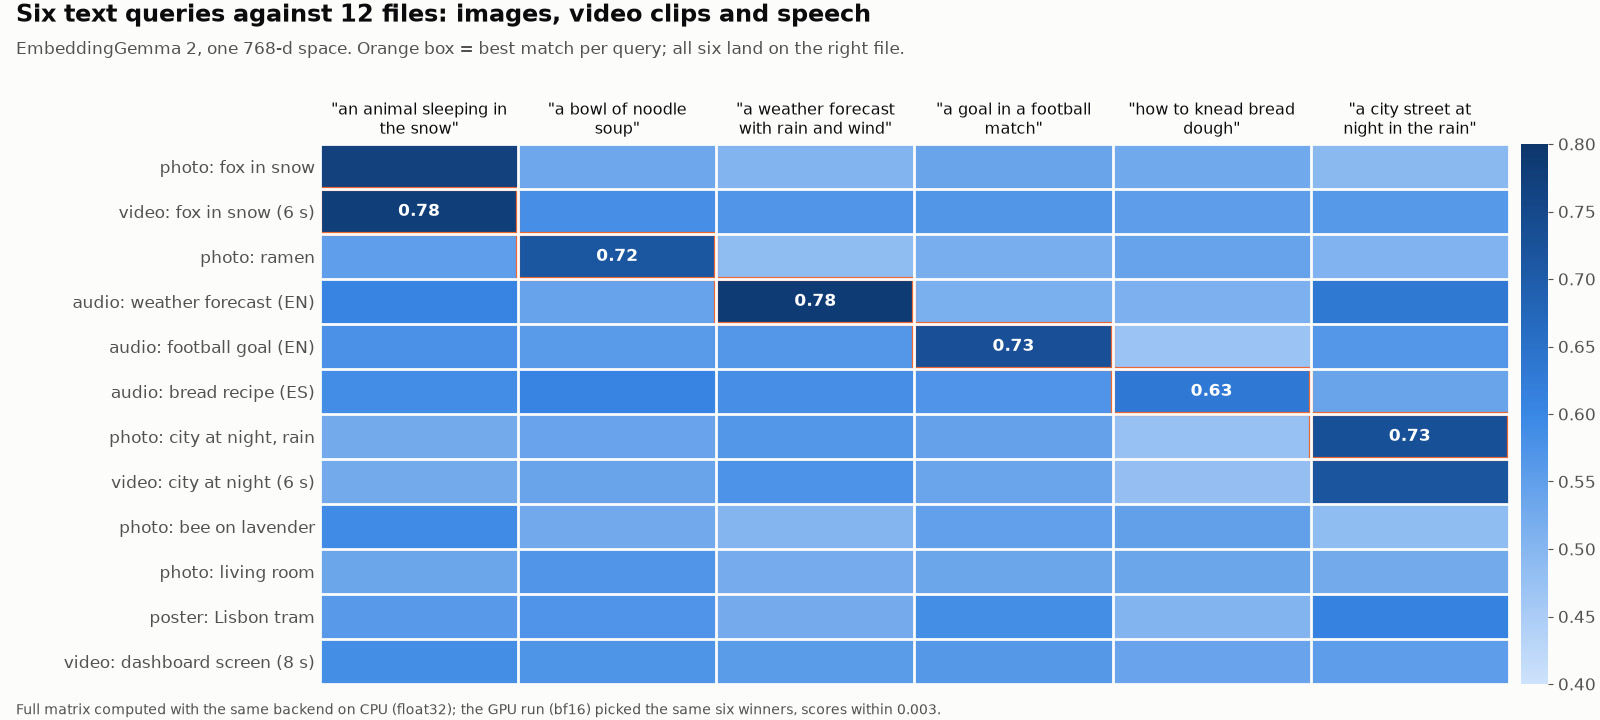
Jede Spalte ist eine Frage, jede Zeile eine Datei. Dunkler heißt näher auf der Karte. Die umrahmte Zelle ist die Top-Antwort.
Alle sechs Fragen fanden die richtige Datei. „A weather forecast with rain and wind“ (eine Wettervorhersage mit Regen und Wind) fand die gesprochene Vorhersage. „A goal in a football match“ (ein Tor in einem Fußballspiel) fand den Fußballkommentar. „How to knead bread dough“ fand das spanische Rezept. Bei „an animal sleeping in the snow“ (ein Tier, das im Schnee schläft) waren die beiden Top-Antworten das Video vom Fuchs und das Foto desselben Fuchses, und bei „a city street at night in the rain“ (eine Stadtstraße nachts im Regen) das Foto und das Video derselben Straße. Eine Einschränkung: Jedes dieser Videos ist ein langsamer Kameraschwenk über genau das Bild, neben dem es steht, seine Frames sind also Ausschnitte aus diesem Foto. Der knappe Gleichstand zeigt, dass der Weg für Video und der Weg für Fotos sich einig sind, nicht dass das Modell dieselbe Szene erkannt hat, die getrennt gefilmt wurde. Die Werte waren identisch, als wir den Test 22 Minuten später noch einmal laufen ließen.
Das beweist weniger, als es aussieht. Die zwölf Dateien sind unsere eigenen und synthetisch: sechs Bilder, die wir mit Iris-3B, einem Modell zur Bilderzeugung, in einem früheren Test gemacht haben, drei Aufnahmen, erstellt mit Pocket TTS, einem Text-to-Speech-Modell, und drei Clips (zwei Kameraschwenks von 6 Sekunden über die Bilder und 8 Sekunden aus unserer früheren Panel-Demo von Iris, der „Dashboard-Bildschirm“). Es zeigt, dass der Mechanismus über InferenceKey funktioniert. Es sagt nichts darüber, wie sich das Modell gegen andere schlägt, dafür ist Googles Benchmark-Tabelle da. Der Wert misst, wie nah eine Datei auf der Karte an der Frage liegt, und höher heißt näher. Alle lagen in einem schmalen Band, zwischen etwa 0.45 und 0.80, also zählt der Abstand zwischen erster und zweiter Antwort, nicht die Zahl selbst. Der niedrigste Gewinner war das Brotrezept, mit 0.63.
Die Demo
Die 57 Sekunden lange Aufnahme unten zeigt das InferenceKey-Panel während des Tests: beide Workloads von EmbeddingGemma 2 (voll und nur Text) laufen auf der GPU-Maschine namens gpu-search-01, das eingebaute Testfeld des Panels beantwortet eine Suchanfrage in 163 ms mit einer Liste von 768 Zahlen, und die Live-Ansicht zeigt, wie ein Skript Fotos, Aufnahmen und Clips schickt.
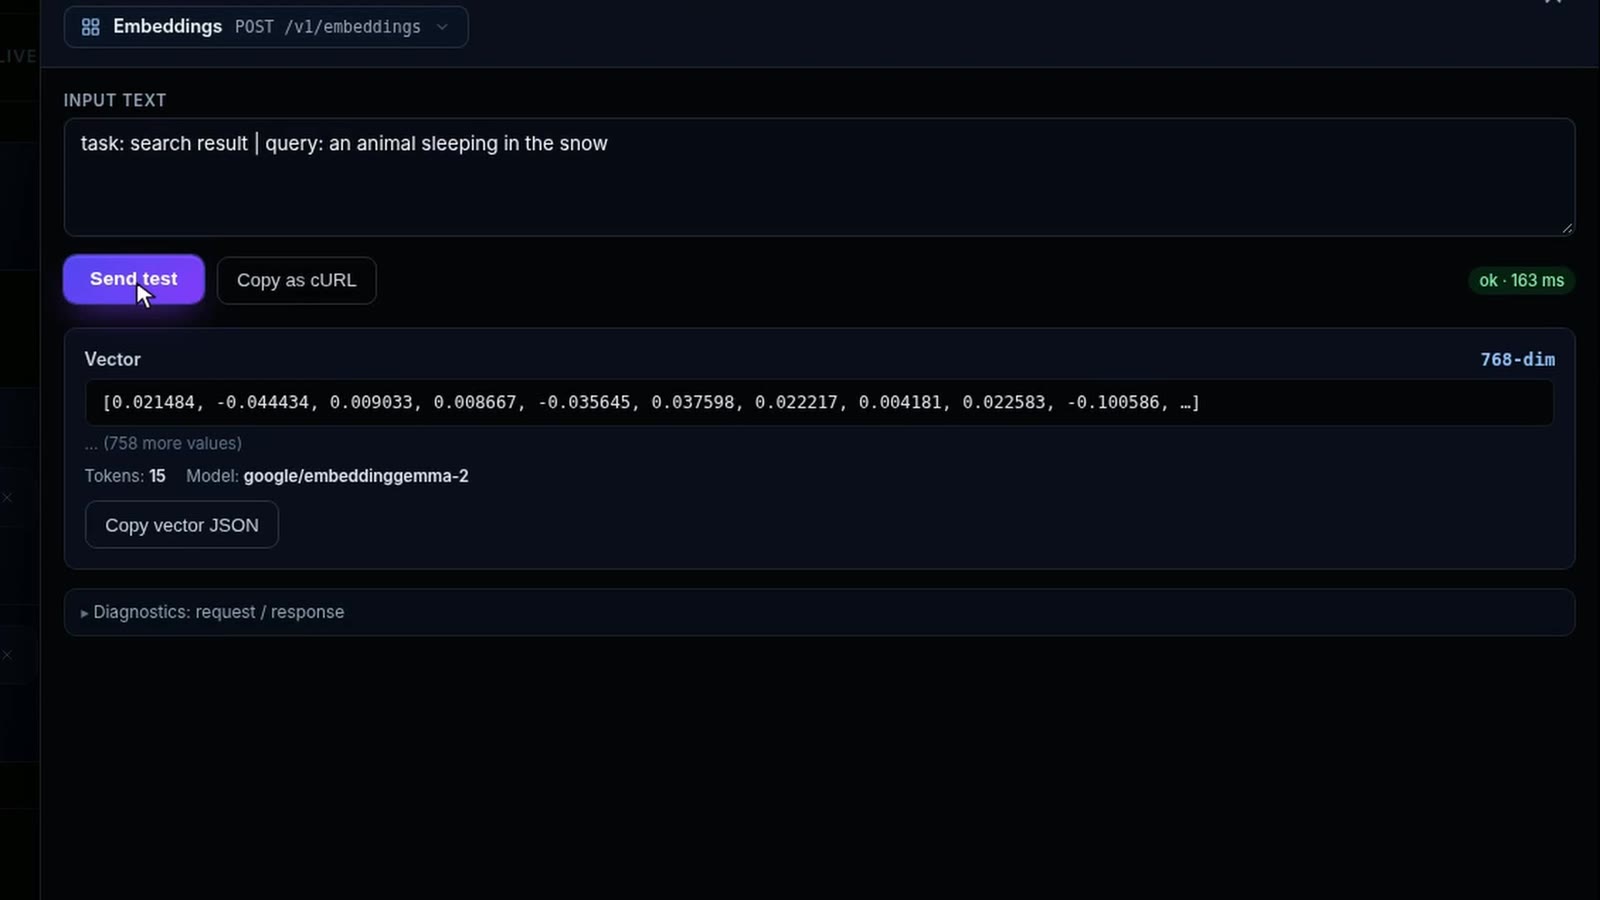
Klick auf das Bild, um das MP4 abzuspielen (56.6 s, 4.8 MB).
Zwei Details des Panels sind im Bild zu sehen, und die müssen wir beheben: Die Spalte Access zeigt „No access“, obwohl der API-Key des Projekts funktioniert hat, und die Tabelle Workers sagt, dass sie nur einen Teil der Zustandswerte der GPU bekommt („GPU telemetry partial“).
Was schiefging
Das Modell lief von Anfang bis Ende, und der Tester und die Live-Ansicht des Panels funktionierten mit unserem Backend ohne Änderungen. Unterwegs sind wir auf fünf Probleme gestoßen. Die Probleme 1 bis 3 lagen in unserem Backend, und die Probleme 1, 4 und 5 zeigen Lücken auf der Seite von InferenceKey:
- Die erste Installation scheiterte nach 3 Sekunden, und der Grund stand nicht im Log. Der Worker sagte nur, dass die Python-Installation fehlgeschlagen war. Erst als wir sie von Hand auf der Maschine ausführten, sahen wir warum: Der Installer hatte veraltete Kopien einiger gängiger Bibliotheken aus einer zweiten Download-Quelle gezogen, und die Mindestversionen, die wir verlangt hatten, ließen sich nicht erfüllen. Wir haben sie entfernt. Die eigentliche Lücke liegt bei uns: Der Worker sollte den Fehler des Installers zeigen, und heute tut er das nicht.
- Fotos und Video waren zwei- bis fünfmal langsamer, als sie sein sollten. Die GPU brauchte etwa 72 ms pro Foto, aber die CPU brauchte 0.33 bis 0.44 Sekunden, um es vorzubereiten. Unsere gemietete Maschine war ein Stück eines größeren Servers. Sie durfte etwa 7 Prozessorkerne nutzen, aber die Software sah alle 64 und versuchte, sie alle zu nutzen, sodass die Arbeit sich ständig selbst im Weg stand. Als wir ihr sagten, nur ihren echten Anteil zu nutzen, sank ein Foto von 531 auf 111 ms und acht Fotos von 4.3 auf 0.87 Sekunden. Der Fix steckt im Beispiel: Es liest, wie viele Kerne die gemietete Maschine nutzen darf, und auf einer Maschine, die das nicht verrät, setzt du die Zahl selbst.
- Die GPU hielt Speicher fest, den sie nicht mehr brauchte. Nach dem Batch mit acht langen Dokumenten hielt der Server 11.6 GB fest, bis er neu gestartet wurde, weil die KI-Bibliothek darunter Speicher fürs nächste Mal aufhebt. Das Backend gibt diesen Speicher jetzt nach jeder sehr großen Anfrage zurück, und nach demselben Batch lag es bei 1.6 GB.
- „Warten bis bereit“ hing einmal fest. Als wir das SDK baten, ein Modell zu deployen, das schon auslieferte, und dann zu warten, bis es bereit ist, blieb es in einem Lauf über 10 Minuten bei „checking readiness“ stehen (wir haben abgebrochen) und 90 Sekunden, als wir es absichtlich noch einmal probiert haben. Unsere Testkopie lief mit einer abgeschalteten Komponente von InferenceKey, dem Policy Executor. Das könnte zusammenhängen, aber wir wissen es noch nicht, und wir haben nicht bestätigt, dass es in Produktion passiert. Löschen und neu deployen dauerte 12 Sekunden.
- Der Tester des Panels nimmt nur Text. Fotos, Ton und Video müssen vorerst über die API gehen.
Wer was gemacht hat
EmbeddingGemma 2 ist die Arbeit von Google DeepMind: das Modell, die drei Leser, die Benchmark-Tabelle und die Model Card, die vor float16 warnt. Sie haben es mit der Matroschka-Technik trainiert (Matryoshka Representation Learning, aus früherer Forschung von Kusupati und Kollegen 2022). Der Launch-Post stammt von Sahil Dua und Henrique Schechter Vera, Research Engineers bei Google DeepMind. Das Modell baut auf Gemma 4 auf, teilt Teile damit (seinen Wortzerleger und seinen Ton-Leser) und kommt laut Post aus derselben Technologie wie die Gemini-Embedding-Modelle. Die Bibliothek transformers von Hugging Face, der Standardcode, um offene Modelle zu betreiben, hat die Unterstützung in Version 5.19.0 hinzugefügt. Ihr Begleiter sentence-transformers ist das, womit die Model Card das Modell ausführt. PyAV, ein Leser für Video und Audio, hat unsere Clips und Aufnahmen dekodiert. Die Testbilder kamen aus Iris-3B von Sperid Labs, die drei Sprachaufnahmen vom Text-to-Speech-Modell Pocket TTS, und das Videowerkzeug ffmpeg hat die Schwenks geschnitten.
Unser Anteil: prüfen, welche Werkzeuge es betreiben können, das Custom Backend und das SDK-Beispiel schreiben, es auf InferenceKey laufen lassen, Geschwindigkeit und Speicher messen, die drei Probleme im Backend beheben und die Demo aufnehmen.
Was du mitnehmen kannst
Wenn du Suche über Dokumente, Fotos, Aufnahmen und Video auf deiner eigenen GPU willst, unter einer Lizenz, die dich ein Produkt darauf bauen lässt, ist EmbeddingGemma 2 einen Test wert. Es lief auf einer kleinen GPU mit 16 GB, mit dem Großteil des Speichers in Reserve, und das Modell brauchte 36 ms für eine Suchanfrage und etwa eine Zehntelsekunde für ein Foto. Unsere Meinung: Das Argument dafür, das auf deiner eigenen GPU zu betreiben, sind Kontrolle und Privatsphäre, nicht die Kosten (Preise haben wir nicht verglichen). Gesprächsaufnahmen, Produktfotos und Bildschirmaufnahmen sind genau die Dateien, die du lieber nicht bei der API von jemand anderem hochlädst, um sie durchsuchbar zu machen. Hier bleiben Modell und Daten auf einer Maschine, die du wählst, deinem eigenen Server oder einer GPU, die du mietest, nicht auf einer, die du mit einem API-Anbieter teilst. Unser eigener Test lief auf einem gemieteten Pod. Plane drei Dinge ein. Lass es in bfloat16 oder im Format in voller Größe (float32) laufen, nie in float16. Wenn du Fotos oder Video auf einer gemieteten Maschine vorbereitest, sag der Software, wie viele Prozessorkerne sie wirklich hat. Und halte etwa 10 GB GPU-Speicher frei, wenn du lange Dokumente in großen Batches schickst.
Der Check, den wir nicht gemacht haben, ist genau der, vor dem die Model Card warnt. Dieser Test war darauf beschränkt, das Modell auf die sichere Art zu betreiben, also ist ein Lauf in float16 unser nächster Test, nicht Teil von diesem: das Modell auf derselben GPU in float16 laden, dieselben zwölf Dateien einbetten und die Karte mit der oben vergleichen. Wenn die Model Card recht hat, stürzt nichts ab, und die Zahlenlisten kommen vielleicht ohne Bedeutung zurück (NaN, „not a number“) oder still daneben. Wir werden sehen, ob sich ein Kästchen verschiebt.
Für Engineers
Modell (Model Card, Launch-Post, Google-Doku). HF-Repo google/embeddinggemma-2, erstellt am 2026-09-14, zuletzt geändert am 2026-10-06, sha 914f7f89142e33e77833254d9c9b90c3cef7303b, license:apache-2.0, nicht gated, 124,930 Downloads und 2,122 Likes, als wir es am 2026-10-14 abgerufen haben. model.safetensors 1,488,915,288 Bytes (bf16).
Text-Backbone: 24 Layer, Model Dim 512, Hidden Dim 2048, 4 Heads, KV-Heads lokal/global 2/1 (GQA/MQA), lokal:global 5:1, Sliding Window 1024, Vokabular 262,144, Gated FFN mit GELU, Mean Pooling, Projektion 512 -> 768. Kontext 8,192 Tokens. Ausgabe 768, MRL-Kürzung auf 512/256/128 (nach dem Kürzen neu normalisieren, und Queries und Dokumente müssen dieselbe Dimension nutzen).
Selektives Laden der Encoder (sentence-transformers config_kwargs):
| Laden | config_kwargs | Parameter |
|---|---|---|
| nur Text | {"vision_config": None, "audio_config": None} | 270M (wir haben 271,002,624 gezählt) |
| Text + Bild | {"audio_config": None} | 440M |
| Text + Audio | {"vision_config": None} | 570M |
| voll | {} | 740M |
Token-Kosten im gemeinsamen Fenster von 8,192 Tokens: Text 1 pro Subword, Bild standardmäßig 280 (etwa 29 Bilder), Video 140 pro Frame (etwa 58 Frames, Standard 1 fps), Audio 25 pro Sekunde (etwa 327 s, mono 16 kHz). Das Vision-Budget ist von 70 bis 1120 Soft Tokens einstellbar, am unteren Ende bis zu etwa 114 Bilder oder Frames. Interleaving nutzt die Platzhalter <|image|>, <|video|>, <|audio|> und gibt ein Embedding zurück. Texteingaben nehmen Task-Präfixe (task: search result | query: {query}, Dokumente title: {title} | text: {content}, task: code retrieval | query: {query}), Medien keine. 100+ Sprachen, Trainingsdaten in 140+ Sprachen, Stichtag Januar 2025.
Benchmarks aus der Model Card (Checkpoint in voller Präzision):
| 768d | 512d | 256d | 128d | EmbeddingGemma 1 (768d) | |
|---|---|---|---|---|---|
| MTEB multilingual v2 | 61.36 | 61.17 | 60.41 | 57.89 | 61.15 |
| MTEB code v1 | 78.68 | 77.24 | 76.18 | 71.41 | 68.76 |
| MMEB v2 overall | 59.01 | 58.38 | 56.24 | 45.65 | |
| MSEB retrieval (MRR@10) | 69.54 | 69.18 | 66.76 | 56.71 |
Ebenfalls bei 768d: MIEB lite 64.64, MMEB v2 Image 57.28 (Hit@1), VisDoc 67.84 (NDCG@5), Video 50.67 (Hit@1), MAEB 49.39. Die Model Card beschreibt den Gewinn bei Code als etwa 14 %, der Blog als +9.92 Punkte, was dieselbe Änderung ist (9.92 / 68.76).
Präzision, wörtlich aus der Model Card: „Run inference in bfloat16 or float32. Do not use float16.“ und „In float16 the model returns NaN or silently degraded embeddings rather than raising an error, so the failure is easy to miss.“ bfloat16, wo nativ unterstützt, float32 sonst, einschließlich der meisten CPUs. Vorgeschlagene Auswahl: dtype = torch.bfloat16 if torch.cuda.is_bf16_supported() else torch.float32. Einen Vergleich mit float16 haben wir nicht laufen lassen. Googles Zahlen für On-Device (quantisiert, Pixel 11 Pro) sind etwa 191 MB RAM nur Text und etwa 567 MB voll. Keine von Googles Seiten nennt einen Wert für GPU-VRAM.
Unser Setup. RunPod NVIDIA RTX 2000 Ada Generation, SECURE Cloud, EUR-IS-1, Treiber 570.195.03 (CUDA 12.8), 16,380 MiB, Limit 70 W, Compute Capability 8.9, 8 vCPU gelistet, cgroup-Quota 6.8 CPUs bei 64 sichtbaren, 0.24 USD/h. RTX A4000 COMMUNITY und SECURE sowie RTX 2000 Ada COMMUNITY antworteten mit 409 wegen fehlendem Bestand. Pod-Bootstrap 66 s nach dem Create-Aufruf. Lokaler InferenceKey-Manager (nie Produktion), erreicht über HTTP- und TCP-Tunnel, 71 ms RTT zum Pod. Backend: Python 3.12.3, torch 2.14.1+cu126 (das CUDA-13-Wheel auf PyPI braucht Treiber 580+), transformers 5.19.0 (erstes Release mit embedding_gemma2), sentence-transformers 6.1.0, av 19.0.1. Multimodales venv 6.7 GB auf der Platte, reines Text-venv 89 MB, HF-Cache 1.5 GB. Custom-Backend-Slugs embeddinggemma2-multimodal und embeddinggemma2-text, task_type embedding, Policy fixed. Veröffentlichte Versionen 0.1.0 (Installation fehlgeschlagen), 0.1.1, 0.1.2 (Thread-Cap), 0.1.3 (Cache-Freigabe). Commit des SDK-Beispiels f18474c auf inferencekey-sdk main. Anfragen reisen als eine Nachricht mit einem Limit von 8 MB, also schick große Dateien einzeln pro Anfrage oder übergib URLs.
Warum ein Custom Backend, und was es tut. vLLM 0.31.0 (2026-10-05) registriert Gemma3TextModel (EmbeddingGemma 1), aber kein EmbeddingGemma2Model, kann dieses Modell also nicht einmal für Text ausliefern. Die eingebauten Embedding-Backends von InferenceKey (SGLang, Ollama, llama.cpp) nehmen nur Text. Googles Launch-Post nennt vLLM, SGLang, Ollama, llama.cpp (GGUF) und andere als unterstützte Werkzeuge; spätere vLLM-Builds und die Nicht-Text-Wege der anderen haben wir nicht geprüft. Das Backend lädt SentenceTransformer("google/embeddinggemma-2") in bf16, wenn torch.cuda.is_bf16_supported(), sonst float32, nie float16. Bilder werden mit Pillow dekodiert, Audio und Video mit PyAV (Video 1 fps, max. 32 Frames; Audio 16 kHz mono). /v1/embeddings nimmt für Text die JSON-Form von OpenAI; Elemente können auch Objekte mit text, image, audio oder video sein (Data-URI, Base64 oder URL), was unsere Erweiterung ist, ein Standard-Client von OpenAI kann also nur Text schicken. Weitere Felder: dimensions (768/512/256/128), prompt_name, encoding_format. Antworten enthalten usage und timings. Fehlerhafte Eingaben geben 400 zurück (geprüft mit dimensions: 300 und einem nicht dekodierbaren Bild).
Startzeiten. Kalt: ensure() bis bereit 78.3 s (venv + Abhängigkeiten 49 s, Download + Laden 28.6 s). Reine Textvariante als zweiter Workload auf demselben Pod: 19.7 s (Laden 5.3 s). Neu-Veröffentlichung 0.1.1 -> 0.1.2 hat den laufenden Workload in 13 s heiß recycelt. Frisches ensure() mit gecachten Gewichten: 11.9 s.
Modellzeit pro Anfrage (Backend timings.encode_s, bf16, Mediane. Vorher = 64 Threads, nachher = auf die cgroup-Quota begrenzt):
| Eingabe | vorher ms | nachher ms | Roundtrip nachher s |
|---|---|---|---|
| 1 kurze Textanfrage | 37 | 36 | 0.28 |
| 256 kurze Texte (4,242 Tokens) | 213 | 204 | 1.02 |
| 32 Docs mit ~500 Tokens (16,256 Tokens) | 691 | 688 | 1.15 |
| 8 Docs mit ~6,000 Tokens (48,064 Tokens) | 4,411 | 4,416 | 5.73 |
| 8.6 s Sprache | 163 | 158 | 0.50 |
| 1 Bild (JPEG mit 768 px) | 531 | 111 | 0.38 |
| 8 Bilder | 4,333 | 867 | 1.32 |
| Video 6 s, 6 Frames | 754 | 307 | 0.68 |
| Bildschirmaufnahme 8 s, 8 Frames | 910 | 422 | 0.85 |
| Text + 2 Bilder + Audio, ein Vektor | 1,148 | 232 | 0.58 |
| 1 Text bei 512 / 256 / 128 Dims | 35 / 34 / 35 | 0.28 / 0.28 / 0.29 |
Durchsatz: etwa 23,600 Tokens/s bei Docs mit 500 Tokens und etwa 10,900 Tokens/s bei Docs mit 6,000 Tokens. Texte/s und Bilder/s im Erzählteil sind unsere Division dieser Mediane, keine eigenen Messungen. dimensions ändert die Größe der Antwort (5,550 / 2,883 / 1,559 Bytes bei 512 / 256 / 128), nicht die Geschwindigkeit. Plattform-Overhead etwa 0.25 s pro Anfrage auf unserem getunnelten Weg. Der Panel-Tester zeigte 163 ms für eine Anfrage mit 15 Tokens.
VRAM (torch.cuda.max_memory_allocated in einem separaten Prozess, dazu nvidia-smi alle 0.5 s). Geladen: 1,432 MiB allokiert (multimodal), 517 MiB (nur Text), 1,530 MiB auf der GPU direkt nach dem Laden. Spitzen: 1 kurzer Text 1,441 MiB, 1 Bild 1,515 MiB, 8 Bilder 2,031 MiB, 32 Docs x 500 Tokens 3,344 MiB, ein Doc mit 2,000 Tokens 1,678 MiB, ein Doc mit 6,000 Tokens 2,152 MiB, ein Doc mit 8,000 Tokens 2,640 MiB. 8 Docs x 6,000 Tokens: Der ausliefernde Prozess wuchs auf 11,610 MiB und behielt das (Allocator-Cache). Derselbe Batch in einem dritten Prozess lief mit 0.9 GB frei in einen OOM („Tried to allocate 1.10 GiB“), er braucht also etwa 10 GB. Mit torch.cuda.empty_cache() oberhalb von 16,384 Tokens lagen die beiden ausliefernden Prozesse nach demselben Batch bei 1,598 MiB und 678 MiB. Spitzenleistung 68.1 W.
Retrieval-Test (12 Dateien, eine pro Anfrage eingebettet, sechs englische Anfragen mit prompt_name: SearchQuery, GPU bf16):
| Anfrage | Top-1 (Wert) | Zweiter (Wert) |
|---|---|---|
| an animal sleeping in the snow | video-fox.mp4 (0.7756) | img-fox.jpg (0.7662) |
| a bowl of noodle soup | img-ramen.jpg (0.7161) | bread-es.wav (0.6059) |
| a weather forecast with rain and wind | weather-en.wav (0.7847) | bread-es.wav (0.5824) |
| a goal in a football match | football-en.wav (0.7322) | img-poster.jpg (0.5849) |
| how to knead bread dough | bread-es.wav (0.6336) | video-fox.mp4 (0.5546) |
| a city street at night in the rain | img-city.jpg (0.7260) | video-city.mp4 (0.7183) |
Identische Werte in zwei Läufen (05:28 und 05:50 UTC). Reine Textprüfung über das typisierte embed() des SDK: Die Aurora-Anfrage erreichte 0.8229 gegen die richtige Passage und 0.5754 / 0.5147 / 0.4981 gegen die anderen. Die volle 6 x 12-Matrix der Heatmap wurde danach mit demselben Backend auf der CPU in float32 neu berechnet: dieselben sechs Gewinner, Werte innerhalb von 0.003 zum GPU-Lauf.
Probleme, genau. (1) Der Treiber 570 des Pods ist zu alt für das CUDA-13-torch von PyPI (braucht 580+), deshalb fügt requirements.txt den Extra-Index cu126 von PyTorch hinzu. SDK error [server_up]: bootstrap step failed, Worker WARN worker::bootstrap: custom backend: uv pip install -r requirements.txt failed ohne Ausgabe von uv. Von Hand: No solution found ... only requests==2.28.1 is available and you require requests>=2.31 ... uv will only consider versions that are published on the first index that contains a given package. Der Extra-Index cu126 hostet auch alte requests, pillow und numpy. Fix: keine Versionsuntergrenzen. Lücke: Der Worker zeigt das stderr von uv nicht. (2) Profiler: 72 ms CUDA pro Bild gegen 0.33 bis 0.44 s CPU-Vorverarbeitung mit 64 Threads bei einer Quota von 6.8 CPUs. _cpu_quota() begrenzt die torch-Threads (Override EG2_TORCH_THREADS): ein Bild 0.50 -> 0.10 s, 8 Bilder 4.7 -> 0.86 s im Profiler. Nur in diesem einen RunPod-Container getestet; es liest die cgroup-Quota, Container ohne Quota brauchen also EG2_TORCH_THREADS. (3) 11.6 GB nach einem langen Batch festgehalten, behoben mit empty_cache() oberhalb von 16,384 Tokens. (4) wait_until_ready() nach ensure() auf einem Workload, der schon auslieferte, blieb bei „worker assigned; checking readiness“ stehen (einmal über 10 min, 90 s in einer Reproduktion): Der Worker loggt custom backend: driven by ProjectConfigSnapshot; skipping legacy LoadModel, und die Bereitschaftsprüfung liest worker_leases, das 0 Zeilen hatte. Der lokale Manager lief mit POLICY_EXECUTOR_ENABLED=false, das ist also eine lokale Beobachtung, kein bestätigter Bug in Produktion. (5) Der Embeddings-Tester des Panels nimmt nur Text. Außerdem: eine Warnung des Hugging Face Hub wegen fehlender Authentifizierung (kein HF_TOKEN), und 3 von 4 GPU-Optionen antworteten mit 409.
Grenzen.
- Ein GPU-Modell, eine Maschine, auf der GPU nur bfloat16. Kein Lauf in float16, kein Lauf in float32 auf der GPU, keine GPU ohne natives bfloat16.
- Das Retrieval-Set sind 12 synthetische Dateien von uns. Es zeigt den Mechanismus, nicht die Qualität gegenüber anderen Modellen.
- Die Zeiten gelten pro Anfrage aus einem Benchmark-Skript. Viele gleichzeitige Aufrufer haben wir nicht per Lasttest geprüft.
- Die Roundtrips enthalten einen Tunnel von unserer Entwicklungsmaschine nach Island und sind nicht repräsentativ für ein Deployment am selben Ort.
- Wir haben nur vLLM 0.31.0 geprüft. Spätere vLLM-Builds haben wir nicht geprüft, ebenso wenig, ob SGLang, Ollama oder llama.cpp (GGUF) die Wege für Bild, Video und Audio dieses Modells ausliefern.
- Das Hängen von
wait_until_ready()haben wir nur auf einem lokalen Stack mit abgeschaltetem Policy Executor gesehen.
Quellen: Model Card, Launch-Post von Google, Doku von Google AI for Developers, SDK-Beispiel.