Kandinsky 6.0: offenes Video mit Ton, bezahlt in Minuten pro Clip
Kandinsky 6.0 erzeugt 5-Sekunden-Clips mit synchronem Ton unter MIT. Minuten pro Clip auf sieben GPUs, und warum jeder Lauf Offload nutzt.
Am 6. Oktober hat Kandinsky Lab Kandinsky 6.0 als Open Source veröffentlicht: zwei Modelle, die aus einem Satz (oder einem Satz plus einem Bild) einen 5-Sekunden-Videoclip mit eigenem Soundtrack machen. Der Ton entsteht zusammen mit dem Bild, in 44 kHz (ungefähr die Qualität einer Musik-CD), und laut den Projektnotizen ist Lip-Sync dabei: Eine Figur, die spricht, bewegt den Mund passend zu den Worten. Es gibt ein kleines Modell, Lite, und ein großes, Pro, etwa zehnmal so groß (3B gegenüber 29B Parametern, die Zahlen, an denen man die Größe eines Modells misst). Ein separates Add-on vergrößert das Ergebnis auf Full HD.
Code und Gewichte stehen unter der MIT-Lizenz, die erlaubt, auf dem Modell aufzubauen, zu verkaufen, was du damit machst, und es weiterzuverbreiten. Ein Haken: Der Download des vollständigen (nicht destillierten) Pro liegt hinter einer Hugging-Face-Zugangssperre, die automatisch freigibt, und deren Bedingungen konnten wir ohne Login nicht lesen. Wir haben uns nicht jedes andere offene Videomodell angesehen, also behaupten wir nicht, dass es das erste oder einzige ist, das Bild und Ton zusammen unter so lockeren Bedingungen erzeugt. Das Release ist weniger als eine Woche alt, und die Gewichte sind einen Download entfernt.
Unsere Ausgangsfrage war, was ein Clip an GPU-Zeit kostet. Das Repo beantwortet sie mit einer Tabelle in Sekunden pro 5-Sekunden-Clip auf sieben GPUs. H100 und A100 sind Rechenzentrumskarten, die RTX PRO 6000 ist eine professionelle Workstation-Karte; RTX 5090, 5080, 4090 und 5060 Ti sind Gaming-Karten, die man für einen Desktop-PC kaufen kann.
Die Tabelle führt drei Einstellungen, SD, HD und Full HD. Das Repo sagt nicht, was sie bedeuten (bei Pro ist HD auf fast allen Karten sogar schneller als SD), deshalb zitieren wir nur die Zahlen. Hier die mittlere, HD, auf allen sieben Karten:
| GPU (Speicher) | Lite: ein 5-s-Clip | Pro: ein 5-s-Clip | Pro-Clips pro Stunde |
|---|---|---|---|
| H100 (80 GB) | 203 s, etwa 3.4 min | 292 s, etwa 4.9 min | etwa 12 |
| RTX PRO 6000 (96 GB) | 274 s | 561 s, etwa 9.4 min | etwa 6.4 |
| RTX 5090 (32 GB) | 296 s | 638 s, etwa 10.6 min | etwa 5.6 |
| A100 (80 GB) | 472 s | 791 s, etwa 13 min | etwa 4.6 |
| RTX 5080 (16 GB) | 579 s | 1,189 s, etwa 20 min | etwa 3 |
| RTX 4090 (24 GB) | 422 s | 1,194 s, etwa 20 min | etwa 3 |
| RTX 5060 Ti (16 GB) | 1,328 s, etwa 22 min | 2,716 s, etwa 45 min | etwa 1.3 |
Zahlen von Kandinsky Lab für die Standardmodelle (nicht die schnelleren „destillierten“ Versionen, die weiter unten erklärt werden), nach einem Aufwärmlauf, ohne das Laden des Modells und das Schreiben der Videodatei. Ob die Zeit zum Lesen des Prompts enthalten ist, sagt das Repo nicht.
Wir haben es selbst noch nicht laufen lassen, und wir haben die Clips weder angesehen noch bewertet. Jede Zahl in diesem Beitrag stammt aus den Repos und Model Cards von Kandinsky Lab oder aus einfacher Rechnung damit, und wir verlinken jede Quelle.
Bestenfalls eine Minute GPU pro Sekunde Video
Fangen wir mit dem besten Fall an. Auf einer H100, der schnellsten Karte in der Tabelle, erzeugt Pro einen HD-Clip in 292 Sekunden. Das ist fast eine Minute GPU-Arbeit für jede Sekunde fertiges Video.
Stell dir jetzt einen kurzen Werbespot vor, 30 Sekunden lang, aus sechs einzelnen Clips. Auf der H100 sind das etwa 29 Minuten Generierung. Auf einer RTX 4090, einer Gaming-Karte der Oberklasse, brauchen dieselben sechs Clips etwa zwei Stunden. Auf der RTX 5060 Ti mit 16 GB dauert ein einziger Pro-Clip in HD etwa 45 Minuten (2,716 s) und in Full HD etwa eine Stunde (3,530 s).
Lite ist bei der GPU-Zeit die günstigere Option. Auf der RTX 5090 macht es einen Clip in etwa 5 Minuten, auf der 4090 in etwa 7. Pro kostet mehr, und der Abstand wächst auf den Gaming-Karten. Auf einer H100 kommen pro Clip etwa anderthalb Minuten gegenüber Lite dazu (292 s gegenüber 203 s). Auf einer 4090 dauert es fast dreimal so lange: etwa 20 Minuten gegenüber 7.
Was dir diese zusätzliche Zeit bringt, können wir dir nicht sagen. Die Repos und Model Cards, die wir gelesen haben, sagen nicht, worin sich die Clips von Pro von denen von Lite unterscheiden, und wir haben sie nicht verglichen. Die Qualitätsaussagen von Kandinsky Lab stehen im technischen Bericht, den dieser Beitrag nicht bewertet. Bevor du also das 1.4- bis 2.8-Fache an GPU-Zeit für Pro bezahlst, mach dieselben paar Clips mit beiden und schau sie dir an.
So oder so ist nichts davon ein interaktives Werkzeug. Du stellst die Arbeit in eine Warteschlange und kommst später wieder. Die Anleitung im Repo für den Betrieb als gemeinsamer Dienst sieht das genauso: Du schickst eine Anfrage für ein Video, bekommst eine Ticketnummer zurück, fragst nach, bis es fertig ist, und lädst dann die Datei herunter.
Warum jeder veröffentlichte Lauf Offload nutzt
Schau dir die Tabelle noch einmal an: Die RTX PRO 6000 mit 96 GB braucht 561 Sekunden für einen Pro-Clip in HD, die H100 mit 80 GB braucht 292. Die Karte mit mehr Speicher braucht fast doppelt so lange. Um das zu lesen, muss man wissen, wie das Modell auf die Karte kommt.
Eine GPU hat ihren eigenen schnellen Speicher, und normalerweise wird ein Modell komplett hineingeladen, bevor es zu arbeiten anfängt. Kandinsky 6.0 Pro passt schlecht in dieses Bild. Seine Dateien summieren sich auf etwa 90 GB, und allein der Teil, der zeichnet, hat etwa 70 GB. Eine H100 hat 80 GB.
Deshalb nutzt das Repo Offload: Das ganze Modell bleibt im normalen Arbeitsspeicher des Rechners (RAM), und Teile werden zur GPU gebracht, wenn sie gebraucht werden. Der Rechner selbst braucht also genug RAM für alles, was nicht auf der Karte liegt; ein Minimum veröffentlicht das Repo nicht.
Das Repo liefert zwei Varianten davon. Auf den drei Karten mit viel Speicher (H100, A100, RTX PRO 6000) bringt es jeweils einen ganzen Abschnitt des Modells: den Teil, der deinen Prompt liest, dann den Teil, der zeichnet, dann die Teile, die das Ergebnis in Frames und Ton verwandeln. Auf den Gaming-Karten bringt es den zeichnenden Teil in kleinen Stücken, zwei auf der GPU, während das nächste schon unterwegs ist.
Jede GPU-Einstellung, die das Repo mitliefert, nutzt eine der beiden Varianten, auch die für die 96-GB-Karte. Keine schaltet Offload ab, und die Anleitung im Repo für den Betrieb von Pro als gemeinsamer Dienst sagt, Offload sei auf einer GPU mit 80 GB „erforderlich“ („is required“). Die RTX PRO 6000 nutzt ihren zusätzlichen Speicher also nicht, um das ganze Modell auf der Karte zu halten.
Die H100 ist am schnellsten; warum genau, kann die Tabelle nicht sagen
Die kurze Antwort: Die H100 ist die schnellste Karte in der Tabelle, und die Tabelle verrät nicht, wie viel davon am Chip und wie viel am Speicher liegt. Kauf also keine Karte mit mehr Speicher wegen dieser Tabelle: Die Karte mit 96 GB verliert gegen die H100 mit 80 GB (561 s gegenüber 292 s), und kein Lauf in der Tabelle hält je das ganze Modell auf der Karte.
Unsere beste Lesart ist, dass der Chip der H100 einfach schneller ist und der zusätzliche Speicher der 96-GB-Karte das nicht ausgleicht. Das ist eine Schlussfolgerung, keine Messung. Jeder Lauf in der Tabelle nutzt Offload, also zeigt nichts das Modell komplett auf der GPU, und nichts misst, wie viel Zeit das Hin- und Hertragen kostet.
Die Karten unterscheiden sich außerdem in mehr als nur dem Speicher. Es sind verschiedene Chips, und das Repo bringt das Modell auf den großen Karten anders auf die GPU als auf den Gaming-Karten. Die H100 nutzt außerdem in jedem Durchgang des Zeichnens eine andere Attention-Software als die übrigen Karten (FlashAttention 3 statt SageAttention), der Vergleich läuft also nicht unter gleichen Bedingungen.
Manche Paare zeigen in die andere Richtung, dahin, dass Speicher doch eine Rolle spielt: Die RTX PRO 6000 mit 96 GB schlägt die RTX 5090 mit 32 GB (561 s gegenüber 638 s), und die A100 mit 80 GB schlägt die RTX 4090 mit 24 GB (791 s gegenüber 1,194 s). Auch diese Paare unterscheiden sich im Chip und in der Art, wie das Modell auf die GPU kommt, sie entscheiden die Frage also in keine Richtung.
Was die destillierten Modelle ändern
Der eigene Standard des Repos ist ein Modell, das es nicht gemessen hat. Jede fertige GPU-Einstellung und die öffentliche Online-Demo starten mit einem destillierten Pro: einer Version, die darauf trainiert ist, einen Clip in 10 Aufräumdurchgängen statt 50 fertigzustellen. Die Zeittabelle deckt nur die Standardmodelle mit 50 Durchgängen ab.
Die Idee hinter den Durchgängen: Diese Modelle starten mit Rauschen und räumen es Schritt für Schritt auf. Auch Lite hat eine destillierte Version. Fünfmal weniger Durchgänge klingt nach fünfmal schneller, aber das würden wir nicht versprechen, denn das Repo veröffentlicht überhaupt keine Zeiten für die destillierten Modelle. Das destillierte Pro ist auf der Platte auch etwas kleiner, insgesamt etwa 81 GB statt 90.
Das Full-HD-Add-on
Den Clip scharf zu machen ist billig im Vergleich dazu, ihn zu erzeugen. Das Super-Resolution-Add-on ist ein eigenes Modell, das das Video vergrößert und seine Details neu zeichnet. Auf einer H100 verdoppelt seine schnellere Version (die, die Kandinsky Lab gemessen hat) die Größe eines 5-Sekunden-Clips in 41 Sekunden und vervierfacht sie in 118, gegenüber etwa 3 bis 7 Minuten, um einen Clip auf derselben Karte zu erzeugen (203 bis 402 Sekunden, je nach Modell und Einstellung). (Der gemessene Clip war etwas kleiner als das, was die Basismodelle liefern, nimm das also als grobe Orientierung.)
Die Basismodelle liefern 864 mal 480 Pixel; das Add-on bringt das auf Full HD. Es streckt die Pixel nicht einfach: Es zeichnet die Details in jedem kleinen Ausschnitt des Bildes neu.
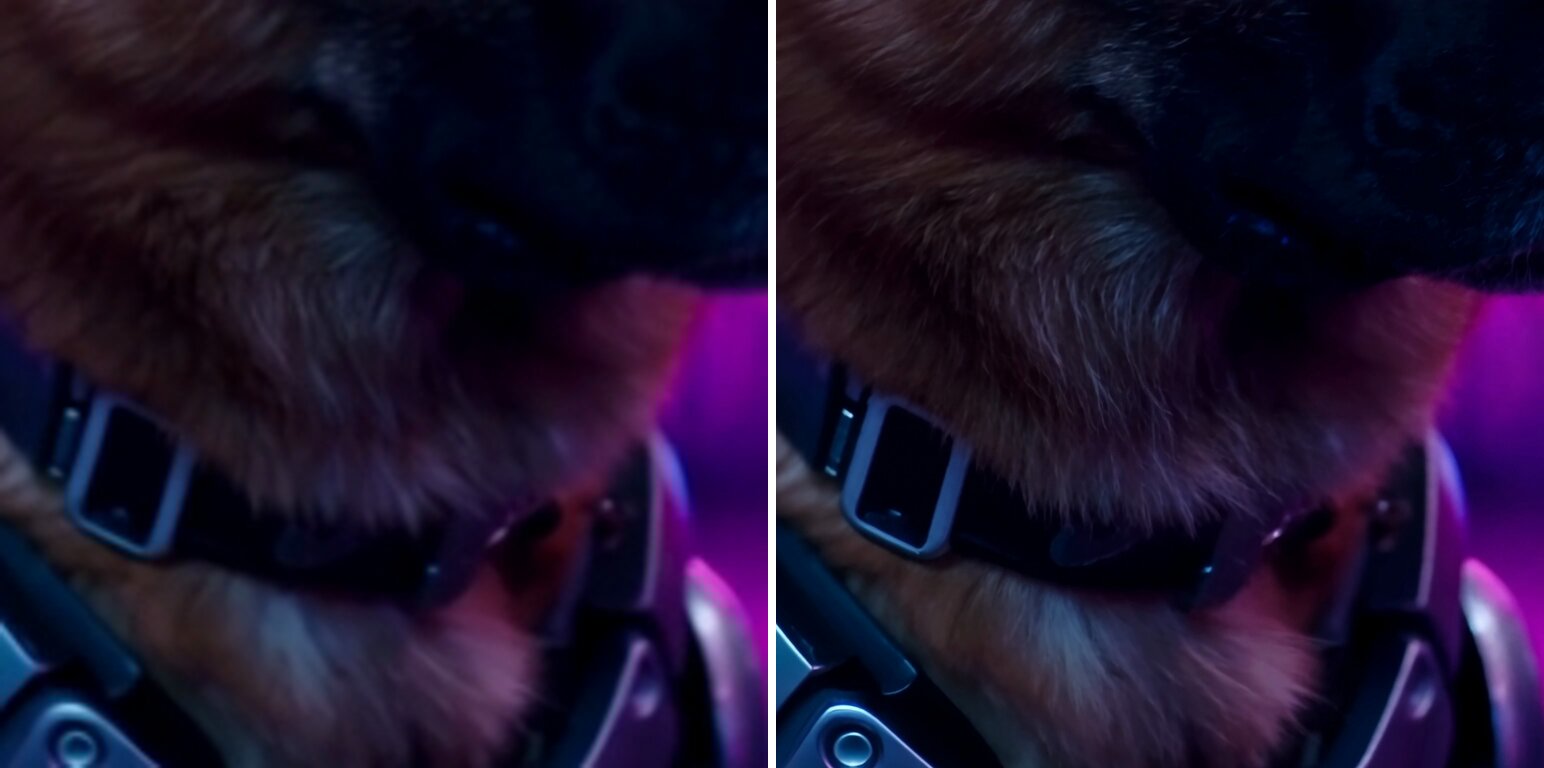
Links: gewöhnliche 4x-Vergrößerung. Rechts: 4x mit dem 2-Schritt-Super-Resolution-Modell. Ausschnitte aus dem Repo kandinsky-6-sr, auf Clips, die Kandinsky 6.0 erzeugt hat.
Für Gaming-Karten oder die langsamere Version gibt es keine veröffentlichten Zeiten. Ein praktisches Detail: Das Add-on arbeitet nur am Bild. Den Ton musst du aus der ursprünglichen Generierung wieder auf das vergrößerte Video legen.
Wer was gemacht hat
Das alles ist die Arbeit von Kandinsky Lab: die zwei Videomodelle, das Super-Resolution-Modell, die GPU-Einstellungen und die Zeittabelle, mit einem technischen Bericht dahinter. Ihre Modelle bauen außerdem auf offener Arbeit anderer Teams auf: Ein Sprachmodell vom Qwen-Team von Alibaba liest den Prompt, eine Komponente im Stil von HunyuanVideo von Tencent verwandelt das Ergebnis in Frames, und Teile aus den Projekten MMAudio und BigVGAN machen daraus Ton.
Am Tag des Releases liefen die Modelle schon in fünf offenen Werkzeugen, vom Point-and-Click-Tool ComfyUI bis zu Software, die ein Modell als gemeinsamen Dienst betreibt, wie vLLM-Omni und SGLang. Zwei Tage später hat der Community-Account realrebelai komprimierte Versionen von Pro veröffentlicht, zwischen etwa 17 und 24 GB, gedacht für kleinere Karten in ComfyUI. Die eigene Seite bezeichnet sie als experimentell und nicht vollständig getestet und warnt, dass Pro „is still a very large model even after quantization“ (auch nach der Quantisierung, der angewandten Kompression, ein sehr großes Modell bleibt).
Unser Anteil an diesem Beitrag ist kleiner: die Repos lesen, Dateigrößen und Configs prüfen und rechnen.
Was du mitnehmen kannst, und was noch offen ist
Wenn du kurze Clips mit Ton auf eigener Hardware erzeugen willst, unter einer Lizenz, die dir erlaubt, auf dem Modell aufzubauen und es weiterzuverbreiten, ist Kandinsky 6.0 einen Test wert. Wir haben Zeiten, Dateien und Configs gelesen. Wir haben die Clips nicht angesehen und ihre Qualität nicht bewertet, diesen Teil musst du also selbst prüfen. Lite lässt sich herunterladen, ohne etwas zu unterschreiben, und hat etwa 28 GB, das meiste davon das Modell, das den Prompt liest. Bei Pro musst du vorher auf Hugging Face die Bedingungen akzeptieren, die Freigabe kommt automatisch; diese Bedingungen konnten wir ohne Login nicht lesen.
Plane es wie eine Render-Farm, nicht wie einen Chatbot. Wähle die Karte danach, wie viele Clips pro Stunde du brauchst: etwa 12 Pro-Clips pro Stunde auf einer H100, etwa 3 auf einer RTX 4090. Das sind die Standardmodelle auf einer aufgewärmten Maschine, ohne Laden und Dateischreiben, deine echte Rate wird also niedriger sein, um einen Betrag, den das Repo nicht veröffentlicht, und der destillierte Standard kann sie verändern.
Die ehrliche Lücke sind die destillierten Modelle: Auf sie stellt das Repo standardmäßig ein, und Kandinsky Lab hat nicht veröffentlicht, wie lange sie brauchen. Um es herauszufinden, brauchst du eine RTX 5090, den Einrichtungsschritt des Repos (just setup) und einen Download von 81 GB (just download pro-distill). Danach:
cp kandinsky/configs/devices/rtx-5090.yaml my-5090.yaml
printf 'profile:\n  mode: time_mem_module\n' >> my-5090.yaml
just generate "a cat on a mat" --config my-5090.yaml --warmup --out clip.mp4
Der Befehl erzeugt den Clip einmal zum Aufwärmen und misst dann einen zweiten Lauf, ähnlich wie die Tabelle gemessen wurde. Worin sich diese Messung von der der Tabelle unterscheidet, steht weiter unten im Abschnitt für Engineers.
Für Engineers
Modelle und Dateien (Größen aus der Hugging-Face-API, abgefragt am 2026-10-12, alle Model Cards deklarieren license: mit):
| Repo | Gesamt | Transformer | Hinweise |
|---|---|---|---|
| Kandinsky-6.0-Pro-5s-Diffusers | 90.04 GB | 69.7 GB | gated, automatische Freigabe |
| Kandinsky-6.0-Pro-distill-5s-Diffusers | 80.65 GB | 60.3 GB | ~30.14B Parameter laut safetensors-Header (30.107B BF16 + 0.033B F32) |
| Kandinsky-6.0-Pro-pretrain-5s-Diffusers | 90.04 GB | 69.7 GB | |
| Kandinsky-6.0-Lite-5s-Diffusers | 27.78 GB | 7.48 GB | ~3.18B Parameter (2.615B BF16 + 0.561B F32), nicht gated |
| Kandinsky-6.0-Lite-distill-5s-Diffusers | 26.68 GB | 6.38 GB | nicht gated |
| Kandinsky-6.0-VSR-5s-Diffusers | 17.46 GB | 4 Schritte pro Tile | |
| Kandinsky-6.0-VSR-distilled2steps-5s-Diffusers | 17.46 GB | π-Flow-destilliert, 2 Auswertungen pro Tile |
Gemeinsame Pro-Komponenten: Qwen2.5-VL-Text-Encoder ~16.58 GB (5 Shards, auch für die Prompt-Erweiterung genutzt), Audio-VAE 1.71 GB, Video-VAE 0.99 GB, CLIP 0.49 GB, Vocoder 0.49 GB. Warum der Transformer von Pro 69.7 GB hat, der von Pro-distill aber 60.3 GB bei nominell ähnlicher Parameterzahl, erklären die Quellen nicht (der Header des gated Pro ließ sich nicht lesen).
Lizenzen. Code von kandinsky-6: MIT. kandinsky-6-sr: MIT, wobei die Diffusers-Export-Templates ihre Apache-2.0-Hinweise behalten (LICENSE-APACHE). Gewichte: MIT auf jeder Model Card. Pro (nicht destilliert) liegt hinter einem automatisch freigegebenen Hugging-Face-Gate.
Architektur. Lite: model_dim 1792, 32 visuelle Blöcke, 2 Textblöcke, ff_dim 7168. Pro: model_dim 4096, 60 visuelle Blöcke, 4 Textblöcke, ff_dim 16384. Pipeline Kandinsky6TI2VAPipeline: Kandinsky6Transformer3DModel, AutoencoderKLHunyuanVideo, Qwen2_5_VLForConditionalGeneration, CLIPTextModel (pooled), MMAudioVAE, MMAudioVocoder (im Stil von BigVGAN), FlowMatchEulerDiscreteScheduler (shift 5.0). Upstream-Credits: Qwen2.5-VL (Qwen-Team von Alibaba), CLIP (OpenAI), VAE-Design von HunyuanVideo (Tencent), MMAudio, BigVGAN (NVIDIA), die Destillationsmethode π-Flow hinter den destillierten Checkpoints, FlashAttention 3 (Tri Dao und Co-Autoren) und SageAttention (die Gruppe thu-ml der Tsinghua-Universität).
Generierungseinstellungen (kandinsky/configs/checkpoints/*.yaml): pro, lite und pretrain: 864x480, 121 Frames, 50 Schritte, Guidance 5.0. pro-distill und lite-distill: 10 Schritte, Guidance 1.0, PiflowScheduler (n_grid 10, 128 Policy-Substeps). Audio-VAE-Skalierung 0.5302 (pro/lite) oder 0.417 (distill, pretrain). Der vLLM-Omni-Abschnitt sagt, Pro nutze standardmäßig 125 Frames bei 24 fps, die nativen Configs und das Diffusers-Beispiel nutzen 121.
Vollständige Zeittabelle (README, Performance). Sekunden pro 5-s-Clip, nicht destilliert, nach Warmup, ohne Laden der Gewichte und MP4-Encoding. Modul-Offload auf RTX PRO 6000, A100, H100. Block-Offload auf den Consumer-Karten. SageAttention2++ für die visuelle Self-Attention überall außer auf der H100 (FlashAttention 3).
| RTX 4090 | RTX 5060 Ti | RTX 5080 | RTX 5090 | RTX PRO 6000 | A100 80 GB | H100 | |
|---|---|---|---|---|---|---|---|
| Lite SD | 437 | 1310 | 577 | 309 | 242 | 532 | 239 |
| Lite HD | 422 | 1328 | 579 | 296 | 274 | 472 | 203 |
| Lite Full HD | 578 | 1774 | 770 | 406 | 387 | 664 | 284 |
| Pro SD | 936 | 3080 | 1336 | 754 | 621 | 972 | 356 |
| Pro HD | 1194 | 2716 | 1189 | 638 | 561 | 791 | 292 |
| Pro Full HD | 1247 | 3530 | 1546 | 854 | 765 | 1106 | 402 |
Merkwürdigkeiten, die man kennen sollte: Pro HD ist auf der 4090 (1194 s) langsamer als auf der 5080 (1189 s). Bei Pro ist SD auf jeder Karte außer der 4090 langsamer als HD (H100: 356 gegenüber 292), und Lite HD schlägt Lite SD auf 4090, 5090, A100 und H100. Die README definiert nicht, wie die Zeilen SD, HD und Full HD zustande kommen, also interpretiere ich sie nicht. Die Tabelle variiert Chip, Attention-Kernel und Offload-Modus gleichzeitig und hat keine Baseline ohne Offload, sie kann die Kosten des Offloads also nicht von der Rechengeschwindigkeit trennen.
Offload im Code (kandinsky/runtime/offload/). module: Registrierte Module bleiben auf der CPU, jeweils eine residente Gruppe auf CUDA, asynchrones H2D/D2H. block: pro DiT-Block (Pro hat 60 visuelle Blöcke, ob die 4 Textblöcke genauso bereitgestellt werden, steht nicht da), zwei resident, der nächste wird auf einem Transfer-Stream vorgeladen, erfordert Pinned Memory, lehnt quantisierte Parameter-Subklassen und AOTI dit_export ab. OffloadConfig steht standardmäßig auf none und die CLI akzeptiert --offload none|module|block, aber jedes mitgelieferte Preset setzt module (rtx-pro-6000, a100-80gb, h100) oder block (rtx-4090, rtx-5090, rtx-5080, rtx-5060-ti). Die Presets für 5060 Ti und 5080 laden außerdem den Qwen-Text-Encoder in NF4 über bitsandbytes. Der VRAM-Spitzenwert pro GPU ist nicht veröffentlicht.
Ausführen. Nativ: Python 3.13 oder 3.14, NVIDIA-GPU, just setup (PyTorch für CUDA 13.0, FlashAttention 3 auf Hopper, SageAttention 2.2.0 mit nvcc kompiliert auf Ampere, Ada und Consumer-Blackwell, nvcc muss also im PATH sein, CUDA_HOME mit Standard /usr/local/cuda), just download pro-distill (etwa 81 GB nach $KANDINSKY_HOME/weights, Standard ~/.cache/kandinsky), just generate "..." [--config ...] [--out ...]. Die Standard-Config ist h100.yaml. --warmup läuft einmal ohne zu speichern, dann noch einmal und speichert; dieser zweite Lauf ist der, der bei eingeschaltetem Profiling profiliert wird. Profiling ist standardmäßig aus (ProfileConfig.mode = "none", kein mitgeliefertes Preset setzt es): Füge profile: {mode: time_mem_module} in eine Kopie des Presets ein, wie im Snippet oben. Das JSON landet mit --out in $KANDINSKY_HOME/profile/time_mem_module/, ohne in <run>/profiles/. Das Profil umschließt den gesamten Pipeline-Aufruf, der bei angegebenem Ziel auch das MP4 schreibt und den Ton muxt, und enthält die standardmäßige qwen25-Prompt-Erweiterung. Seine total_time zählt also Encoding mit, das die README-Tabelle ausschließt: Vergleiche die Zeiten pro Modul (DiT, VAE, Audio-VAE, Vocoder), um näher heranzukommen. Weitere Flags: --sr, --no-audio, --image, --steps, --guidance, --magcache/--navicache.
vLLM-Omni braucht vLLM 0.31.0 plus vLLM-Omni aus dem Quellcode gebaut, auf Python 3.12, in einer separaten Umgebung. Das Beispiel unten zieht das gated Pro-Repo, also akzeptiere vorher die Bedingungen auf Hugging Face und authentifiziere dich mit einem HF-Token:
vllm serve kandinskylab/Kandinsky-6.0-Pro-5s-Diffusers --omni \
  --host 127.0.0.1 --port 8091 --num-gpus 1 --enable-cpu-offload
# POST /v1/videos (prompt, size=864x480, num_frames=125, num_inference_steps=50, seed)
# GET /v1/videos/$VID until done, then GET /v1/videos/$VID/content
Diffusers: Kandinsky6TI2VAPipeline.from_pretrained(..., torch_dtype=torch.bfloat16) plus pipe.enable_model_cpu_offload(). sample_audio=False liefert nur Video, expand_prompts=True lässt Qwen2.5-VL den Prompt umschreiben (kostet Latenz). In der README aufgeführte Integrationen zum Release: Diffusers, ComfyUI, vLLM-Omni, SGLang und FastVideo.
Super-Resolution (kandinsky-6-sr). Kandinsky6SRPipeline, x2, x2.25 (Standard: x1.125 bilinear, dann der x2-Pfad) oder x4, gekachelte Diffusion im latenten Raum des K-VAE mit Hann-Fenster-Blending, Overlap 0.20, tiles_batch_size standardmäßig 1. Eine Quelle mit 480x864 ergibt bei x2.25 1088x1952. Um das zu skalieren, setze target_resolution (Stufen hd, fullhd, 2k; jede Stufe enthält eine Größe im Querformat 16:9, eine quadratische und eine im Hochformat 9:16, und es wird die mit dem nächstliegenden Seitenverhältnis gewählt, z. B. fullhd quer 1080x1920). Die Skalierung beschneidet nie. Mit dem Standard target_resize_mode: fit werden beide Seiten mit einem Faktor skaliert, min(1080/1088, 1920/1952), fullhd ergibt also 1070x1920 (1920 breit, 1070 hoch). Für exakt 1080x1920 braucht es zusätzlich target_resize_mode: exact, was eine leichte anisotrope Stauchung zulässt. Komponenten: SR-DiT 1.41B, SR-VAE 1.74B, Latent-Upscaler-Bank 3.65B. Benötigt torch._inductor.config.max_autotune = True und das Flex-Attention-Backend. Vertrag: 24 fps, höchstens 121 Frames. Nur Frames, den Ton muxt du selbst zurück. H100-Zeiten, 2-Schritt-Modell, Eingabe 768x512, torch 2.10.0+cu128, ohne Warmup und IO: x2 (9 Tiles) 41 s, x4 (25 Tiles) 118 s.
Community-Quants (realrebelai/Kandinsky-6.0-Pro-5s_GGUFs, MIT, erstellt am 2026-10-08, „Experimental / Not Fully Tested“): Pro Q3_K_S 20.35 GB, Pro Q4_K_S 23.73 GB, Pro W4A8 17.13 GB, Pro-distill W4A8 17.13 GB, Qwen2.5-VL-7B-W4A8-Encoder 5.58 GB. GGUF braucht zwei ComfyUI-Forks von RebelAI, W4A8 nutzt die offiziellen Nodes. Die Card empfiehlt für erste Tests 240x240 und 21 Frames und warnt, dass ein Lauf die Diffusion abschließen und dann beim Audio-Decoding scheitern kann, wenn die 44-kHz-Dateien von MMAudio und BigVGAN fehlen.
Grenzen.
- Wir haben Kandinsky 6.0 nicht laufen lassen und seine Ausgabe weder angesehen noch bewertet. Jede Zeitangabe stammt von Kandinsky Lab, in deren Setup.
- Die Tabelle gilt für die nicht destillierten Modelle, während jedes Preset standardmäßig
pro-distillnutzt. Die genaue Config hinter der Tabelle (Checkpoint-Override, Schritte, Frames) ist nicht veröffentlicht. - Ob die Tabelle Prompt-Erweiterung und Text-Encoding einschließt oder nur Denoising und Decoding, steht nicht da.
- Es gibt keine Zeiten für die destillierten Checkpoints, für das 4-Schritt-VSR oder für VSR auf Consumer-Karten.
- Jeder veröffentlichte Lauf nutzt Offload, also sind weder die Kosten des Offloads noch die Geschwindigkeit ohne ihn gemessen. Jede Aussage über Speicher gegenüber Rechenleistung auf Basis dieser Tabelle ist eine Schlussfolgerung.
- „Offload is required on 80 GB“ steht für vLLM-Omni. Für die native Pipeline nutzen die Presets Offload auf jeder Karte, aber das Repo sagt nicht, dass ein Lauf ohne unmöglich ist.
- Qualitätsaussagen (Genauigkeit des Lip-Sync, Benchmark-Werte) stehen im technischen Bericht, den dieser Beitrag nicht bewertet.
Quellen: kandinsky-6, kandinsky-6-sr, Model Cards von Pro, Lite und VSR, Community-GGUFs.