Kandinsky 6.0: vídeo abierto con sonido, a minutos por clip
Kandinsky 6.0 genera clips de 5 segundos con audio sincronizado bajo MIT. Minutos por clip en siete GPUs, y por qué todas las pruebas usan offload.
El 6 de octubre, Kandinsky Lab liberó Kandinsky 6.0: dos modelos que convierten una frase (o una frase más una imagen) en un clip de vídeo de 5 segundos con su propia banda sonora. El sonido se genera a la vez que la imagen, a 44 kHz (más o menos la calidad de un CD de música), y las notas del proyecto dicen que incluye sincronización labial: un personaje que habla mueve la boca al ritmo de las palabras. Hay un modelo pequeño, Lite, y uno grande, Pro, unas diez veces mayor (3B frente a 29B parámetros, la cifra que mide el tamaño de un modelo). Un complemento aparte amplía el resultado a Full HD.
El código y los pesos están bajo licencia MIT, que permite construir sobre el modelo, vender lo que hagas con él y redistribuirlo. Un matiz: la descarga del Pro completo (no destilado) está detrás de un acceso restringido de Hugging Face que te aprueba automáticamente, y no hemos podido leer sus condiciones sin iniciar sesión. No hemos repasado todos los demás modelos de vídeo abiertos, así que no vamos a decir que sea el primero ni el único que genera imagen y sonido juntos con una licencia tan permisiva. El lanzamiento tiene menos de una semana y los pesos están a una descarga de distancia.
La pregunta de la que partimos fue cuánto tiempo de GPU cuesta un clip. El repo la responde con una tabla de segundos por clip de 5 segundos en siete GPUs. La H100 y la A100 son tarjetas de centro de datos, y la RTX PRO 6000 es una tarjeta profesional de estación de trabajo; las RTX 5090, 5080, 4090 y 5060 Ti son tarjetas gaming que puedes comprar para un ordenador de sobremesa.
La tabla da tres ajustes, SD, HD y Full HD. El repo no explica qué significan (en Pro, HD es incluso más rápido que SD en casi todas las tarjetas), así que solo citamos las cifras. Este es el del medio, HD, en las siete tarjetas:
| GPU (memoria) | Lite: un clip de 5 s | Pro: un clip de 5 s | Clips de Pro por hora |
|---|---|---|---|
| H100 (80 GB) | 203 s, unos 3,4 min | 292 s, unos 4,9 min | unos 12 |
| RTX PRO 6000 (96 GB) | 274 s | 561 s, unos 9,4 min | unos 6,4 |
| RTX 5090 (32 GB) | 296 s | 638 s, unos 10,6 min | unos 5,6 |
| A100 (80 GB) | 472 s | 791 s, unos 13 min | unos 4,6 |
| RTX 5080 (16 GB) | 579 s | 1189 s, unos 20 min | unos 3 |
| RTX 4090 (24 GB) | 422 s | 1194 s, unos 20 min | unos 3 |
| RTX 5060 Ti (16 GB) | 1328 s, unos 22 min | 2716 s, unos 45 min | unos 1,3 |
Cifras de Kandinsky Lab para los modelos estándar (no las versiones "destiladas", más rápidas, que se explican más abajo), tras una ejecución de calentamiento, sin contar la carga del modelo ni la escritura del fichero de vídeo. El repo no dice si incluyen el tiempo de leer el prompt.
Todavía no lo hemos ejecutado nosotros, y no hemos visto ni valorado los clips. Cada cifra de este post sale de los repos y las model cards de Kandinsky Lab, o de cuentas sencillas sobre ellas, y enlazamos cada fuente.
En el mejor caso, un minuto de GPU por segundo de vídeo
Empecemos por el mejor caso. En una H100, la tarjeta más rápida de la tabla, Pro genera un clip HD en 292 segundos. Eso es casi un minuto de trabajo de GPU por cada segundo de vídeo terminado.
Ahora imagina un anuncio corto, de 30 segundos, montado con seis clips distintos. En la H100 son unos 29 minutos de generación. En una RTX 4090, una tarjeta gaming de gama alta, los mismos seis clips tardan unas dos horas. En la RTX 5060 Ti de 16 GB, un clip de Pro tarda unos 45 minutos en HD (2716 s) y alrededor de una hora en Full HD (3530 s).
Lite es la opción barata en tiempo de GPU. En la RTX 5090 hace un clip en unos 5 minutos, y en la 4090 en unos 7. Pro cuesta más, y la diferencia crece en las tarjetas gaming. En una H100 añade alrededor de minuto y medio por clip respecto a Lite (292 s frente a 203 s). En una 4090 tarda casi el triple: unos 20 minutos frente a 7.
Lo que te compra ese tiempo extra no podemos decírtelo. Los repos y las model cards que hemos leído no dicen en qué se diferencian los clips de Pro de los de Lite, y nosotros no los hemos comparado. Las afirmaciones de calidad de Kandinsky Lab están en su informe técnico, que este post no evalúa. Así que, antes de pagar entre 1,4 y 2,8 veces más tiempo de GPU por Pro, genera los mismos pocos clips con los dos y míralos.
En cualquier caso, nada de esto es una herramienta interactiva. Encolas el trabajo y vuelves más tarde. Las instrucciones del repo para ejecutarlo como servicio compartido van en la misma línea: envías una petición de vídeo, recibes un número de ticket, vas preguntando hasta que esté listo y luego descargas el fichero.
Por qué todas las pruebas publicadas usan offload
Vuelve a mirar la tabla: la RTX PRO 6000 de 96 GB tarda 561 segundos en un clip HD de Pro, y la H100 de 80 GB tarda 292. La tarjeta con más memoria tarda casi el doble. Para leer eso hay que saber cómo llega el modelo a la tarjeta.
Una GPU tiene su propia memoria rápida, y normalmente el modelo se carga entero en ella antes de empezar a trabajar. Kandinsky 6.0 Pro no encaja bien en ese esquema. Sus ficheros suman unos 90 GB, y solo la parte que dibuja ocupa unos 70 GB. Una H100 tiene 80 GB.
Así que el repo usa offload: el modelo completo se queda en la memoria normal del ordenador (la RAM), y las piezas se llevan a la GPU cuando hacen falta. Eso significa que el propio ordenador necesita RAM suficiente para guardar lo que no está en la tarjeta; el repo no publica un mínimo.
El repo trae dos formas de hacerlo. En las tres tarjetas con mucha memoria (H100, A100, RTX PRO 6000) lleva una sección entera del modelo cada vez: la parte que lee tu prompt, luego la parte que dibuja, luego las partes que convierten el resultado en fotogramas y sonido. En las tarjetas gaming lleva la parte que dibuja en rodajas pequeñas, dos en la GPU mientras la siguiente ya va de camino.
Todos los ajustes de GPU que trae el repo usan una de las dos, incluida la tarjeta de 96 GB. Ninguno desactiva el offload, y las instrucciones del repo para ejecutar Pro como servicio compartido dicen que el offload "is required" (es obligatorio) en una GPU de 80 GB. Así que la RTX PRO 6000 no aprovecha su memoria extra para tener el modelo entero en la tarjeta.
La H100 es la más rápida; la tabla no puede decir exactamente por qué
La respuesta corta: la H100 es la tarjeta más rápida de la tabla, y la tabla no permite saber cuánto se debe al chip y cuánto a la memoria. Así que no te compres una tarjeta con más memoria por esta tabla: la de 96 GB pierde contra la H100 de 80 GB (561 s frente a 292 s), y en ninguna prueba de la tabla el modelo se queda entero en la tarjeta.
Nuestra mejor lectura es que el chip de la H100 sencillamente es más rápido, y la memoria extra de la tarjeta de 96 GB no lo compensa. Eso es una deducción, no una medida. Todas las pruebas de la tabla usan offload, así que nada muestra el modelo entero en la GPU, y nada mide cuánto tiempo cuesta el acarreo.
Además, las tarjetas no solo se diferencian en la memoria. Son chips distintos, y el repo carga el modelo de forma distinta en las tarjetas grandes y en las gaming. La H100 también usa un software de atención distinto al de las demás tarjetas (FlashAttention 3 en lugar de SageAttention) en cada pasada del dibujo, así que la comparación no se hace en igualdad de condiciones.
Algunas parejas apuntan en la dirección contraria, a que la memoria sí importa: la RTX PRO 6000 de 96 GB gana a la RTX 5090 de 32 GB (561 s frente a 638 s), y la A100 de 80 GB gana a la RTX 4090 de 24 GB (791 s frente a 1194 s). Esas parejas también se diferencian en el chip y en cómo se carga el modelo, así que tampoco zanjan la cuestión en ningún sentido.
Qué cambian los modelos destilados
El modelo por defecto del propio repo es uno que no ha cronometrado. Todos los ajustes de GPU listos para usar, y la demo pública online, parten de un Pro destilado: una versión entrenada para terminar un clip en 10 pasadas de limpieza en lugar de 50. La tabla de tiempos solo cubre los modelos estándar de 50 pasadas.
La idea detrás de las pasadas: estos modelos parten de ruido y lo van limpiando paso a paso. Lite también tiene versión destilada. Cinco veces menos pasadas suena a cinco veces más rápido, pero no lo prometeríamos, porque el repo no publica ningún tiempo de los modelos destilados. El Pro destilado también ocupa algo menos en disco, unos 81 GB en total en lugar de 90.
El complemento Full HD
Darle nitidez al clip sale barato comparado con generarlo. El complemento de superresolución es un modelo aparte que amplía el vídeo y vuelve a dibujar su detalle. En una H100, su versión rápida (la que cronometró Kandinsky Lab) duplica el tamaño de un clip de 5 segundos en 41 segundos y lo cuadruplica en 118, frente a los 3 a 7 minutos que cuesta generar un clip en la misma tarjeta (de 203 a 402 segundos, según el modelo y el ajuste). (El clip cronometrado era algo más pequeño que lo que producen los modelos base, así que tómalo como una referencia aproximada.)
Los modelos base producen 864 por 480 píxeles; el complemento lo lleva a Full HD. No se limita a estirar los píxeles: vuelve a dibujar el detalle de cada pequeño trozo del fotograma.
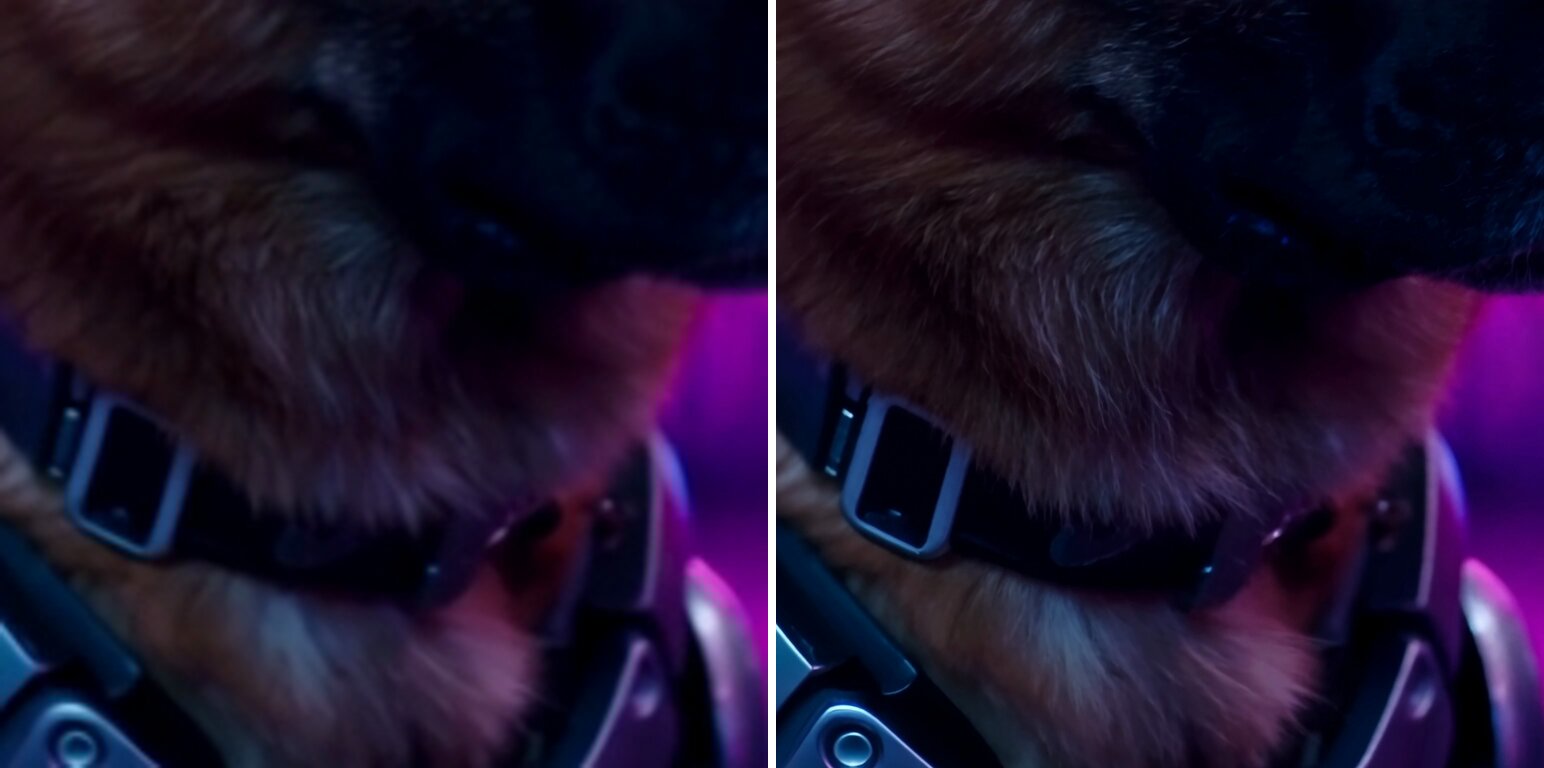
Izquierda: ampliación 4x habitual. Derecha: 4x con el modelo de superresolución de 2 pasos. Recortes del repo kandinsky-6-sr, sobre clips generados por Kandinsky 6.0.
No hay tiempos publicados para tarjetas gaming ni para la versión lenta. Un detalle práctico: el complemento solo trabaja sobre la imagen. El sonido hay que volver a ponerlo sobre el vídeo ampliado a partir de la generación original.
Quién hizo qué
Todo esto es trabajo de Kandinsky Lab: los dos modelos de vídeo, el modelo de superresolución, los ajustes de GPU y la tabla de tiempos, con un informe técnico detrás. Sus modelos, además, se apoyan en el trabajo abierto de otros equipos: un modelo de lenguaje del equipo Qwen de Alibaba lee el prompt, un componente al estilo de HunyuanVideo de Tencent convierte el resultado en fotogramas, y piezas de los proyectos MMAudio y BigVGAN lo convierten en sonido.
El mismo día del lanzamiento, los modelos ya funcionaban en cinco herramientas abiertas, desde ComfyUI, de apuntar y hacer clic, hasta software que ejecuta un modelo como servicio compartido, como vLLM-Omni y SGLang. Dos días después, la cuenta de la comunidad realrebelai publicó versiones comprimidas de Pro, de entre unos 17 y 24 GB, pensadas para tarjetas más pequeñas en ComfyUI. Su propia página las marca como experimentales y no probadas del todo, y avisa de que Pro "is still a very large model even after quantization" (sigue siendo un modelo muy grande incluso después de la cuantización, la compresión que aplicó).
Nuestra parte en este post es más modesta: leer los repos, comprobar tamaños de ficheros y configuraciones, y hacer las cuentas.
Qué sacar en claro, y qué queda abierto
Si quieres generar clips cortos con sonido en tu propio hardware, con una licencia que te deja construir sobre el modelo y redistribuirlo, Kandinsky 6.0 merece una prueba. Nosotros hemos leído tiempos, ficheros y configuraciones. No hemos visto los clips ni valorado su calidad, así que esa parte te toca comprobarla a ti. Lite se descarga sin firmar nada y ocupa unos 28 GB, la mayor parte el modelo que lee el prompt. Pro te pide aceptar antes sus condiciones en Hugging Face, con aprobación automática; no hemos podido leer esas condiciones sin iniciar sesión.
Planifícalo como una granja de render, no como un chatbot. Elige la tarjeta por cuántos clips por hora necesitas: unos 12 clips de Pro por hora en una H100, unos 3 en una RTX 4090. Son los modelos estándar en una máquina ya calentada, sin contar la carga ni la escritura del fichero, así que tu ritmo real será menor, en una cantidad que el repo no publica, y el destilado que viene por defecto puede cambiarlo.
El hueco honesto son los modelos destilados: son lo que el repo usa por defecto, y Kandinsky Lab no ha publicado cuánto tardan. Averiguarlo requiere una RTX 5090, el paso de instalación del repo (just setup) y una descarga de 81 GB (just download pro-distill). Después:
cp kandinsky/configs/devices/rtx-5090.yaml my-5090.yaml
printf 'profile:\n  mode: time_mem_module\n' >> my-5090.yaml
just generate "a cat on a mat" --config my-5090.yaml --warmup --out clip.mp4
El comando genera el clip una vez para calentar y luego cronometra una segunda ejecución, de forma parecida a como se midió la tabla. En qué se diferencia esa medida de la de la tabla está en la sección para ingenieros de abajo.
Para ingenieros
Modelos y ficheros (tamaños de la API de Hugging Face, consultados el 2026-10-12; todas las model cards declaran license: mit):
| Repo | Total | Transformer | Notas |
|---|---|---|---|
| Kandinsky-6.0-Pro-5s-Diffusers | 90,04 GB | 69,7 GB | con acceso restringido, aprobación automática |
| Kandinsky-6.0-Pro-distill-5s-Diffusers | 80,65 GB | 60,3 GB | ~30,14B parámetros en la cabecera safetensors (30,107B BF16 + 0,033B F32) |
| Kandinsky-6.0-Pro-pretrain-5s-Diffusers | 90,04 GB | 69,7 GB | |
| Kandinsky-6.0-Lite-5s-Diffusers | 27,78 GB | 7,48 GB | ~3,18B parámetros (2,615B BF16 + 0,561B F32), sin acceso restringido |
| Kandinsky-6.0-Lite-distill-5s-Diffusers | 26,68 GB | 6,38 GB | sin acceso restringido |
| Kandinsky-6.0-VSR-5s-Diffusers | 17,46 GB | 4 pasos por tile | |
| Kandinsky-6.0-VSR-distilled2steps-5s-Diffusers | 17,46 GB | destilado con π-Flow, 2 evaluaciones por tile |
Componentes compartidos de Pro: text encoder Qwen2.5-VL ~16,58 GB (5 shards, también se usa para la expansión del prompt), VAE de audio 1,71 GB, VAE de vídeo 0,99 GB, CLIP 0,49 GB, vocoder 0,49 GB. Las fuentes no explican por qué el transformer de Pro ocupa 69,7 GB y el de Pro-distill 60,3 GB con un número de parámetros nominalmente parecido (la cabecera del Pro restringido no se pudo leer).
Licencias. Código de kandinsky-6: MIT. kandinsky-6-sr: MIT, con sus plantillas de exportación a Diffusers que mantienen los avisos Apache-2.0 (LICENSE-APACHE). Pesos: MIT en todas las model cards. Pro (no destilado) está detrás de un acceso restringido de Hugging Face con aprobación automática.
Arquitectura. Lite: model_dim 1792, 32 bloques visuales, 2 bloques de texto, ff_dim 7168. Pro: model_dim 4096, 60 bloques visuales, 4 bloques de texto, ff_dim 16384. Pipeline Kandinsky6TI2VAPipeline: Kandinsky6Transformer3DModel, AutoencoderKLHunyuanVideo, Qwen2_5_VLForConditionalGeneration, CLIPTextModel (pooled), MMAudioVAE, MMAudioVocoder (estilo BigVGAN), FlowMatchEulerDiscreteScheduler (shift 5.0). Mérito de origen: Qwen2.5-VL (equipo Qwen de Alibaba), CLIP (OpenAI), diseño del VAE de HunyuanVideo (Tencent), MMAudio, BigVGAN (NVIDIA), el método de destilación π-Flow detrás de los checkpoints destilados, FlashAttention 3 (Tri Dao y coautores) y SageAttention (grupo thu-ml de Tsinghua).
Ajustes de generación (kandinsky/configs/checkpoints/*.yaml): pro, lite y pretrain: 864x480, 121 fotogramas, 50 pasos, guidance 5.0. pro-distill y lite-distill: 10 pasos, guidance 1.0, PiflowScheduler (n_grid 10, 128 subpasos de política). Escalado del VAE de audio 0.5302 (pro/lite) o 0.417 (distill, pretrain). La sección de vLLM-Omni dice que Pro usa por defecto 125 fotogramas a 24 fps; las configs nativas y el ejemplo de Diffusers usan 121.
Tabla de tiempos completa (README, Performance). Segundos por clip de 5 s, no destilado, tras el calentamiento, sin contar la carga de pesos ni la codificación del MP4. Offload por módulo en RTX PRO 6000, A100 y H100. Offload por bloque en las tarjetas de consumo. SageAttention2++ para la self-attention visual en todas salvo la H100 (FlashAttention 3).
| RTX 4090 | RTX 5060 Ti | RTX 5080 | RTX 5090 | RTX PRO 6000 | A100 80 GB | H100 | |
|---|---|---|---|---|---|---|---|
| Lite SD | 437 | 1310 | 577 | 309 | 242 | 532 | 239 |
| Lite HD | 422 | 1328 | 579 | 296 | 274 | 472 | 203 |
| Lite Full HD | 578 | 1774 | 770 | 406 | 387 | 664 | 284 |
| Pro SD | 936 | 3080 | 1336 | 754 | 621 | 972 | 356 |
| Pro HD | 1194 | 2716 | 1189 | 638 | 561 | 791 | 292 |
| Pro Full HD | 1247 | 3530 | 1546 | 854 | 765 | 1106 | 402 |
Rarezas que conviene conocer: Pro HD en la 4090 (1194 s) es más lento que en la 5080 (1189 s). En Pro, SD es más lento que HD en todas las tarjetas salvo la 4090 (H100: 356 frente a 292), y Lite HD gana a Lite SD en la 4090, la 5090, la A100 y la H100. El README no define cómo se generan las filas SD, HD y Full HD, así que no las interpreto. La tabla varía a la vez el chip, el kernel de atención y el modo de offload, y no tiene una referencia sin offload, así que no puede separar el coste del offload de la velocidad de cómputo.
El offload en el código (kandinsky/runtime/offload/). module: los módulos registrados se quedan en CPU, un grupo residente cada vez en CUDA, H2D/D2H asíncronos. block: por bloque del DiT (Pro tiene 60 bloques visuales, y no se dice si los 4 bloques de texto se gestionan igual), dos residentes, el siguiente precargado en un stream de transferencia; requiere memoria pinned y rechaza las subclases de parámetros cuantizados y el dit_export de AOTI. OffloadConfig vale none por defecto y la CLI acepta --offload none|module|block, pero todos los presets que trae el repo fijan module (rtx-pro-6000, a100-80gb, h100) o block (rtx-4090, rtx-5090, rtx-5080, rtx-5060-ti). Los presets de la 5060 Ti y la 5080 cargan además el text encoder de Qwen en NF4 con bitsandbytes. No se publica el pico de VRAM por GPU.
Cómo ejecutarlo. Nativo: Python 3.13 o 3.14, GPU NVIDIA, just setup (PyTorch para CUDA 13.0, FlashAttention 3 en Hopper, SageAttention 2.2.0 compilado con nvcc en Ampere, Ada y Blackwell de consumo, así que nvcc tiene que estar en el PATH, con CUDA_HOME por defecto en /usr/local/cuda), just download pro-distill (unos 81 GB en $KANDINSKY_HOME/weights, por defecto ~/.cache/kandinsky), just generate "..." [--config ...] [--out ...]. La config por defecto es h100.yaml. --warmup ejecuta una vez sin guardar y luego otra vez guardando; esa segunda ejecución es la que se perfila cuando el perfilado está activo. El perfilado está desactivado por defecto (ProfileConfig.mode = "none", ningún preset del repo lo activa): añade profile: {mode: time_mem_module} a una copia del preset, como en el fragmento de arriba. El JSON acaba en $KANDINSKY_HOME/profile/time_mem_module/ con --out, o en <run>/profiles/ sin él. El perfil envuelve la llamada completa al pipeline, que además escribe el MP4 y mezcla el audio cuando se da un destino, e incluye la expansión del prompt qwen25 por defecto. Así que su total_time cuenta una codificación que la tabla del README excluye: compara los tiempos por módulo (DiT, VAE, VAE de audio, vocoder) para un resultado más parecido. Otros flags: --sr, --no-audio, --image, --steps, --guidance, --magcache/--navicache.
vLLM-Omni necesita vLLM 0.31.0 más vLLM-Omni compilado desde el código fuente, en Python 3.12, en un entorno aparte. El ejemplo de abajo descarga el repo restringido de Pro, así que antes acepta sus condiciones en Hugging Face y autentícate con un token de HF:
vllm serve kandinskylab/Kandinsky-6.0-Pro-5s-Diffusers --omni \
  --host 127.0.0.1 --port 8091 --num-gpus 1 --enable-cpu-offload
# POST /v1/videos (prompt, size=864x480, num_frames=125, num_inference_steps=50, seed)
# GET /v1/videos/$VID until done, then GET /v1/videos/$VID/content
Diffusers: Kandinsky6TI2VAPipeline.from_pretrained(..., torch_dtype=torch.bfloat16) más pipe.enable_model_cpu_offload(). sample_audio=False da solo vídeo, y expand_prompts=True deja que Qwen2.5-VL reescriba el prompt (añade latencia). Integraciones del día del lanzamiento que lista el README: Diffusers, ComfyUI, vLLM-Omni, SGLang y FastVideo.
Superresolución (kandinsky-6-sr). Kandinsky6SRPipeline, x2, x2.25 (por defecto: x1.125 bilineal y luego el camino x2) o x4, difusión por tiles en el espacio latente de K-VAE con mezcla por ventana de Hann, overlap 0.20, tiles_batch_size 1 por defecto. Una fuente de 480x864 a x2.25 da 1088x1952. Para redimensionarla, fija target_resolution (niveles hd, fullhd, 2k; cada nivel tiene un tamaño horizontal 16:9, uno cuadrado y uno vertical 9:16, y se elige el de relación de aspecto más cercana, p. ej. fullhd horizontal 1080x1920). El redimensionado nunca recorta. Con el target_resize_mode: fit por defecto, los dos lados se escalan por un mismo factor, min(1080/1088, 1920/1952), así que fullhd da 1070x1920 (1920 de ancho, 1070 de alto). Para obtener exactamente 1080x1920 hace falta además target_resize_mode: exact, que admite una ligera deformación anisótropa. Componentes: SR DiT 1,41B, SR VAE 1,74B, banco de upscalers latentes 3,65B. Necesita torch._inductor.config.max_autotune = True y el backend de flex attention. Contrato: 24 fps, como mucho 121 fotogramas. Solo fotogramas: el audio lo vuelves a mezclar tú. Tiempos en H100, modelo de 2 pasos, entrada de 768x512, torch 2.10.0+cu128, sin calentamiento ni E/S: x2 (9 tiles) 41 s, x4 (25 tiles) 118 s.
Cuantizaciones de la comunidad (realrebelai/Kandinsky-6.0-Pro-5s_GGUFs, MIT, creado el 2026-10-08, "Experimental / Not Fully Tested"): Pro Q3_K_S 20,35 GB, Pro Q4_K_S 23,73 GB, Pro W4A8 17,13 GB, Pro-distill W4A8 17,13 GB, encoder Qwen2.5-VL-7B W4A8 5,58 GB. GGUF necesita dos forks de ComfyUI de RebelAI; W4A8 usa los nodos oficiales. La card sugiere 240x240 y 21 fotogramas para las primeras pruebas, y avisa de que una ejecución puede terminar la difusión y luego fallar al decodificar el audio si faltan los ficheros de MMAudio y BigVGAN a 44 kHz.
Límites.
- No hemos ejecutado Kandinsky 6.0 ni hemos mirado o valorado lo que genera. Todos los tiempos son de Kandinsky Lab, con su configuración.
- La tabla es de los modelos no destilados, mientras que todos los presets usan
pro-distillpor defecto. La config exacta detrás de la tabla (checkpoint sobrescrito, pasos, fotogramas) no está publicada. - No se dice si la tabla incluye la expansión del prompt y la codificación del texto, o solo el denoising y la decodificación.
- No hay tiempos para los checkpoints destilados, para el VSR de 4 pasos ni para el VSR en tarjetas de consumo.
- Todas las pruebas publicadas usan offload, así que no se mide ni el coste del offload ni la velocidad sin él. Cualquier conclusión sobre memoria frente a cómputo a partir de esta tabla es una deducción.
- "Offload is required on 80 GB" se afirma para vLLM-Omni. En el pipeline nativo los presets usan offload en todas las tarjetas, pero el repo no dice que ejecutarlo sin él sea imposible.
- Las afirmaciones de calidad (precisión de la sincronización labial, puntuaciones en benchmarks) están en el informe técnico, que este post no evalúa.
Fuentes: kandinsky-6, kandinsky-6-sr, model cards de Pro, Lite y VSR, GGUFs de la comunidad.