EmbeddingGemma 2: un modelo abierto y pequeño para buscar en texto, fotos, vídeo y voz
EmbeddingGemma 2 de Google pone texto, imágenes, vídeo y audio en un mismo espacio de búsqueda. Cargó en 1,4 GB en nuestra RTX 2000 Ada de 16 GB.
La mañana del 14 de octubre, en una tarjeta gráfica alquilada de 16 GB en un centro de datos de Islandia, le preguntamos en inglés a un pequeño índice de búsqueda "how to knead bread dough" (cómo amasar la masa del pan). El índice tenía doce ficheros y ni una sola línea de texto: seis imágenes, tres vídeos cortos y tres grabaciones de voz. De los doce ficheros, solo uno trataba de pan, y salió el primero: una grabación de una voz sintética leyendo una receta de pan en español.
El modelo que hace la búsqueda es EmbeddingGemma 2, que Google DeepMind publicó el 6 de octubre con licencia Apache 2.0. Convierte texto, código, imágenes, vídeo y audio en el mismo tipo de lista de números, así que una sola búsqueda puede saltar de una frase a una foto, un vídeo o una grabación. El modelo entero es una descarga de 1,5 GB.
En resumen: un solo modelo lee cinco tipos de entrada y los pone todos en el mismo espacio de búsqueda, y es lo bastante ligero para una GPU alquilada barata. La pega es un ajuste: si lo ejecutas en el formato numérico equivocado, avisa la model card (la documentación que Google publica con el modelo), los resultados empeoran sin dar ningún error.
Esto es lo que medimos en esa GPU, antes de explicar nada:
| EmbeddingGemma 2 en una NVIDIA RTX 2000 Ada (16 GB) | |
|---|---|
| Qué entra | texto y código, imágenes, vídeo, voz y otro audio, o una mezcla de todo en una sola entrada |
| Qué sale | una lista de 768 números por entrada, que se puede recortar a 512, 256 o 128 |
| Tamaño del modelo | 740M parámetros en total (los números aprendidos dentro del modelo, una medida aproximada de su tamaño), 270M si solo necesitas texto |
| Memoria de GPU, con el modelo cargado | 1,4 GB (0,5 GB solo texto) |
| Memoria de GPU en el momento de más carga | 1,5 GB para una imagen, 2,6 GB para un documento cerca de la longitud máxima del modelo, unos 10 GB para ocho documentos largos a la vez |
| Tiempo del modelo por petición | 36 ms para una consulta de búsqueda, 111 ms para una imagen, 158 ms para 8,6 s de voz, 307 ms para un vídeo de 6 s |
| Nuestra prueba de búsqueda | 6 de 6 consultas de texto encontraron el fichero correcto entre 12 fotos, vídeos y grabaciones |
| Tiempo desde "arráncalo" hasta la primera respuesta | 78 s la primera vez, 12 s con el fichero del modelo (1,5 GB) ya en la máquina |
Un mapa donde las cosas parecidas caen juntas
Un embedding es una forma de poner cualquier cosa en un mapa. El modelo lee una frase, una foto o una grabación y le da una posición, escrita como una lista de números (aquí, 768). Las cosas que significan lo mismo caen cerca. Buscar es entonces sencillo: colocas la pregunta en el mismo mapa y te quedas con lo que tenga más cerca. Es lo que hacen por dentro muchos sistemas de "chatea con tus documentos": primero encuentran los fragmentos más cercanos y luego se los pasan a un chatbot.
Muchos modelos de embeddings dibujan su mapa solo a partir de texto. EmbeddingGemma 2 pone todo tipo de entrada en un mismo mapa. Una foto de un zorro dormido en la nieve y la frase "an animal sleeping in the snow" caen cerca, y también un vídeo de 6 segundos del mismo zorro. También puedes mezclar cosas en una sola entrada: el ejemplo de la model card es la ficha de un producto con dos fotos y un vídeo, que sale como una única posición en el mapa que puedes comparar con cualquier otra cosa.
Imagina el disco duro de un grupo después de una gira: grabaciones de ensayos, fotos de los conciertos, vídeos movidos grabados con el móvil en la furgoneta, un setlist escrito en una app de notas. Con un solo mapa, "el público cantando el estribillo" o "la furgoneta en la frontera" es una pregunta que le puedes hacer a todo eso desde una sola caja de texto, siempre que el momento quedara grabado por un micro o una cámara.
Qué ha publicado Google
El modelo tiene tres partes, y solo cargas las que necesitas. La parte de texto, que también lee código, es un modelo de 270M. Un lector de imágenes y vídeo añade 170M y un lector de sonido añade 300M, 740M en total. Si tu búsqueda es solo de texto, te saltas las otras dos y te quedas con un modelo de 270M. Es más pequeño que el primer EmbeddingGemma (308M, según la documentación de Google), que según Google ha superado los 20 millones de descargas.
Cada entrada puede tener unos 8.000 tokens (un token es más o menos una palabra o un trozo de una), cuatro veces más que la primera versión. Las imágenes, el vídeo y el sonido comparten ese mismo presupuesto: por defecto caben en una entrada unas 29 imágenes, 58 fotogramas de vídeo (uno por segundo) o unos cinco minutos y medio de audio, según la model card. Cubre más de 100 idiomas, y en nuestra prueba una grabación en español respondió a una pregunta en inglés.
En las pruebas de la propia Google rinde igual que la primera versión en texto en muchos idiomas (61,36 frente a 61,15) y en torno a un 14% mejor buscando código (78,68 frente a 68,76). Las puntuaciones de imagen, vídeo y sonido no tienen versión anterior con la que comparar. La tabla completa está en la sección para ingenieros.
La licencia es Apache 2.0, que permite uso comercial, modificaciones y redistribución. Google la llama "commercially permissive", y el repo de Hugging Face es abierto, sin formulario que firmar.
Listas de números más pequeñas, casi la misma búsqueda
Cada fichero que indexas se guarda como su lista de números, y un índice grande supone una factura grande de almacenamiento y memoria. EmbeddingGemma 2 está entrenado como un juego de muñecas rusas (la técnica, Matryoshka Representation Learning, lleva el nombre de las matrioskas): los primeros 512, 256 o 128 números de cada lista son una versión más pequeña del mapa que sigue funcionando. Recortar de 768 a 128 números ocupa seis veces menos.
La model card es honesta con el precio. Hasta 256 números, los resultados son "close to lossless" (casi sin pérdida): la puntuación en texto apenas se mueve (61,36 a 60,41). A 128, el texto aguanta, pero la búsqueda entre imágenes y vídeo pierde casi una cuarta parte de su puntuación (59,01 a 45,65), y la recuperación de audio hablado alrededor de una quinta parte (69,54 a 56,71). El consejo de la model card es dejar 128 para trabajo solo con texto. Haciendo cuentas sencillas, un millón de documentos a 768 números cada uno, guardados a 4 bytes por número, ocupan unos 3 GB, y a 256 números, alrededor de 1 GB.
El ajuste que falla sin avisarte
Las GPU pueden guardar números en un formato compacto para ahorrar memoria. El más común, float16, es justo el que la model card dice que no uses nunca: los números internos del modelo se salen de su rango. Su formato hermano, bfloat16, ocupa la misma memoria y es seguro. El formato de tamaño completo (float32) también es seguro, pero ocupa el doble de memoria.
Esto importa en GPU antiguas que no tienen el formato seguro: ahí pagas el doble de memoria por el de tamaño completo. Nuestro ejemplo pide una GPU NVIDIA reciente que tenga el formato seguro, como la RTX 2000 Ada que usamos. El propio código de la model card elige el formato seguro cuando la GPU lo soporta y el de tamaño completo en caso contrario, y nuestro backend hace lo mismo y nunca usa float16. No probamos GPU antiguas, así que comprueba qué formato elige de verdad tu código en la tuya.
Una cosa que no hicimos: nunca ejecutamos el modelo en float16 para ver el fallo con nuestros propios ojos. Todo lo que medimos es el formato seguro de 16 bits en la GPU, o el formato de tamaño completo en un procesador normal. El aviso es de Google.
Cómo lo ejecutamos en InferenceKey
Ningún servidor ya hecho de los que probamos podía ejecutar todavía este modelo entero, así que escribimos uno pequeño nosotros y lo ejecutamos en InferenceKey. Aquí van la GPU, el código, las cifras y lo que se rompió por el camino.
La GPU y por qué esa
Alquilamos una NVIDIA RTX 2000 Ada Generation con 16 GB de memoria en RunPod, en Islandia. Es una GPU pequeña de estación de trabajo de 70 vatios, y aquí sobra: el modelo cargó en 1,4 GB, dejando libre la mayor parte de los 16 GB para entradas largas. Nuestra primera opción, una RTX A4000, estaba agotada, así que cogimos esta.
Para tus propias cuentas: indexar 100.000 páginas de unos 500 tokens llevaría, según nuestra aritmética, unos 36 minutos de tiempo de modelo (medimos 32 de esas páginas en 0,69 segundos). Eso cuenta solo el tiempo del modelo, no el de enviar los ficheros, arrancar la máquina o esperar entre peticiones.
Por qué un custom backend
Un backend es el trozo de código que carga un modelo una vez y luego responde a las peticiones. Los backends de embeddings ya hechos de InferenceKey solo aceptan texto, y el servidor de código abierto vLLM todavía no reconocía este modelo cuando lo comprobamos (versión 0.31.0). El post de lanzamiento de Google lista varias de estas herramientas como soportadas, así que esto puede cambiar pronto. Los detalles están en la sección para ingenieros.
Así que escribimos nuestro propio backend en Python, algo que InferenceKey te deja traer. El paquete ocupa unos 6 KB, sin pesos dentro, y carga el modelo como muestra la model card, en bfloat16. Para texto acepta el mismo formato de petición que la API de embeddings de OpenAI. Para contenido multimedia añade un formato propio y sencillo, de modo que cada elemento puede ser texto o una foto, una grabación o un vídeo, y puede devolver las listas más cortas. Una entrada incorrecta recibe un error claro en lugar de una respuesta rara.
También publicamos una variante solo de texto que nunca carga los lectores de imagen y sonido. Usó 0,5 GB de memoria de GPU con el modelo cargado.
Ejecutamos todo esto en una copia privada de pruebas de InferenceKey, con la GPU alquilada conectándose a ella, así que nada de esto tocó nuestro servicio de producción. El nombre de empresa que sale en el vídeo, Northwind Search, es una cuenta de demo inventada.
Los pasos
Todo está en el ejemplo de nuestro SDK (el kit de software para manejar InferenceKey desde código), embeddinggemma2-multimodal-embedding-custom-backend-private-nvidia. Necesitas una cuenta de InferenceKey con un worker NVIDIA (una máquina con GPU conectada a tu proyecto) cuya GPU soporte bfloat16. El fichero .env del ejemplo lista las claves que lee. El SDK se compila en local desde el repo:
cp .env.example .env        # SDK token, API key, project, worker id (tenant id and session token only for publish.py)
python -m venv .venv && . .venv/bin/activate
pip install maturin requests
( cd ../../bindings/python && maturin develop --release )
python publish.py           # packages backend.py and registers it as "embeddinggemma2-multimodal"
python main.py              # deploy, wait until ready, text search, then cross-modal search over ./media
main.py le pide a InferenceKey una copia del modelo en tu worker, espera a que esté sirviendo, lanza una búsqueda de texto y después ordena consultas de texto frente a cada foto, grabación y vídeo de ./media. Al salir borra el modelo en ejecución (el workload), salvo que pongas IK_KEEP_ALIVE=1. Para la variante solo de texto: python publish.py --variant text y después EG2_VARIANT=text python main.py. Abajo está la forma de la petición. La dirección que aparece es la del servicio alojado de InferenceKey, que el ejemplo usa por defecto. Nosotros enviamos la misma petición a nuestra copia privada de pruebas, no a esta dirección.
curl https://cloud.inferencekey.com/endpoint/$INFERENCEKEY_PROJECT/embeddinggemma2-multimodal/v1/embeddings \
  -H "Authorization: Bearer $INFERENCEKEY_API_KEY" -H "Content-Type: application/json" \
  -d '{"model": "default", "input": ["an animal sleeping in the snow", {"image": "https://example.com/fox.jpg"}], "prompt_name": "SearchQuery", "dimensions": 256}'
Lo que medimos
Arranque. Desde la llamada de despliegue hasta que pudo responder pasaron 78 segundos en una máquina nueva: 49 segundos para instalar las librerías de Python y después 29 segundos para descargar el fichero del modelo de 1,5 GB y cargarlo. Con el fichero del modelo ya en la máquina, un despliegue nuevo estuvo listo en 12 segundos. Cuando publicamos una versión nueva de nuestro backend, InferenceKey reinició por sí solo el modelo en ejecución con el código nuevo, en 13 segundos.
Velocidad. Estos son los tiempos que la máquina con GPU dedicó a cada petición, el valor central de varias ejecuciones:
- una consulta de búsqueda: 36 ms
- 256 textos cortos en una petición: 204 ms, unos 1.250 textos por segundo (nuestra aritmética)
- 32 documentos de unos 500 tokens (más o menos una página cada uno) en una petición: 688 ms, o sea unas 46 páginas por segundo (nuestra aritmética)
- 8,6 segundos de voz: 158 ms
- una foto: 111 ms, y ocho fotos en una petición: 867 ms, unas 9 fotos por segundo (nuestra aritmética)
- un vídeo de 6 segundos: 307 ms
- una frase, dos fotos y una grabación mezcladas en una sola entrada: 232 ms
Recortar la lista a 512, 256 o 128 números no cambió la velocidad (de 34 a 35 ms por consulta). Solo hace la respuesta más pequeña de enviar y guardar.
Vista desde nuestra mesa, cada petición tardó alrededor de un cuarto de segundo más que esas cifras. Ese tiempo extra es el camino, no el modelo: las peticiones iban desde nuestra máquina de desarrollo, pasando por la copia de pruebas de InferenceKey y un túnel, hasta una GPU en Islandia. Un despliegue situado junto a sus usuarios se ahorraría la mayor parte.
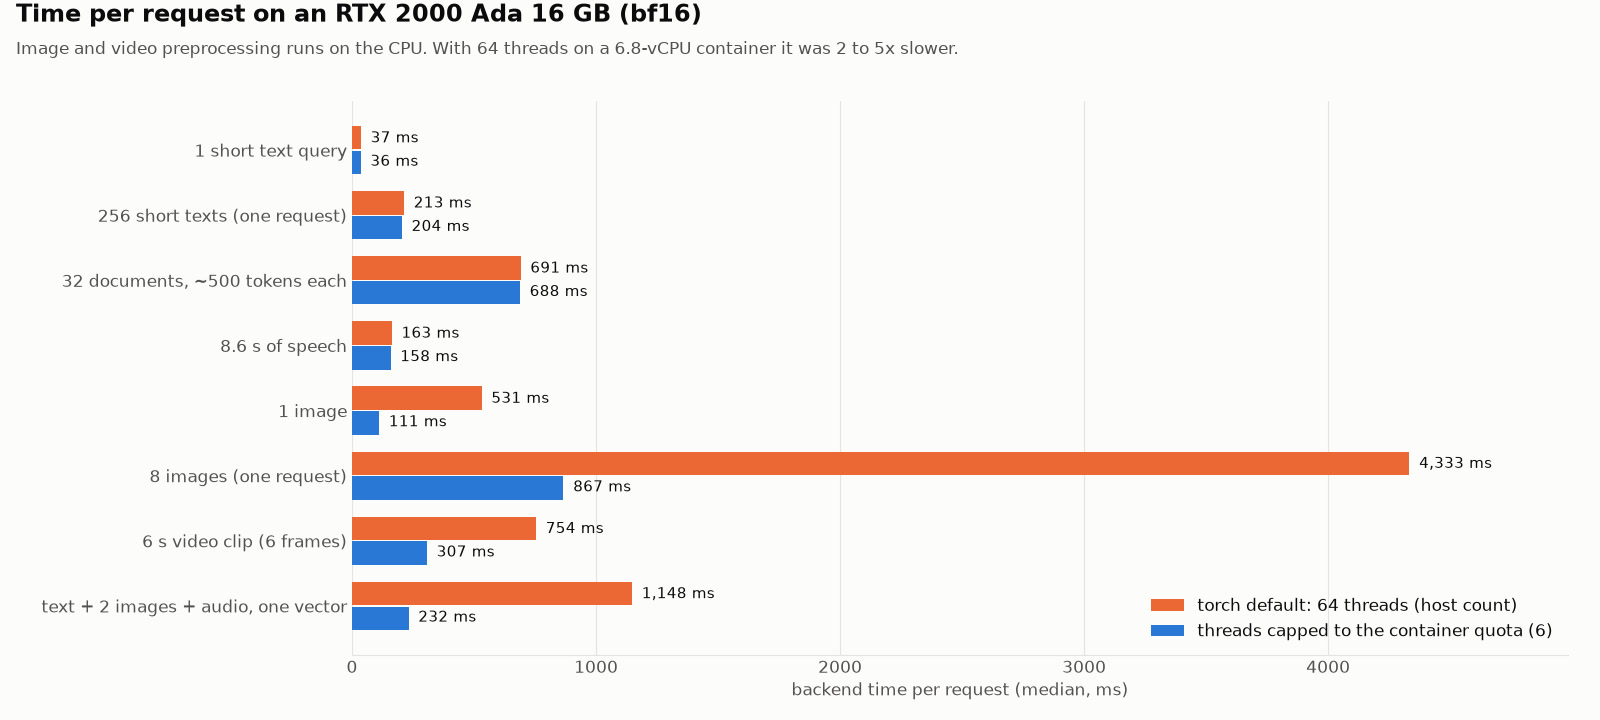
El azul es el backend final. El naranja es la primera versión, antes del arreglo de CPU que se describe en "Lo que falló". Al texto y a la voz les dio igual. Las fotos y el vídeo iban entre dos y cinco veces más lentos.
Memoria. El modelo completo ocupó 1,4 GB de memoria de GPU una vez cargado. Una consulta corta apenas lo movió. En nuestra GPU, el modelo más una entrada cada vez nunca necesitó más de 2,6 GB. Los lotes grandes de documentos largos son la excepción: ocho documentos de 6.000 tokens en una petición necesitaron unos 10 GB. En detalle, la memoria llegó a un pico de 1,5 GB para una foto, 2,0 GB para ocho fotos, 2,6 GB para un documento de 8.000 tokens y 3,3 GB para 32 documentos de 500 tokens. En una GPU de 16 GB eso sigue cabiendo, pero es la cifra con la que hay que planificar si indexas PDF largos en masa. La GPU nunca consumió más de 68 vatios.
La prueba de búsqueda
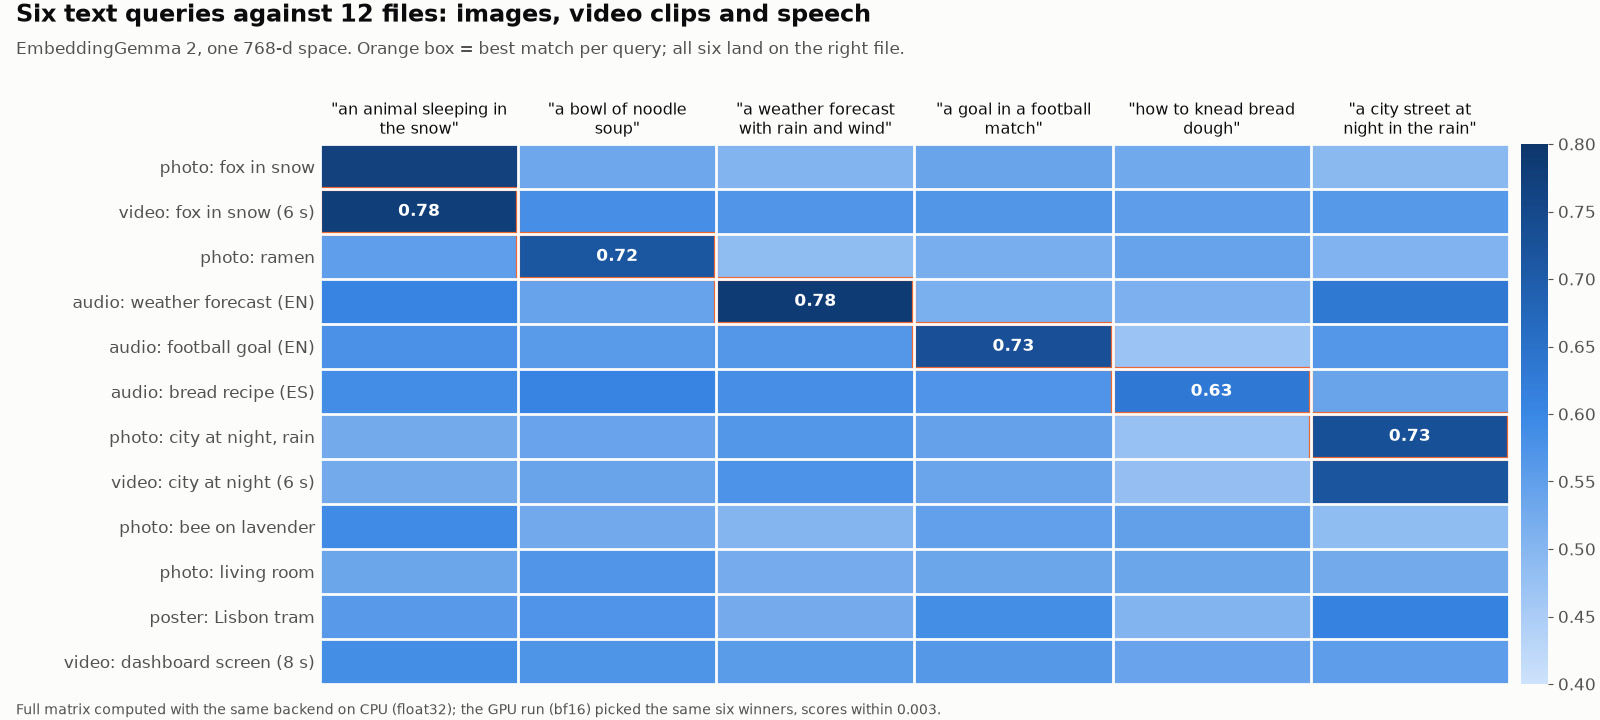
Cada columna es una pregunta, cada fila un fichero. Más oscuro significa más cerca en el mapa. La celda recuadrada es la primera respuesta.
Las seis preguntas encontraron el fichero correcto. "A weather forecast with rain and wind" (un parte meteorológico con lluvia y viento) encontró el parte grabado. "A goal in a football match" (un gol en un partido de fútbol) encontró la narración del fútbol. "How to knead bread dough" encontró la receta en español. Para "an animal sleeping in the snow", las dos primeras respuestas fueron el vídeo del zorro y la foto del mismo zorro, y para "a city street at night in the rain" (una calle de ciudad de noche bajo la lluvia), la foto y el vídeo de la misma calle. Un matiz: cada uno de esos vídeos es un barrido lento de cámara sobre la misma imagen que tiene al lado, así que sus fotogramas son recortes de esa foto. El casi empate muestra que el camino del vídeo y el de la foto coinciden entre sí, no que el modelo reconociera la misma escena filmada por separado. Las puntuaciones fueron idénticas cuando lo repetimos 22 minutos después.
Esto demuestra menos de lo que parece. Los doce ficheros son nuestros y sintéticos: seis imágenes que hicimos con Iris-3B, un modelo que genera imágenes, en una prueba anterior, tres grabaciones hechas con Pocket TTS, un modelo de texto a voz, y tres vídeos (dos barridos de cámara de 6 segundos sobre las imágenes y 8 segundos de nuestra demo anterior del panel con Iris, la "pantalla de panel"). Demuestra que el mecanismo funciona a través de InferenceKey. No dice nada de cómo se compara el modelo con otros, que es para lo que está la tabla de benchmarks de Google. La puntuación mide lo cerca que está un fichero de la pregunta en el mapa, y más alto es más cerca. Todas cayeron en una franja estrecha, entre 0,45 y 0,80 aproximadamente, así que lo que importa es la distancia entre la primera y la segunda respuesta, no la cifra en sí. La ganadora más baja fue la receta de pan, con 0,63.
La demo
La grabación de 57 segundos de abajo es el panel de InferenceKey durante la prueba: los dos workloads de EmbeddingGemma 2 (completo y solo texto) ejecutándose en la máquina con GPU, llamada gpu-search-01, la caja de pruebas integrada del panel respondiendo a una consulta de búsqueda con una lista de 768 números en 163 ms, y la vista en directo mientras un script envía fotos, grabaciones y vídeos.
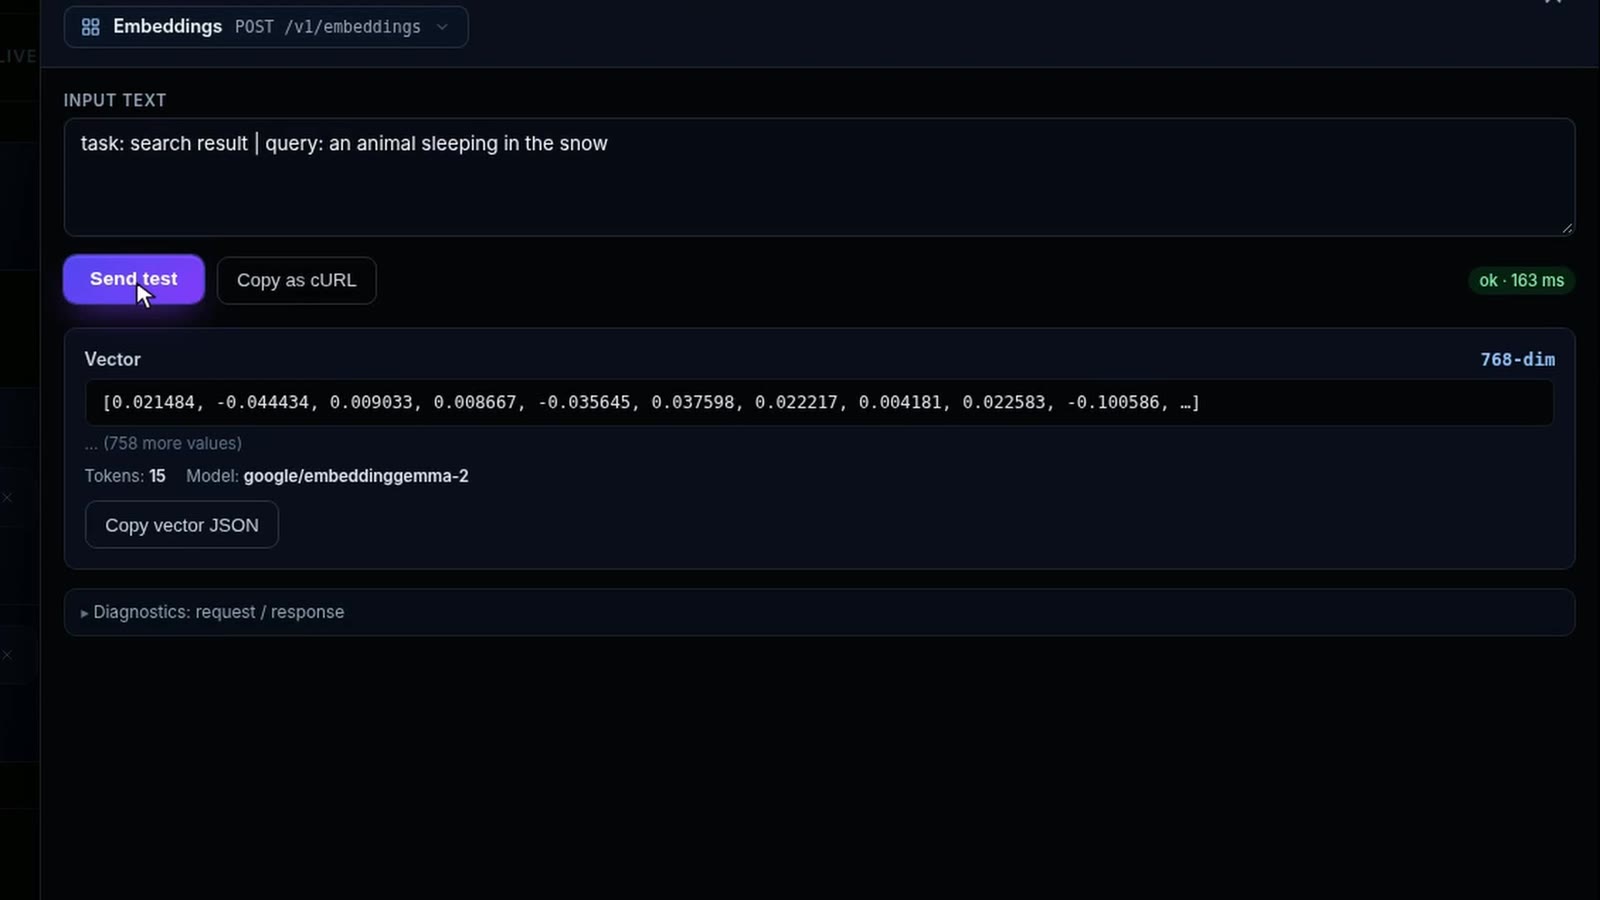
Haz clic en la imagen para ver el MP4 (56,6 s, 4,8 MB).
En pantalla se ven dos detalles del panel que nos toca arreglar a nosotros: la columna Access dice "No access" aunque la API key del proyecto funcionaba, y la tabla Workers dice que solo recibe parte de las lecturas de salud de la GPU ("GPU telemetry partial").
Lo que falló
El modelo funcionó de principio a fin, y el probador y la vista en directo del panel funcionaron con nuestro backend sin cambios. Por el camino nos topamos con cinco problemas. Los problemas 1 a 3 estaban en nuestro backend, y los problemas 1, 4 y 5 muestran carencias del lado de InferenceKey:
- La primera instalación falló en 3 segundos, y el motivo no estaba en el log. El worker solo decía que la instalación de Python había fallado. Ejecutarla a mano en la máquina mostró por qué: el instalador cogía copias desactualizadas de unas cuantas librerías comunes de una fuente de descarga secundaria, y no se podían cumplir las versiones mínimas que habíamos pedido. Las quitamos. La carencia real es nuestra: el worker debería mostrar el error del instalador, y hoy no lo hace.
- Las fotos y el vídeo iban entre dos y cinco veces más lentos de lo que deberían. La GPU dedicaba unos 72 ms a cada foto, pero la CPU dedicaba de 0,33 a 0,44 segundos a prepararla. Nuestra máquina alquilada era una porción de un servidor más grande. Tenía permitidos unos 7 núcleos de procesador, pero el software veía los 64 e intentaba usarlos todos, así que el trabajo se estorbaba a sí mismo. Decirle que usara solo su parte real llevó una foto de 531 a 111 ms y ocho fotos de 4,3 a 0,87 segundos. El arreglo está en el ejemplo: lee cuántos núcleos tiene permitidos la máquina alquilada, y en una máquina que no lo indique, el número lo pones tú.
- La GPU se quedaba con memoria que ya no necesitaba. Después del lote de ocho documentos largos, el servidor retuvo 11,6 GB hasta que se reinició, porque la librería de IA que hay debajo guarda memoria para la próxima vez. Ahora el backend devuelve esa memoria después de cualquier petición muy grande, y tras el mismo lote se quedó en 1,6 GB.
- "Esperar hasta que esté listo" se colgó una vez. Pedirle al SDK que desplegara un modelo que ya estaba sirviendo, y luego esperar a que estuviera listo, se quedó en "checking readiness" más de 10 minutos en una ejecución (lo paramos) y 90 segundos cuando lo repetimos a propósito. Nuestra copia de pruebas funcionaba con un componente de InferenceKey, el policy executor, desactivado. Puede estar relacionado, pero todavía no lo sabemos, y no hemos confirmado que pase en producción. Borrar y volver a desplegar tardó 12 segundos.
- El probador del panel solo acepta texto. Las fotos, el sonido y el vídeo tienen que ir por la API de momento.
Quién hizo qué
EmbeddingGemma 2 es trabajo de Google DeepMind: el modelo, los tres lectores, la tabla de benchmarks y la model card que avisa sobre float16. Lo entrenaron con la técnica de las muñecas rusas (Matryoshka Representation Learning, de una investigación anterior de Kusupati y sus colegas en 2022). El post de lanzamiento es de Sahil Dua y Henrique Schechter Vera, ingenieros de investigación de Google DeepMind. El modelo está construido sobre Gemma 4, comparte partes con él (su divisor de palabras y su lector de sonido) y sale de la misma tecnología que los modelos Gemini Embedding, según el post. La librería transformers de Hugging Face, el código estándar para ejecutar modelos abiertos, añadió soporte en la versión 5.19.0. Su compañera sentence-transformers es la que usa la model card para ejecutarlo. PyAV, un lector de vídeo y audio, decodificó nuestros vídeos y grabaciones. Las imágenes de prueba salieron de Iris-3B de Sperid Labs, las tres grabaciones de voz del modelo de texto a voz Pocket TTS, y la herramienta de vídeo ffmpeg cortó los barridos.
Nuestra parte: comprobar qué herramientas podían ejecutarlo, escribir el custom backend y el ejemplo del SDK, ejecutarlo en InferenceKey, medir velocidad y memoria, arreglar los tres problemas del backend y grabar la demo.
Qué sacar en claro
Si quieres búsqueda sobre documentos, fotos, grabaciones y vídeo en tu propia GPU, con una licencia que te deje construir un producto encima, merece la pena probar EmbeddingGemma 2. Funcionó en una GPU pequeña de 16 GB con la mayor parte de la memoria de sobra, y el modelo tardó 36 ms en una consulta de búsqueda y alrededor de una décima de segundo en una foto. Nuestra opinión: el motivo para ejecutar esto en tu propia GPU es el control y la privacidad, no el coste (no comparamos precios). Las grabaciones de llamadas, las fotos de producto y las capturas de pantalla son justo los ficheros que preferirías no subir a la API de otro para poder buscar en ellos. Aquí el modelo y los datos se quedan en una máquina que eliges tú, tu propio servidor o una GPU que alquilas, no una compartida con un proveedor de API. Nuestra propia prueba usó un pod alquilado. Ten en cuenta tres cosas. Ejecútalo en bfloat16 o en el formato de tamaño completo (float32), nunca en float16. Si preparas fotos o vídeo en una máquina alquilada, dile al software cuántos núcleos de procesador tiene de verdad. Y deja libres unos 10 GB de memoria de GPU si envías documentos largos en lotes grandes.
La comprobación que no hicimos es justo la que señala la model card. Esta prueba se limitó a servir el modelo de la forma segura, así que una ejecución en float16 es nuestra próxima prueba, no parte de esta: cargar el modelo en float16 en la misma GPU, generar los embeddings de los mismos doce ficheros y comparar el mapa con el de arriba. Si la model card tiene razón, nada se romperá, y las listas de números pueden volver vacías de significado (NaN, "not a number") o desviadas sin que se note. Veremos si se mueve alguna casilla.
Para ingenieros
Modelo (model card, post de lanzamiento, documentación de Google). Repo de HF google/embeddinggemma-2, creado el 2026-09-14, modificado por última vez el 2026-10-06, sha 914f7f89142e33e77833254d9c9b90c3cef7303b, license:apache-2.0, sin acceso restringido, 124.930 descargas y 2.122 likes cuando lo consultamos el 2026-10-14. model.safetensors 1.488.915.288 bytes (bf16).
Backbone de texto: 24 capas, model dim 512, hidden dim 2048, 4 cabezas, cabezas KV local/global 2/1 (GQA/MQA), local:global 5:1, sliding window 1024, vocabulario 262.144, FFN con compuerta y GELU, mean pooling, proyección 512 -> 768. Contexto de 8.192 tokens. Salida de 768, truncado MRL a 512/256/128 (renormaliza después de truncar, y las consultas y los documentos tienen que usar la misma dimensión).
Carga selectiva de encoders (config_kwargs de sentence-transformers):
| Carga | config_kwargs | Parámetros |
|---|---|---|
| solo texto | {"vision_config": None, "audio_config": None} | 270M (contamos 271.002.624) |
| texto + imagen | {"audio_config": None} | 440M |
| texto + audio | {"vision_config": None} | 570M |
| completo | {} | 740M |
Coste en tokens dentro de la ventana compartida de 8.192 tokens: texto 1 por subpalabra, imagen 280 por defecto (unas 29 imágenes), vídeo 140 por fotograma (unos 58 fotogramas, 1 fps por defecto), audio 25 por segundo (unos 327 s, mono 16 kHz). El presupuesto de visión se puede configurar de 70 a 1120 soft tokens, hasta unas 114 imágenes o fotogramas en el extremo bajo. El intercalado usa los placeholders <|image|>, <|video|>, <|audio|> y devuelve un solo embedding. Las entradas de texto llevan prefijos de tarea (task: search result | query: {query}, documentos title: {title} | text: {content}, task: code retrieval | query: {query}), el contenido multimedia no lleva ninguno. Más de 100 idiomas, datos de entrenamiento en más de 140 idiomas, fecha de corte enero de 2025.
Benchmarks de la model card (checkpoint en precisión completa):
| 768d | 512d | 256d | 128d | EmbeddingGemma 1 (768d) | |
|---|---|---|---|---|---|
| MTEB multilingual v2 | 61,36 | 61,17 | 60,41 | 57,89 | 61,15 |
| MTEB code v1 | 78,68 | 77,24 | 76,18 | 71,41 | 68,76 |
| MMEB v2 overall | 59,01 | 58,38 | 56,24 | 45,65 | |
| MSEB retrieval (MRR@10) | 69,54 | 69,18 | 66,76 | 56,71 |
También a 768d: MIEB lite 64,64, MMEB v2 Image 57,28 (Hit@1), VisDoc 67,84 (NDCG@5), Video 50,67 (Hit@1), MAEB 49,39. La model card describe la mejora en código como de un 14% aproximadamente y el blog como +9,92 puntos, que es el mismo cambio (9,92 / 68,76).
Precisión, literal de la model card: "Run inference in bfloat16 or float32. Do not use float16." y "In float16 the model returns NaN or silently degraded embeddings rather than raising an error, so the failure is easy to miss." bfloat16 donde haya soporte nativo, float32 en el resto, incluida la mayoría de CPU. Selección sugerida: dtype = torch.bfloat16 if torch.cuda.is_bf16_supported() else torch.float32. No hicimos una comparación en float16. Las cifras de Google en dispositivo (cuantizado, Pixel 11 Pro) son unos 191 MB de RAM solo texto y unos 567 MB completo. Ninguna página de Google da una cifra de VRAM de GPU.
Nuestro montaje. RunPod NVIDIA RTX 2000 Ada Generation, SECURE cloud, EUR-IS-1, driver 570.195.03 (CUDA 12.8), 16.380 MiB, límite de 70 W, compute capability 8.9, 8 vCPU anunciadas, cuota de cgroup de 6,8 CPU con 64 visibles, 0,24 USD/h. RTX A4000 COMMUNITY y SECURE y RTX 2000 Ada COMMUNITY respondieron 409 por falta de stock. Bootstrap del pod 66 s después de la llamada de creación. Manager local de InferenceKey (nunca producción) accesible a través de túneles HTTP y TCP, 71 ms de RTT hasta el pod. Backend: Python 3.12.3, torch 2.14.1+cu126 (la wheel de CUDA 13 de PyPI necesita driver 580+), transformers 5.19.0 (primera release con embedding_gemma2), sentence-transformers 6.1.0, av 19.0.1. Venv multimodal de 6,7 GB en disco, venv solo texto de 89 MB, caché de HF de 1,5 GB. Slugs del custom backend embeddinggemma2-multimodal y embeddinggemma2-text, task_type embedding, policy fixed. Versiones publicadas 0.1.0 (instalación fallida), 0.1.1, 0.1.2 (límite de hilos), 0.1.3 (liberación de caché). Commit del ejemplo del SDK f18474c en main de inferencekey-sdk. Las peticiones viajan como un solo mensaje con un límite de 8 MB, así que envía los ficheros grandes de uno en uno o pasa URL.
Por qué un custom backend, y qué hace. vLLM 0.31.0 (2026-10-05) registra Gemma3TextModel (EmbeddingGemma 1) pero no EmbeddingGemma2Model, así que no puede servir este modelo ni siquiera para texto. Los backends de embeddings integrados de InferenceKey (SGLang, Ollama, llama.cpp) solo aceptan texto. El post de lanzamiento de Google lista vLLM, SGLang, Ollama, llama.cpp (GGUF) y otros como herramientas soportadas; no comprobamos builds posteriores de vLLM ni los caminos no textuales de los demás. El backend carga SentenceTransformer("google/embeddinggemma-2") en bf16 cuando torch.cuda.is_bf16_supported(), si no en float32, nunca en float16. Las imágenes se decodifican con Pillow, el audio y el vídeo con PyAV (vídeo a 1 fps, máximo 32 fotogramas; audio a 16 kHz mono). /v1/embeddings acepta la forma JSON de OpenAI para texto; los elementos también pueden ser objetos con text, image, audio o video (data URI, base64 o URL), que es una extensión nuestra, así que un cliente estándar de OpenAI solo puede enviar texto. Otros campos: dimensions (768/512/256/128), prompt_name, encoding_format. Las respuestas incluyen usage y timings. Una entrada incorrecta devuelve 400 (comprobado con dimensions: 300 y una imagen que no se puede decodificar).
Tiempos de arranque. En frío: de ensure() a listo 78,3 s (venv + dependencias 49 s, descarga + carga 28,6 s). Variante solo texto como segundo workload en el mismo pod: 19,7 s (carga 5,3 s). Volver a publicar de 0.1.1 -> 0.1.2 recicló en caliente el workload en ejecución en 13 s. ensure() nuevo con los pesos en caché: 11,9 s.
Tiempo del modelo por petición (timings.encode_s del backend, bf16, medianas. Antes = 64 hilos, después = limitado a la cuota del cgroup):
| Entrada | antes ms | después ms | ida y vuelta después s |
|---|---|---|---|
| 1 consulta de texto corta | 37 | 36 | 0,28 |
| 256 textos cortos (4.242 tokens) | 213 | 204 | 1,02 |
| 32 docs de ~500 tokens (16.256 tokens) | 691 | 688 | 1,15 |
| 8 docs de ~6.000 tokens (48.064 tokens) | 4.411 | 4.416 | 5,73 |
| 8,6 s de voz | 163 | 158 | 0,50 |
| 1 imagen (JPEG de 768 px) | 531 | 111 | 0,38 |
| 8 imágenes | 4.333 | 867 | 1,32 |
| vídeo de 6 s, 6 fotogramas | 754 | 307 | 0,68 |
| grabación de pantalla de 8 s, 8 fotogramas | 910 | 422 | 0,85 |
| texto + 2 imágenes + audio, un vector | 1.148 | 232 | 0,58 |
| 1 texto a 512 / 256 / 128 dims | 35 / 34 / 35 | 0,28 / 0,28 / 0,29 |
Throughput: unos 23.600 tokens/s con docs de 500 tokens y unos 10.900 tokens/s con docs de 6.000 tokens. Los textos/s e imágenes/s del relato son nuestra división de estas medianas, no mediciones aparte. dimensions cambia el tamaño de la respuesta (5.550 / 2.883 / 1.559 bytes a 512 / 256 / 128), no la velocidad. Sobrecoste de la plataforma de unos 0,25 s por petición en nuestro camino con túnel. El probador del panel mostró 163 ms para una consulta de 15 tokens.
VRAM (torch.cuda.max_memory_allocated en un proceso aparte, más nvidia-smi cada 0,5 s). Cargado: 1.432 MiB asignados (multimodal), 517 MiB (solo texto), 1.530 MiB en la GPU justo después de cargar. Picos: 1 texto corto 1.441 MiB, 1 imagen 1.515 MiB, 8 imágenes 2.031 MiB, 32 docs x 500 tokens 3.344 MiB, un doc de 2.000 tokens 1.678 MiB, un doc de 6.000 tokens 2.152 MiB, un doc de 8.000 tokens 2.640 MiB. 8 docs x 6.000 tokens: el proceso que servía creció hasta 11.610 MiB y se quedó ahí (caché del allocator). El mismo lote en un tercer proceso dio OOM con 0,9 GB libres ("Tried to allocate 1.10 GiB"), así que necesita unos 10 GB. Con torch.cuda.empty_cache() por encima de 16.384 tokens, los dos procesos que servían se quedaron en 1.598 MiB y 678 MiB después del mismo lote. Pico de consumo 68,1 W.
Prueba de recuperación (12 ficheros con un embedding por petición, seis consultas en inglés con prompt_name: SearchQuery, GPU bf16):
| Consulta | Top-1 (puntuación) | Segundo (puntuación) |
|---|---|---|
| an animal sleeping in the snow | video-fox.mp4 (0,7756) | img-fox.jpg (0,7662) |
| a bowl of noodle soup | img-ramen.jpg (0,7161) | bread-es.wav (0,6059) |
| a weather forecast with rain and wind | weather-en.wav (0,7847) | bread-es.wav (0,5824) |
| a goal in a football match | football-en.wav (0,7322) | img-poster.jpg (0,5849) |
| how to knead bread dough | bread-es.wav (0,6336) | video-fox.mp4 (0,5546) |
| a city street at night in the rain | img-city.jpg (0,7260) | video-city.mp4 (0,7183) |
Puntuaciones idénticas en dos ejecuciones (05:28 y 05:50 UTC). Comprobación solo de texto a través del embed() tipado del SDK: la consulta de la aurora sacó 0,8229 frente al pasaje correcto y 0,5754 / 0,5147 / 0,4981 frente a los demás. La matriz completa de 6 x 12 del heatmap se recalculó después con el mismo backend en CPU en float32: los mismos seis ganadores, con puntuaciones a menos de 0,003 de la ejecución en GPU.
Problemas, al detalle. (1) El driver 570 del pod es demasiado antiguo para el torch de CUDA 13 de PyPI (necesita 580+), así que requirements.txt añade el índice extra cu126 de PyTorch. SDK error [server_up]: bootstrap step failed, worker WARN worker::bootstrap: custom backend: uv pip install -r requirements.txt failed sin salida de uv. A mano: No solution found ... only requests==2.28.1 is available and you require requests>=2.31 ... uv will only consider versions that are published on the first index that contains a given package. El índice extra cu126 también aloja versiones antiguas de requests, pillow y numpy. Arreglo: sin versiones mínimas. Carencia: el worker no muestra el stderr de uv. (2) Profiler: 72 ms de CUDA por imagen frente a 0,33 a 0,44 s de preprocesado en CPU con 64 hilos sobre una cuota de 6,8 CPU. _cpu_quota() limita los hilos de torch (se puede forzar con EG2_TORCH_THREADS): una imagen 0,50 -> 0,10 s, 8 imágenes 4,7 -> 0,86 s en el profiler. Probado solo en este contenedor de RunPod; lee la cuota del cgroup, así que los contenedores sin cuota necesitan EG2_TORCH_THREADS. (3) 11,6 GB retenidos tras un lote largo, arreglado con empty_cache() por encima de 16.384 tokens. (4) wait_until_ready() después de ensure() sobre un workload que ya estaba sirviendo se quedó en "worker assigned; checking readiness" (más de 10 min una vez, 90 s en una reproducción): el worker registra custom backend: driven by ProjectConfigSnapshot; skipping legacy LoadModel, y la comprobación de disponibilidad lee worker_leases, que tenía 0 filas. El manager local funcionaba con POLICY_EXECUTOR_ENABLED=false, así que esto es una observación en local, no un bug confirmado en producción. (5) El probador de embeddings del panel solo acepta texto. Además: un aviso de Hugging Face Hub sin autenticar (sin HF_TOKEN), y 3 de 4 opciones de GPU respondieron 409.
Límites.
- Un solo modelo de GPU, una sola máquina, solo bfloat16 en la GPU. Sin ejecución en float16, sin ejecución en float32 en GPU, sin GPU sin bfloat16 nativo.
- El conjunto de recuperación son 12 ficheros sintéticos nuestros. Muestra el mecanismo, no la calidad frente a otros modelos.
- Los tiempos son por petición, desde un script de benchmark. No hicimos pruebas de carga con muchas llamadas concurrentes.
- Las idas y vueltas incluyen un túnel desde nuestra máquina de desarrollo hasta Islandia y no representan un despliegue situado junto a los usuarios.
- Solo comprobamos vLLM 0.31.0. No comprobamos builds posteriores de vLLM, ni si SGLang, Ollama o llama.cpp (GGUF) sirven los caminos de imagen, vídeo y audio de este modelo.
- El cuelgue de
wait_until_ready()solo se vio en un stack local con el policy executor desactivado.
Fuentes: model card, post de lanzamiento de Google, documentación de Google AI for Developers, ejemplo del SDK.