EmbeddingGemma 2 : un petit modèle ouvert pour chercher dans du texte, des photos, de la vidéo et de la voix
EmbeddingGemma 2 de Google place texte, images, vidéo et audio dans un même espace de recherche. Chargé en 1,4 GB sur notre RTX 2000 Ada de 16 GB.
Le matin du 14 octobre, sur une carte graphique de 16 GB louée dans un data center en Islande, nous avons posé une question en anglais à un petit index de recherche : "how to knead bread dough" (comment pétrir une pâte à pain). L'index contenait douze fichiers et pas une seule ligne de texte : six images, trois courts clips vidéo et trois enregistrements de voix. Sur les douze fichiers, un seul parlait de pain, et c'est lui qui est arrivé en tête : l'enregistrement d'une voix de synthèse qui lit une recette de pain en espagnol.
Le modèle qui fait la recherche est EmbeddingGemma 2, que Google DeepMind a publié le 6 octobre sous licence Apache 2.0. Il transforme le texte, le code, les images, la vidéo et l'audio en un même type de liste de nombres, si bien qu'une seule recherche peut passer d'une phrase à une photo, un clip ou un enregistrement. Le modèle complet se télécharge en 1,5 GB.
En bref : un seul modèle lit cinq types d'entrées et les place tous dans le même espace de recherche, et il est assez léger pour un GPU loué bon marché. Le piège tient à un seul réglage : faites-le tourner dans le mauvais format de nombres et, prévient la fiche du modèle (la documentation que Google publie avec le modèle), les résultats se dégradent sans la moindre erreur.
Voici ce que nous avons mesuré sur ce GPU, avant de tout expliquer :
| EmbeddingGemma 2 sur une NVIDIA RTX 2000 Ada (16 GB) | |
|---|---|
| Ce qui entre | du texte et du code, des images, de la vidéo, de la voix et d'autres sons, ou un mélange de tout cela dans une seule entrée |
| Ce qui sort | une liste de 768 nombres par entrée, que l'on peut couper à 512, 256 ou 128 |
| Taille du modèle | 740 millions de paramètres au total (les nombres appris à l'intérieur du modèle, une mesure approximative de sa taille), 270 millions si vous n'avez besoin que du texte |
| Mémoire GPU, modèle chargé | 1,4 GB (0,5 GB en texte seul) |
| Mémoire GPU au moment le plus chargé | 1,5 GB pour une image, 2,6 GB pour un document proche de la longueur maximale du modèle, environ 10 GB pour huit longs documents à la fois |
| Temps du modèle par requête | 36 ms pour une requête de recherche, 111 ms pour une image, 158 ms pour 8,6 s de voix, 307 ms pour un clip de 6 s |
| Notre test de recherche | 6 requêtes texte sur 6 ont trouvé le bon fichier parmi 12 photos, clips et enregistrements |
| Du "lancez-le" à la première réponse | 78 s la première fois, 12 s quand le fichier du modèle (1,5 GB) était déjà sur la machine |
Une carte où les choses semblables tombent côte à côte
Un embedding est une façon de placer n'importe quoi sur une carte. Le modèle lit une phrase, une photo ou un enregistrement et lui donne une position, écrite sous forme de liste de nombres (768 ici). Les choses qui veulent dire la même chose tombent près les unes des autres. Chercher devient alors simple : on place la question sur la même carte et on prend ce qui se trouve le plus près. C'est ce que font en coulisse beaucoup de systèmes pour "discuter avec vos documents" : ils trouvent d'abord les passages les plus proches, puis les passent à un chatbot.
Beaucoup de modèles d'embedding ne dessinent leur carte qu'à partir de texte. EmbeddingGemma 2 place tous les types d'entrées sur une seule carte. La photo d'un renard endormi dans la neige et la phrase "un animal qui dort dans la neige" tombent près l'une de l'autre, et une vidéo de 6 secondes du même renard aussi. On peut aussi mélanger plusieurs choses dans une seule entrée : l'exemple de la fiche du modèle est une fiche produit avec deux photos et une vidéo, qui ressort comme une seule position sur la carte, comparable à n'importe quoi d'autre.
Imaginez le disque dur d'un groupe après une tournée : des enregistrements de répétition, des photos de concerts, des vidéos tremblantes prises au téléphone dans le van, une setlist tapée dans une appli de notes. Avec une seule carte, "le public qui chante le refrain" ou "le van à la frontière" devient une question que l'on peut poser à tout cela depuis une seule zone de texte, à condition que le moment ait été capté par un micro ou une caméra.
Ce que Google a publié
Le modèle a trois parties, et vous ne chargez que celles dont vous avez besoin. La partie texte, qui lit aussi le code, est un modèle de 270M. Un lecteur d'images et de vidéo ajoute 170M et un lecteur de sons ajoute 300M, soit 740M au total. Si votre recherche ne porte que sur du texte, vous laissez tomber les deux autres et gardez un modèle de 270M. C'est plus petit que le premier EmbeddingGemma (308M, d'après la documentation de Google), qui a dépassé 20 millions de téléchargements selon Google.
Chaque entrée peut faire environ 8 000 tokens (un token correspond à peu près à un mot ou à un morceau de mot), quatre fois plus que la première version. Les images, la vidéo et le son partagent ce même budget : par défaut, environ 29 images, 58 images de vidéo (une par seconde) ou environ cinq minutes et demie d'audio tiennent dans une seule entrée, selon la fiche du modèle. Il couvre plus de 100 langues, et dans notre test un enregistrement en espagnol a répondu à une question en anglais.
Sur les propres tests de Google, il fait aussi bien que la première version sur le texte en plusieurs langues (61,36 contre 61,15) et environ 14 % mieux pour trouver du code (78,68 contre 68,76). Les scores sur l'image, la vidéo et le son n'ont pas de version précédente à laquelle se comparer. Le tableau complet est dans la section pour les ingénieurs.
La licence est Apache 2.0, qui autorise l'usage commercial, la modification et la redistribution. Google la qualifie de "commercially permissive" (permissive pour un usage commercial), et le repo Hugging Face est ouvert, sans formulaire à signer.
Des listes de nombres plus courtes, une recherche presque identique
Chaque fichier indexé est stocké sous forme de sa liste de nombres, et un gros index veut dire une grosse facture de stockage et de mémoire. EmbeddingGemma 2 est entraîné comme un jeu de poupées gigognes (la technique, Matryoshka Representation Learning, tient son nom des poupées russes) : les 512, 256 ou 128 premiers nombres de chaque liste forment une version réduite de la carte qui fonctionne encore. Passer de 768 à 128 nombres divise le stockage par six.
La fiche du modèle est honnête sur le prix à payer. Jusqu'à 256 nombres, les résultats sont "close to lossless" (quasiment sans perte) : le score texte bouge à peine (de 61,36 à 60,41). À 128, le texte tient encore, mais la recherche à travers les images et la vidéo perd presque un quart de son score (de 59,01 à 45,65), et la recherche dans l'audio parlé environ un cinquième (de 69,54 à 56,71). Le conseil de la fiche du modèle est de réserver 128 au travail en texte seul. Par simple calcul, un million de documents à 768 nombres chacun, stockés à 4 octets par nombre, occupent environ 3 GB, et à 256 nombres environ 1 GB.
Le réglage qui échoue sans prévenir
Les GPU peuvent stocker les nombres dans un format compact pour économiser de la mémoire. Le plus courant, float16, est celui que la fiche du modèle dit de ne jamais utiliser : les nombres internes du modèle dépassent ce qu'il peut contenir. Son format jumeau, bfloat16, prend la même mémoire et ne pose pas de problème. Le format pleine taille (float32) est sûr lui aussi, mais prend deux fois plus de mémoire.
Cela compte sur les GPU plus anciens qui n'ont pas le format sûr : là, vous payez le double de mémoire pour le format pleine taille. Notre exemple demande un GPU NVIDIA récent qui a le format sûr, comme la RTX 2000 Ada que nous avons utilisée. Le code de la fiche du modèle choisit le format sûr quand le GPU le prend en charge et le format pleine taille sinon, et notre backend fait de même et n'utilise jamais float16. Nous n'avons pas testé de GPU plus anciens, alors vérifiez quel format votre code choisit réellement sur le vôtre.
Une chose que nous n'avons pas faite : nous n'avons jamais fait tourner le modèle en float16 pour voir la panne nous-mêmes. Tout ce que nous avons mesuré l'a été dans le format 16 bits sûr sur le GPU, ou dans le format pleine taille sur un processeur ordinaire. L'avertissement vient de Google.
Le faire tourner sur InferenceKey
Aucun serveur prêt à l'emploi parmi ceux que nous avons essayés ne pouvait encore faire tourner tout ce modèle, alors nous en avons écrit un petit nous-mêmes et l'avons fait tourner sur InferenceKey. Voici le GPU, le code, les chiffres, et ce qui a cassé en route.
Le GPU et pourquoi celui-là
Nous avons loué une NVIDIA RTX 2000 Ada Generation avec 16 GB de mémoire sur RunPod, en Islande. C'est un petit GPU de station de travail de 70 watts, et c'est largement suffisant ici : le modèle s'est chargé en 1,4 GB, ce qui laisse l'essentiel des 16 GB libres pour les entrées longues. Notre premier choix, une RTX A4000, était en rupture de stock, alors nous avons pris celle-ci.
Pour vos propres calculs : indexer 100 000 pages d'environ 500 tokens prendrait, selon notre calcul, environ 36 minutes de temps du modèle (nous avons mesuré 32 de ces pages en 0,69 seconde). Cela ne compte que le temps du modèle, pas le temps d'envoyer les fichiers, de démarrer la machine ou d'attendre entre les requêtes.
Pourquoi un backend custom
Un backend est le morceau de code qui charge un modèle une fois puis répond aux requêtes. Les backends d'embedding prêts à l'emploi d'InferenceKey ne prennent que du texte, et le serveur open source vLLM ne reconnaissait pas encore ce modèle quand nous avons vérifié (version 0.31.0). L'article de lancement de Google cite plusieurs de ces outils comme pris en charge, donc cela peut changer vite. Les détails sont dans la section pour les ingénieurs.
Nous avons donc écrit notre propre backend en Python, ce qu'InferenceKey permet d'apporter. Le paquet fait environ 6 KB, sans aucun poids à l'intérieur, et il charge le modèle comme le montre la fiche du modèle, en bfloat16. Pour le texte, il accepte le même format de requête que l'API d'embeddings d'OpenAI. Pour les médias, il ajoute sa propre forme simple, de sorte que chaque élément peut être du texte ou une photo, un enregistrement ou un clip, et il peut renvoyer les listes raccourcies. Une entrée invalide reçoit une erreur claire au lieu d'une réponse bizarre.
Nous avons aussi publié une variante texte seul qui ne charge jamais les lecteurs d'images et de sons. Elle occupait 0,5 GB de mémoire GPU une fois chargée.
Nous avons fait tourner tout cela sur une copie de test privée d'InferenceKey, avec le GPU loué qui s'y connectait, donc rien ici n'a touché notre service de production. Le nom d'entreprise dans la vidéo, Northwind Search, est un compte de démo inventé.
Les étapes
Tout est dans l'exemple de notre SDK (le kit logiciel pour piloter InferenceKey depuis du code), embeddinggemma2-multimodal-embedding-custom-backend-private-nvidia. Il vous faut un compte InferenceKey avec un worker NVIDIA (une machine GPU connectée à votre projet) dont le GPU prend en charge bfloat16. Le fichier .env de l'exemple liste les clés qu'il lit. Le SDK se compile en local depuis le repo :
cp .env.example .env        # SDK token, API key, project, worker id (tenant id and session token only for publish.py)
python -m venv .venv && . .venv/bin/activate
pip install maturin requests
( cd ../../bindings/python && maturin develop --release )
python publish.py           # packages backend.py and registers it as "embeddinggemma2-multimodal"
python main.py              # deploy, wait until ready, text search, then cross-modal search over ./media
main.py demande à InferenceKey une copie du modèle sur votre worker, attend qu'elle serve, lance une recherche texte puis classe des requêtes texte face à chaque photo, enregistrement et clip de ./media. Il supprime le modèle en cours (le workload) en sortant, sauf si vous définissez IK_KEEP_ALIVE=1. Pour la variante texte seul : python publish.py --variant text, puis EG2_VARIANT=text python main.py. Voici la forme de la requête. L'adresse indiquée est celle du service InferenceKey hébergé, que l'exemple utilise par défaut. Nous avons envoyé la même requête à notre copie de test privée, pas à cette adresse.
curl https://cloud.inferencekey.com/endpoint/$INFERENCEKEY_PROJECT/embeddinggemma2-multimodal/v1/embeddings \
  -H "Authorization: Bearer $INFERENCEKEY_API_KEY" -H "Content-Type: application/json" \
  -d '{"model": "default", "input": ["an animal sleeping in the snow", {"image": "https://example.com/fox.jpg"}], "prompt_name": "SearchQuery", "dimensions": 256}'
Ce que nous avons mesuré
Démarrage. De l'appel de déploiement jusqu'à la première réponse possible, il a fallu 78 secondes sur une machine neuve : 49 secondes pour installer les bibliothèques Python, puis 29 secondes pour télécharger le fichier du modèle de 1,5 GB et le charger. Avec le fichier du modèle déjà sur la machine, un nouveau déploiement était prêt en 12 secondes. Quand nous avons publié une nouvelle version de notre backend, InferenceKey a redémarré tout seul le modèle en cours avec le nouveau code, en 13 secondes.
Vitesse. Voici le temps que la machine GPU a passé sur chaque requête, la valeur médiane de plusieurs exécutions :
- une requête de recherche : 36 ms
- 256 textes courts dans une requête : 204 ms, environ 1 250 textes par seconde (notre calcul)
- 32 documents d'environ 500 tokens (à peu près une page chacun) dans une requête : 688 ms, donc environ 46 pages par seconde (notre calcul)
- 8,6 secondes de voix : 158 ms
- une photo : 111 ms, et huit photos dans une requête : 867 ms, environ 9 photos par seconde (notre calcul)
- un clip vidéo de 6 secondes : 307 ms
- une phrase, deux photos et un enregistrement mélangés dans une seule entrée : 232 ms
Couper la liste à 512, 256 ou 128 nombres n'a rien changé à la vitesse (34 à 35 ms pour une requête). Cela rend seulement la réponse plus petite à envoyer et à stocker.
Vue de notre bureau, chaque requête prenait environ un quart de seconde de plus que ces chiffres. Ce temps en plus, c'est la route, pas le modèle : les requêtes partaient de notre machine de développement, passaient par la copie de test d'InferenceKey et un tunnel jusqu'à un GPU en Islande. Un déploiement installé à côté de ses utilisateurs n'en paierait pas l'essentiel.
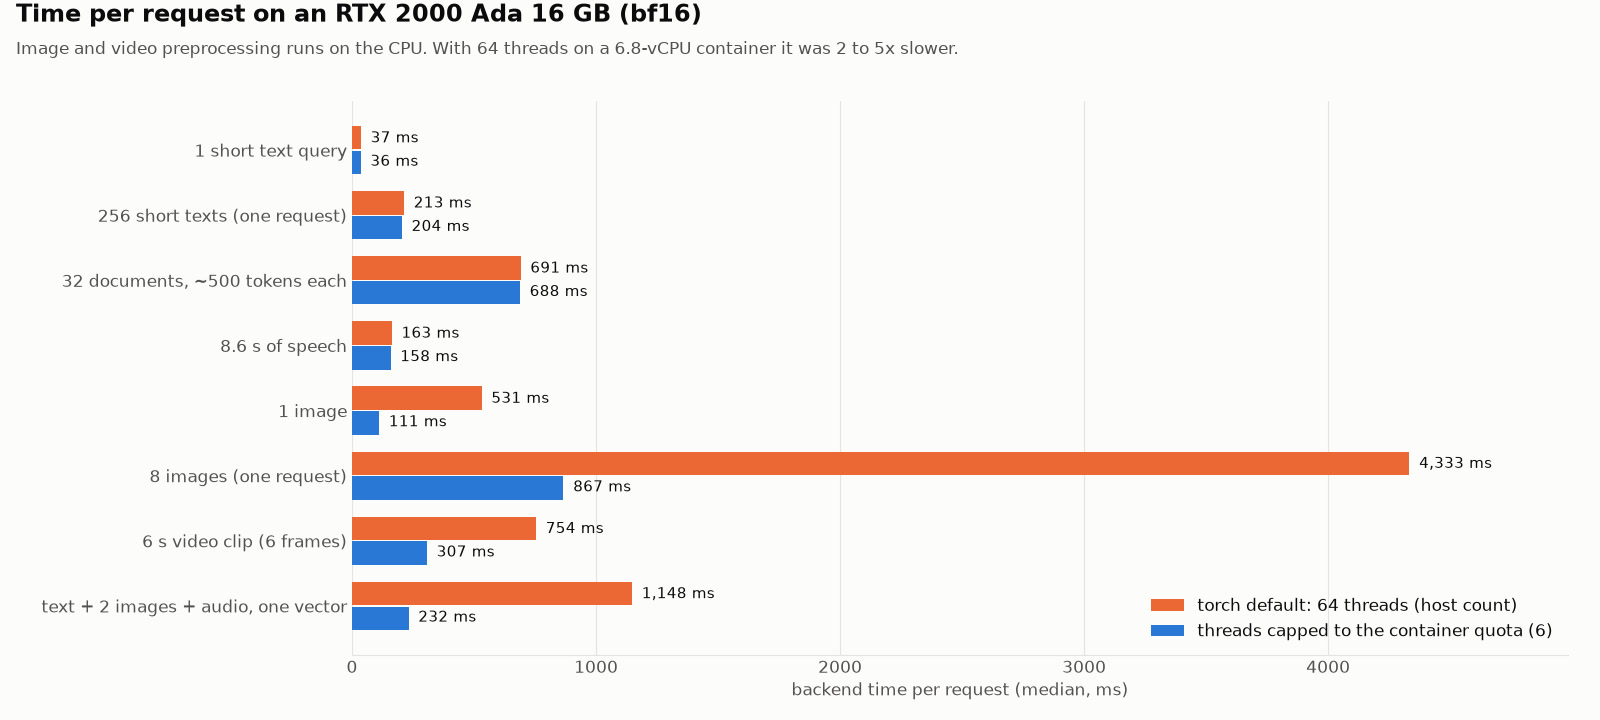
En bleu, le backend final. En orange, la première version, avant la correction CPU décrite dans "Ce qui a cassé". Le texte et la voix n'ont rien remarqué. Les photos et la vidéo étaient deux à cinq fois plus lentes.
Mémoire. Le modèle complet occupait 1,4 GB de mémoire GPU une fois chargé. Une requête courte l'a à peine fait bouger. Sur notre GPU, le modèle plus une entrée à la fois n'a jamais demandé plus de 2,6 GB. Les gros lots de longs documents font exception : huit documents de 6 000 tokens dans une requête ont demandé environ 10 GB. Dans le détail, la mémoire a culminé à 1,5 GB pour une photo, 2,0 GB pour huit photos, 2,6 GB pour un document de 8 000 tokens et 3,3 GB pour 32 documents de 500 tokens. Sur un GPU de 16 GB, cela tient encore, mais c'est le chiffre à prévoir si vous indexez de longs PDF en masse. Le GPU n'a jamais tiré plus de 68 watts.
Le test de recherche
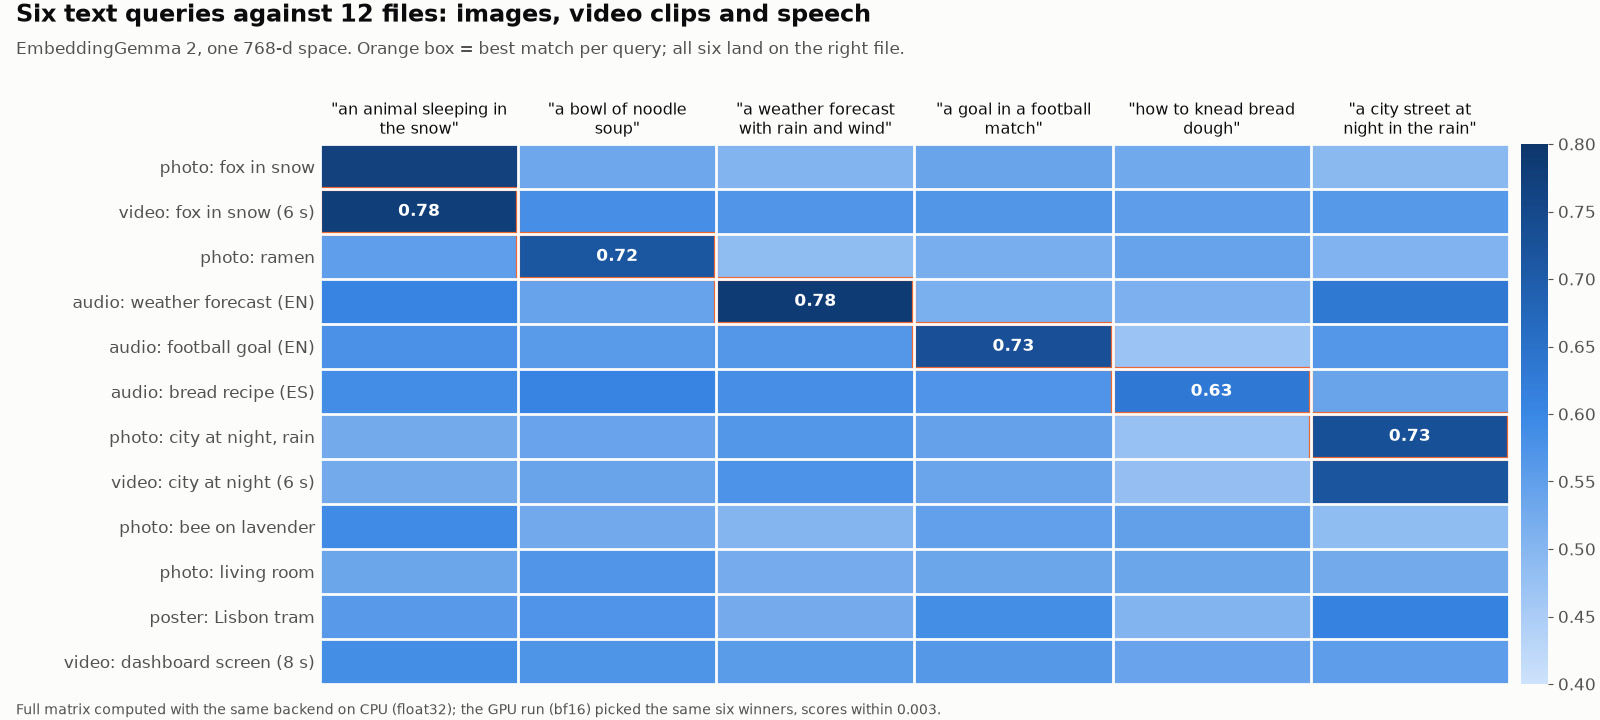
Chaque colonne est une question, chaque ligne un fichier. Plus c'est foncé, plus c'est proche sur la carte. La case encadrée est la première réponse.
Les six questions ont trouvé le bon fichier. "A weather forecast with rain and wind" (une météo avec pluie et vent) a trouvé la météo parlée. "A goal in a football match" (un but dans un match de football) a trouvé le commentaire de football. "How to knead bread dough" a trouvé la recette en espagnol. Pour "an animal sleeping in the snow" (un animal qui dort dans la neige), les deux premières réponses étaient la vidéo du renard et la photo du même renard, et pour "a city street at night in the rain" (une rue de ville la nuit sous la pluie), la photo et la vidéo de la même rue. Une réserve : chacune de ces vidéos est un lent panoramique de caméra sur l'image même qui se trouve à côté, donc ses images sont des recadrages de cette photo. Le quasi ex aequo montre que le chemin vidéo et le chemin photo sont d'accord entre eux, pas que le modèle a reconnu la même scène filmée séparément. Les scores étaient identiques quand nous avons relancé le test 22 minutes plus tard.
Cela prouve moins qu'il n'y paraît. Les douze fichiers sont à nous et synthétiques : six images que nous avons faites avec Iris-3B, un modèle qui génère des images, lors d'un test précédent, trois enregistrements faits avec Pocket TTS, un modèle de synthèse vocale, et trois clips (deux panoramiques de 6 secondes sur les images et 8 secondes de notre démo précédente du panneau avec Iris, l'"écran de tableau de bord"). Cela montre que le mécanisme fonctionne à travers InferenceKey. Cela ne dit rien du classement du modèle face aux autres, ce à quoi sert le tableau de benchmarks de Google. Le score mesure à quelle distance un fichier se trouve de la question sur la carte, et plus il est haut, plus c'est proche. Tous sont tombés dans une bande étroite, entre environ 0,45 et 0,80, donc ce qui compte, c'est l'écart entre la première et la deuxième réponse, pas le nombre lui-même. Le gagnant le plus bas était la recette de pain, à 0,63.
La démo
L'enregistrement de 57 secondes ci-dessous montre le panneau d'InferenceKey pendant le test : les deux workloads EmbeddingGemma 2 (complet et texte seul) qui tournent sur la machine GPU, nommée gpu-search-01, la zone de test intégrée au panneau qui répond à une requête de recherche avec une liste de 768 nombres en 163 ms, et la vue en direct pendant qu'un script envoie des photos, des enregistrements et des clips.
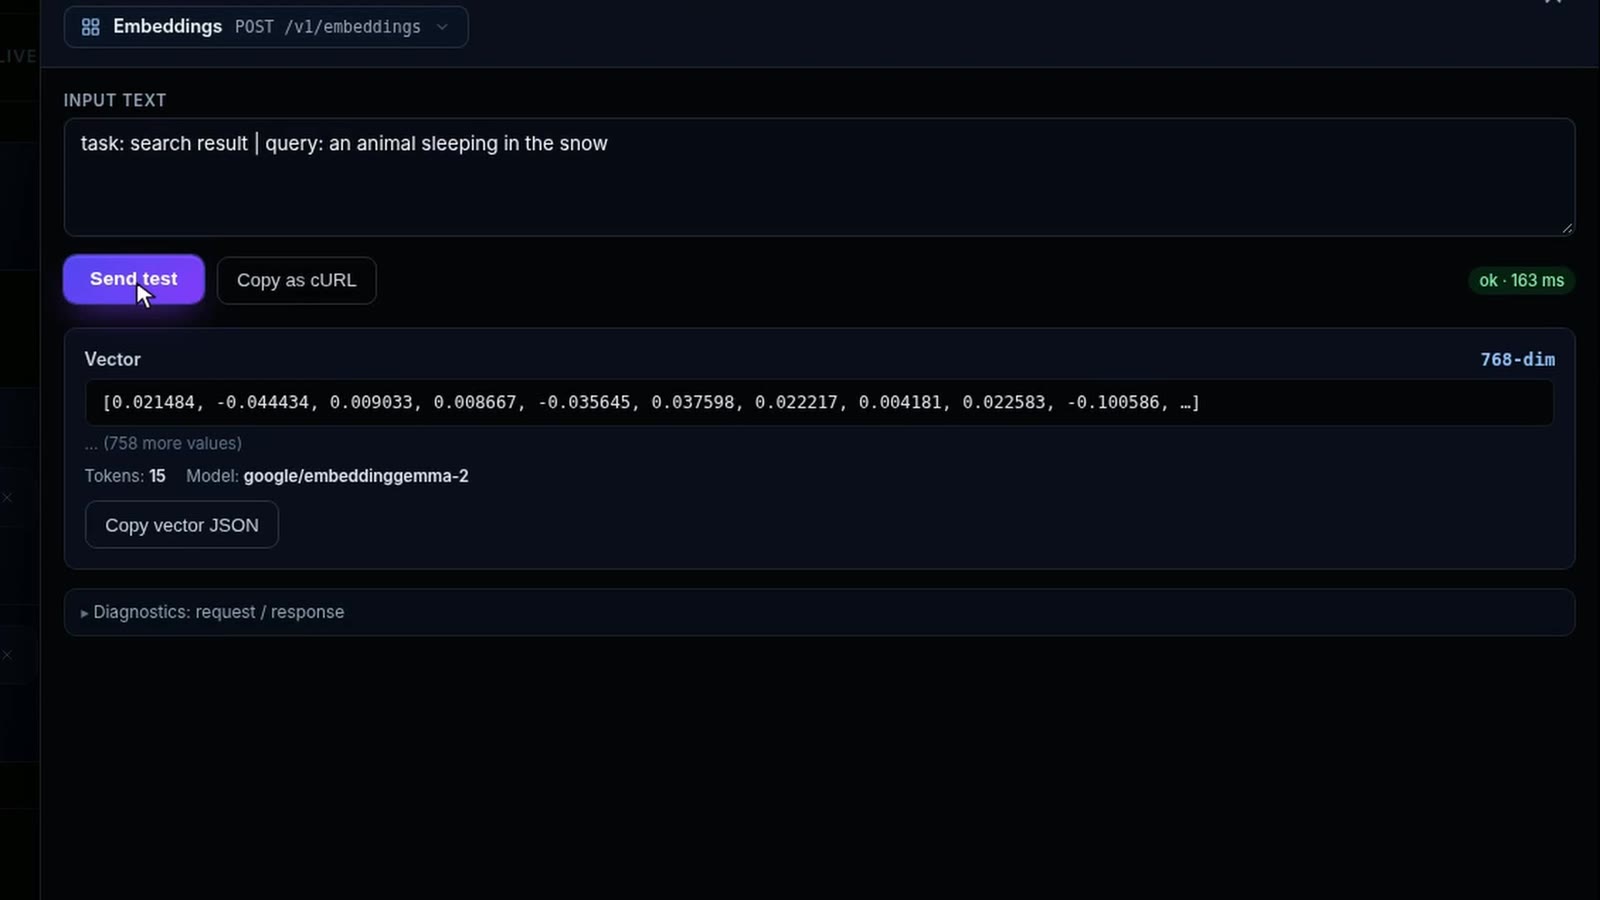
Cliquez sur l'image pour lire le MP4 (56,6 s, 4,8 MB).
Deux détails du panneau apparaissent à l'écran et sont à nous de corriger : la colonne Access indique "No access" alors que la clé d'API du projet fonctionnait, et le tableau Workers indique qu'il ne reçoit qu'une partie des relevés de santé du GPU ("GPU telemetry partial").
Ce qui a cassé
Le modèle a tourné de bout en bout, et le testeur et la vue en direct du panneau ont fonctionné avec notre backend sans modification. En route, nous avons rencontré cinq problèmes. Les problèmes 1 à 3 étaient dans notre backend, et les problèmes 1, 4 et 5 montrent des manques côté InferenceKey :
- La première installation a échoué en 3 secondes, et la raison n'était pas dans le log. Le worker disait seulement que l'installation Python avait échoué. La lancer à la main sur la machine a montré pourquoi : l'installateur récupérait des copies obsolètes de quelques bibliothèques courantes depuis une source de téléchargement secondaire, et les versions minimales que nous avions demandées ne pouvaient pas être satisfaites. Nous les avons retirées. Le vrai manque est de notre côté : le worker devrait afficher l'erreur de l'installateur, et aujourd'hui il ne le fait pas.
- Les photos et la vidéo étaient deux à cinq fois plus lentes qu'elles ne devraient. Le GPU passait environ 72 ms sur chaque photo, mais le CPU passait 0,33 à 0,44 seconde à la préparer. Notre machine louée était une tranche d'un serveur plus gros. Elle avait droit à environ 7 cœurs de processeur, mais le logiciel en voyait 64 et essayait de tous les utiliser, si bien que le travail se marchait dessus. Lui dire de n'utiliser que sa part réelle a fait passer une photo de 531 à 111 ms et huit photos de 4,3 à 0,87 seconde. La correction est dans l'exemple : il lit combien de cœurs la machine louée a le droit d'utiliser, et sur une machine qui ne le dit pas, c'est à vous de fixer le nombre.
- Le GPU gardait de la mémoire dont il n'avait plus besoin. Après le lot de huit longs documents, le serveur a conservé 11,6 GB jusqu'à son redémarrage, parce que la bibliothèque d'IA en dessous garde la mémoire pour la prochaine fois. Le backend rend maintenant cette mémoire après toute très grosse requête, et après le même lot il restait à 1,6 GB.
- "Attendre que ce soit prêt" s'est bloqué une fois. Demander au SDK de déployer un modèle qui servait déjà, puis attendre qu'il soit prêt, est resté sur "checking readiness" plus de 10 minutes lors d'une exécution (nous l'avons arrêté) et 90 secondes quand nous avons réessayé exprès. Notre copie de test tournait avec un composant d'InferenceKey, le policy executor, désactivé. Cela peut être lié, mais nous ne le savons pas encore, et nous n'avons pas confirmé que cela arrive en production. Supprimer et redéployer a pris 12 secondes.
- Le testeur du panneau ne prend que du texte. Les photos, le son et la vidéo doivent passer par l'API pour l'instant.
Qui a fait quoi
EmbeddingGemma 2 est le travail de Google DeepMind : le modèle, les trois lecteurs, le tableau de benchmarks et la fiche du modèle qui met en garde contre float16. Ils l'ont entraîné avec la technique des poupées gigognes (Matryoshka Representation Learning, issue de recherches antérieures de Kusupati et ses collègues en 2022). L'article de lancement est signé Sahil Dua et Henrique Schechter Vera, ingénieurs de recherche chez Google DeepMind. Le modèle est construit sur Gemma 4, partage des parties avec lui (son découpeur de mots et son lecteur de sons), et vient de la même technologie que les modèles Gemini Embedding, d'après l'article. La bibliothèque transformers de Hugging Face, le code de référence pour faire tourner les modèles ouverts, l'a prise en charge à partir de la version 5.19.0. Sa compagne sentence-transformers est ce que la fiche du modèle utilise pour le faire tourner. PyAV, un lecteur vidéo et audio, a décodé nos clips et nos enregistrements. Les images de test viennent d'Iris-3B de Sperid Labs, les trois enregistrements de voix du modèle de synthèse vocale Pocket TTS, et l'outil vidéo ffmpeg a découpé les panoramiques.
Notre part : vérifier quels outils pouvaient le faire tourner, écrire le backend custom et l'exemple du SDK, le faire tourner sur InferenceKey, mesurer la vitesse et la mémoire, corriger les trois problèmes du backend et enregistrer la démo.
Ce qu'il faut retenir
Si vous voulez chercher à travers des documents, des photos, des enregistrements et des vidéos sur votre propre GPU, sous une licence qui vous laisse construire un produit dessus, EmbeddingGemma 2 mérite un test. Il a tourné sur un petit GPU de 16 GB avec l'essentiel de la mémoire en réserve, et le modèle a pris 36 ms sur une requête de recherche et environ un dixième de seconde sur une photo. Notre avis : l'argument pour le faire tourner sur votre propre GPU, c'est le contrôle et la confidentialité, pas le coût (nous n'avons pas comparé les prix). Des enregistrements d'appels, des photos de produits et des captures d'écran sont exactement le genre de fichiers que l'on préfère ne pas envoyer à l'API de quelqu'un d'autre pour les rendre cherchables. Ici, le modèle et les données restent sur une machine que vous choisissez, votre propre serveur ou un GPU que vous louez, et non une machine partagée avec un fournisseur d'API. Notre propre test a utilisé un pod loué. Prévoyez trois choses. Faites-le tourner en bfloat16 ou dans le format pleine taille (float32), jamais en float16. Si vous préparez des photos ou de la vidéo sur une machine louée, dites au logiciel combien de cœurs de processeur il a vraiment. Et gardez environ 10 GB de mémoire GPU libres si vous envoyez de longs documents en gros lots.
La vérification que nous n'avons pas faite, c'est celle contre laquelle la fiche du modèle met en garde. Ce test se limitait à servir le modèle de la façon sûre, donc un essai en float16 est notre prochain test, pas une partie de celui-ci : charger le modèle en float16 sur le même GPU, calculer les embeddings des mêmes douze fichiers et comparer la carte avec celle ci-dessus. Si la fiche du modèle a raison, rien ne plantera, et les listes de nombres pourront revenir vides de sens (NaN, "not a number", pas un nombre) ou discrètement faussées. Nous verrons si une case encadrée bouge.
Pour les ingénieurs
Modèle (fiche du modèle, article de lancement, documentation Google). Repo HF google/embeddinggemma-2, créé le 2026-09-14, modifié pour la dernière fois le 2026-10-06, sha 914f7f89142e33e77833254d9c9b90c3cef7303b, license:apache-2.0, non gated, 124 930 téléchargements et 2 122 likes quand nous l'avons récupéré le 2026-10-14. model.safetensors 1 488 915 288 octets (bf16).
Backbone texte : 24 couches, model dim 512, hidden dim 2048, 4 têtes, têtes KV local/global 2/1 (GQA/MQA), local:global 5:1, sliding window 1024, vocabulaire 262 144, FFN gated avec GELU, mean pooling, projection 512 -> 768. Contexte 8 192 tokens. Sortie 768, troncature MRL à 512/256/128 (renormaliser après la troncature, et les requêtes et les documents doivent utiliser la même dimension).
Chargement sélectif des encodeurs (sentence-transformers config_kwargs) :
| Chargement | config_kwargs | Paramètres |
|---|---|---|
| texte seul | {"vision_config": None, "audio_config": None} | 270M (nous en avons compté 271 002 624) |
| texte + image | {"audio_config": None} | 440M |
| texte + audio | {"vision_config": None} | 570M |
| complet | {} | 740M |
Coût en tokens dans la fenêtre partagée de 8 192 tokens : texte 1 par subword, image 280 par défaut (environ 29 images), vidéo 140 par image (environ 58 images, 1 fps par défaut), audio 25 par seconde (environ 327 s, mono 16 kHz). Le budget vision se configure de 70 à 1120 soft tokens, jusqu'à environ 114 images ou frames au plus bas. L'entrelacement utilise les placeholders <|image|>, <|video|>, <|audio|> et renvoie un seul embedding. Les entrées texte prennent des préfixes de tâche (task: search result | query: {query}, documents title: {title} | text: {content}, task: code retrieval | query: {query}), les médias n'en prennent aucun. Plus de 100 langues, données d'entraînement dans plus de 140 langues, date de coupure janvier 2025.
Benchmarks de la fiche du modèle (checkpoint pleine précision) :
| 768d | 512d | 256d | 128d | EmbeddingGemma 1 (768d) | |
|---|---|---|---|---|---|
| MTEB multilingual v2 | 61,36 | 61,17 | 60,41 | 57,89 | 61,15 |
| MTEB code v1 | 78,68 | 77,24 | 76,18 | 71,41 | 68,76 |
| MMEB v2 overall | 59,01 | 58,38 | 56,24 | 45,65 | |
| MSEB retrieval (MRR@10) | 69,54 | 69,18 | 66,76 | 56,71 |
Aussi à 768d : MIEB lite 64,64, MMEB v2 Image 57,28 (Hit@1), VisDoc 67,84 (NDCG@5), Video 50,67 (Hit@1), MAEB 49,39. La fiche du modèle décrit le gain en code comme environ 14 %, le blog comme +9,92 points, ce qui est le même changement (9,92 / 68,76).
Précision, mot pour mot dans la fiche du modèle : "Run inference in bfloat16 or float32. Do not use float16." et "In float16 the model returns NaN or silently degraded embeddings rather than raising an error, so the failure is easy to miss." bfloat16 là où il est pris en charge nativement, float32 ailleurs, y compris sur la plupart des CPU. Sélection suggérée : dtype = torch.bfloat16 if torch.cuda.is_bf16_supported() else torch.float32. Nous n'avons pas fait de comparaison en float16. Les chiffres de Google sur appareil (quantifié, Pixel 11 Pro) sont d'environ 191 MB de RAM en texte seul et d'environ 567 MB en complet. Aucune page de Google ne donne de chiffre de VRAM GPU.
Notre installation. RunPod NVIDIA RTX 2000 Ada Generation, cloud SECURE, EUR-IS-1, driver 570.195.03 (CUDA 12.8), 16 380 MiB, limite 70 W, compute capability 8.9, 8 vCPU annoncés, quota cgroup de 6,8 CPU avec 64 visibles, 0,24 USD/h. RTX A4000 COMMUNITY et SECURE et RTX 2000 Ada COMMUNITY ont répondu 409 faute de stock. Bootstrap du pod 66 s après l'appel de création. Manager InferenceKey local (jamais la production) joint via des tunnels HTTP et TCP, 71 ms de RTT jusqu'au pod. Backend : Python 3.12.3, torch 2.14.1+cu126 (la wheel CUDA 13 sur PyPI exige un driver 580+), transformers 5.19.0 (première version avec embedding_gemma2), sentence-transformers 6.1.0, av 19.0.1. Venv multimodal de 6,7 GB sur disque, venv texte seul de 89 MB, cache HF de 1,5 GB. Slugs des backends custom embeddinggemma2-multimodal et embeddinggemma2-text, task_type embedding, policy fixed. Versions publiées 0.1.0 (installation échouée), 0.1.1, 0.1.2 (limite de threads), 0.1.3 (libération du cache). Commit de l'exemple du SDK f18474c sur la branche main d'inferencekey-sdk. Les requêtes voyagent en un seul message avec une limite de 8 MB, donc envoyez les gros fichiers un par requête ou passez des URL.
Pourquoi un backend custom, et ce qu'il fait. vLLM 0.31.0 (2026-10-05) enregistre Gemma3TextModel (EmbeddingGemma 1) mais pas de EmbeddingGemma2Model, il ne peut donc pas servir ce modèle, même pour le texte. Les backends d'embedding intégrés d'InferenceKey (SGLang, Ollama, llama.cpp) ne prennent que du texte. L'article de lancement de Google cite vLLM, SGLang, Ollama, llama.cpp (GGUF) et d'autres comme outils pris en charge ; nous n'avons pas vérifié les builds plus récents de vLLM ni les chemins non texte des autres. Le backend charge SentenceTransformer("google/embeddinggemma-2") en bf16 quand torch.cuda.is_bf16_supported(), sinon en float32, jamais en float16. Les images sont décodées avec Pillow, l'audio et la vidéo avec PyAV (vidéo à 1 fps, 32 frames max ; audio 16 kHz mono). /v1/embeddings accepte la forme JSON d'OpenAI pour le texte ; les éléments peuvent aussi être des objets avec text, image, audio ou video (data URI, base64 ou URL), ce qui est notre extension, donc un client OpenAI standard ne peut envoyer que du texte. Autres champs : dimensions (768/512/256/128), prompt_name, encoding_format. Les réponses incluent usage et timings. Une entrée invalide renvoie 400 (vérifié avec dimensions: 300 et une image indécodable).
Temps de démarrage. À froid : de ensure() à prêt 78,3 s (venv + dépendances 49 s, téléchargement + chargement 28,6 s). Variante texte seul comme second workload sur le même pod : 19,7 s (chargement 5,3 s). La republication 0.1.1 -> 0.1.2 a recyclé à chaud le workload en cours en 13 s. Nouveau ensure() avec les poids en cache : 11,9 s.
Temps du modèle par requête (backend timings.encode_s, bf16, médianes. Avant = 64 threads, après = limité au quota cgroup) :
| Entrée | avant ms | après ms | aller-retour après s |
|---|---|---|---|
| 1 requête texte courte | 37 | 36 | 0,28 |
| 256 textes courts (4 242 tokens) | 213 | 204 | 1,02 |
| 32 docs d'environ 500 tokens (16 256 tokens) | 691 | 688 | 1,15 |
| 8 docs d'environ 6 000 tokens (48 064 tokens) | 4 411 | 4 416 | 5,73 |
| 8,6 s de voix | 163 | 158 | 0,50 |
| 1 image (JPEG de 768 px) | 531 | 111 | 0,38 |
| 8 images | 4 333 | 867 | 1,32 |
| vidéo de 6 s, 6 frames | 754 | 307 | 0,68 |
| enregistrement d'écran de 8 s, 8 frames | 910 | 422 | 0,85 |
| texte + 2 images + audio, un seul vecteur | 1 148 | 232 | 0,58 |
| 1 texte à 512 / 256 / 128 dims | 35 / 34 / 35 | 0,28 / 0,28 / 0,29 |
Débit : environ 23 600 tokens/s sur des docs de 500 tokens et environ 10 900 tokens/s sur des docs de 6 000 tokens. Les textes/s et images/s du récit sont notre division de ces médianes, pas des mesures séparées. dimensions change la taille de la réponse (5 550 / 2 883 / 1 559 octets à 512 / 256 / 128), pas la vitesse. Surcoût de la plateforme d'environ 0,25 s par requête sur notre chemin tunnelé. Le testeur du panneau a affiché 163 ms pour une requête de 15 tokens.
VRAM (torch.cuda.max_memory_allocated dans un processus séparé, plus nvidia-smi toutes les 0,5 s). Chargé : 1 432 MiB alloués (multimodal), 517 MiB (texte seul), 1 530 MiB sur le GPU juste après le chargement. Pics : 1 texte court 1 441 MiB, 1 image 1 515 MiB, 8 images 2 031 MiB, 32 docs x 500 tokens 3 344 MiB, un doc de 2 000 tokens 1 678 MiB, un doc de 6 000 tokens 2 152 MiB, un doc de 8 000 tokens 2 640 MiB. 8 docs x 6 000 tokens : le processus de service est monté à 11 610 MiB et les a gardés (cache de l'allocateur). Le même lot dans un troisième processus a fait un OOM avec 0,9 GB libres ("Tried to allocate 1.10 GiB"), il lui faut donc environ 10 GB. Avec torch.cuda.empty_cache() au-delà de 16 384 tokens, les deux processus de service étaient à 1 598 MiB et 678 MiB après le même lot. Puissance maximale 68,1 W.
Test de recherche (12 fichiers, un embedding par requête, six requêtes en anglais avec prompt_name: SearchQuery, GPU bf16) :
| Requête | Top-1 (score) | Deuxième (score) |
|---|---|---|
| an animal sleeping in the snow | video-fox.mp4 (0,7756) | img-fox.jpg (0,7662) |
| a bowl of noodle soup | img-ramen.jpg (0,7161) | bread-es.wav (0,6059) |
| a weather forecast with rain and wind | weather-en.wav (0,7847) | bread-es.wav (0,5824) |
| a goal in a football match | football-en.wav (0,7322) | img-poster.jpg (0,5849) |
| how to knead bread dough | bread-es.wav (0,6336) | video-fox.mp4 (0,5546) |
| a city street at night in the rain | img-city.jpg (0,7260) | video-city.mp4 (0,7183) |
Scores identiques sur deux exécutions (05:28 et 05:50 UTC). Vérification texte seul via embed() typé du SDK : la requête sur l'aurore boréale a obtenu 0,8229 face au bon passage et 0,5754 / 0,5147 / 0,4981 face aux autres. La matrice complète 6 x 12 de la heatmap a été recalculée ensuite avec le même backend sur CPU en float32 : les six mêmes gagnants, des scores à moins de 0,003 de l'exécution sur GPU.
Problèmes, en détail. (1) Le driver 570 du pod est trop ancien pour le torch CUDA 13 de PyPI (il faut 580+), donc requirements.txt ajoute l'index supplémentaire cu126 de PyTorch. SDK error [server_up]: bootstrap step failed, worker WARN worker::bootstrap: custom backend: uv pip install -r requirements.txt failed sans aucune sortie de uv. À la main : No solution found ... only requests==2.28.1 is available and you require requests>=2.31 ... uv will only consider versions that are published on the first index that contains a given package. L'index supplémentaire cu126 héberge aussi d'anciennes versions de requests, pillow et numpy. Correction : pas de versions minimales. Manque : le worker ne fait pas remonter le stderr de uv. (2) Profiler : 72 ms de CUDA par image contre 0,33 à 0,44 s de prétraitement CPU avec 64 threads sur un quota de 6,8 CPU. _cpu_quota() limite les threads de torch (surcharge par EG2_TORCH_THREADS) : une image 0,50 -> 0,10 s, 8 images 4,7 -> 0,86 s dans le profiler. Testé sur ce seul conteneur RunPod ; il lit le quota cgroup, donc les conteneurs sans quota ont besoin de EG2_TORCH_THREADS. (3) 11,6 GB conservés après un long lot, corrigé avec empty_cache() au-delà de 16 384 tokens. (4) wait_until_ready() après ensure() sur un workload qui servait déjà est resté sur "worker assigned; checking readiness" (plus de 10 min une fois, 90 s dans une reproduction) : le worker logue custom backend: driven by ProjectConfigSnapshot; skipping legacy LoadModel, et la vérification de disponibilité lit worker_leases, qui avait 0 ligne. Le manager local tournait avec POLICY_EXECUTOR_ENABLED=false, donc c'est une observation locale, pas un bug de production confirmé. (5) Le testeur d'embeddings du panneau est en texte seul. Aussi : un avertissement Hugging Face Hub non authentifié (pas de HF_TOKEN), et 3 des 4 choix de GPU ont répondu 409.
Limites.
- Un seul modèle de GPU, une seule machine, bfloat16 uniquement sur le GPU. Pas d'exécution en float16, pas d'exécution en float32 sur GPU, pas de GPU sans bfloat16 natif.
- Le jeu de recherche, ce sont 12 fichiers synthétiques à nous. Il montre le mécanisme, pas la qualité face à d'autres modèles.
- Les temps sont par requête, depuis un script de benchmark. Nous n'avons pas fait de test de charge avec de nombreux appelants simultanés.
- Les allers-retours incluent un tunnel depuis notre machine de développement jusqu'en Islande et ne sont pas représentatifs d'un déploiement installé au même endroit que ses utilisateurs.
- Nous n'avons vérifié que vLLM 0.31.0. Nous n'avons pas vérifié les builds plus récents de vLLM, ni si SGLang, Ollama ou llama.cpp (GGUF) servent les chemins image, vidéo et audio de ce modèle.
- Le blocage de
wait_until_ready()n'a été vu que sur une stack locale avec le policy executor désactivé.
Sources : fiche du modèle, article de lancement de Google, documentation Google AI for Developers, exemple du SDK.