Kandinsky 6.0 : de la vidéo ouverte avec le son, au prix de minutes par clip
Kandinsky 6.0 génère des clips de 5 s avec son synchronisé, sous MIT. Minutes par clip sur sept GPU, et pourquoi chaque run publié passe par l'offload.
Le 6 octobre, Kandinsky Lab a publié Kandinsky 6.0 en open source : deux modèles qui transforment une phrase (ou une phrase plus une image) en un clip vidéo de 5 secondes avec sa propre bande-son. Le son est généré en même temps que l'image, à 44 kHz (à peu près la qualité d'un CD audio), et les notes du projet disent qu'il inclut la synchronisation labiale : un personnage qui parle bouge la bouche avec les mots. Il y a un petit modèle, Lite, et un gros, Pro, environ dix fois plus grand (3B contre 29B paramètres, le chiffre qui mesure la taille d'un modèle). Un module à part agrandit le résultat jusqu'en Full HD.
Le code et les poids sont sous licence MIT, qui permet de construire sur le modèle, de vendre ce que vous faites avec et de le redistribuer. Une réserve : le téléchargement du Pro complet (non distillé) se trouve derrière un accès restreint de Hugging Face, accordé automatiquement, et nous n'avons pas pu en lire les conditions sans nous connecter. Nous n'avons pas passé en revue tous les autres modèles vidéo ouverts, donc nous ne prétendrons pas que c'est le premier ni le seul à produire image et son ensemble sous des conditions aussi souples. La release a moins d'une semaine et les poids sont à un téléchargement près.
Notre question de départ était combien de temps GPU coûte un clip. Le repo y répond avec un tableau de secondes par clip de 5 secondes sur sept GPU. La H100 et l'A100 sont des cartes de data center et la RTX PRO 6000 est une carte de station de travail professionnelle ; les RTX 5090, 5080, 4090 et 5060 Ti sont des cartes gaming qu'on peut acheter pour un PC de bureau.
Le tableau donne trois réglages, SD, HD et Full HD. Le repo ne dit pas ce qu'ils signifient (pour Pro, HD est même plus rapide que SD sur presque toutes les cartes), donc nous citons seulement les chiffres. Voici celui du milieu, HD, sur les sept cartes :
| GPU (mémoire) | Lite : un clip de 5 s | Pro : un clip de 5 s | Clips Pro par heure |
|---|---|---|---|
| H100 (80 GB) | 203 s, environ 3,4 min | 292 s, environ 4,9 min | environ 12 |
| RTX PRO 6000 (96 GB) | 274 s | 561 s, environ 9,4 min | environ 6,4 |
| RTX 5090 (32 GB) | 296 s | 638 s, environ 10,6 min | environ 5,6 |
| A100 (80 GB) | 472 s | 791 s, environ 13 min | environ 4,6 |
| RTX 5080 (16 GB) | 579 s | 1 189 s, environ 20 min | environ 3 |
| RTX 4090 (24 GB) | 422 s | 1 194 s, environ 20 min | environ 3 |
| RTX 5060 Ti (16 GB) | 1 328 s, environ 22 min | 2 716 s, environ 45 min | environ 1,3 |
Chiffres de Kandinsky Lab pour les modèles standard (pas les versions "distillées", plus rapides, expliquées plus bas), après un run de chauffe, sans compter le chargement du modèle ni l'écriture du fichier vidéo. Le repo ne dit pas si le temps de lecture du prompt est inclus.
Nous ne l'avons pas encore fait tourner nous-mêmes, et nous n'avons ni regardé ni jugé les clips. Chaque chiffre de cet article vient des repos et des model cards de Kandinsky Lab, ou d'une arithmétique simple dessus, et nous donnons le lien de chaque source.
Au mieux, une minute de GPU par seconde de vidéo
Commençons par le meilleur cas. Sur une H100, la carte la plus rapide du tableau, Pro produit un clip HD en 292 secondes. C'est près d'une minute de travail GPU pour chaque seconde de vidéo finie.
Imaginez maintenant une courte pub de 30 secondes, construite à partir de six clips séparés. Sur la H100, ça fait environ 29 minutes de génération. Sur une RTX 4090, une carte gaming haut de gamme, les mêmes six clips prennent environ deux heures. Sur la RTX 5060 Ti de 16 GB, un seul clip Pro prend environ 45 minutes en HD (2 716 s) et environ une heure en Full HD (3 530 s).
Lite est l'option la moins chère en temps GPU. Sur la RTX 5090, il produit un clip en environ 5 minutes, et sur la 4090 en environ 7. Pro coûte plus, et l'écart se creuse sur les cartes gaming. Sur une H100, il ajoute environ une minute et demie par clip par rapport à Lite (292 s contre 203 s). Sur une 4090, il prend presque trois fois plus de temps : environ 20 minutes contre 7.
Ce que ce temps en plus vous achète, nous ne pouvons pas vous le dire. Les repos et les model cards que nous avons lus ne disent pas en quoi les clips de Pro diffèrent de ceux de Lite, et nous ne les avons pas comparés. Les affirmations de qualité de Kandinsky Lab sont dans son rapport technique, que cet article n'évalue pas. Donc avant de payer 1,4 à 2,8 fois le temps GPU pour Pro, faites les mêmes quelques clips avec les deux et regardez.
Dans tous les cas, rien de tout ça n'est un outil interactif. Vous mettez le travail en file d'attente et vous revenez plus tard. Les instructions du repo pour le faire tourner comme service partagé vont dans le même sens : vous envoyez une demande de vidéo, vous recevez un numéro de ticket, vous vérifiez où elle en est jusqu'à ce qu'elle soit prête, puis vous téléchargez le fichier.
Pourquoi chaque run publié passe par l'offload
Regardez de nouveau le tableau : la RTX PRO 6000 de 96 GB met 561 secondes pour un clip Pro HD, et la H100 de 80 GB en met 292. La carte qui a le plus de mémoire met presque deux fois plus de temps. Pour lire ça, il faut savoir comment le modèle arrive sur la carte.
Un GPU a sa propre mémoire rapide, et normalement un modèle y est chargé en entier avant de commencer à travailler. Kandinsky 6.0 Pro rentre mal dans ce schéma. Ses fichiers font environ 90 GB au total, et la partie qui dessine fait à elle seule environ 70 GB. Une H100 a 80 GB.
Le repo utilise donc l'offload : le modèle complet reste dans la mémoire normale de l'ordinateur (la RAM), et les morceaux sont apportés au GPU quand on en a besoin. L'ordinateur lui-même a donc besoin d'assez de RAM pour garder ce qui n'est pas sur la carte ; le repo ne publie pas de minimum.
Le repo fournit deux façons de le faire. Sur les trois cartes à grosse mémoire (H100, A100, RTX PRO 6000), il apporte une section entière du modèle à la fois : la partie qui lit votre prompt, puis la partie qui dessine, puis les parties qui transforment le résultat en images et en son. Sur les cartes gaming, il apporte la partie qui dessine en petites tranches, deux sur le GPU pendant que la suivante est déjà en route.
Chaque réglage GPU fourni par le repo utilise l'une des deux, carte de 96 GB comprise. Aucun ne désactive l'offload, et les instructions du repo pour faire tourner Pro comme service partagé disent que l'offload "is required" (est obligatoire) sur un GPU de 80 GB. La RTX PRO 6000 n'utilise donc pas sa mémoire en plus pour garder le modèle entier sur la carte.
La H100 est la plus rapide ; le tableau ne peut pas dire exactement pourquoi
La réponse courte : la H100 est la carte la plus rapide du tableau, et le tableau ne permet pas de savoir ce qui revient à la puce et ce qui revient à la mémoire. N'achetez donc pas une carte avec plus de mémoire sur la foi de ce tableau : la carte de 96 GB perd face à la H100 de 80 GB (561 s contre 292 s), et aucun run du tableau ne garde jamais le modèle entier sur la carte.
Notre meilleure lecture, c'est que la puce de la H100 est tout simplement plus rapide, et que la mémoire en plus de la carte de 96 GB ne compense pas. C'est une déduction, pas une mesure. Chaque run du tableau utilise l'offload, donc rien ne montre le modèle installé en entier sur le GPU, et rien ne mesure combien de temps coûte le transport.
Les cartes diffèrent aussi par autre chose que la mémoire. Ce sont des puces différentes, et le repo n'apporte pas le modèle de la même façon sur les grosses cartes et sur les cartes gaming. La H100 utilise aussi un logiciel d'attention différent des autres cartes (FlashAttention 3 au lieu de SageAttention) à chaque passe du dessin, donc la comparaison ne se fait pas à armes égales.
Certaines paires pointent dans l'autre sens, vers une mémoire qui compte : la RTX PRO 6000 de 96 GB bat la RTX 5090 de 32 GB (561 s contre 638 s), et l'A100 de 80 GB bat la RTX 4090 de 24 GB (791 s contre 1 194 s). Ces paires diffèrent aussi par la puce et par la façon d'apporter le modèle, donc elles ne tranchent pas la question non plus.
Ce que changent les modèles distillés
Le choix par défaut du repo est un modèle qu'il n'a pas chronométré. Chaque réglage GPU prêt à l'emploi, et la démo publique en ligne, part d'un Pro distillé : une version entraînée pour finir un clip en 10 passes de nettoyage au lieu de 50. Le tableau de temps ne couvre que les modèles standard à 50 passes.
L'idée derrière les passes : ces modèles partent du bruit et le nettoient étape par étape. Lite a lui aussi une version distillée. Cinq fois moins de passes, ça sonne comme cinq fois plus rapide, mais nous ne le promettrions pas, parce que le repo ne publie aucun temps pour les modèles distillés. Le Pro distillé est aussi un peu plus petit sur disque, environ 81 GB au total au lieu de 90.
Le module Full HD
Rendre le clip net coûte peu à côté de le fabriquer. Le module de super-résolution est un modèle à part qui agrandit la vidéo et en redessine le détail. Sur une H100, sa version rapide (celle que Kandinsky Lab a chronométrée) double la taille d'un clip de 5 secondes en 41 secondes et la quadruple en 118, contre environ 3 à 7 minutes pour générer un clip sur la même carte (de 203 à 402 secondes selon le modèle et le réglage). (Le clip chronométré était un peu plus petit que ce que produisent les modèles de base, donc prenez ça comme un ordre de grandeur.)
Les modèles de base produisent du 864 par 480 pixels ; le module amène ça en Full HD. Il ne se contente pas d'étirer les pixels : il redessine le détail de chaque petit morceau de l'image.
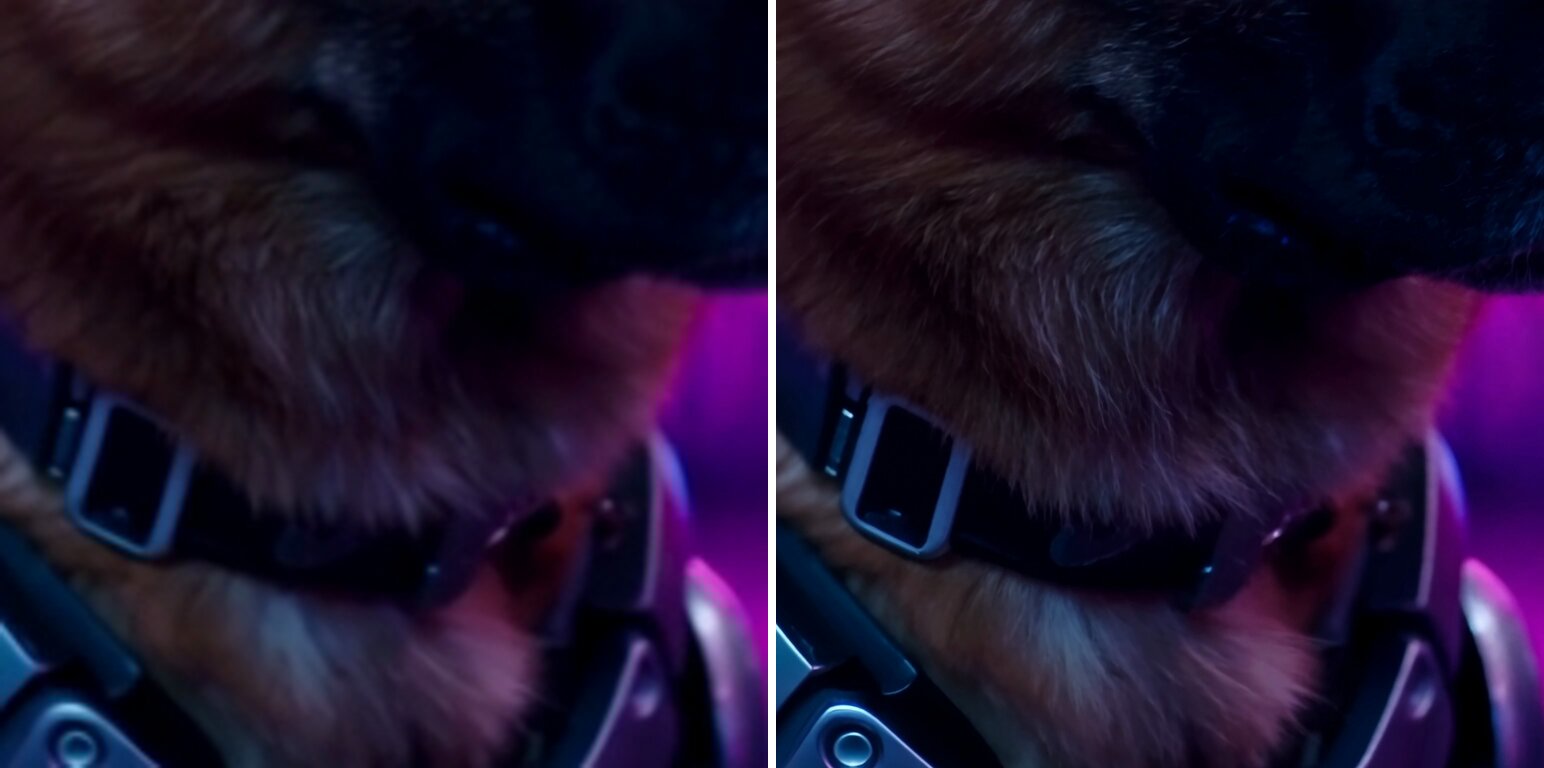
À gauche : agrandissement 4x ordinaire. À droite : 4x avec le modèle de super-résolution en 2 étapes. Recadrages tirés du repo kandinsky-6-sr, sur des clips générés par Kandinsky 6.0.
Il n'y a pas de temps publiés pour les cartes gaming ni pour la version lente. Un détail pratique : le module ne travaille que sur l'image. Le son doit être remis sur la vidéo agrandie à partir de la génération d'origine.
Qui a fait quoi
Tout ça, c'est le travail de Kandinsky Lab : les deux modèles vidéo, le modèle de super-résolution, les réglages GPU et le tableau de temps, avec un rapport technique derrière. Leurs modèles s'appuient aussi sur le travail ouvert d'autres équipes : un modèle de langage de l'équipe Qwen d'Alibaba lit le prompt, un composant dans le style de HunyuanVideo de Tencent transforme le résultat en images, et des pièces des projets MMAudio et BigVGAN le transforment en son.
Le jour de la sortie, les modèles fonctionnaient aussi dans cinq outils ouverts, de ComfyUI, qui se pilote à la souris, à des logiciels qui font tourner un modèle comme service partagé, comme vLLM-Omni et SGLang. Deux jours plus tard, le compte communautaire realrebelai a publié des versions compressées de Pro, entre environ 17 et 24 GB, pensées pour des cartes plus petites dans ComfyUI. Sa propre page les présente comme expérimentales et pas entièrement testées, et prévient que Pro "is still a very large model even after quantization" (reste un très gros modèle même après la quantization, la compression appliquée).
Notre part dans cet article est plus modeste : lire les repos, vérifier les tailles de fichiers et les configs, et faire l'arithmétique.
Ce qu'il faut retenir, et ce qui reste ouvert
Si vous voulez faire de courts clips avec du son sur votre propre matériel, sous une licence qui vous laisse construire sur le modèle et le redistribuer, Kandinsky 6.0 mérite un test. Nous avons lu des temps, des fichiers et des configs. Nous n'avons pas regardé les clips ni jugé leur qualité, donc cette partie-là, c'est à vous de la vérifier. Lite se télécharge sans rien signer et fait environ 28 GB, surtout le modèle qui lit le prompt. Pro vous demande d'abord d'accepter ses conditions sur Hugging Face, avec une approbation automatique ; nous n'avons pas pu lire ces conditions sans nous connecter.
Prévoyez-le comme une ferme de rendu, pas comme un chatbot. Choisissez la carte selon le nombre de clips par heure dont vous avez besoin : environ 12 clips Pro par heure sur une H100, environ 3 sur une RTX 4090. Ce sont les modèles standard sur une machine déjà chaude, sans le chargement ni l'écriture du fichier, donc votre débit réel sera plus bas, d'une quantité que le repo ne publie pas, et le modèle distillé par défaut peut le changer.
Le vrai trou, ce sont les modèles distillés : c'est ce que le repo utilise par défaut, et Kandinsky Lab n'a pas publié combien de temps ils prennent. Pour le découvrir, il faut une RTX 5090, l'étape d'installation du repo (just setup) et un téléchargement de 81 GB (just download pro-distill). Ensuite :
cp kandinsky/configs/devices/rtx-5090.yaml my-5090.yaml
printf 'profile:\n  mode: time_mem_module\n' >> my-5090.yaml
just generate "a cat on a mat" --config my-5090.yaml --warmup --out clip.mp4
La commande génère le clip une fois pour chauffer, puis chronomètre un second run, à peu près comme le tableau a été mesuré. En quoi cette mesure diffère de celle du tableau, c'est expliqué dans la section pour les ingénieurs ci-dessous.
Pour les ingénieurs
Modèles et fichiers (tailles de l'API Hugging Face, interrogée le 2026-10-12, toutes les model cards déclarent license: mit) :
| Repo | Total | Transformer | Notes |
|---|---|---|---|
| Kandinsky-6.0-Pro-5s-Diffusers | 90,04 GB | 69,7 GB | gated, approbation automatique |
| Kandinsky-6.0-Pro-distill-5s-Diffusers | 80,65 GB | 60,3 GB | ~30,14B paramètres dans l'en-tête safetensors (30,107B BF16 + 0,033B F32) |
| Kandinsky-6.0-Pro-pretrain-5s-Diffusers | 90,04 GB | 69,7 GB | |
| Kandinsky-6.0-Lite-5s-Diffusers | 27,78 GB | 7,48 GB | ~3,18B paramètres (2,615B BF16 + 0,561B F32), pas gated |
| Kandinsky-6.0-Lite-distill-5s-Diffusers | 26,68 GB | 6,38 GB | pas gated |
| Kandinsky-6.0-VSR-5s-Diffusers | 17,46 GB | 4 étapes par tuile | |
| Kandinsky-6.0-VSR-distilled2steps-5s-Diffusers | 17,46 GB | distillé π-Flow, 2 évaluations par tuile |
Composants partagés de Pro : encodeur de texte Qwen2.5-VL ~16,58 GB (5 shards, utilisé aussi pour l'expansion du prompt), VAE audio 1,71 GB, VAE vidéo 0,99 GB, CLIP 0,49 GB, vocoder 0,49 GB. Pourquoi le transformer de Pro fait 69,7 GB alors que celui de Pro-distill fait 60,3 GB pour des nombres de paramètres nominalement proches, les sources ne l'expliquent pas (l'en-tête de Pro, qui est gated, n'a pas pu être lu).
Licences. Code de kandinsky-6 : MIT. kandinsky-6-sr : MIT, avec ses templates d'export Diffusers qui gardent des mentions Apache-2.0 (LICENSE-APACHE). Poids : MIT sur chaque model card. Pro (non distillé) est derrière un gate Hugging Face à approbation automatique.
Architecture. Lite : model_dim 1792, 32 blocs visuels, 2 blocs texte, ff_dim 7168. Pro : model_dim 4096, 60 blocs visuels, 4 blocs texte, ff_dim 16384. Pipeline Kandinsky6TI2VAPipeline : Kandinsky6Transformer3DModel, AutoencoderKLHunyuanVideo, Qwen2_5_VLForConditionalGeneration, CLIPTextModel (pooled), MMAudioVAE, MMAudioVocoder (style BigVGAN), FlowMatchEulerDiscreteScheduler (shift 5.0). Crédits amont : Qwen2.5-VL (équipe Qwen d'Alibaba), CLIP (OpenAI), conception du VAE HunyuanVideo (Tencent), MMAudio, BigVGAN (NVIDIA), la méthode de distillation π-Flow derrière les checkpoints distillés, FlashAttention 3 (Tri Dao et ses co-auteurs) et SageAttention (le groupe thu-ml de Tsinghua).
Réglages de génération (kandinsky/configs/checkpoints/*.yaml) : pro, lite et pretrain : 864x480, 121 frames, 50 steps, guidance 5,0. pro-distill et lite-distill : 10 steps, guidance 1,0, PiflowScheduler (n_grid 10, 128 sous-étapes de policy). Scaling du VAE audio 0,5302 (pro/lite) ou 0,417 (distill, pretrain). La section vLLM-Omni dit que Pro est par défaut à 125 frames à 24 fps, alors que les configs natives et l'exemple Diffusers utilisent 121.
Tableau de temps complet (README, Performance). Secondes par clip de 5 s, non distillé, après warmup, chargement des poids et encodage MP4 exclus. Offload par module sur RTX PRO 6000, A100, H100. Offload par bloc sur les cartes grand public. SageAttention2++ pour la self-attention visuelle partout sauf sur H100 (FlashAttention 3).
| RTX 4090 | RTX 5060 Ti | RTX 5080 | RTX 5090 | RTX PRO 6000 | A100 80 GB | H100 | |
|---|---|---|---|---|---|---|---|
| Lite SD | 437 | 1310 | 577 | 309 | 242 | 532 | 239 |
| Lite HD | 422 | 1328 | 579 | 296 | 274 | 472 | 203 |
| Lite Full HD | 578 | 1774 | 770 | 406 | 387 | 664 | 284 |
| Pro SD | 936 | 3080 | 1336 | 754 | 621 | 972 | 356 |
| Pro HD | 1194 | 2716 | 1189 | 638 | 561 | 791 | 292 |
| Pro Full HD | 1247 | 3530 | 1546 | 854 | 765 | 1106 | 402 |
Bizarreries à connaître : Pro HD sur la 4090 (1194 s) est plus lent que sur la 5080 (1189 s). Pour Pro, SD est plus lent que HD sur toutes les cartes sauf la 4090 (H100 : 356 contre 292), et Lite HD bat Lite SD sur la 4090, la 5090, l'A100 et la H100. Le README ne définit pas comment les lignes SD, HD et Full HD sont produites, donc je ne les interprète pas. Le tableau fait varier en même temps la puce, le kernel d'attention et le mode d'offload, et n'a aucune base sans offload, donc il ne peut pas isoler le coût de l'offload de la vitesse de calcul.
L'offload dans le code (kandinsky/runtime/offload/). module : les modules enregistrés restent sur le CPU, un groupe résident à la fois sur CUDA, H2D/D2H asynchrone. block : par bloc DiT (Pro a 60 blocs visuels, et rien n'indique si les 4 blocs texte sont gérés de la même façon), deux résidents, le suivant préchargé sur un stream de transfert, exige de la mémoire pinned, refuse les sous-classes de paramètres quantizés et le dit_export AOTI. OffloadConfig vaut none par défaut et la CLI accepte --offload none|module|block, mais chaque preset fourni règle module (rtx-pro-6000, a100-80gb, h100) ou block (rtx-4090, rtx-5090, rtx-5080, rtx-5060-ti). Les presets 5060 Ti et 5080 chargent aussi l'encodeur de texte Qwen en NF4 via bitsandbytes. Le pic de VRAM par GPU n'est pas publié.
Le faire tourner. En natif : Python 3.13 ou 3.14, GPU NVIDIA, just setup (PyTorch pour CUDA 13.0, FlashAttention 3 sur Hopper, SageAttention 2.2.0 compilé avec nvcc sur Ampere, Ada et Blackwell grand public, donc nvcc doit être dans le PATH, CUDA_HOME vaut /usr/local/cuda par défaut), just download pro-distill (environ 81 GB dans $KANDINSKY_HOME/weights, par défaut ~/.cache/kandinsky), just generate "..." [--config ...] [--out ...]. La config par défaut est h100.yaml. --warmup lance un run sans sauvegarder, puis relance et sauvegarde ; c'est ce second run qui est profilé quand le profilage est actif. Le profilage est désactivé par défaut (ProfileConfig.mode = "none", aucun preset fourni ne l'active) : ajoutez profile: {mode: time_mem_module} à une copie du preset, comme dans l'extrait plus haut. Le JSON arrive dans $KANDINSKY_HOME/profile/time_mem_module/ avec --out, ou dans <run>/profiles/ sans. Le profil englobe tout l'appel du pipeline, qui écrit aussi le MP4 et multiplexe l'audio quand une destination est donnée, et inclut l'expansion du prompt qwen25 par défaut. Son total_time compte donc un encodage que le tableau du README exclut : comparez plutôt les temps par module (DiT, VAE, VAE audio, vocoder) pour être plus proche. Autres flags : --sr, --no-audio, --image, --steps, --guidance, --magcache/--navicache.
vLLM-Omni demande vLLM 0.31.0 plus vLLM-Omni compilé depuis les sources, sous Python 3.12, dans un environnement séparé. L'exemple ci-dessous tire le repo Pro, qui est gated : acceptez d'abord ses conditions sur Hugging Face et authentifiez-vous avec un token HF :
vllm serve kandinskylab/Kandinsky-6.0-Pro-5s-Diffusers --omni \
  --host 127.0.0.1 --port 8091 --num-gpus 1 --enable-cpu-offload
# POST /v1/videos (prompt, size=864x480, num_frames=125, num_inference_steps=50, seed)
# GET /v1/videos/$VID until done, then GET /v1/videos/$VID/content
Diffusers : Kandinsky6TI2VAPipeline.from_pretrained(..., torch_dtype=torch.bfloat16) plus pipe.enable_model_cpu_offload(). sample_audio=False donne la vidéo seule, expand_prompts=True laisse Qwen2.5-VL réécrire le prompt (ajoute de la latence). Intégrations du jour de sortie listées dans le README : Diffusers, ComfyUI, vLLM-Omni, SGLang et FastVideo.
Super-résolution (kandinsky-6-sr). Kandinsky6SRPipeline, x2, x2.25 (par défaut : x1.125 bilinéaire puis le chemin x2) ou x4, diffusion par tuiles dans l'espace latent K-VAE avec un mélange par fenêtre de Hann, recouvrement 0,20, tiles_batch_size à 1 par défaut. Une source 480x864 en x2.25 donne 1088x1952. Pour redimensionner ça, réglez target_resolution (niveaux hd, fullhd, 2k ; chaque niveau contient une taille paysage 16:9, une carrée et une portrait 9:16, et celle dont le ratio est le plus proche est choisie, par exemple fullhd paysage 1080x1920). Le redimensionnement ne recadre jamais. Avec le target_resize_mode: fit par défaut, les deux côtés sont mis à l'échelle par un seul facteur, min(1080/1088, 1920/1952), donc fullhd donne 1070x1920 (1920 de large, 1070 de haut). Obtenir exactement 1080x1920 demande en plus target_resize_mode: exact, qui autorise un léger écrasement anisotrope. Composants : SR DiT 1,41B, SR VAE 1,74B, banque d'upscalers latents 3,65B. Exige torch._inductor.config.max_autotune = True et le backend flex attention. Contrat : 24 fps, 121 frames au maximum. Images seulement, remultiplexez l'audio vous-même. Temps sur H100, modèle en 2 étapes, entrée 768x512, torch 2.10.0+cu128, warmup et IO exclus : x2 (9 tuiles) 41 s, x4 (25 tuiles) 118 s.
Quants de la communauté (realrebelai/Kandinsky-6.0-Pro-5s_GGUFs, MIT, créé le 2026-10-08, "Experimental / Not Fully Tested") : Pro Q3_K_S 20,35 GB, Pro Q4_K_S 23,73 GB, Pro W4A8 17,13 GB, Pro-distill W4A8 17,13 GB, encodeur Qwen2.5-VL-7B W4A8 5,58 GB. GGUF demande deux forks ComfyUI de RebelAI, W4A8 utilise les nœuds officiels. La card suggère 240x240 et 21 frames pour les premiers tests, et prévient qu'un run peut finir la diffusion puis échouer au décodage audio si les fichiers MMAudio et BigVGAN 44 kHz manquent.
Limites.
- Nous n'avons pas fait tourner Kandinsky 6.0 et nous n'avons ni regardé ni jugé ce qu'il produit. Chaque temps est celui de Kandinsky Lab, dans leur configuration.
- Le tableau porte sur les modèles non distillés alors que chaque preset utilise
pro-distillpar défaut. La config exacte derrière le tableau (override de checkpoint, steps, frames) n'est pas publiée. - Rien n'indique si le tableau inclut l'expansion du prompt et l'encodage du texte, ou seulement le débruitage et le décodage.
- Il n'existe aucun temps pour les checkpoints distillés, pour le VSR en 4 étapes, ni pour le VSR sur cartes grand public.
- Chaque run publié utilise l'offload, donc ni le coût de l'offload ni la vitesse sans lui ne sont mesurés. Toute affirmation sur la mémoire contre le calcul tirée de ce tableau est une déduction.
- "Offload is required on 80 GB" est affirmé pour vLLM-Omni. Pour le pipeline natif, les presets utilisent l'offload sur chaque carte, mais le repo ne dit pas que s'en passer est impossible.
- Les affirmations de qualité (précision de la synchronisation labiale, scores de benchmark) sont dans le rapport technique, que cet article n'évalue pas.
Sources : kandinsky-6, kandinsky-6-sr, model cards de Pro, Lite et VSR, GGUFs de la communauté.