Iris-3B : un modèle d'image ouvert qui dessine ses propres pixels, en deux secondes environ par image
Iris-3B, modèle d'image ouvert, dessine lui-même ses pixels. Nous avons lancé sa version rapide Turbo sur InferenceKey : environ 2 s par image sur une A40.
Le 5 octobre, Sperid Labs a publié Iris-3B sur Hugging Face et sur GitHub, un modèle d'image ouvert qui dessine lui-même chaque pixel de l'image. Les modèles auxquels il se compare, dont FLUX et Qwen-Image, ne le font pas : ils esquissent une version compressée, puis un décodeur à part la transforme en pixels.
Leur article scientifique construit aussi deux outils supplémentaires sur le modèle, l'un qui estime la profondeur et l'autre qui restaure les photos, et son résumé dit que travailler en pixels n'a apporté de gain net ni pour l'un ni pour l'autre.
Le 12 octobre, ils ont ajouté une version rapide, "Turbo", qui termine une image en 4 passes au lieu de 100 (ces modèles partent d'un bruit aléatoire et le nettoient un peu à chaque passe). Nous l'avons repérée dans la vidéo d'actualité d'AI Search du 11 octobre, nous avons lu les sources et fait tourner Turbo nous-mêmes sur un GPU loué, servi via InferenceKey. Voici ce qu'il faut retenir avant d'entrer dans les détails :
| Iris-3B Turbo | |
|---|---|
| Licence | Apache-2.0 pour le code et les poids : vous pouvez l'utiliser commercialement, le modifier et le redistribuer |
| Taille | 3 milliards de paramètres (les nombres appris à l'intérieur du modèle, une mesure approximative de sa taille), plus un modèle de 4 milliards de paramètres qui lit le prompt |
| Téléchargement nécessaire | environ 6 GB pour Turbo, plus environ 9 GB pour le lecteur de prompt. Pas tout le repo de 42 GB |
| Mémoire GPU, mesurée | environ 21 GB une fois chargé, environ 23 GB au pic : juste sous une carte gaming de 24 GB (non testé), à l'aise sur la carte de 48 GB que nous avons utilisée |
| Temps par image 1024x1024, mesuré sur une NVIDIA A40 | 1,96 s sur le GPU, environ 2,9 s de bout en bout via l'API |
| Même image avec le modèle de base à 100 passes | environ 90 s |
| Premier démarrage, du "deploy" à prêt pour la première image (machine GPU déjà en ligne) | environ 2 minutes (130 s) |
| Ses faiblesses dans notre test | un menu avec quatre prix, des mains en trop sur un pianiste, un chat qui n'est pas apparu |
Voici pourquoi ça m'intéresse. La façon habituelle de mettre des images générées dans un produit, c'est une API hébergée qui facture à l'image. Un modèle Apache-2.0 aussi petit, vous pouvez le faire tourner vous-même sur un GPU loué : vous gardez les poids, vous choisissez quand la version change, vous savez où vont les prompts et les images, et vous payez le temps de la carte au lieu de payer à l'image. Ce n'est pas le meilleur modèle d'image ouvert en qualité, et nous disons plus bas où il pèche, mais c'est une vraie option si vous voulez posséder le modèle plutôt que louer des images à quelqu'un d'autre.
La plupart des modèles d'image travaillent sur un MP3 de l'image
La recette habituelle est la suivante. Un petit réseau auxiliaire comprime chaque image en un code compact, un peu comme un MP3 comprime un enregistrement. Le gros modèle apprend à dessiner dans ce code, ce qui coûte bien moins cher que de dessiner chaque pixel, et l'auxiliaire redéploie le résultat en image complète à la fin. Appelons-les modèles à image compressée : ce sont ceux auxquels Sperid Labs compare Iris.
La page de recherche de Sperid Labs plaide contre le MP3. La compression perd du détail, écrivent-ils, et le code compressé est "biased" (biaisé) et "texture-focused" (centré sur la texture) : il est réglé sur l'aspect des surfaces plus que sur le détail exact. Leur cible, ce sont les tâches où le détail fin compte, comme estimer la profondeur à partir d'une photo ou restaurer une photo en basse résolution. Iris-3B se passe donc du MP3 et travaille sur le master : il découpe l'image en tuiles de 16 par 16 pixels, travaille directement sur ces tuiles, et un petit étage final retransforme chaque tuile en vrais pixels. Les auteurs ont emprunté la conception de cette dernière étape à un autre groupe de recherche (crédité plus bas). Il n'y a ni décodeur séparé ni espace compressé.
Le prompt est lu par un modèle séparé, Qwen3-VL-4B-Instruct, de l'équipe Qwen d'Alibaba, lui aussi sous Apache-2.0, qu'Iris télécharge à sa première exécution.
Le verdict des auteurs eux-mêmes : pas de gain net grâce aux pixels
Le résumé de l'article énonce sa conclusion sans détour : "We find no significant improvement from using a pixel-space generative prior." (nous ne constatons aucune amélioration significative en utilisant un a priori génératif dans l'espace des pixels). Autrement dit : construire les outils de profondeur et de restauration de photos sur un modèle en pixels ne les a pas rendus meilleurs que les construire sur un modèle à image compressée. Ils l'ont testé sur deux tâches face à FLUX.2 Klein, un modèle à image compressée de taille comparable (4 milliards de paramètres). Sur la profondeur, les deux sont à égalité. Sur l'agrandissement de photos par 4, Iris-3B n'a pas battu FLUX.2 Klein.
Pour la simple création d'images, l'article dit qu'Iris-3B obtient le même score que Qwen-Image, un modèle environ sept fois plus gros (20 milliards de paramètres), sur un test général qui mesure à quel point les images suivent leur prompt (OneIG dans le tableau ci-dessous). L'autre colonne, LongText, mesure la capacité du modèle à écrire une phrase ou plus dans l'image.
| Modèle | LongText (EN) | OneIG (EN) |
|---|---|---|
| Iris-3B (base) | 0,857 | 0,540 |
| Iris-3B Turbo | 0,804 | 0,516 |
| Qwen-Image (20B) | 0,943 | 0,539 |
| Z-Image (6B, réécriture du prompt) | 0,935 | 0,546 |
| FLUX.1-dev (12B) | 0,607 | 0,434 |
Les scores vont de 0 à 1, plus c'est haut, mieux c'est. "Réécriture du prompt" : le score de Z-Image a été mesuré après qu'un assistant a réécrit chaque prompt plus en détail, ce qui l'avantage. Les lignes Iris ont été mesurées par Sperid Labs. Les autres sont citées sur leur page de recherche à partir des rapports de Qwen-Image et de Z-Image. Nous n'en avons rien reproduit. D'autres lignes et deux colonnes de plus se trouvent dans la section pour les ingénieurs.
Regardez la colonne LongText : Iris-3B obtient 0,857 là où Qwen-Image obtient 0,943. Iris-3B est nettement derrière Qwen-Image et Z-Image sur ce point, et Turbo est un peu derrière son propre modèle de base. Cela colle avec ce que nous avons vu sur un menu avec des prix, plus bas. Le testeur d'AI Search l'a dit plus franchement : une qualité "not as good as the leading open models out there" (pas aussi bonne que celle des meilleurs modèles ouverts du moment), mais "a decent lightweight alternative" (une alternative légère correcte). Nous n'avons pas fait tourner de modèle à image compressée sur les mêmes prompts, donc cette comparaison de qualité repose sur les tableaux de l'éditeur et l'avis d'un testeur, pas sur nos images.
Un réseau, trois métiers
Le même réseau Iris, un peu réentraîné pour chaque tâche, est aussi livré sous la forme de deux autres outils dans le même téléchargement. L'un estime la profondeur à partir d'une seule photo (à quelle distance se trouve chaque point par rapport aux autres, pas en mètres). L'autre, un agrandisseur de photos, agrandit une photo 4 fois et en restaure le détail, tuile par tuile. Les deux tournent en une seule passe, sans prompt ni modèle de texte. Sperid Labs publie des scores pour les deux sur des jeux de test standard, repris dans la section pour les ingénieurs. Nous n'avons testé ni l'un ni l'autre.
Turbo : quatre passes au lieu de cent
L'Iris-3B de base utilise 100 passes, et chaque passe exécute le modèle deux fois (une fois avec votre prompt et une fois sans, pour pouvoir pousser l'image vers le prompt), ce qui le ralentit encore. Turbo, c'est le modèle entier réentraîné pour finir en 4 passes d'une seule exécution chacune. Sperid Labs dit que Turbo produit une image 1024x1024 en environ 0,7 seconde sur une H100, le GPU de data center haut de gamme de Nvidia, quand il en génère quatre à la fois. Nous n'avons pas testé cette carte. La contrepartie, selon leur propre liste de limites : Turbo est moins bon que le modèle de base sur le texte dense ou long, donne moins de variété quand on demande plusieurs fois le même prompt, et peut laisser un léger grain sur les fonds unis.
Sperid Labs n'a pas été le premier à rendre Iris rapide. Leur propre fiche de modèle remercie pentacoxian-dev, qui a construit iris-3b-turbo-lora, une version à 4 passes empaquetée sous forme d'un petit module complémentaire de 460 MB et entraînée sur un seul GPU grand public. Elle a sa propre ligne dans le tableau de benchmarks de la fiche de modèle de Sperid Labs. Nous avons fait tourner le Turbo de Sperid Labs, pas celui-ci.
Le piège des 42 GB
Si vous clonez le repo Hugging Face, vous récupérez quatre modèles : le modèle de base (environ 12 GB), Turbo (environ 6 GB), le modèle de profondeur (environ 12 GB) et l'agrandisseur de photos (environ 12 GB). Soit 41,9 GB au total. Pour générer des images rapidement, il vous faut seulement Turbo :
hf download speridlabs/iris-3b --include "turbo/*" --local-dir iris-3b
Le lecteur de prompt, Qwen3-VL-4B-Instruct, vient en plus : encore 8,88 GB, récupérés automatiquement la première fois que le code tourne.
Le faire tourner sur InferenceKey
Turbo servait des images via l'API InferenceKey environ deux minutes après l'appel de déploiement (sur une machine GPU déjà en ligne), à environ 2 secondes de GPU par image 1024x1024. Voici comment, et ce qui a coincé en chemin.
Le GPU et pourquoi celui-là
Nous avons loué une NVIDIA A40 avec 48 GB de mémoire sur RunPod, dans un data center de l'UE. Le choix évident pour un modèle "3B" serait une carte gaming de 24 GB moins chère, comme une RTX 4090. Nous l'avons écartée à cause de la façon dont le code des auteurs charge le modèle : il stocke chaque nombre du réseau de 3B au double de la taille dans laquelle le fichier est livré, ce qui prend environ 12 GB, et le lecteur de prompt ajoute environ 8 GB de plus. Turbo seul a mesuré environ 21 GB une fois chargé et environ 23 GB au pic. Nous n'avons pas essayé de carte de 24 GB, donc la question de savoir si Turbo y tient en pratique reste ouverte. La carte de 48 GB nous a aussi permis de charger le modèle de base à 100 passes à côté de Turbo pour une comparaison côte à côte.
Pour vos propres calculs : au prix catalogue de l'A40 sur RunPod, mille images Turbo générées quatre par quatre représentent environ 29 minutes de carte, soit à peu près 30 cents de dollar, sans compter le démarrage ni le temps d'inactivité. Vous payez le temps de la carte au lieu de payer à l'image, et c'est vous qui choisissez le modèle, pas un fournisseur.
Pourquoi un backend custom
Un backend, c'est le bout de code qui charge un modèle une fois puis répond aux requêtes. InferenceKey fournit des backends prêts à l'emploi pour les formats habituels des modèles d'image et de texte, mais Iris-3B arrive dans son propre format, donc aucun d'eux ne peut le faire tourner. Nous avons donc écrit le nôtre en Python, ce qu'InferenceKey permet d'apporter. Le nôtre fait environ 5 KB, sans aucun poids dedans. Au démarrage, il télécharge une version figée du code des auteurs, récupère uniquement le dossier Turbo sur Hugging Face et charge le modèle comme le font les auteurs. Il répond au même format de requête /v1/images/generations que l'API d'images d'OpenAI, donc n'importe quel client qui parle ce format peut l'appeler.
Nous l'avons fait tourner sur une copie de test privée d'InferenceKey, avec le GPU loué qui s'y reconnecte, donc rien de tout ça n'a touché notre service de production. Le nom d'entreprise que vous voyez dans la vidéo, Lumenframe Studio, est un compte de démo inventé.
Les étapes
Tout est dans l'exemple du SDK iris3b-text2image-custom-backend-private-nvidia. Il vous faut un compte InferenceKey avec un worker NVIDIA (une machine GPU connectée à votre projet). Le fichier .env de l'exemple liste les clés qu'il lit. Vous pouvez aussi téléverser le backend à la main dans le dashboard. Le SDK se compile en local depuis le repo, donc les étapes d'installation du README passent en premier :
cp .env.example .env        # SDK token, API key, project, worker id, tenant id, dashboard session token
python -m venv .venv && . .venv/bin/activate
pip install maturin requests
( cd ../../bindings/python && maturin develop --release )
python publish.py           # packages backend.py and registers it as "iris3b-text2image"
python main.py              # deploy, wait until ready, generate two images, clean up
main.py demande à InferenceKey une copie du modèle toujours active sur votre worker, attend qu'elle serve, envoie les requêtes pour deux images, enregistre les PNG et supprime le modèle en cours d'exécution (le workload) en sortant (mettez IK_KEEP_ALIVE=1 pour le garder). Pour le modèle de base à 100 passes, python publish.py --variant base puis IRIS_VARIANT=base python main.py. Voici le même format de requête que nous avons envoyé à notre copie locale d'InferenceKey, avec le prompt et la seed de l'abeille des images plus bas. Sur le service hébergé, il a le même format, même si nous ne l'y avons pas appelé :
curl https://cloud.inferencekey.com/endpoint/$INFERENCEKEY_PROJECT/iris3b-turbo/v1/images/generations \
  -H "Authorization: Bearer $INFERENCEKEY_API_KEY" -H "Content-Type: application/json" \
  -d '{"model": "default", "prompt": "Macro photograph of a honeybee covered in pollen on a lavender flower, shallow depth of field", "size": "1024x1024", "seed": 110, "n": 1}'
Ce que nous avons mesuré
Le premier démarrage a pris 130 secondes entre l'appel de déploiement et l'état prêt. La préparation de l'environnement Python a pris 16 secondes et le téléchargement du fichier de modèle de 6 GB de Turbo, 12. L'essentiel du reste, c'était le lecteur de prompt : environ 72 secondes pour le télécharger, puis environ 27 secondes pour charger les deux modèles sur le GPU.
Une fois lancé, une image 1024x1024 a pris 1,96 seconde sur le GPU à chaque fois, et 2,8 à 2,9 secondes entre la requête et le PNG terminé revenu chez l'appelant. Des tailles plus grandes et non carrées, comme 1344x896, ont pris 2,2 à 2,9 secondes de GPU. Quatre images en une requête ont pris 7,0 secondes, soit 1,75 seconde chacune. L'éditeur annonce 0,7 seconde par image sur une H100. Nous n'avons pas fait ce test à conditions égales. Le testeur d'images du panneau InferenceKey affichait 2,9 secondes par image.
Le modèle de base, avec ses 100 passes, a pris environ 90 secondes par image 1024x1024 et 106 en 1344x896. C'est environ 46 fois plus lent que Turbo. Avec les deux chargés sur la même carte, ils ont utilisé presque tous ses 48 GB au pic.
Les images
Turbo s'en est bien sorti sur les photos, les styles et le texte court. Elles sortent telles quelles de l'API, 4 passes chacune :
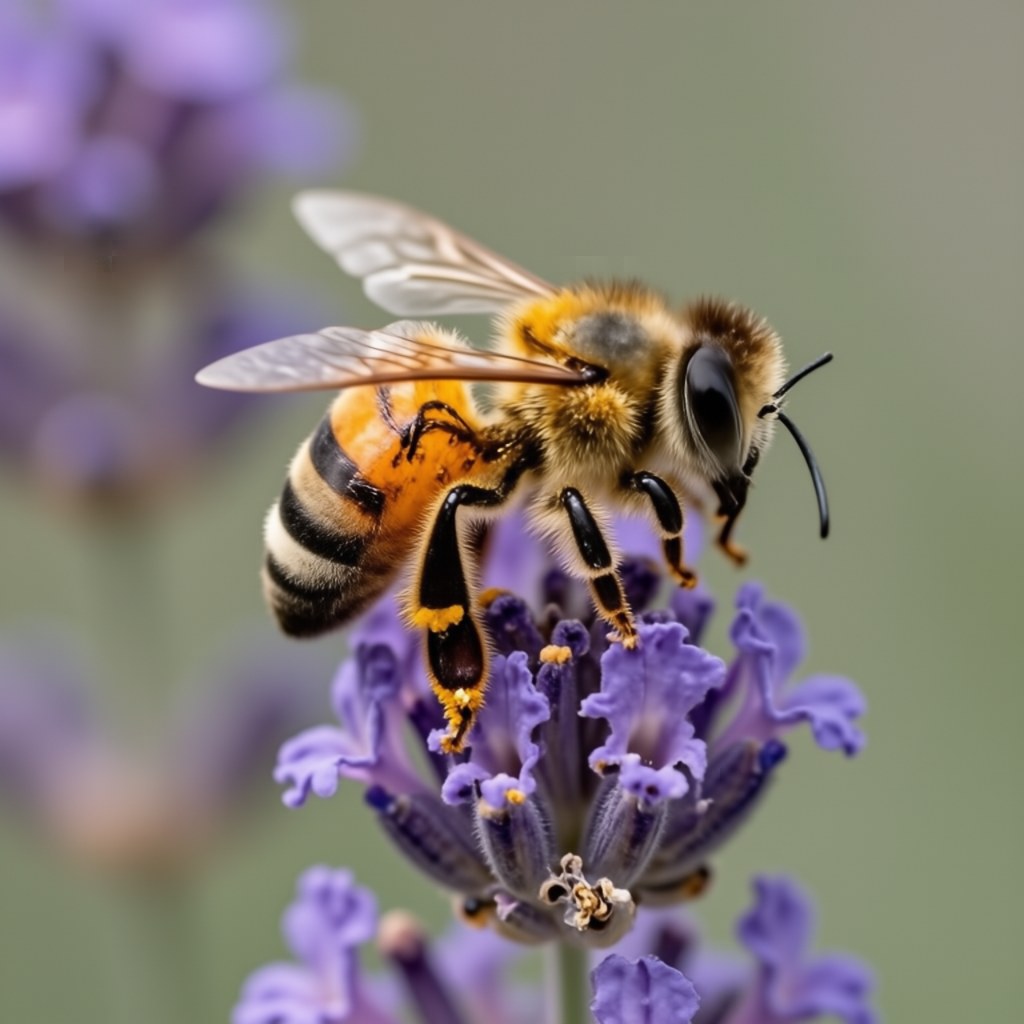
"Macro photograph of a honeybee covered in pollen on a lavender flower, shallow depth of field" (photo macro d'une abeille couverte de pollen sur une fleur de lavande, faible profondeur de champ). 1024x1024, 1,96 s sur le GPU.
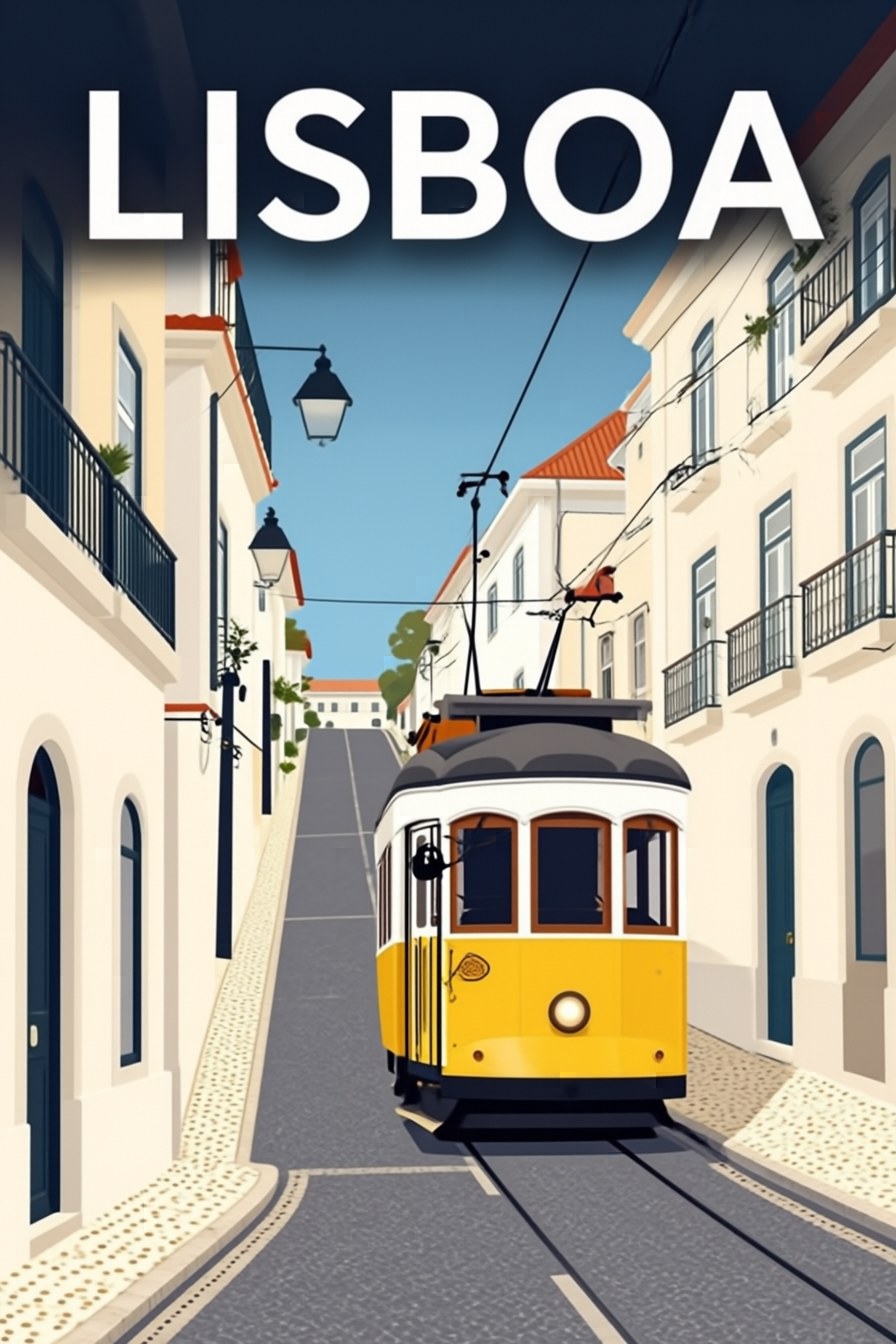
Une affiche de voyage en vectoriel plat. Le mot LISBOA est sorti sans faute. 896x1344, 2,65 s.
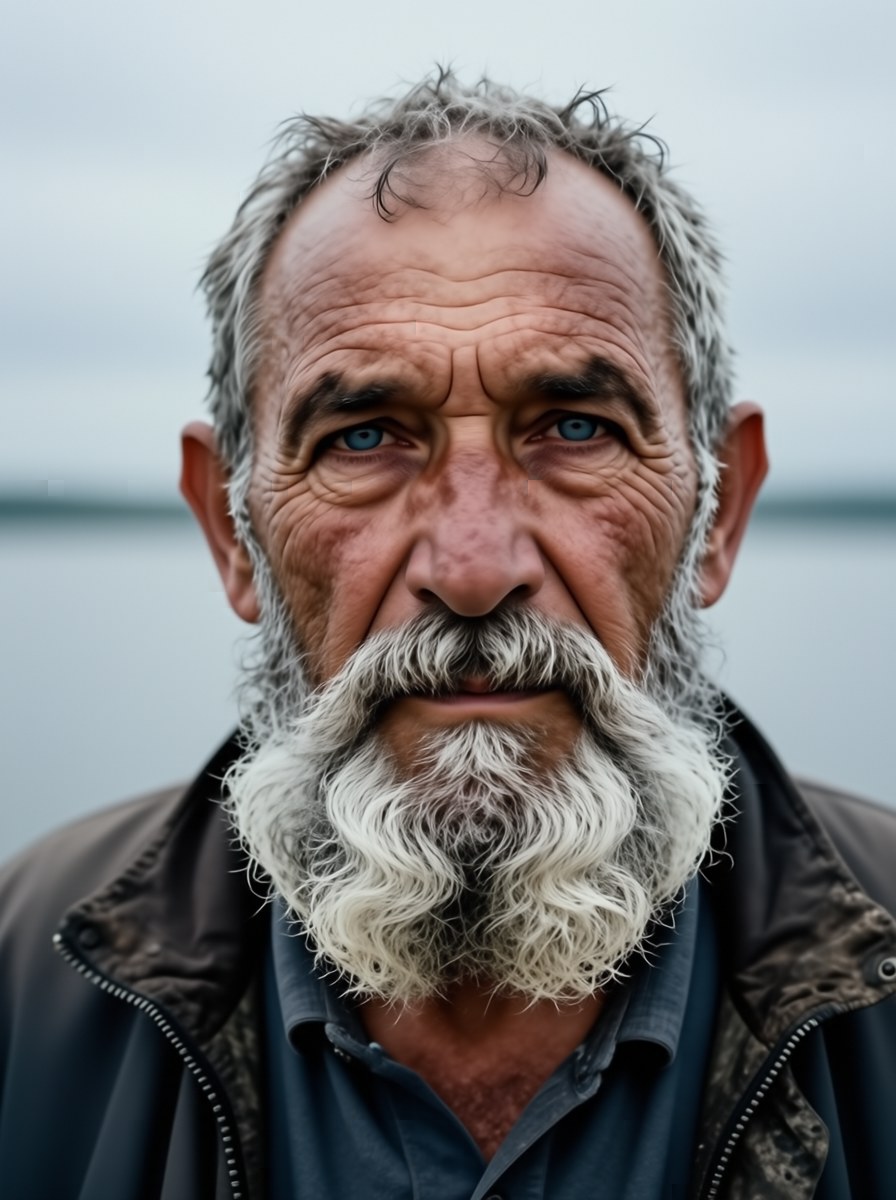
Un vieux pêcheur, style photo argentique. 896x1200, 2,77 s.
Il a aussi bien écrit "OPEN LATE" sur une plaque émaillée, et dessiné exactement sept pommes quand on lui en demandait sept. Trois prompts ont mal tourné. Dans le panneau, "a lighthouse keeper's cat asleep on a windowsill, stormy sea outside, oil painting" (le chat d'un gardien de phare endormi sur un rebord de fenêtre, mer déchaînée dehors, peinture à l'huile) a donné la fenêtre et le phare, mais aucun chat que nous ayons pu voir. Nous avons demandé "two hands of a pianist" (deux mains d'un pianiste) et obtenu les deux à droite, plus une troisième main en bas à gauche et une partie d'une autre sur le bord en haut à gauche (celle-là est peut-être un reflet dans la laque noire).
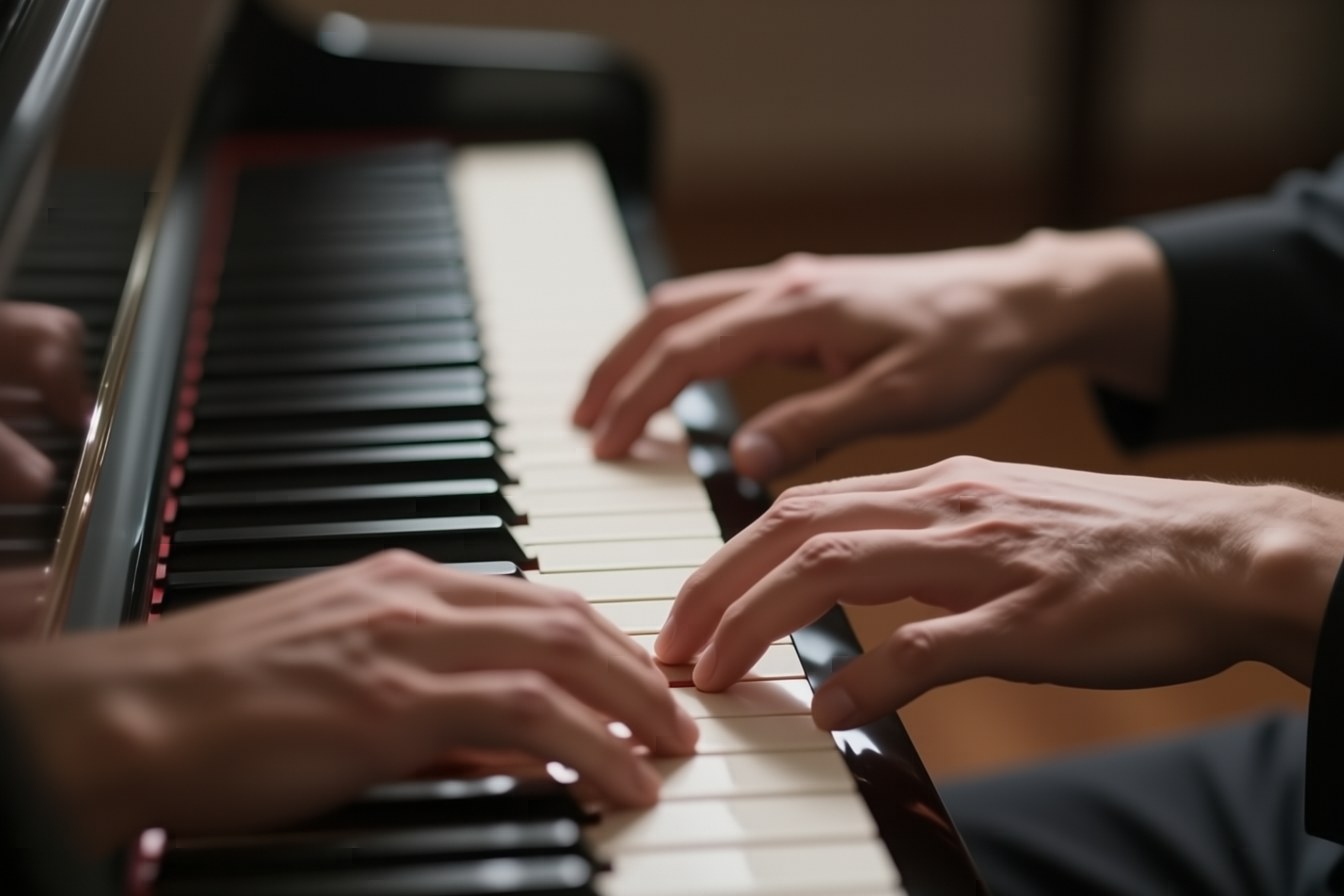
"Close-up of two hands of a pianist playing a grand piano" (gros plan sur les deux mains d'un pianiste jouant d'un piano à queue). Regardez en bas à gauche. 1344x896, 2,83 s.
Et un menu sur ardoise avec quatre prix, c'était trop. Turbo a laissé tomber les points décimaux ("Cappuccino 320", "Daily soup 550"). Le modèle de base, en 90 secondes au lieu de 2, a mis le point décimal dans trois des quatre prix. Le cappuccino est quand même sorti à 320, et il a écrit deux fois le prix de l'espresso et la ligne du croissant.
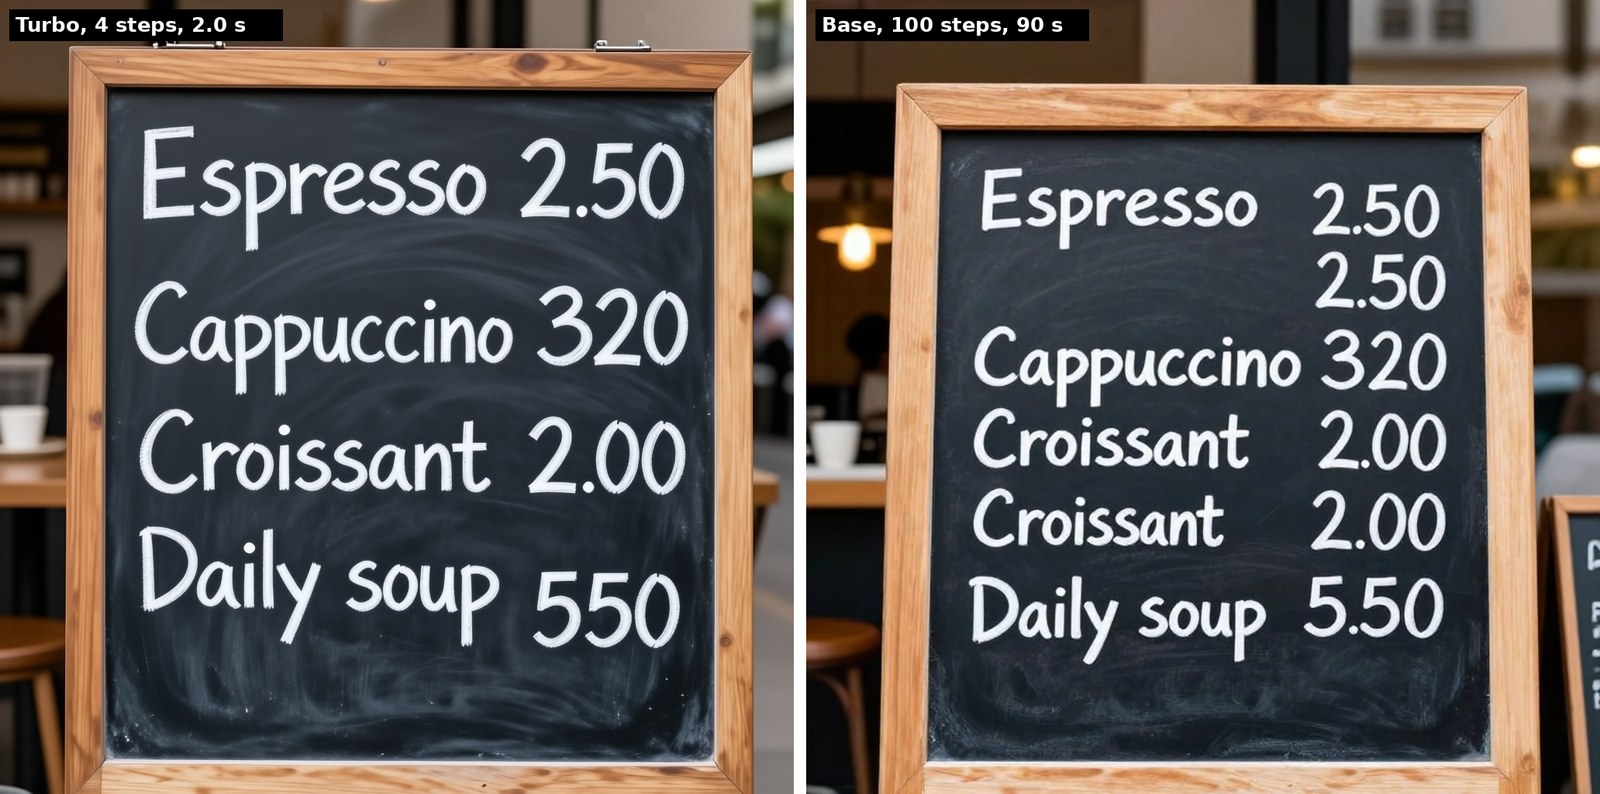
Même prompt et même seed, Turbo à gauche, base à droite. Le prompt demandait "Espresso 2.50, Cappuccino 3.20, Croissant 2.00, Daily soup 5.50".
Sur une photo sans texte, les deux sont difficiles à distinguer au premier coup d'œil, et c'est tout l'intérêt de Turbo :
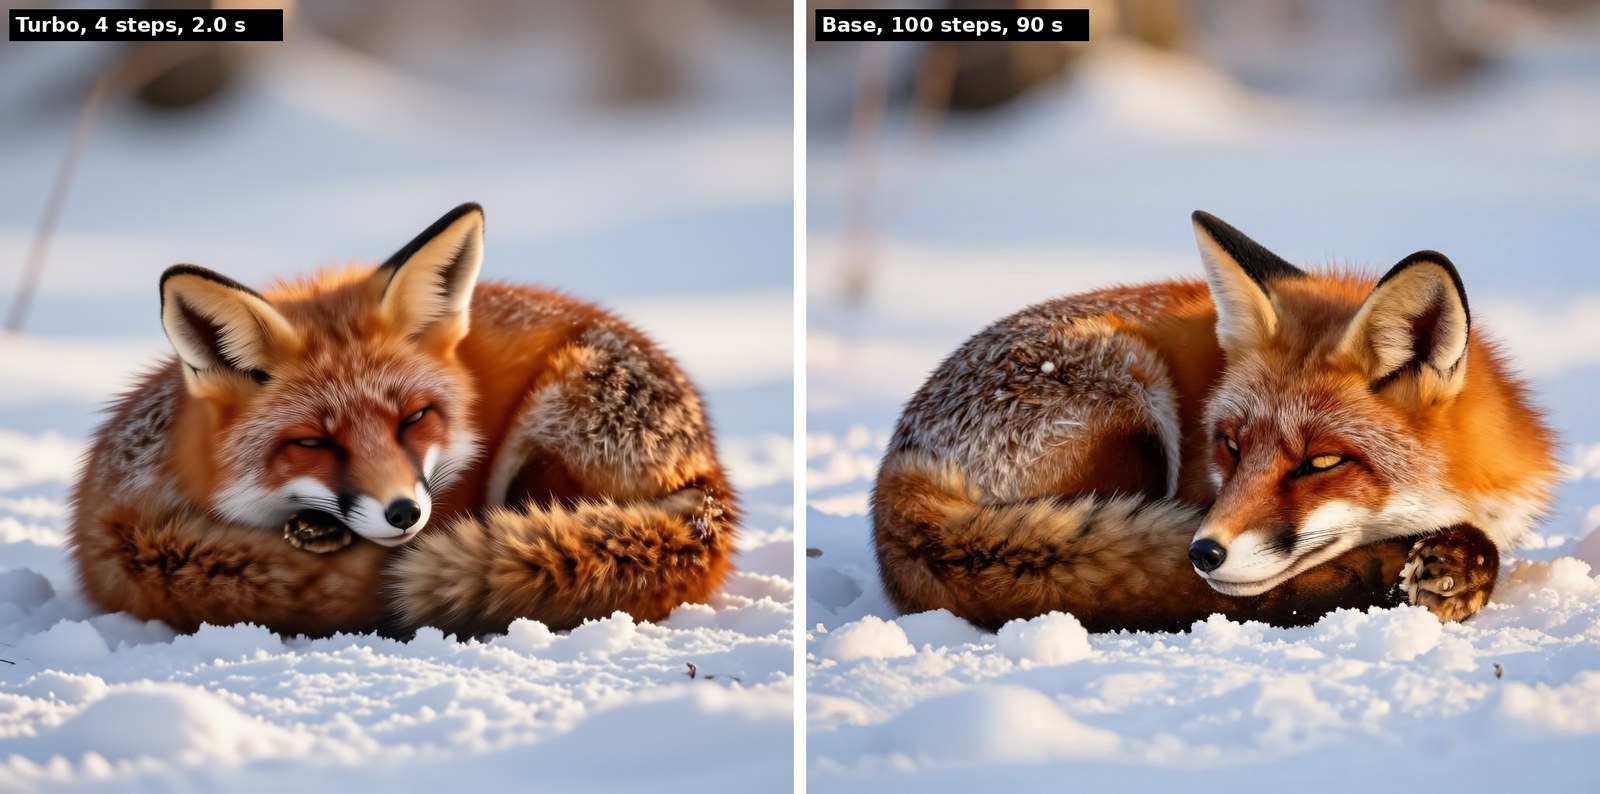
Même prompt et même seed. 2 secondes contre 90.
La démo
L'enregistrement de 72 secondes ci-dessous montre le panneau InferenceKey pendant le test : les deux workloads Iris qui tournent sur l'A40 (nommée a40-render-01), le testeur d'images qui génère l'abeille et la plaque "OPEN LATE" en 2,9 secondes chacune, et la vue en direct avec huit requêtes qui passent.
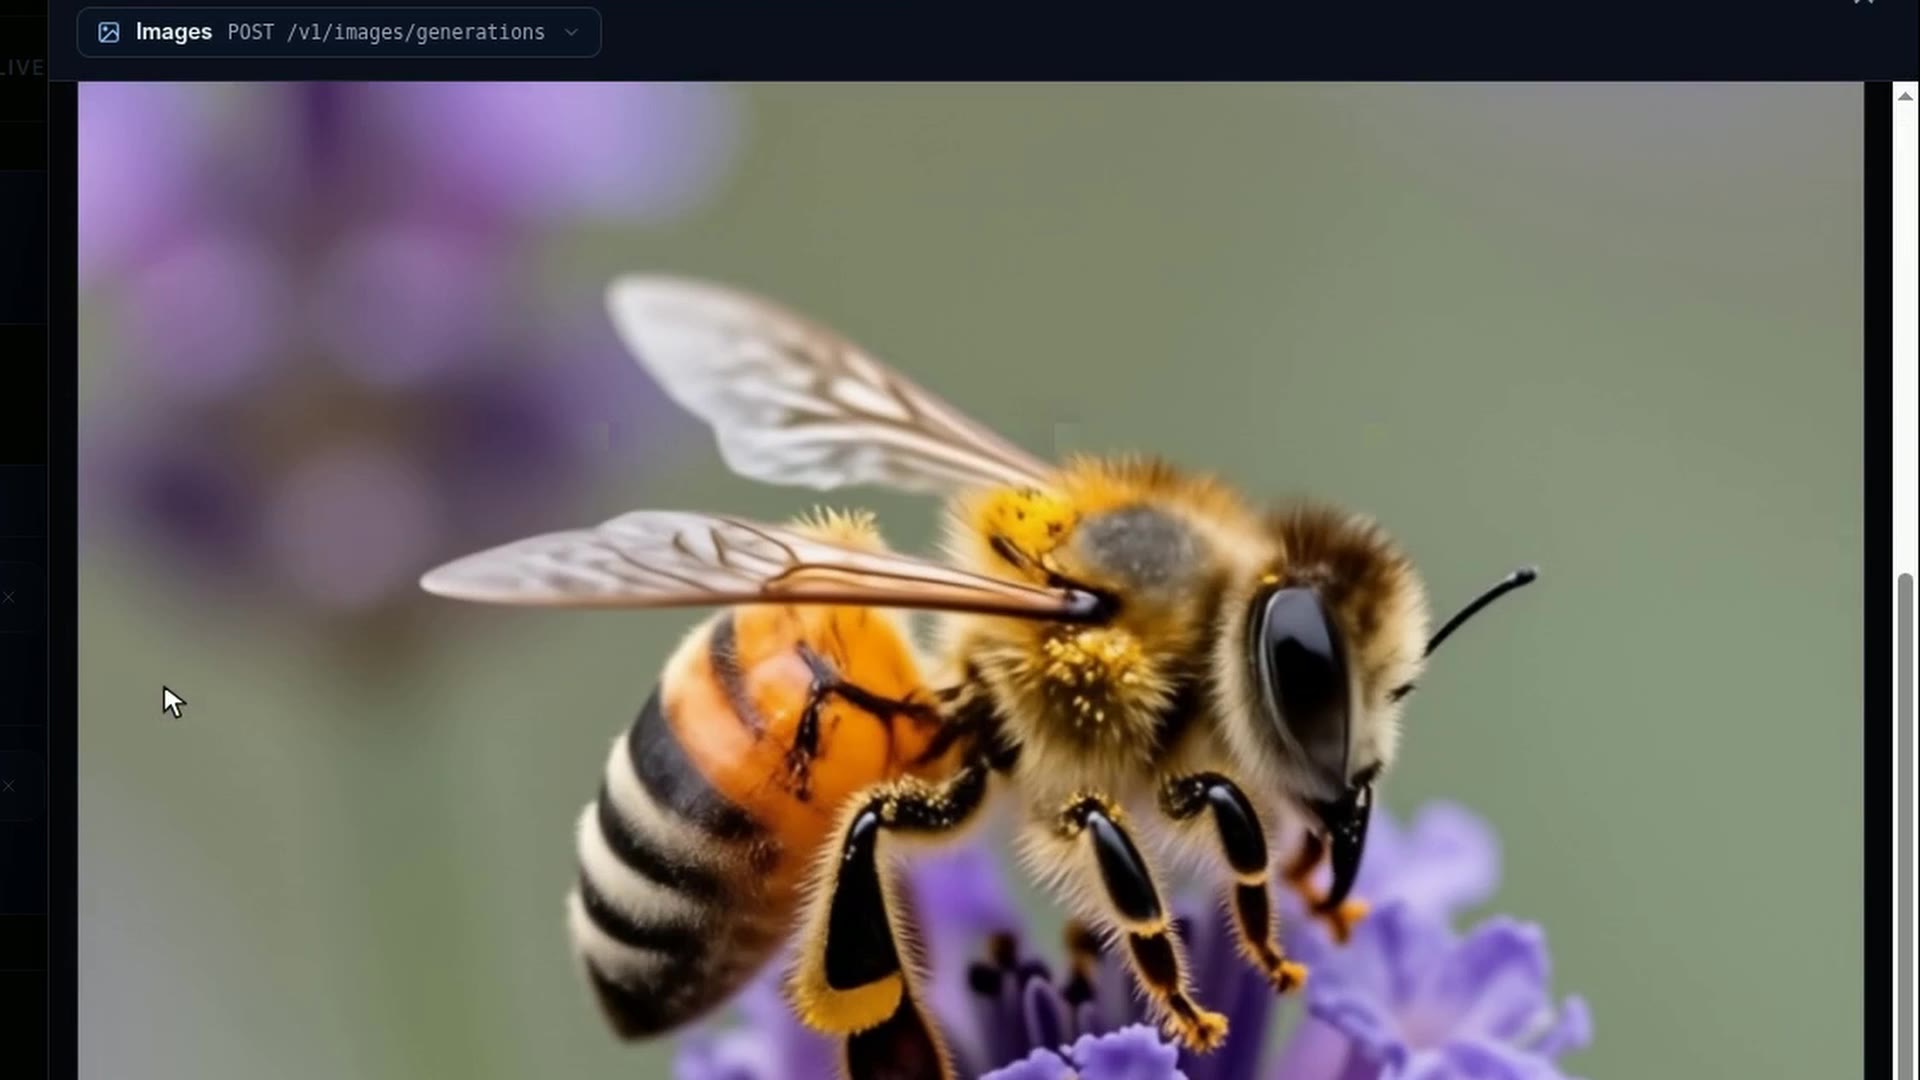
Cliquez sur l'image pour lire le MP4 (72,5 s, 7,4 MB).
Ce qui a coincé, et une chose qui a bien marché
Turbo a tourné de bout en bout, et le testeur d'images et la vue en direct du panneau ont fonctionné avec notre backend sans modification. En chemin, nous sommes tombés sur quatre aspérités côté InferenceKey, aucune fatale. Les numéros 1, 3 et 4 correspondent au fonctionnement actuel de la plateforme, donc ils se reproduiront. Le numéro 2, nous l'avons vu une fois, sur un seul run :
- Une réponse trop grosse est devenue une attente de cinq minutes. Deux images PNG dans une requête faisaient 9,1 MB au total, plus que la limite de 8 MB pour un seul message à l'intérieur d'InferenceKey. Le worker l'a su tout de suite et a abandonné le résultat, mais l'appelant n'a reçu qu'un timeout générique au bout d'environ 5 minutes. Notre exemple refuse désormais ce cas immédiatement avec une erreur claire et propose JPEG ou WebP, où quatre images tiennent en 688 KB.
- "Prêt" est arrivé 50 secondes trop tôt. Avec deux modèles sur un worker, l'attente de disponibilité du SDK a déclaré le modèle de base prêt au bout de 10 secondes. Le "prêt" qu'elle a vu venait en fait de Turbo, qui redémarrait avec notre code mis à jour sur le même GPU. Aucune requête n'a été perdue : la première a attendu dans la file jusqu'à ce que le modèle de base soit lancé.
- Pas de réglages par workload. On ne peut pas dire à un backend custom "fais tourner le modèle de base cette fois" depuis les réglages du workload. Nous avons publié le modèle de base comme un second backend, sous son propre nom.
- Une limite de démarrage fixe. Un backend custom a 300 secondes pour être prêt, et sur une machine GPU louée qu'InferenceKey configure pour vous, il n'y a aucun moyen de l'augmenter. Le nôtre a pris 113 secondes, mais un téléchargement plus lent pourrait atteindre la limite.
Ce qui a bien marché : quand nous avons corrigé le problème 1 et republié le backend, InferenceKey a détecté le changement et redémarré tout seul le modèle en cours avec le nouveau code, en 23 secondes, sans aucune étape manuelle.
Qui a fait quoi
Iris-3B est le travail de Sperid Labs : le modèle, la version Turbo, les versions profondeur et agrandissement de photos, les scripts d'entraînement, la démo publique et l'article de Hanqiu Li Cai et Chema Garabito. Le premier Iris rapide, à 4 passes, est venu de la communauté : pentacoxian-dev a construit iris-3b-turbo-lora sur un seul GPU grand public. Qwen3-VL-4B-Instruct, le modèle qui lit le prompt, vient de l'équipe Qwen d'Alibaba. L'étage qui transforme chaque tuile en pixels suit la conception de PixelDiT, le modèle d'un autre groupe (les auteurs ont écrit leur propre code pour cela). L'entraînement s'appuie aussi sur des méthodes publiées par d'autres groupes, dont un modèle d'image de Meta (DINOv2) utilisé comme guide au début de l'entraînement. La liste complète est dans la section pour les ingénieurs. C'est par la vidéo d'actualité d'AI Search que nous en avons entendu parler.
Notre part : lire les sources, écrire le backend custom et l'exemple du SDK, le faire tourner sur InferenceKey, le mesurer et enregistrer la démo.
Ce qu'il faut retenir
Si vous avez besoin d'un modèle d'image ouvert utilisable commercialement et qui produit une image 1024x1024 en environ 2 secondes sur une A40 de 48 GB louée, Iris-3B Turbo mérite un test. Téléchargez le dossier Turbo, pas le repo. Restez réaliste sur le texte long et sur les mains, et essayez vos propres prompts avant de vous engager : les benchmarks de l'éditeur et le test d'AI Search le placent tous deux derrière les meilleurs modèles ouverts, et nous n'en avons fait tourner aucun côte à côte. L'idée de l'espace des pixels est une recherche intéressante, et les auteurs sont les premiers à vous dire qu'elle n'a pas gagné la comparaison qu'ils ont montée.
La question que nous avons laissée ouverte, c'est la carte bon marché. Turbo a culminé à environ 23 GB sur l'A40. Savoir s'il tourne sur une RTX 4090 de 24 GB ne demande qu'un python main.py sur un worker qui en a une.
Pour les ingénieurs
Modèle (README GitHub, page de recherche, article). Diffusion transformer de 3B travaillant dans l'espace des pixels : pas de VAE ni d'espace latent (le "réseau auxiliaire" et le "code compressé" du récit). 24 blocs de largeur 2560 (8 dual-stream + 16 single-stream), GQA 20 têtes query / 5 têtes KV, patch size 16, une tête pixel-transformer (PiT) de 4 blocs qui suit la conception de celle de PixelDiT (implémentation indépendante, sans code de PixelDiT) décode chaque token de patch en pixels. Rectified flow, v-prediction, timesteps logit-normal. RoPE 2D, donc un seul jeu de poids tourne à n'importe quel ratio d'aspect jusqu'à environ 1 MP. Encodeur de texte : Qwen3-VL-4B-Instruct gelé, 12 couches cachées combinées par un adaptateur de layer-attention appris. Article : "Iris-3B: Going Beyond the Latent with Pixel-Space Diffusion Training, Conversion and Fine-Tuning", arXiv 2610.09450 v1, 7 octobre 2026, 19 pages (nous avons lu le résumé, pas le texte complet).
Entraînement. From scratch, 256 -> 512 -> 1024 px, puis SFT à 1024 : 665K steps (étape 1 jusqu'à 365K au batch 1024 avec REPA sur DINOv2-B/14, étape 2 jusqu'à 530K, étape 3 jusqu'à 625K au batch 512, SFT 625K-665K). Muon + AdamW, bf16, FSDP2, torchrun --nproc_per_node=8. Les scripts d'entraînement sont publiés. Les heures GPU ne sont pas indiquées (la page de recherche dit seulement "a fraction" (une fraction) du calcul des modèles latents).
Échantillonnage de base. 1024x1024, 100 steps DPM-Solver++ (ordre 2), CFG 3. python scripts/sample.py --checkpoint iris-3b --prompt "...", flags --steps --seed --negative-prompt --txt-file --cfg-scale.
Turbo. Fine-tune complet des 3B paramètres (pas une LoRA) avec Trajectory Distribution Matching, sans données, en deux étapes (6 steps pendant 1 600 mises à jour, puis 4 steps pendant 500). CFG 3,5 intégré depuis le teacher, pas de CFG ni de negative prompt à l'inférence, sigmas fixes 1 ; 0,938 ; 0,833 ; 0,625. Sept buckets d'aspect autour de 1 MP : 1024x1024, 752x1344, 896x1344, 896x1200 et leurs transposés. Poids exportés en bf16, convertis en FP32, exécutés sous autocast BF16. API Python iris3b.sampling.generate_few_step. Alternative communautaire : iris-3b-turbo-lora de pentacoxian-dev, une distillation DMD2 à 4 steps sous forme de LoRA de rang 64 (460 MB), non testée par nous. Limites listées par l'éditeur : moins bon que la base sur le texte dense ou long, moins de variété entre seeds, léger grain possible sur les fonds vectoriels unis, 4 steps fixes. De manière générale, le rendu du texte et les comptes exacts ne sont pas toujours fiables.
Crédits des méthodes. L'architecture DiT, la conception de la tête PiT de PixelDiT pour décoder les patchs en pixels, l'optimiseur Muon via Dion de Microsoft, REPA avec les features DINOv2-B/14 de Meta à l'étape 1 de l'entraînement de base, le sampler DPM-Solver++ pour le modèle de base, Trajectory Distribution Matching pour Turbo, la recette HYPIR pour l'upscaler et le protocole Marigold V2 pour évaluer la profondeur.
Tableau de benchmarks (lignes choisies). Lignes Iris mesurées par Sperid Labs avec les évaluateurs officiels à 1024², sans réécriture du prompt, sans best-of-N. Les autres lignes sont citées sur la page de recherche comme références tirées des rapports de Qwen-Image et de Z-Image. La page de recherche liste aussi SDXL, SD3 Medium, SD3.5 Large et Lumina-Image 2.0, non repris ici. La ligne de la LoRA communautaire vient de la card HF et du README GitHub.
| Modèle | GenEval | DPG | LongText EN | OneIG EN |
|---|---|---|---|---|
| Iris-3B | 0,798 | 86,52 | 0,857 | 0,540 |
| Iris-3B Turbo | 0,820 | 86,68 | 0,804 | 0,516 |
| iris-3b-turbo-lora r2-1000 (communauté) | 0,760 | 85,05 | 0,733 | 0,486 |
| Qwen-Image 20B | 0,87 | 88,3 | 0,943 | 0,539 |
| Z-Image 6B (réécriture du prompt) | 0,84 | 88,1 | 0,935 | 0,546 |
| HiDream-I1-Full | 0,83 | 85,89 | 0,543 | 0,477 |
| Janus-Pro-7B | 0,80 | 84,19 | 0,019 | 0,267 |
| FLUX.1-dev 12B | 0,66 | 83,8 | 0,607 | 0,434 |
Fine-tunes (chiffres de l'éditeur, non testés par nous). Profondeur (depth/, environ 12 GB) : profondeur log relative, invariante affine, 10K steps, AbsRel 0,071 et delta1 0,946 en moyenne zero-shot sur NYUv2, KITTI, ETH3D, ScanNet et DIODE (protocole Marigold V2), scripts/depth.py photo.jpg --out depth_out. Upscaler (upscaler/, environ 12 GB) : restauration adversariale en une étape (recette HYPIR), 10K steps, 4x, LPIPS 0,292 et PSNR 20,68 sur DIV2K val, tuiles 1024x1024 au pas de 512 avec fondu gaussien, sortie plafonnée à 2048x4096 (21 tuiles) par défaut, scripts/upscale.py photo.jpg --out upscaled. Les deux font une seule forward pass avec un prompt vide et sans encodeur de texte. La démo Gradio avec les trois modèles demande environ 45 GB, environ 20 GB au pic avec IRIS_OFFLOAD=1. Le HF Space tourne sur ZeroGPU.
Fichiers (API HF, 2026-10-12) : à la racine model.safetensors 11 950 112 680 B (base fp32), turbo/model.safetensors 5 975 089 200 B, depth/model.safetensors 11 952 738 184 B, upscaler/model.safetensors 11 950 112 680 B, repo entier 41 911 753 317 B. Safetensors de Qwen3-VL-4B-Instruct 8,88 GB. Prérequis : Python 3.11+, PyTorch 2.7.1+, GPU NVIDIA avec CUDA.
Notre setup. RunPod NVIDIA A40 48 GB, SECURE, EU-SE-1, 0,59 USD/h avec 100 GB de disque, image runpod/pytorch:1.0.2-cu1281-torch280-ubuntu2404, driver 580.159.03 (CUDA 13.0). Worker bootstrappé par un manager InferenceKey local via des tunnels HTTP + TCP. RTX 4090 COMMUNITY affichée à 0,34 USD/h à ce moment-là. Pod créé à 21:07:30Z (worker en ligne vers 21:08:40Z), supprimé à 21:33:35Z. Venv du backend : Python 3.12.3, torch 2.14.1+cu130, transformers 5.19.0, installés par uv. Code upstream figé à 73bcdf59 (un commit de docs ultérieur, cee0c13, est arrivé le même jour et n'a pas été testé).
Backend (backend.py). Un backend custom parce qu'Iris-3B n'est ni un pipeline Diffusers ni un fichier GGUF, les formats que chargent les backends intégrés. Slugs iris3b-text2image (Turbo) et iris3b-base-text2image (base), paquet de 5 209 à 5 800 octets. setup() télécharge le tarball upstream au commit figé (environ 1 MB), fait un snapshot_download de turbo/* (ou de config.yaml + model.safetensors pour la base), construit IrisDiT sur le device meta, charge les poids, les convertit en fp32 et construit l'encodeur Qwen3-VL. process() accepte l'entrée native ou le JSON d'images OpenAI, aligne les tailles Turbo sur les 7 buckets, tire le bruit sur le CPU à partir de la seed (le même bruit de départ sur n'importe quel GPU), lance generate_few_step (Turbo) ou generate (base, 100 steps, CFG 3) sous autocast bf16 et renvoie {data: [{b64_json}]}. n de 1 à 4, output_format png, jpeg ou webp, PNG avec n > 1 répond 400. Commit de l'exemple SDK 05869ee sur main.
Mesures (temps GPU = mesuré par le backend avec cuda.synchronize(), aller-retour = du client HTTP au manager, encodage et NATS compris) :
| Cas | GPU s | Aller-retour s |
|---|---|---|
Démarrage à froid de Turbo, de ensure() à prêt | 130 (venv 16, code upstream + téléchargement Turbo 12,2, téléchargement de l'encodeur ~72, chargement des deux modèles ~27) | |
| Deux premiers appels Turbo, 1024x1024 / 1344x752 | 3,45 / 2,75 | 5,80 / 3,73 |
| Turbo 1024x1024, 5 prompts | 1,956 à 1,961 | 2,83 à 2,92 |
| Turbo 1344x752 | 1,91 | 2,79 à 2,83 |
| Turbo 1344x896 | 2,21 / 2,83 | 3,46 / 3,84 |
| Turbo 896x1200 / 1200x896 / 896x1344 | 2,77 / 2,87 / 2,65 | 3,76 / 3,83 / 3,71 |
| Turbo n=4, 1024x1024, JPEG | 7,02 (1,75 par image) | 7,41 (688 KB) |
| Turbo, 8 requêtes JPEG séquentielles | 2,10 à 2,25 | |
| Turbo, testeur d'images du panneau | 2,86 et 2,92 | |
| Base 1024x1024, 100 steps, CFG 3 | 89,8 / 90,0 | |
| Base 1344x896 | 106,1 |
Démarrage de la base avec l'encodeur en cache : prête 60 s après ensure() (poids 42,7 s, chargement 11,4 s). VRAM relevée par nvidia-smi toutes les 0,5 s : Turbo 20 384 MiB chargé, 21 831 MiB au pic (19,9 / 21,3 GiB, soit 21,4 / 22,9 GB). Turbo + base 40 455 MiB chargés, 44 890 MiB au pic (39,5 / 43,8 GiB). Puissance carte maximale 308,8 W pour une limite de 300 W.
Problèmes de plateforme, en détail.
n=2en PNG à 1024x1024 = 9 097 397 octets, au-delà du max payload NATS de 8 388 608 octets. Worker :job result refused by JetStream for good (code max_payload: ...); the result is given up and the job is acked. Client : HTTP 504inference_timeoutau bout d'environ 300 s. Le worker le sait tout de suite, le gateway ne l'apprend que par le timeout. Atténué dans l'exemple (400 en 0,08 s).wait_until_ready("iris3b-base")est revenu à +10 s alors que le backend de base est devenu prêt à 21:19:52. L'événement vu était le hot recycle de Turbo sur le même worker. Premier aller-retour de la base 141 s (environ 50 s en file + 90 s de génération).- Le worker lance
python -m inferencekey.backend.serve --port N --backend <entrypoint>sans--config-json, donc un backend custom ne reçoit aucune config par workload. Contournement : une seconde classe d'entrypoint,Iris3BBaseText2ImageBackend, sous son propre slug. INFERENCEKEY_CUSTOM_BACKEND_READY_TIMEOUT_SECSvaut 300 s par défaut et ne peut pas être réglé sur les pods RunPod provisionnés par le manager. Ce setup a pris 113 s.
Positif : republier le backend a fait un hot recycle du workload en cours en 23 s (custom backend artifact changed for a running workload; recycling its backend).
Limites.
- Un seul modèle de GPU (A40), un seul run, une seule seed par prompt.
- Un seul client envoyant les requêtes l'une après l'autre (les 8 requêtes "en direct" étaient séquentielles), et un seul workload servant du trafic à la fois. Aucun test de concurrence ni de débit sous charge. Nous n'avons pas testé de carte de 24 GB, donc la question de savoir si Turbo tient en pratique sur une RTX 4090 ou une A5000 reste ouverte.
- Les 0,7 s par image annoncées par l'éditeur sur une H100 au batch 4 n'ont pas été reproduites. Nos 1,75 s par image au batch 4 sont sur une A40 et ne constituent pas une vérification à conditions égales.
- Les jugements de qualité sont les nôtres, après avoir regardé chaque image que nous avons générée, une seed par prompt. Nous n'avons pas fait tourner de modèle à image compressée (latent) comme FLUX, Z-Image ou Qwen-Image sur les mêmes prompts, donc la comparaison de qualité avec eux repose sur les tableaux de l'éditeur et l'avis d'un testeur. La variété entre seeds et le grain sur les fonds unis n'ont pas été évalués.
- Les scores de profondeur et d'upscaler, les scores de benchmark et les conclusions de l'article sont des affirmations de Sperid Labs. Nous avons lu le résumé de l'article, pas le texte complet.
- Le test d'AI Search disait que le modèle de base de 12 GB "should fit on most consumer GPUs" (devrait tenir sur la plupart des GPU grand public). Avec la conversion fp32 des auteurs et l'encodeur de texte, Turbo seul a mesuré 20 384 MiB (19,9 GiB) une fois chargé, donc prévoyez plus que la taille du fichier.
Sources : fiche de modèle Iris-3B, repo GitHub, article, page de recherche, HF Space, exemple du SDK, vidéo d'AI Search (chapitre à 36:35).