Iris-3B: un modelo de imagen abierto que dibuja sus propios píxeles, unos dos segundos por imagen
Iris-3B es un modelo de imagen abierto que dibuja los píxeles él mismo. Probamos su versión Turbo en InferenceKey: unos 2 s por imagen en una A40.
El 5 de octubre, Sperid Labs publicó Iris-3B en Hugging Face y en GitHub, un modelo de imagen abierto que dibuja él mismo cada píxel de la imagen. Los modelos con los que se compara, entre ellos FLUX y Qwen-Image, no lo hacen: esbozan una versión comprimida y un decodificador aparte la convierte en píxeles.
Su paper también construyó dos herramientas extra sobre el modelo, una que estima la profundidad y otra que restaura fotos, y el resumen dice que trabajar en píxeles no aportó una mejora clara en ninguna de las dos.
El 12 de octubre añadieron una versión rápida, "Turbo", que termina una imagen en 4 pasadas en lugar de 100 (estos modelos parten de ruido aleatorio y lo van limpiando un poco en cada pasada). Lo vimos en el vídeo de noticias de AI Search del 11 de octubre, leímos las fuentes y ejecutamos Turbo nosotros mismos en una GPU alquilada, servido a través de InferenceKey. Esto es lo que conviene saber antes de entrar en detalles:
| Iris-3B Turbo | |
|---|---|
| Licencia | Apache-2.0 para código y pesos: puedes usarlo comercialmente, modificarlo y redistribuirlo |
| Tamaño | 3B parámetros (los números aprendidos dentro del modelo, una medida aproximada de su tamaño), más un modelo de 4B parámetros que lee el prompt |
| Lo que necesitas descargar | unos 6 GB para Turbo, más unos 9 GB para el lector del prompt. No el repo entero de 42 GB |
| Memoria de GPU, medida | unos 21 GB cargado, unos 23 GB en el pico: justo por debajo de una tarjeta gaming de 24 GB (sin probar), holgado en la tarjeta de 48 GB que usamos |
| Tiempo por imagen de 1024x1024, medido en una NVIDIA A40 | 1,96 s en la GPU, unos 2,9 s de principio a fin a través de la API |
| La misma imagen con el modelo base de 100 pasadas | unos 90 s |
| Primer arranque, desde "desplegar" hasta listo para la primera imagen (con la máquina GPU ya en línea) | unos 2 minutos (130 s) |
| Dónde se queda corto en nuestra prueba | un menú con cuatro precios, manos de más en un pianista, un gato que no apareció |
Por esto me importa. La forma habitual de meter imágenes generadas en un producto es una API alojada que cobra por imagen. Un modelo Apache-2.0 así de pequeño es uno que puedes ejecutar tú mismo en una GPU alquilada: te quedas con los pesos, decides cuándo cambia la versión, sabes adónde van los prompts y las imágenes, y pagas por el tiempo de la tarjeta en lugar de por imagen. No es el mejor modelo de imagen abierto en calidad, y más abajo contamos dónde se queda corto, pero es una opción real si quieres ser dueño del modelo en vez de alquilarle imágenes a otro.
La mayoría de los modelos de imagen trabajan sobre un MP3 de la imagen
La receta habitual es esta. Una pequeña red auxiliar comprime cada imagen en un código compacto, un poco como un MP3 comprime una grabación. El modelo grande aprende a dibujar en ese código, lo que es mucho más barato que dibujar cada píxel, y al final la red auxiliar lo expande de nuevo a una imagen completa. Llamémoslos modelos de imagen comprimida: son con los que Sperid Labs compara Iris.
La página de investigación de Sperid Labs se posiciona en contra del MP3. La compresión pierde detalle, escriben, y el código comprimido está "sesgado" y "centrado en la textura": está ajustado al aspecto de las superficies más que al detalle exacto. Su objetivo son tareas donde el detalle fino importa, como estimar la profundidad a partir de una foto o restaurar una de baja resolución. Así que Iris-3B se salta el MP3 y trabaja sobre el máster: corta la imagen en teselas de 16 por 16 píxeles, trabaja directamente sobre esas teselas, y una pequeña etapa final convierte cada tesela de nuevo en píxeles reales. Los autores tomaron el diseño de ese último paso de otro grupo de investigación (lo citamos más abajo). No hay decodificador aparte ni espacio comprimido.
El prompt lo lee un modelo aparte, Qwen3-VL-4B-Instruct, del equipo Qwen de Alibaba, también Apache-2.0, que Iris descarga en su primera ejecución.
El veredicto de los propios autores: los píxeles no aportan una mejora clara
El resumen del paper expone su conclusión sin rodeos: "We find no significant improvement from using a pixel-space generative prior." Dicho llanamente: construir las herramientas de profundidad y de restauración de fotos sobre un modelo de píxeles no las hizo mejores que construirlas sobre un modelo de imagen comprimida. Lo probaron en dos tareas frente a FLUX.2 Klein, un modelo de imagen comprimida de tamaño parecido (4B parámetros). En profundidad, los dos empataron. Al ampliar fotos 4 veces, Iris-3B no superó a FLUX.2 Klein.
Para generar imágenes sin más, el paper dice que Iris-3B puntúa al nivel de Qwen-Image, un modelo unas siete veces mayor (20B parámetros), en una prueba general de lo bien que las imágenes siguen su prompt (OneIG en la tabla de abajo). La otra columna, LongText, puntúa lo bien que el modelo escribe una frase o más dentro de la imagen.
| Modelo | LongText (EN) | OneIG (EN) |
|---|---|---|
| Iris-3B (base) | 0,857 | 0,540 |
| Iris-3B Turbo | 0,804 | 0,516 |
| Qwen-Image (20B) | 0,943 | 0,539 |
| Z-Image (6B, reescritura del prompt) | 0,935 | 0,546 |
| FLUX.1-dev (12B) | 0,607 | 0,434 |
Las puntuaciones van de 0 a 1, y más alto es mejor. "Reescritura del prompt": la puntuación de Z-Image se midió después de que un asistente reescribiera cada prompt con más detalle, lo que le ayuda. Las filas de Iris las midió Sperid Labs. Las demás filas se citan en su página de investigación a partir de los informes de Qwen-Image y Z-Image. Nada de esto lo hemos reproducido nosotros. Hay más filas y dos columnas más en la sección para ingenieros.
Fíjate en la columna LongText: Iris-3B saca 0,857 donde Qwen-Image saca 0,943. Ahí Iris-3B queda claramente por detrás de Qwen-Image y Z-Image, y Turbo queda un poco por detrás de su propio modelo base. Eso encaja con lo que vimos con un menú de precios más abajo. El revisor de AI Search lo dijo de forma más directa: calidad "not as good as the leading open models out there", pero "a decent lightweight alternative". No ejecutamos un modelo de imagen comprimida con los mismos prompts, así que esta comparación de calidad son las tablas del fabricante y la opinión de un revisor, no nuestras imágenes.
Una red, tres trabajos
La misma red de Iris, reentrenada un poco para cada tarea, viene también como otras dos herramientas en la misma descarga. Una estima la profundidad a partir de una sola foto (a qué distancia está cada punto, relativa a los demás, no en metros). La otra, un ampliador de fotos, amplía una foto 4 veces y restaura su detalle, trabajando tesela a tesela. Las dos funcionan en una sola pasada, sin prompt y sin modelo de texto. Sperid Labs da puntuaciones de ambas en conjuntos de prueba estándar, recogidas en la sección para ingenieros. No hemos probado ninguna de las dos.
Turbo: cuatro pasadas en lugar de cien
El Iris-3B base usa 100 pasadas, y cada pasada ejecuta el modelo dos veces (una con tu prompt y otra sin él, para poder empujar la imagen hacia el prompt), lo que lo hace aún más lento. Turbo es el modelo entero reentrenado para terminar en 4 pasadas de una sola ejecución cada una. Sperid Labs dice que Turbo hace una imagen de 1024x1024 en unos 0,7 segundos en una H100, la GPU de centro de datos más alta de gama de Nvidia, cuando genera cuatro a la vez. No hemos probado esa tarjeta. El precio a pagar, según su propia lista de limitaciones: Turbo es más flojo que el modelo base con texto denso o largo, da menos variedad cuando pides el mismo prompt varias veces y puede dejar un grano tenue en fondos planos.
Sperid Labs no fue el primero en hacer rápido a Iris. Su propia model card da las gracias a pentacoxian-dev, que creó iris-3b-turbo-lora, una versión de 4 pasadas empaquetada como un pequeño complemento de 460 MB y entrenada en una sola GPU de consumo. Tiene su propia fila en la tabla de benchmarks de la model card de Sperid Labs. Nosotros ejecutamos el Turbo de Sperid Labs, no este.
La trampa de los 42 GB
Si clonas el repo de Hugging Face te llevas cuatro modelos: el modelo base (unos 12 GB), Turbo (unos 6 GB), el modelo de profundidad (unos 12 GB) y el ampliador de fotos (unos 12 GB). Son 41,9 GB en total. Para generar imágenes rápido solo necesitas Turbo:
hf download speridlabs/iris-3b --include "turbo/*" --local-dir iris-3b
El lector del prompt, Qwen3-VL-4B-Instruct, va aparte: otros 8,88 GB, que se descargan automáticamente la primera vez que se ejecuta el código.
Cómo lo ejecutamos en InferenceKey
Turbo estaba sirviendo imágenes a través de la API de InferenceKey unos dos minutos después de la llamada de despliegue (en una máquina GPU que ya estaba en línea), a unos 2 segundos de GPU por imagen de 1024x1024. Así lo hicimos, y esto es lo que falló por el camino.
La GPU y por qué esa
Alquilamos una NVIDIA A40 con 48 GB de memoria en RunPod, en un centro de datos de la UE. La elección obvia para un modelo "3B" sería una tarjeta gaming más barata de 24 GB, como una RTX 4090. La descartamos por cómo carga el modelo el código de los autores: guarda cada número de la red de 3B al doble del tamaño con el que viene en el fichero, lo que ocupa unos 12 GB, y el lector del prompt añade unos 8 GB más. Turbo solo midió unos 21 GB cargado y unos 23 GB en el pico. No hemos probado una tarjeta de 24 GB, así que queda abierto si Turbo entra en una en la práctica. La tarjeta de 48 GB también nos permitió cargar el modelo base de 100 pasadas junto a Turbo para compararlos lado a lado.
Para que hagas tus propias cuentas: al precio de lista de la A40 en RunPod, mil imágenes de Turbo generadas de cuatro en cuatro son unos 29 minutos de tarjeta, unos 30 centavos de dólar, sin contar el arranque ni el tiempo ocioso. Pagas por el tiempo de la tarjeta en lugar de pagar por imagen, y eliges tú el modelo, no un proveedor.
Por qué un custom backend
Un backend es la pieza de código que carga un modelo una vez y luego responde peticiones. InferenceKey trae backends listos para las formas habituales de empaquetar modelos de imagen y de texto, pero Iris-3B viene en su propio formato, así que ninguno de ellos puede ejecutarlo. Por eso escribimos el nuestro en Python, algo que InferenceKey te permite aportar. El nuestro ocupa unos 5 KB, sin pesos dentro. Al arrancar descarga una versión fija del código de los autores, baja de Hugging Face solo la carpeta de Turbo y carga el modelo igual que lo hacen los autores. Responde con la misma forma de petición /v1/images/generations que usa la API de imágenes de OpenAI, así que cualquier cliente que hable ese formato puede llamarlo.
Lo ejecutamos en una copia privada de pruebas de InferenceKey, con la GPU alquilada conectándose a ella, así que nada de esto tocó nuestro servicio de producción. El nombre de empresa que ves en el vídeo, Lumenframe Studio, es una cuenta de demo inventada.
Los pasos
Todo está en el ejemplo del SDK iris3b-text2image-custom-backend-private-nvidia. Necesitas una cuenta de InferenceKey con un worker NVIDIA (una máquina GPU conectada a tu proyecto). El fichero .env del ejemplo lista las claves que lee. También puedes subir el backend a mano desde el panel. El SDK se compila en local a partir del repo, así que primero van los pasos de preparación del README:
cp .env.example .env        # SDK token, API key, project, worker id, tenant id, dashboard session token
python -m venv .venv && . .venv/bin/activate
pip install maturin requests
( cd ../../bindings/python && maturin develop --release )
python publish.py           # packages backend.py and registers it as "iris3b-text2image"
python main.py              # deploy, wait until ready, generate two images, clean up
main.py pide a InferenceKey una copia del modelo siempre encendida en tu worker, espera a que esté sirviendo, envía peticiones para dos imágenes, guarda los PNG y borra el modelo en ejecución (el workload) al salir (pon IK_KEEP_ALIVE=1 para mantenerlo). Para el modelo base de 100 pasadas, python publish.py --variant base y después IRIS_VARIANT=base python main.py. Abajo está la misma forma de petición que enviamos a nuestra copia local de InferenceKey, con el prompt y la semilla de la abeja de las imágenes de más abajo. En el servicio alojado tiene la misma forma, aunque allí no la llamamos:
curl https://cloud.inferencekey.com/endpoint/$INFERENCEKEY_PROJECT/iris3b-turbo/v1/images/generations \
  -H "Authorization: Bearer $INFERENCEKEY_API_KEY" -H "Content-Type: application/json" \
  -d '{"model": "default", "prompt": "Macro photograph of a honeybee covered in pollen on a lavender flower, shallow depth of field", "size": "1024x1024", "seed": 110, "n": 1}'
Lo que medimos
El primer arranque tardó 130 segundos desde la llamada de despliegue hasta estar listo. Preparar el entorno de Python llevó 16 segundos y descargar el fichero de 6 GB del modelo Turbo, 12. Casi todo el resto fue el lector del prompt: unos 72 segundos para descargarlo y luego unos 27 segundos para cargar los dos modelos en la GPU.
Una vez en marcha, una imagen de 1024x1024 tardó 1,96 segundos en la GPU todas las veces, y de 2,8 a 2,9 segundos desde la petición hasta tener el PNG terminado de vuelta en el cliente. Tamaños mayores y no cuadrados, como 1344x896, tardaron de 2,2 a 2,9 segundos de GPU. Cuatro imágenes en una sola petición tardaron 7,0 segundos, 1,75 segundos cada una. El fabricante da 0,7 segundos por imagen en una H100. No hicimos esa prueba en igualdad de condiciones. El probador de imágenes del panel de InferenceKey mostró 2,9 segundos por imagen.
El modelo base, con sus 100 pasadas, tardó unos 90 segundos por imagen de 1024x1024 y 106 a 1344x896. Eso es unas 46 veces más lento que Turbo. Con los dos cargados en la misma tarjeta, usaron casi todos sus 48 GB en el pico.
Las imágenes
Turbo funcionó bien con fotos, estilos y texto corto. Estas salen tal cual de la API, 4 pasadas cada una:
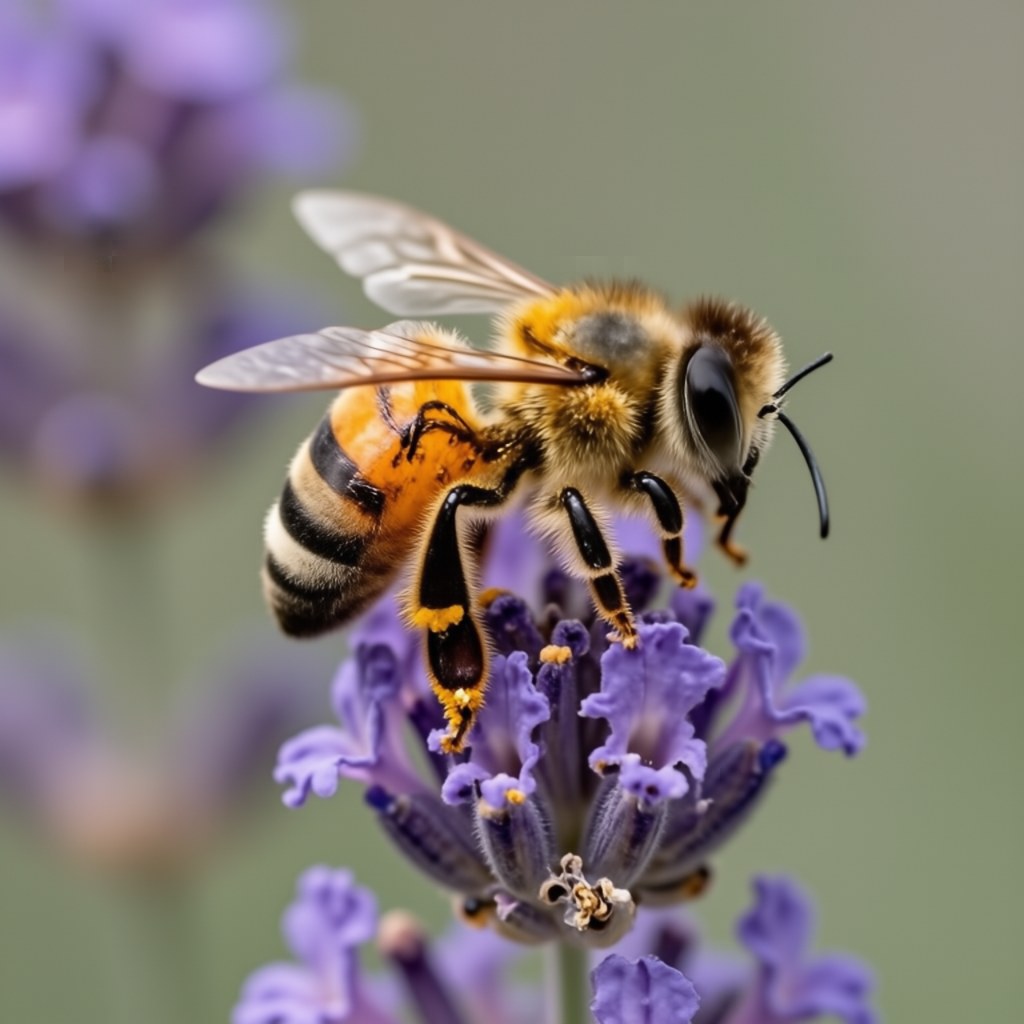
"Macro photograph of a honeybee covered in pollen on a lavender flower, shallow depth of field". 1024x1024, 1,96 s en la GPU.
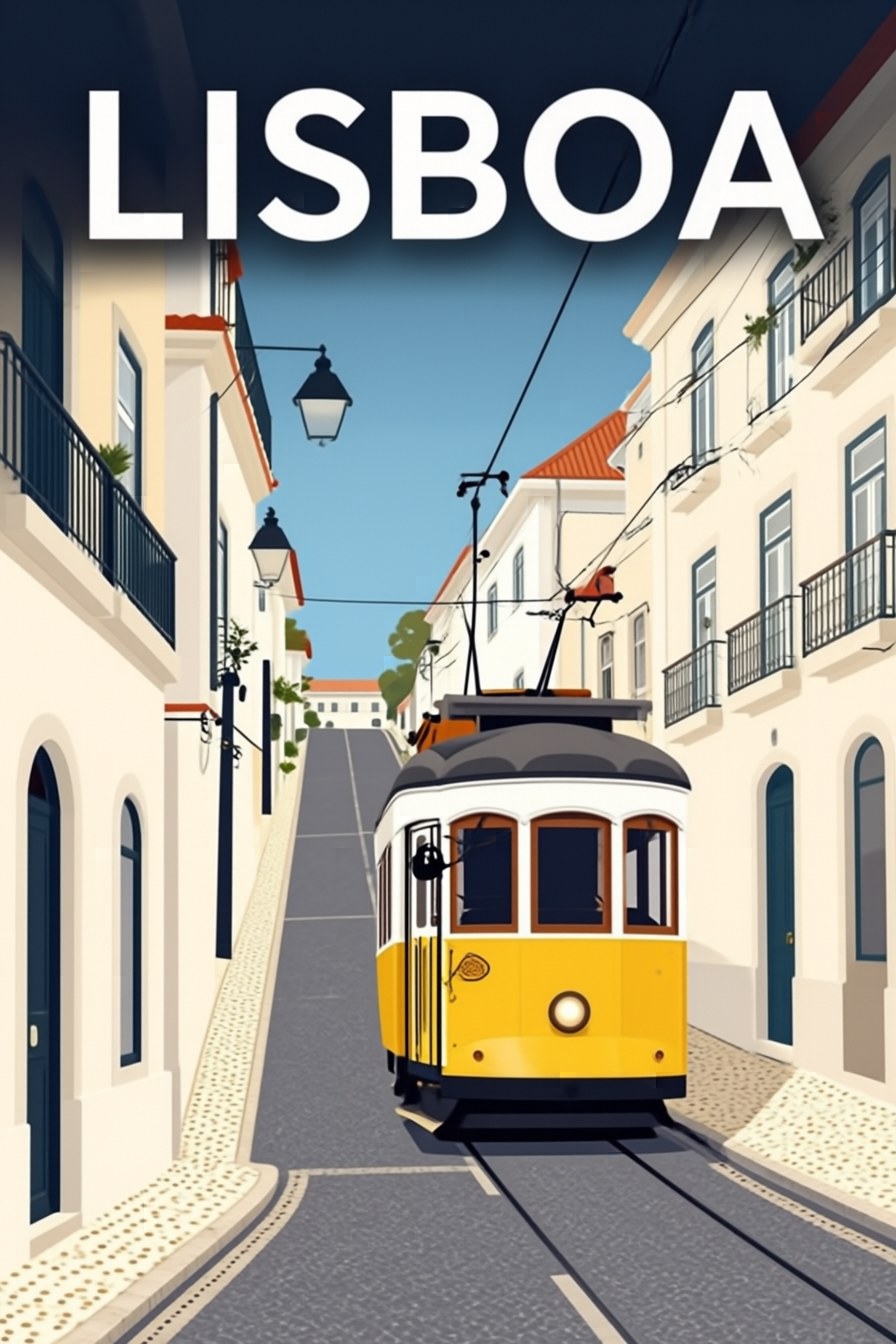
Un póster de viaje de estilo vectorial plano. La palabra LISBOA salió bien escrita. 896x1344, 2,65 s.
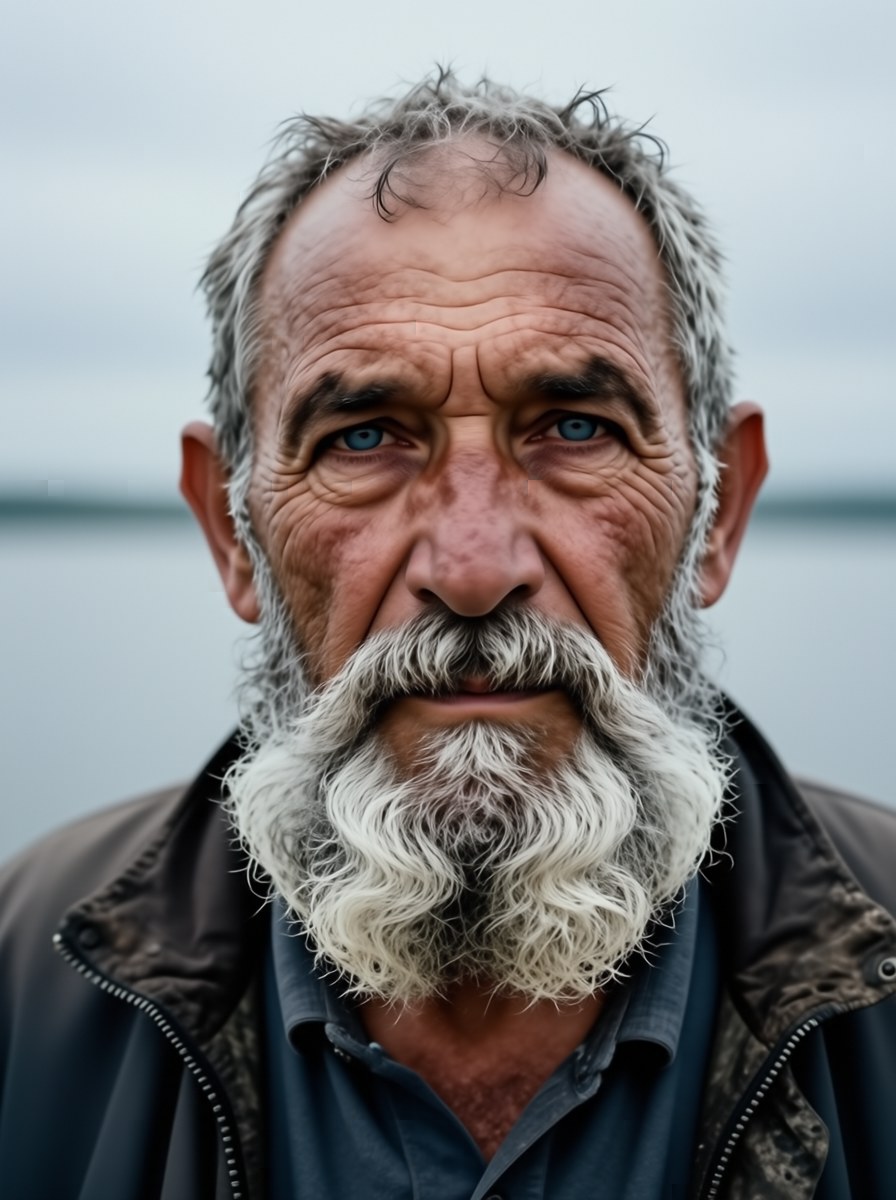
Un pescador anciano, con estilo de foto analógica. 896x1200, 2,77 s.
También escribió bien "OPEN LATE" en un cartel esmaltado, y dibujó exactamente siete manzanas cuando le pedimos siete. Tres prompts salieron mal. En el panel, "a lighthouse keeper's cat asleep on a windowsill, stormy sea outside, oil painting" dio la ventana y el faro, pero ningún gato que pudiéramos ver. Pedimos "two hands of a pianist" y obtuvimos las dos de la derecha, más una tercera mano abajo a la izquierda y parte de otra en el borde superior izquierdo (esa puede ser un reflejo en la laca negra).
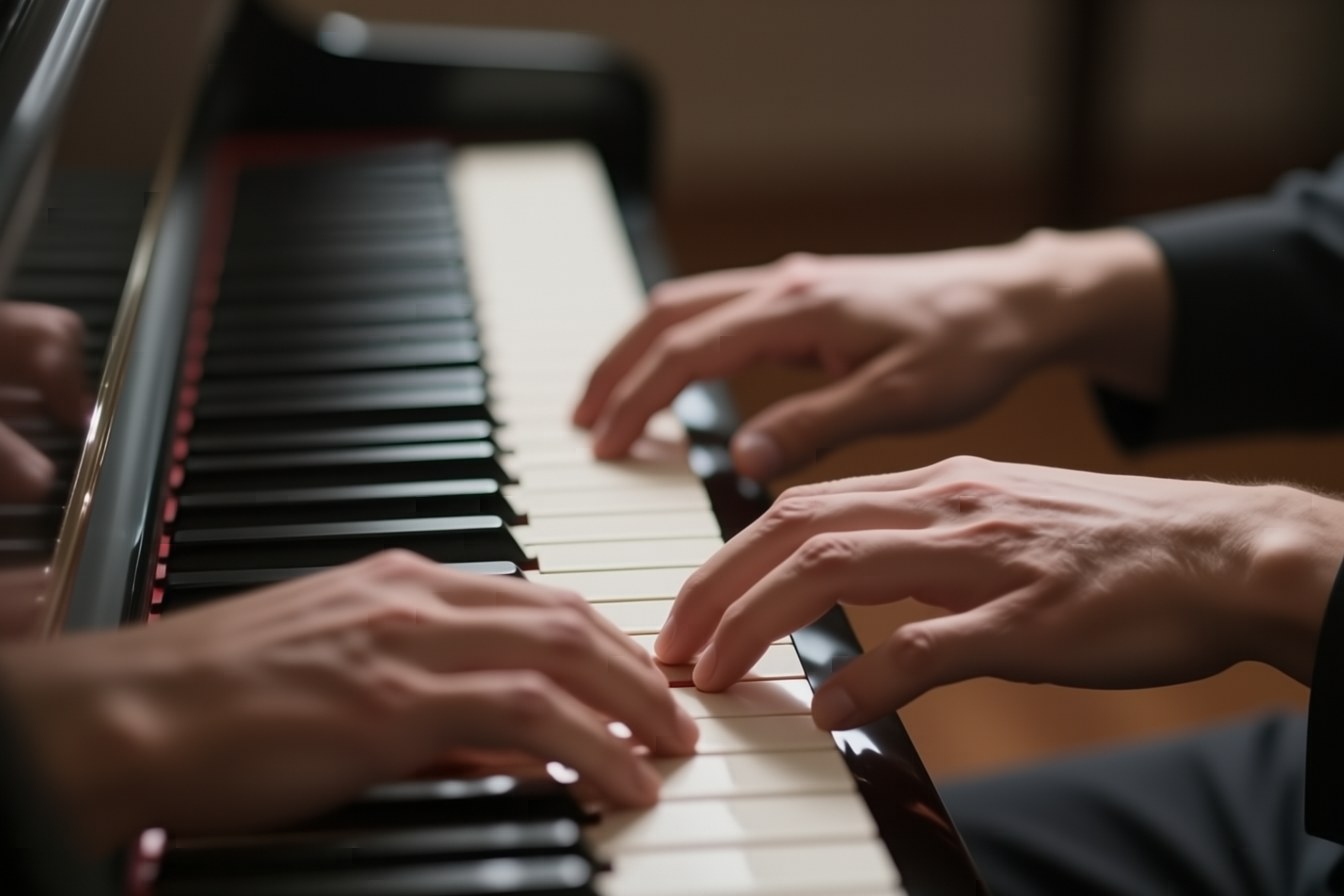
"Close-up of two hands of a pianist playing a grand piano". Mira abajo a la izquierda. 1344x896, 2,83 s.
Y una pizarra de menú con cuatro precios fue demasiado. Turbo se comió los puntos decimales ("Cappuccino 320", "Daily soup 550"). El modelo base, en 90 segundos en lugar de 2, puso el punto decimal en tres de los cuatro precios. Cappuccino siguió saliendo como 320, y escribió dos veces el precio del espresso y la línea del croissant.
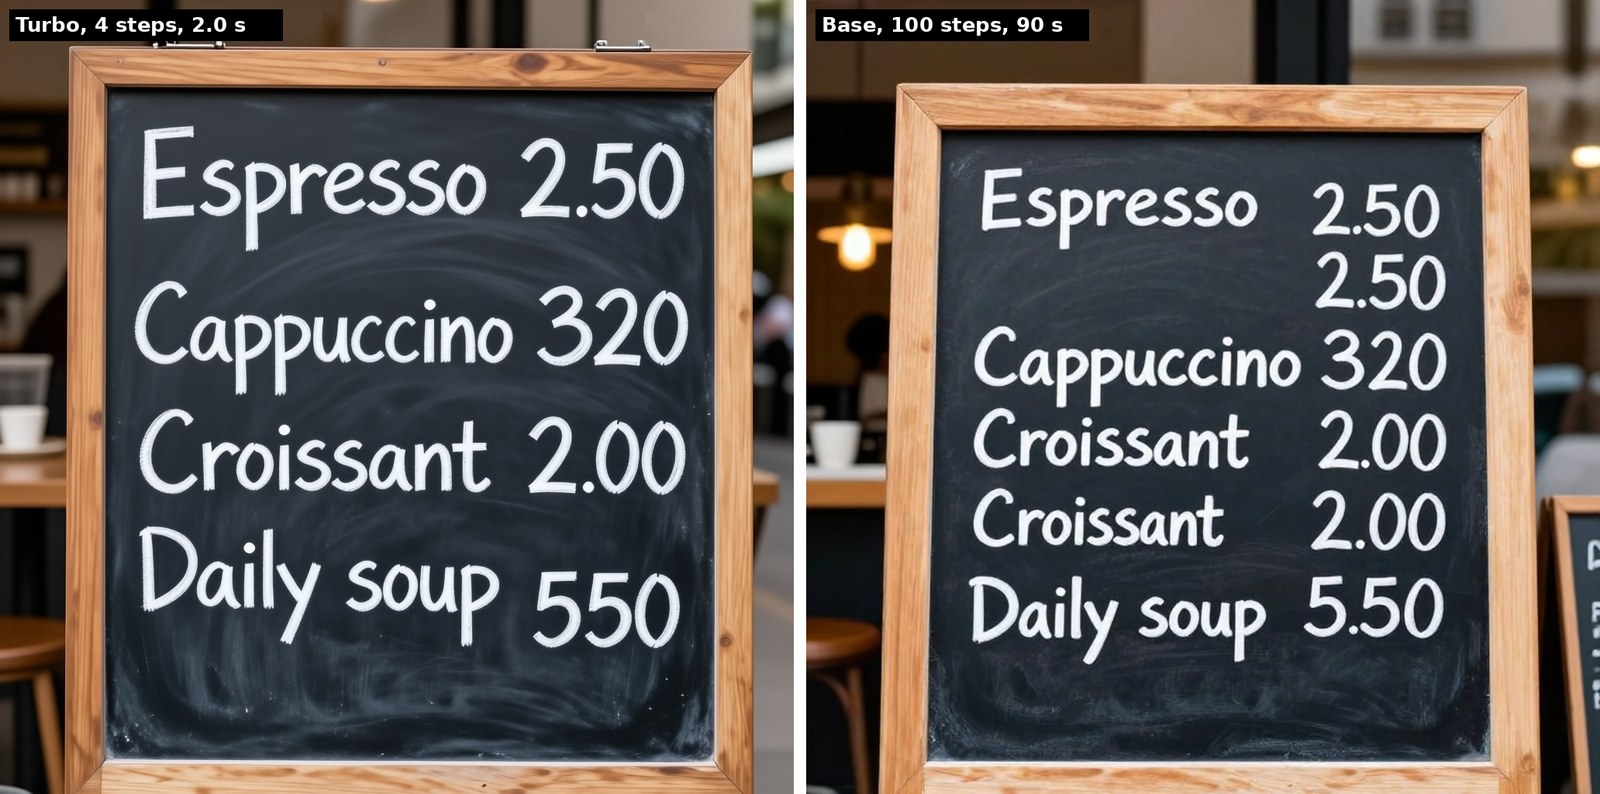
Mismo prompt y misma semilla, Turbo a la izquierda, base a la derecha. El prompt pedía "Espresso 2.50, Cappuccino 3.20, Croissant 2.00, Daily soup 5.50".
En una foto sin texto cuesta distinguirlos a simple vista, y de eso se trata con Turbo:
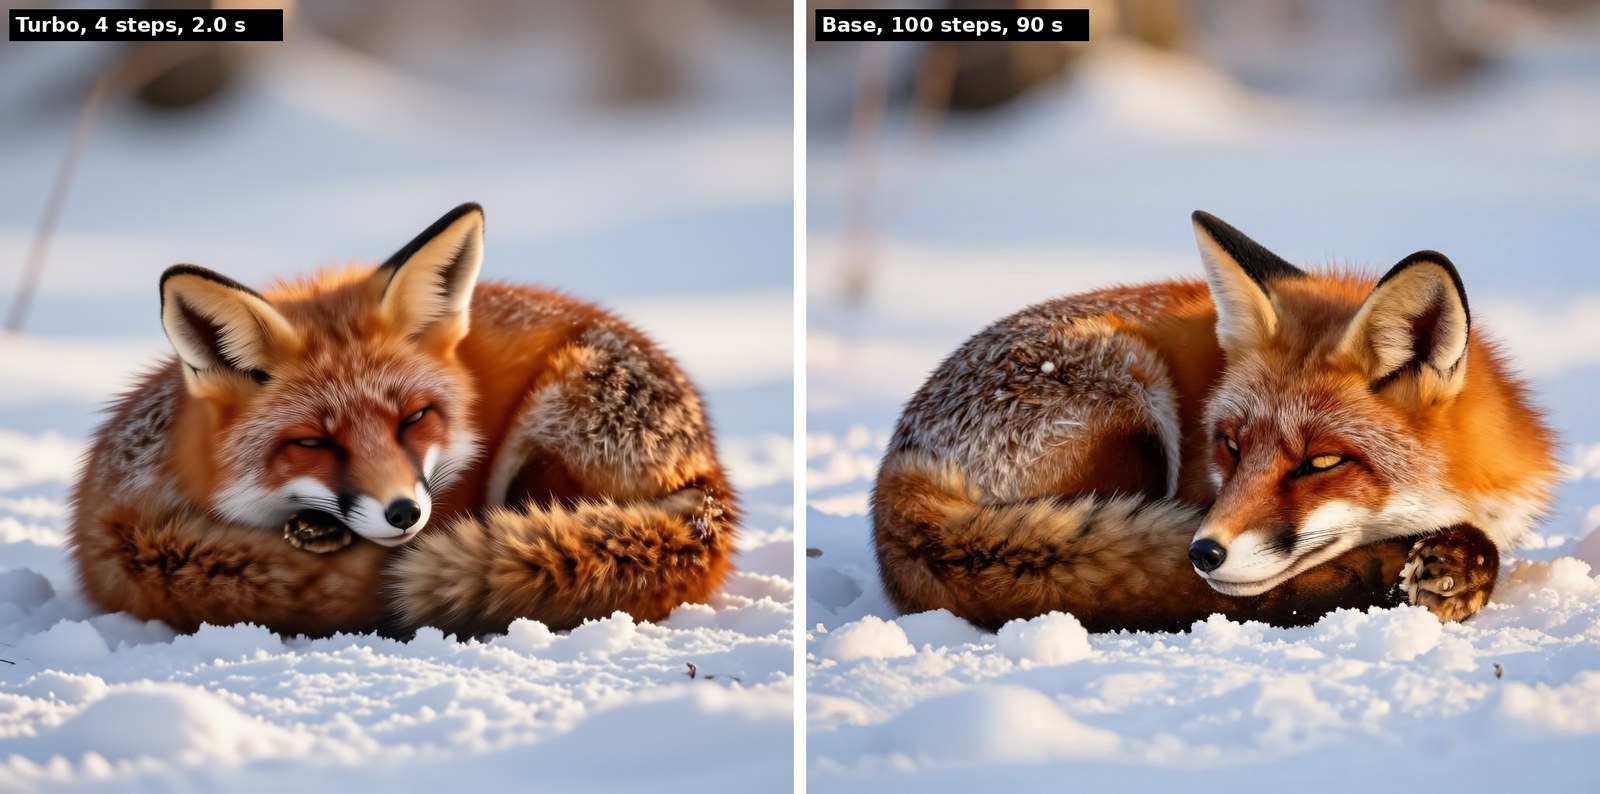
Mismo prompt y misma semilla. 2 segundos frente a 90.
La demo
La grabación de 72 segundos de abajo es el panel de InferenceKey durante la prueba: los dos workloads de Iris ejecutándose en la A40 (llamada a40-render-01), el probador de imágenes generando la abeja y el cartel "OPEN LATE" en 2,9 segundos cada uno, y la vista en directo con ocho peticiones pasando.
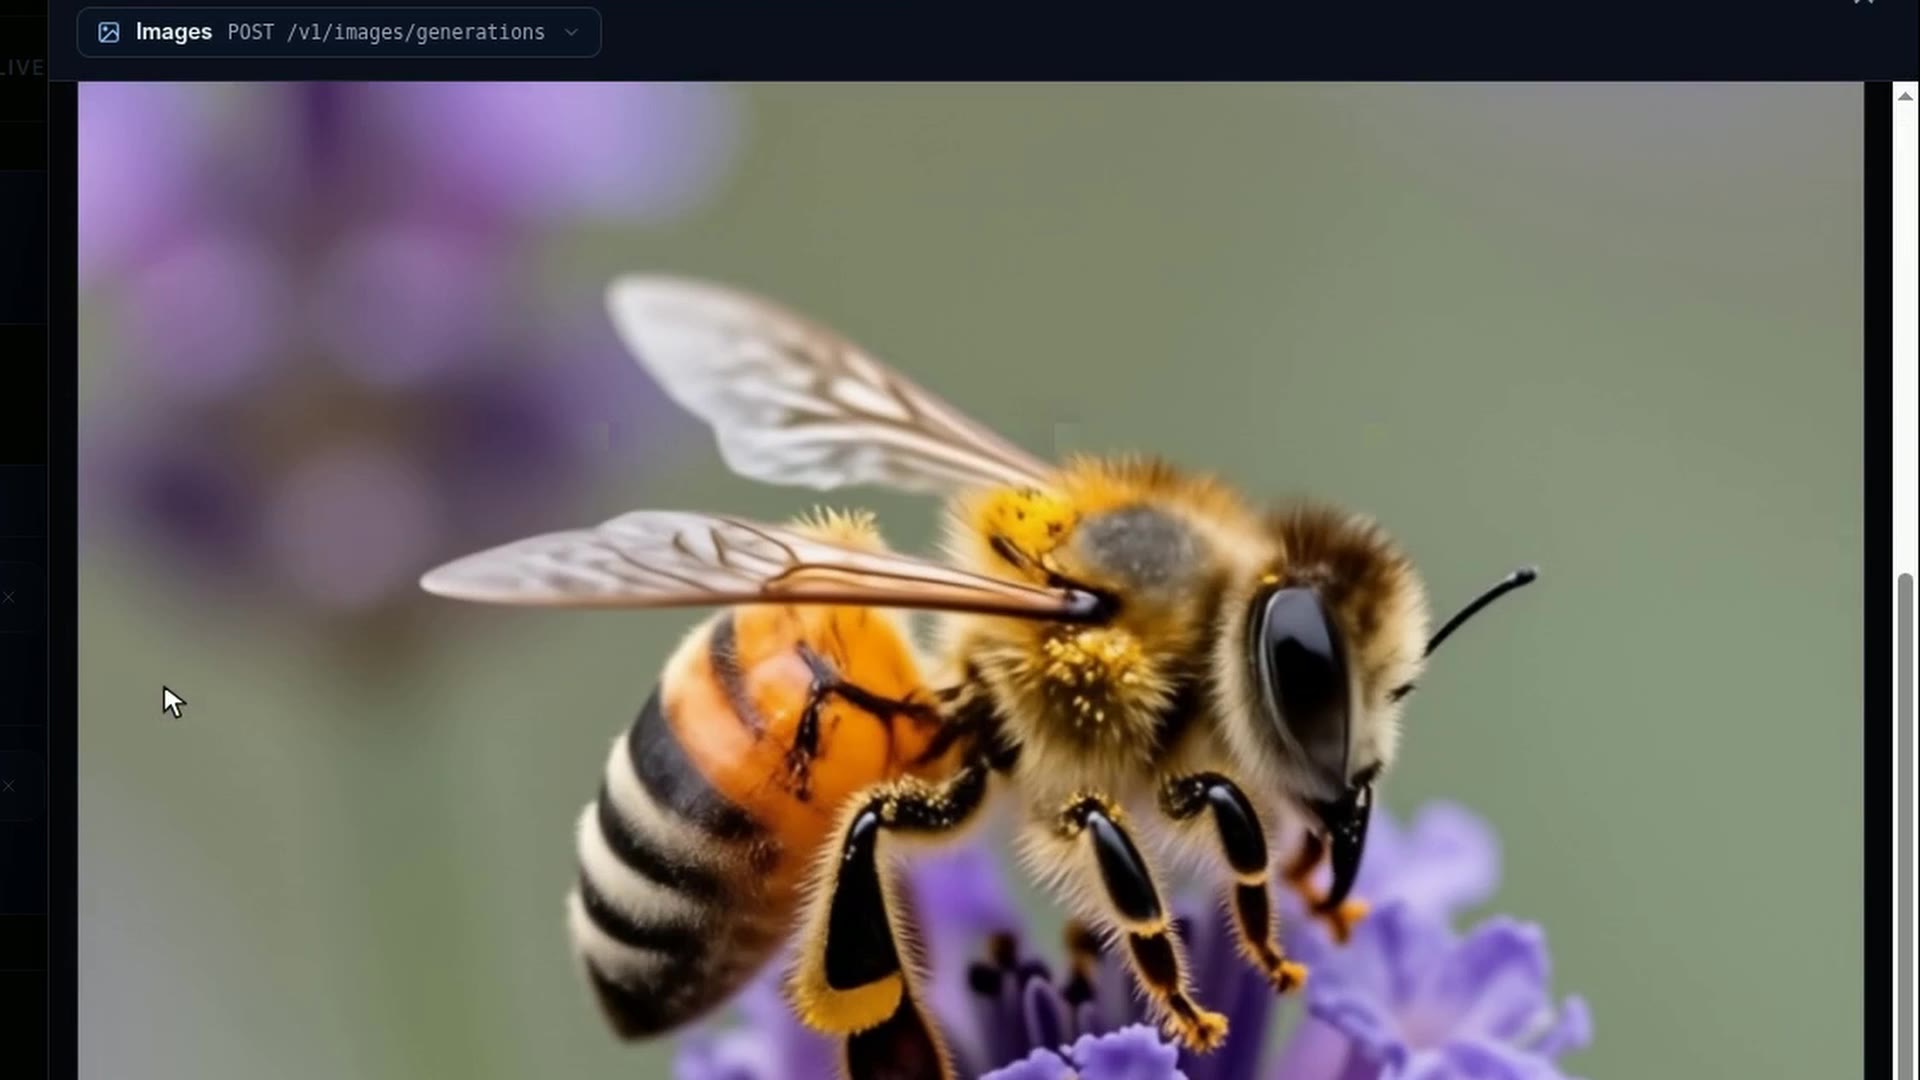
Haz clic en la imagen para reproducir el MP4 (72,5 s, 7,4 MB).
Lo que falló, y una cosa que salió bien
Turbo funcionó de principio a fin, y el probador de imágenes y la vista en directo del panel funcionaron con nuestro backend sin cambios. Por el camino nos topamos con cuatro asperezas del lado de InferenceKey, ninguna grave. Los números 1, 3 y 4 son cómo funciona la plataforma hoy, así que volverán a pasar. El número 2 lo vimos una vez, en una ejecución:
- Una respuesta demasiado grande se convirtió en una espera de cinco minutos. Dos imágenes PNG en una sola petición sumaron 9,1 MB, más que el límite de 8 MB para un único mensaje dentro de InferenceKey. El worker lo supo al instante y descartó el resultado, pero el cliente solo recibió un timeout genérico al cabo de unos 5 minutos. Nuestro ejemplo ahora rechaza ese caso de inmediato con un error claro y ofrece JPEG o WebP, con los que cuatro imágenes caben en 688 KB.
- El "listo" llegó 50 segundos antes de tiempo. Con dos modelos en un worker, la espera hasta estar listo del SDK dio el modelo base por listo a los 10 segundos. El "listo" que vio venía en realidad de Turbo, que se estaba reiniciando con nuestro código actualizado en la misma GPU. No se perdió ninguna petición: la primera esperó en la cola hasta que el modelo base estuvo arriba.
- Sin ajustes por workload. A un custom backend no se le puede decir "esta vez ejecuta el modelo base" desde los ajustes del workload. En su lugar, publicamos el modelo base como un segundo backend con su propio nombre.
- Un límite de arranque fijo. Un custom backend tiene 300 segundos para estar listo, y en una máquina GPU alquilada que InferenceKey prepara por ti no hay forma de ampliarlo. El nuestro tardó 113 segundos, pero una descarga más lenta podría llegar al límite.
Lo que salió bien: cuando arreglamos el problema 1 y volvimos a publicar el backend, InferenceKey detectó el cambio y reinició por sí solo el modelo en ejecución con el código nuevo, en 23 segundos, sin ningún paso manual.
Quién hizo qué
Iris-3B es trabajo de Sperid Labs: el modelo, la versión Turbo, las versiones de profundidad y de ampliación de fotos, los scripts de entrenamiento, la demo pública y el paper de Hanqiu Li Cai y Chema Garabito. El primer Iris rápido, de 4 pasadas, salió de la comunidad: pentacoxian-dev creó iris-3b-turbo-lora en una sola GPU de consumo. Qwen3-VL-4B-Instruct, el modelo que lee el prompt, es del equipo Qwen de Alibaba. La etapa que convierte cada tesela en píxeles sigue el diseño de PixelDiT, el modelo de otro grupo (los autores escribieron su propio código para ella). El entrenamiento también se apoya en métodos publicados por otros grupos, entre ellos un modelo de imagen de Meta (DINOv2) usado como guía al principio del entrenamiento. La lista completa está en la sección para ingenieros. El vídeo de noticias de AI Search es donde oímos hablar de él por primera vez.
Nuestra parte: leer las fuentes, escribir el custom backend y el ejemplo del SDK, ejecutarlo en InferenceKey, medirlo y grabar la demo.
Qué sacar en claro
Si necesitas un modelo de imagen abierto que puedas usar comercialmente y que haga una imagen de 1024x1024 en unos 2 segundos en una A40 de 48 GB alquilada, merece la pena probar Iris-3B Turbo. Descarga la carpeta de Turbo, no el repo. Mantén unas expectativas realistas con el texto largo y con las manos, y prueba tus propios prompts antes de comprometerte: los benchmarks del fabricante y la reseña de AI Search lo sitúan por detrás de los mejores modelos abiertos, y no ejecutamos ninguno de ellos lado a lado. La idea de trabajar en el espacio de píxeles es investigación interesante, y los autores son los primeros en decirte que no ganó la comparación que ellos mismos plantearon.
La pregunta que dejamos abierta es la de la tarjeta barata. Turbo llegó a un pico de unos 23 GB en la A40. Saber si funciona en una RTX 4090 de 24 GB está a un python main.py de distancia en un worker que tenga una.
Para ingenieros
Modelo (README de GitHub, página de investigación, paper). Diffusion transformer de 3B que trabaja en el espacio de píxeles: sin VAE y sin espacio latente (la "red auxiliar" y el "código comprimido" del relato). 24 bloques de ancho 2560 (8 dual-stream + 16 single-stream), GQA con 20 cabezas de query / 5 de KV, patch size 16, y una cabeza pixel-transformer (PiT) de 4 bloques que sigue el diseño de la de PixelDiT (una implementación independiente, sin código de PixelDiT) decodifica cada token de patch a píxeles. Rectified flow, v-prediction, timesteps logit-normal. RoPE 2D, así que un único juego de pesos funciona con cualquier relación de aspecto hasta 1 MP aproximadamente. Text encoder: Qwen3-VL-4B-Instruct congelado, 12 capas ocultas combinadas por un adaptador de layer-attention aprendido. Paper: "Iris-3B: Going Beyond the Latent with Pixel-Space Diffusion Training, Conversion and Fine-Tuning", arXiv 2610.09450 v1, 7 de octubre de 2026, 19 páginas (leímos el resumen, no el texto completo).
Entrenamiento. Desde cero, 256 -> 512 -> 1024 px, y después SFT a 1024: 665K pasos (etapa 1 hasta 365K con batch 1024 y REPA sobre DINOv2-B/14, etapa 2 hasta 530K, etapa 3 hasta 625K con batch 512, SFT 625K-665K). Muon + AdamW, bf16, FSDP2, torchrun --nproc_per_node=8. Los scripts de entrenamiento están publicados. No se indican las horas de GPU (la página de investigación solo dice "a fraction" del cómputo de los modelos latentes).
Muestreo del base. 1024x1024, 100 pasos de DPM-Solver++ (orden 2), CFG 3. python scripts/sample.py --checkpoint iris-3b --prompt "...", flags --steps --seed --negative-prompt --txt-file --cfg-scale.
Turbo. Fine-tune completo de los 3B parámetros (no un LoRA) con Trajectory Distribution Matching, sin datos, en dos etapas (6 pasos durante 1.600 actualizaciones, luego 4 pasos durante 500). CFG 3.5 incorporado desde el teacher, sin CFG ni prompt negativo en inferencia, sigmas fijos 1, 0.938, 0.833, 0.625. Siete buckets de aspecto en torno a 1 MP: 1024x1024, 752x1344, 896x1344, 896x1200 y sus traspuestos. Pesos exportados en bf16, convertidos a FP32 y ejecutados bajo autocast BF16. API de Python iris3b.sampling.generate_few_step. Alternativa de la comunidad: iris-3b-turbo-lora de pentacoxian-dev, una destilación DMD2 a 4 pasos como LoRA de rango 64 (460 MB), que no hemos probado. Limitaciones que lista el fabricante: más flojo que el base con texto denso o largo, menos variedad entre semillas, posible grano tenue en fondos vectoriales planos, 4 pasos fijos. En general, el renderizado de texto y los recuentos exactos no siempre son fiables.
Mérito de los métodos. La arquitectura DiT, el diseño de la cabeza PiT de PixelDiT para decodificar patches a píxeles, el optimizador Muon a través de Dion de Microsoft, REPA con features de DINOv2-B/14 de Meta en la etapa 1 del entrenamiento del base, el sampler DPM-Solver++ para el modelo base, Trajectory Distribution Matching para Turbo, la receta HYPIR para el ampliador y el protocolo Marigold V2 para puntuar la profundidad.
Tabla de benchmarks (filas seleccionadas). Las filas de Iris las ejecutó Sperid Labs con los evaluadores oficiales a 1024², sin reescritura del prompt y sin best-of-N. Las demás filas se citan en la página de investigación como referencias de los informes de Qwen-Image y Z-Image. La página de investigación también lista SDXL, SD3 Medium, SD3.5 Large y Lumina-Image 2.0, que no copiamos aquí. La fila del LoRA de la comunidad sale de la card de HF y del README de GitHub.
| Modelo | GenEval | DPG | LongText EN | OneIG EN |
|---|---|---|---|---|
| Iris-3B | 0,798 | 86,52 | 0,857 | 0,540 |
| Iris-3B Turbo | 0,820 | 86,68 | 0,804 | 0,516 |
| iris-3b-turbo-lora r2-1000 (comunidad) | 0,760 | 85,05 | 0,733 | 0,486 |
| Qwen-Image 20B | 0,87 | 88,3 | 0,943 | 0,539 |
| Z-Image 6B (reescritura del prompt) | 0,84 | 88,1 | 0,935 | 0,546 |
| HiDream-I1-Full | 0,83 | 85,89 | 0,543 | 0,477 |
| Janus-Pro-7B | 0,80 | 84,19 | 0,019 | 0,267 |
| FLUX.1-dev 12B | 0,66 | 83,8 | 0,607 | 0,434 |
Fine-tunes (cifras del fabricante, sin probar por nosotros). Profundidad (depth/, unos 12 GB): log depth relativa, invariante afín, 10K pasos, AbsRel 0,071 y delta1 0,946 de media zero-shot sobre NYUv2, KITTI, ETH3D, ScanNet y DIODE (protocolo Marigold V2), scripts/depth.py photo.jpg --out depth_out. Ampliador (upscaler/, unos 12 GB): restauración adversarial en un paso (receta HYPIR), 10K pasos, 4x, LPIPS 0,292 y PSNR 20,68 en DIV2K val, teselas de 1024x1024 con stride 512 y mezcla gaussiana, salida limitada por defecto a 2048x4096 (21 teselas), scripts/upscale.py photo.jpg --out upscaled. Los dos hacen un único forward pass con un prompt vacío y sin text encoder. La demo de Gradio con los tres modelos necesita unos 45 GB, unos 20 GB de pico con IRIS_OFFLOAD=1. El HF Space funciona en ZeroGPU.
Ficheros (API de HF, 2026-10-12): model.safetensors en la raíz 11.950.112.680 B (base en fp32), turbo/model.safetensors 5.975.089.200 B, depth/model.safetensors 11.952.738.184 B, upscaler/model.safetensors 11.950.112.680 B, repo completo 41.911.753.317 B. Safetensors de Qwen3-VL-4B-Instruct: 8,88 GB. Requisitos: Python 3.11+, PyTorch 2.7.1+, GPU NVIDIA con CUDA.
Nuestro montaje. RunPod NVIDIA A40 48 GB, SECURE, EU-SE-1, 0,59 USD/h con 100 GB de disco, imagen runpod/pytorch:1.0.2-cu1281-torch280-ubuntu2404, driver 580.159.03 (CUDA 13.0). Worker arrancado por un manager local de InferenceKey a través de túneles HTTP + TCP. La RTX 4090 COMMUNITY figuraba a 0,34 USD/h en ese momento. Pod creado a las 21:07:30Z (worker en línea hacia las 21:08:40Z), borrado a las 21:33:35Z. Venv del backend: Python 3.12.3, torch 2.14.1+cu130, transformers 5.19.0, instalados con uv. Código upstream fijado en 73bcdf59 (un commit posterior de documentación, cee0c13, entró el mismo día y no se probó).
Backend (backend.py). Un custom backend porque Iris-3B no es ni un pipeline de Diffusers ni un fichero GGUF, los formatos que cargan los backends integrados. Slugs iris3b-text2image (Turbo) e iris3b-base-text2image (base), paquete de 5.209 a 5.800 bytes. setup() descarga el tarball upstream en el commit fijado (alrededor de 1 MB), hace snapshot_download de turbo/* (o config.yaml + model.safetensors para el base), construye IrisDiT en el meta device, carga los pesos, los convierte a fp32 y construye el encoder Qwen3-VL. process() acepta la entrada nativa o el JSON de imágenes de OpenAI, ajusta los tamaños de Turbo a los 7 buckets, genera el ruido en la CPU a partir de la semilla (el mismo ruido inicial en cualquier GPU), ejecuta generate_few_step (Turbo) o generate (base, 100 pasos, CFG 3) bajo autocast bf16 y devuelve {data: [{b64_json}]}. n de 1 a 4, output_format png, jpeg o webp, y PNG con n > 1 responde 400. Commit del ejemplo del SDK 05869ee en main.
Mediciones (tiempo de GPU = medido por el backend con cuda.synchronize(); ida y vuelta = del cliente HTTP al manager, incluyendo codificación y NATS):
| Caso | GPU s | Ida y vuelta s |
|---|---|---|
Arranque en frío de Turbo, de ensure() a listo | 130 (venv 16, código upstream + descarga de Turbo 12,2, descarga del encoder ~72, carga de los dos modelos ~27) | |
| Primeras dos llamadas de Turbo, 1024x1024 / 1344x752 | 3,45 / 2,75 | 5,80 / 3,73 |
| Turbo 1024x1024, 5 prompts | de 1,956 a 1,961 | de 2,83 a 2,92 |
| Turbo 1344x752 | 1,91 | de 2,79 a 2,83 |
| Turbo 1344x896 | 2,21 / 2,83 | 3,46 / 3,84 |
| Turbo 896x1200 / 1200x896 / 896x1344 | 2,77 / 2,87 / 2,65 | 3,76 / 3,83 / 3,71 |
| Turbo n=4, 1024x1024, JPEG | 7,02 (1,75 por imagen) | 7,41 (688 KB) |
| Turbo, 8 peticiones JPEG secuenciales | de 2,10 a 2,25 | |
| Turbo, probador de imágenes del panel | 2,86 y 2,92 | |
| Base 1024x1024, 100 pasos, CFG 3 | 89,8 / 90,0 | |
| Base 1344x896 | 106,1 |
Arranque del base con el encoder ya en caché: listo 60 s después de ensure() (pesos 42,7 s, carga 11,4 s). VRAM de nvidia-smi cada 0,5 s: Turbo 20.384 MiB cargado, 21.831 MiB de pico (19,9 / 21,3 GiB, o 21,4 / 22,9 GB). Turbo + base 40.455 MiB cargados, 44.890 MiB de pico (39,5 / 43,8 GiB). Potencia máxima de la tarjeta 308,8 W frente a un límite de 300 W.
Problemas de la plataforma, al detalle.
n=2PNG a 1024x1024 = 9.097.397 bytes, por encima del max payload de NATS de 8.388.608 bytes. Worker:job result refused by JetStream for good (code max_payload: ...); the result is given up and the job is acked. Cliente: HTTP 504inference_timeoutal cabo de unos 300 s. El worker lo sabe al instante; el gateway solo se entera por timeout. Mitigado en el ejemplo (400 en 0,08 s).wait_until_ready("iris3b-base")volvió a los +10 s, mientras que el backend base estuvo listo a las 21:19:52. El evento que vio fue el reciclado en caliente de Turbo en el mismo worker. Primera ida y vuelta del base: 141 s (unos 50 s en cola + 90 s de generación).- El worker lanza
python -m inferencekey.backend.serve --port N --backend <entrypoint>sin--config-json, así que un custom backend no recibe configuración por workload. Solución provisional: una segunda clase de entrypoint,Iris3BBaseText2ImageBackend, con su propio slug. INFERENCEKEY_CUSTOM_BACKEND_READY_TIMEOUT_SECSvale 300 s por defecto y no se puede configurar en los pods de RunPod que provisiona el manager. Este montaje tardó 113 s.
Lo positivo: volver a publicar el backend recicló en caliente el workload en ejecución en 23 s (custom backend artifact changed for a running workload; recycling its backend).
Límites.
- Un solo modelo de GPU (A40), una ejecución, una semilla por prompt.
- Un solo cliente enviando peticiones una tras otra (las 8 peticiones "en directo" fueron secuenciales), y un solo workload sirviendo tráfico a la vez. Sin prueba de concurrencia ni de rendimiento bajo carga. No probamos una tarjeta de 24 GB, así que queda abierto si Turbo entra en la práctica en una RTX 4090 o una A5000.
- Los 0,7 s por imagen del fabricante en una H100 con batch 4 no se reprodujeron. Nuestros 1,75 s por imagen con batch 4 son en una A40 y no son una comprobación en igualdad de condiciones.
- Los juicios de calidad son nuestros, tras mirar cada imagen que generamos, con una semilla por prompt. No ejecutamos un modelo de imagen comprimida (latente) como FLUX, Z-Image o Qwen-Image con los mismos prompts, así que la comparación de calidad con ellos son las tablas del fabricante y la opinión de un revisor. No evaluamos la variedad entre semillas ni el grano en fondos planos.
- Las puntuaciones de profundidad y del ampliador, las de los benchmarks y las conclusiones del paper son afirmaciones de Sperid Labs. Leímos el resumen del paper, no el texto completo.
- La reseña de AI Search dijo que el modelo base de 12 GB "should fit on most consumer GPUs". Con la conversión a fp32 de los autores y el text encoder, Turbo solo midió 20.384 MiB (19,9 GiB) cargado, así que cuenta con más memoria que el tamaño del fichero.
Fuentes: model card de Iris-3B, repo de GitHub, paper, página de investigación, HF Space, ejemplo del SDK, vídeo de AI Search (capítulo en el 36:35).