Iris-3B: ein offenes Bildmodell, das seine Pixel selbst zeichnet, etwa zwei Sekunden pro Bild
Iris-3B ist ein offenes Bildmodell, das die Pixel selbst zeichnet. Wir haben die schnelle Turbo-Version auf InferenceKey betrieben: etwa 2 s pro Bild, A40.
Am 5. Oktober hat Sperid Labs Iris-3B auf Hugging Face und GitHub veröffentlicht, ein offenes Bildmodell, das jedes Pixel des Bildes selbst zeichnet. Die Modelle, mit denen es sich vergleicht, darunter FLUX und Qwen-Image, tun das nicht: Sie skizzieren eine komprimierte Version, und ein separater Decoder macht daraus Pixel.
Ihr Paper hat auf dem Modell außerdem zwei zusätzliche Werkzeuge gebaut, eines, das Tiefe schätzt, und eines, das Fotos restauriert, und laut Abstract hat die Arbeit in Pixeln bei keinem der beiden einen klaren Vorteil gebracht.
Am 12. Oktober kam eine schnelle „Turbo“-Version dazu, die ein Bild in 4 Durchgängen statt 100 fertigstellt (diese Modelle starten mit zufälligem Rauschen und räumen es bei jedem Durchgang ein Stück auf). Wir haben sie im News-Video von AI Search vom 11. Oktober entdeckt, die Quellen gelesen und Turbo selbst auf einer gemieteten GPU laufen lassen, ausgeliefert über InferenceKey. Das kannst du mitnehmen, bevor es ins Detail geht:
| Iris-3B Turbo | |
|---|---|
| Lizenz | Apache-2.0 für Code und Gewichte: Du darfst es kommerziell nutzen, verändern und weiterverbreiten |
| Größe | 3 Milliarden Parameter (die gelernten Zahlen im Modell, ein grobes Maß für seine Größe), dazu ein Modell mit 4 Milliarden Parametern, das den Prompt liest |
| Download, den du brauchst | etwa 6 GB für Turbo, dazu etwa 9 GB für den Prompt-Leser. Nicht das ganze 42-GB-Repo |
| GPU-Speicher, gemessen | etwa 21 GB geladen, etwa 23 GB in der Spitze: knapp unter einer 24-GB-Gaming-Karte (nicht getestet), bequem auf der 48-GB-Karte, die wir genutzt haben |
| Zeit pro Bild in 1024x1024, gemessen auf einer NVIDIA A40 | 1.96 s auf der GPU, etwa 2.9 s von Anfang bis Ende über die API |
| Dasselbe Bild mit dem Basismodell und 100 Durchgängen | etwa 90 s |
| Erster Start, von „deploy“ bis bereit für das erste Bild (GPU-Maschine schon online) | etwa 2 Minuten (130 s) |
| Wo es in unserem Test schwächelt | ein Menü mit vier Preisen, zusätzliche Hände bei einem Pianisten, eine Katze, die nicht auftauchte |
Darum ist mir das wichtig. Der übliche Weg, generierte Bilder in ein Produkt zu bringen, ist eine gehostete API, die pro Bild abrechnet. Ein Apache-2.0-Modell dieser Größe kannst du selbst auf einer gemieteten GPU betreiben: Du behältst die Gewichte, du entscheidest, wann sich die Version ändert, du weißt, wohin Prompts und Bilder gehen, und du zahlst für die Zeit der Karte statt pro Bild. Bei der Qualität ist es nicht das beste offene Bildmodell, und wo es schwächelt, sagen wir weiter unten, aber es ist eine echte Option, wenn du das Modell besitzen willst, statt Bilder bei jemand anderem zu mieten.
Die meisten Bildmodelle arbeiten auf einer MP3 des Bildes
Das übliche Rezept geht so. Ein kleines Hilfsnetz presst jedes Bild in einen kompakten Code, ein bisschen so, wie eine MP3 eine Aufnahme zusammenpresst. Das große Modell lernt, in diesem Code zu zeichnen, was viel billiger ist, als jedes Pixel zu zeichnen, und das Hilfsnetz entpackt das Ergebnis am Ende wieder zu einem vollen Bild. Nennen wir sie Modelle mit komprimiertem Bild: Mit genau diesen vergleicht Sperid Labs Iris.
Die Forschungsseite von Sperid Labs argumentiert gegen die MP3. Kompression verliert Details, schreiben sie, und der komprimierte Code sei „biased“ und „texture-focused“: Er ist mehr auf das Aussehen von Oberflächen abgestimmt als auf exakte Details. Ihr Ziel sind Aufgaben, bei denen feine Details zählen, etwa die Tiefe aus einem Foto zu schätzen oder ein Foto mit niedriger Auflösung zu restaurieren. Also lässt Iris-3B die MP3 weg und arbeitet am Master: Es schneidet das Bild in Kacheln von 16 mal 16 Pixeln, arbeitet direkt auf diesen Kacheln, und eine kleine letzte Stufe macht aus jeder Kachel wieder echte Pixel. Das Design dieses letzten Schritts haben die Autoren von einer anderen Forschungsgruppe übernommen (Credits weiter unten). Es gibt keinen separaten Decoder und keinen komprimierten Raum.
Den Prompt liest ein separates Modell, Qwen3-VL-4B-Instruct vom Qwen-Team von Alibaba, ebenfalls Apache-2.0, das Iris beim ersten Lauf herunterlädt.
Das Urteil der Autoren selbst: kein klarer Gewinn durch Pixel
Der Abstract des Papers sagt sein Ergebnis ohne Umschweife: „We find no significant improvement from using a pixel-space generative prior.“ Auf Deutsch: Die Werkzeuge für Tiefe und Fotorestaurierung auf einem Pixelmodell aufzubauen, hat sie nicht besser gemacht, als sie auf einem Modell mit komprimiertem Bild aufzubauen. Getestet haben sie das bei zwei Aufgaben gegen FLUX.2 Klein, ein Modell mit komprimiertem Bild von ähnlicher Größe (4 Milliarden Parameter). Bei der Tiefe gab es ein Unentschieden. Beim Vergrößern von Fotos um das 4-Fache hat Iris-3B FLUX.2 Klein nicht geschlagen.
Für das reine Erzeugen von Bildern sagt das Paper, dass Iris-3B gleichauf mit Qwen-Image liegt, einem Modell, das etwa siebenmal so groß ist (20 Milliarden Parameter), und zwar bei einem allgemeinen Test, wie gut Bilder ihren Prompts folgen (OneIG in der Tabelle unten). Die andere Spalte, LongText, bewertet, wie gut das Modell einen Satz oder mehr ins Bild schreibt.
| Modell | LongText (EN) | OneIG (EN) |
|---|---|---|
| Iris-3B (Basis) | 0.857 | 0.540 |
| Iris-3B Turbo | 0.804 | 0.516 |
| Qwen-Image (20B) | 0.943 | 0.539 |
| Z-Image (6B, Prompt-Umschreibung) | 0.935 | 0.546 |
| FLUX.1-dev (12B) | 0.607 | 0.434 |
Die Werte reichen von 0 bis 1, höher ist besser. „Prompt-Umschreibung“: Der Wert von Z-Image wurde gemessen, nachdem ein Assistent jeden Prompt ausführlicher umgeschrieben hatte, was ihm hilft. Die Iris-Zeilen hat Sperid Labs gemessen. Die anderen Zeilen zitiert ihre Forschungsseite aus den Berichten zu Qwen-Image und Z-Image. Nichts davon haben wir nachgemessen. Weitere Zeilen und zwei weitere Spalten stehen im Abschnitt für Engineers.
Schau auf die Spalte LongText: Iris-3B kommt auf 0.857, Qwen-Image auf 0.943. Da liegt Iris-3B klar hinter Qwen-Image und Z-Image, und Turbo liegt ein wenig hinter seinem eigenen Basismodell. Das passt zu dem, was wir weiter unten bei einer Preistafel gesehen haben. Der Rezensent von AI Search hat es deutlicher gesagt: Die Qualität sei „not as good as the leading open models out there“, aber „a decent lightweight alternative“. Wir haben kein Modell mit komprimiertem Bild mit denselben Prompts laufen lassen, dieser Qualitätsvergleich besteht also aus den Tabellen des Anbieters und der Meinung eines Rezensenten, nicht aus unseren Bildern.
Ein Netz, drei Aufgaben
Dasselbe Iris-Netz, für jede Aufgabe ein wenig nachtrainiert, kommt im selben Download auch als zwei weitere Werkzeuge. Eines schätzt die Tiefe aus einem einzelnen Foto (wie weit jeder Punkt entfernt ist, relativ zu den anderen, nicht in Metern). Das andere, ein Foto-Vergrößerer, vergrößert ein Foto um das 4-Fache und stellt seine Details wieder her, Kachel für Kachel. Beide laufen in einem einzigen Durchgang, ohne Prompt und ohne Textmodell. Sperid Labs nennt Werte für beide auf Standard-Testsets, aufgeführt im Abschnitt für Engineers. Getestet haben wir keines der beiden.
Turbo: vier Durchgänge statt hundert
Das Basismodell Iris-3B nutzt 100 Durchgänge, und jeder Durchgang lässt das Modell zweimal laufen (einmal mit deinem Prompt und einmal ohne, damit es das Bild in Richtung des Prompts schieben kann), was es noch langsamer macht. Turbo ist das ganze Modell, nachtrainiert, um in 4 Durchgängen mit je einem Lauf fertig zu werden. Laut Sperid Labs macht Turbo ein Bild in 1024x1024 in etwa 0.7 Sekunden auf einer H100, Nvidias Top-GPU fürs Rechenzentrum, wenn es vier auf einmal erzeugt. Diese Karte haben wir nicht getestet. Der Preis dafür, nach ihrer eigenen Liste von Grenzen: Turbo ist bei dichtem oder langem Text schwächer als das Basismodell, liefert weniger Vielfalt, wenn du denselben Prompt mehrmals anfragst, und kann auf flachen Hintergründen eine leichte Körnung hinterlassen.
Sperid Labs war nicht der Erste, der Iris schnell gemacht hat. Ihre eigene Model Card dankt pentacoxian-dev, der iris-3b-turbo-lora gebaut hat, eine Version mit 4 Durchgängen, verpackt als kleines Add-on von 460 MB und trainiert auf einer einzigen Consumer-GPU. Sie hat eine eigene Zeile in der Benchmark-Tabelle auf der Model Card von Sperid Labs. Wir haben das Turbo von Sperid Labs laufen lassen, nicht dieses.
Die 42-GB-Falle
Wenn du das Hugging-Face-Repo klonst, bekommst du vier Modelle: das Basismodell (etwa 12 GB), Turbo (etwa 6 GB), das Tiefenmodell (etwa 12 GB) und den Foto-Vergrößerer (etwa 12 GB). Das sind insgesamt 41.9 GB. Um schnell Bilder zu machen, brauchst du nur Turbo:
hf download speridlabs/iris-3b --include "turbo/*" --local-dir iris-3b
Der Prompt-Leser, Qwen3-VL-4B-Instruct, kommt obendrauf: weitere 8.88 GB, die beim ersten Lauf des Codes automatisch geladen werden.
So läuft es auf InferenceKey
Turbo lieferte etwa zwei Minuten nach dem Deploy-Aufruf Bilder über die InferenceKey-API aus (auf einer GPU-Maschine, die schon online war), mit etwa 2 Sekunden GPU pro Bild in 1024x1024. So geht es, und das ist unterwegs schiefgelaufen.
Die GPU und warum genau diese
Wir haben eine NVIDIA A40 mit 48 GB Speicher bei RunPod gemietet, in einem Rechenzentrum in der EU. Die naheliegende Wahl für ein „3B“-Modell wäre eine billigere 24-GB-Gaming-Karte wie eine RTX 4090. Die haben wir ausgelassen, weil der Code der Autoren das Modell so lädt: Er speichert jede Zahl des 3B-Netzes in doppelter Größe gegenüber der Datei, wie sie ausgeliefert wird, was etwa 12 GB belegt, und der Prompt-Leser legt etwa 8 GB drauf. Turbo allein kam gemessen auf etwa 21 GB geladen und etwa 23 GB in der Spitze. Eine 24-GB-Karte haben wir nicht ausprobiert, ob Turbo in der Praxis auf eine passt, ist also offen. Mit der 48-GB-Karte konnten wir außerdem das Basismodell mit 100 Durchgängen neben Turbo laden, für einen direkten Vergleich.
Für deine eigene Rechnung: Zum Listenpreis der A40 bei RunPod sind tausend Turbo-Bilder, je vier auf einmal, etwa 29 Minuten der Karte, grob 30 US-Cent, ohne Start- und Leerlaufzeit. Du zahlst für die Zeit der Karte statt pro Bild, und du wählst das Modell, nicht einen Anbieter.
Warum ein Custom Backend
Ein Backend ist das Stück Code, das ein Modell einmal lädt und dann Anfragen beantwortet. InferenceKey bringt fertige Backends für die üblichen Formate mit, in denen Bild- und Textmodelle verpackt werden, aber Iris-3B kommt in einem eigenen Format, also kann keines davon es ausführen. Deshalb haben wir ein eigenes in Python geschrieben, was InferenceKey erlaubt. Unseres hat etwa 5 KB, ohne Gewichte. Beim Start lädt es eine feste Version des Codes der Autoren herunter, holt nur den Turbo-Ordner von Hugging Face und lädt das Modell genauso wie die Autoren. Es beantwortet dieselbe Anfrageform /v1/images/generations, die die Bild-API von OpenAI nutzt, also kann jeder Client, der dieses Format spricht, es aufrufen.
Wir haben es auf einer privaten Testkopie von InferenceKey laufen lassen, mit der gemieteten GPU, die sich zu ihr zurückverbindet, also hat nichts hiervon unseren Produktivdienst berührt. Der Firmenname im Video, Lumenframe Studio, ist ein erfundenes Demo-Konto.
Die Schritte
Alles steht im SDK-Beispiel iris3b-text2image-custom-backend-private-nvidia. Du brauchst ein InferenceKey-Konto mit einem NVIDIA-Worker (eine GPU-Maschine, die mit deinem Projekt verbunden ist). Die .env-Datei des Beispiels listet die Schlüssel auf, die es liest. Du kannst das Backend auch von Hand im Dashboard hochladen. Das SDK wird lokal aus dem Repo gebaut, also kommen zuerst die Einrichtungsschritte aus dem README:
cp .env.example .env        # SDK token, API key, project, worker id, tenant id, dashboard session token
python -m venv .venv && . .venv/bin/activate
pip install maturin requests
( cd ../../bindings/python && maturin develop --release )
python publish.py           # packages backend.py and registers it as "iris3b-text2image"
python main.py              # deploy, wait until ready, generate two images, clean up
main.py bittet InferenceKey um eine dauerhaft laufende Kopie des Modells auf deinem Worker, wartet, bis sie ausliefert, schickt Anfragen für zwei Bilder, speichert die PNGs und löscht das laufende Modell (den Workload) beim Beenden (setze IK_KEEP_ALIVE=1, um ihn zu behalten). Für das Basismodell mit 100 Durchgängen: python publish.py --variant base und dann IRIS_VARIANT=base python main.py. Unten steht dieselbe Anfrageform, die wir an unsere lokale Kopie von InferenceKey geschickt haben, mit dem Prompt und dem Seed der Biene aus den Bildern weiter unten. Auf dem gehosteten Dienst hat sie dieselbe Form, dort haben wir sie aber nicht aufgerufen:
curl https://cloud.inferencekey.com/endpoint/$INFERENCEKEY_PROJECT/iris3b-turbo/v1/images/generations \
  -H "Authorization: Bearer $INFERENCEKEY_API_KEY" -H "Content-Type: application/json" \
  -d '{"model": "default", "prompt": "Macro photograph of a honeybee covered in pollen on a lavender flower, shallow depth of field", "size": "1024x1024", "seed": 110, "n": 1}'
Was wir gemessen haben
Der erste Start dauerte 130 Sekunden vom Deploy-Aufruf bis bereit. Die Python-Umgebung einzurichten dauerte 16 Sekunden, die 6 GB große Modelldatei von Turbo herunterzuladen 12. Der Großteil des Rests war der Prompt-Leser: etwa 72 Sekunden für den Download, dann etwa 27 Sekunden, um beide Modelle auf die GPU zu laden.
Sobald es lief, brauchte ein Bild in 1024x1024 jedes Mal 1.96 Sekunden auf der GPU und 2.8 bis 2.9 Sekunden von der Anfrage bis zum fertigen PNG beim Aufrufer. Größere, nicht quadratische Formate wie 1344x896 brauchten 2.2 bis 2.9 Sekunden GPU. Vier Bilder in einer Anfrage brauchten 7.0 Sekunden, 1.75 Sekunden pro Bild. Der Anbieter nennt 0.7 Sekunden pro Bild auf einer H100. Diesen direkt vergleichbaren Test haben wir nicht gemacht. Der Bildtester im InferenceKey-Panel zeigte 2.9 Sekunden pro Bild.
Das Basismodell mit seinen 100 Durchgängen brauchte etwa 90 Sekunden pro Bild in 1024x1024 und 106 in 1344x896. Das ist etwa 46-mal langsamer als Turbo. Mit beiden auf derselben Karte geladen, belegten sie in der Spitze fast die ganzen 48 GB.
Die Bilder
Turbo hat bei Fotos, Stilen und kurzem Text gut abgeschnitten. Diese kommen direkt aus der API, je 4 Durchgänge:
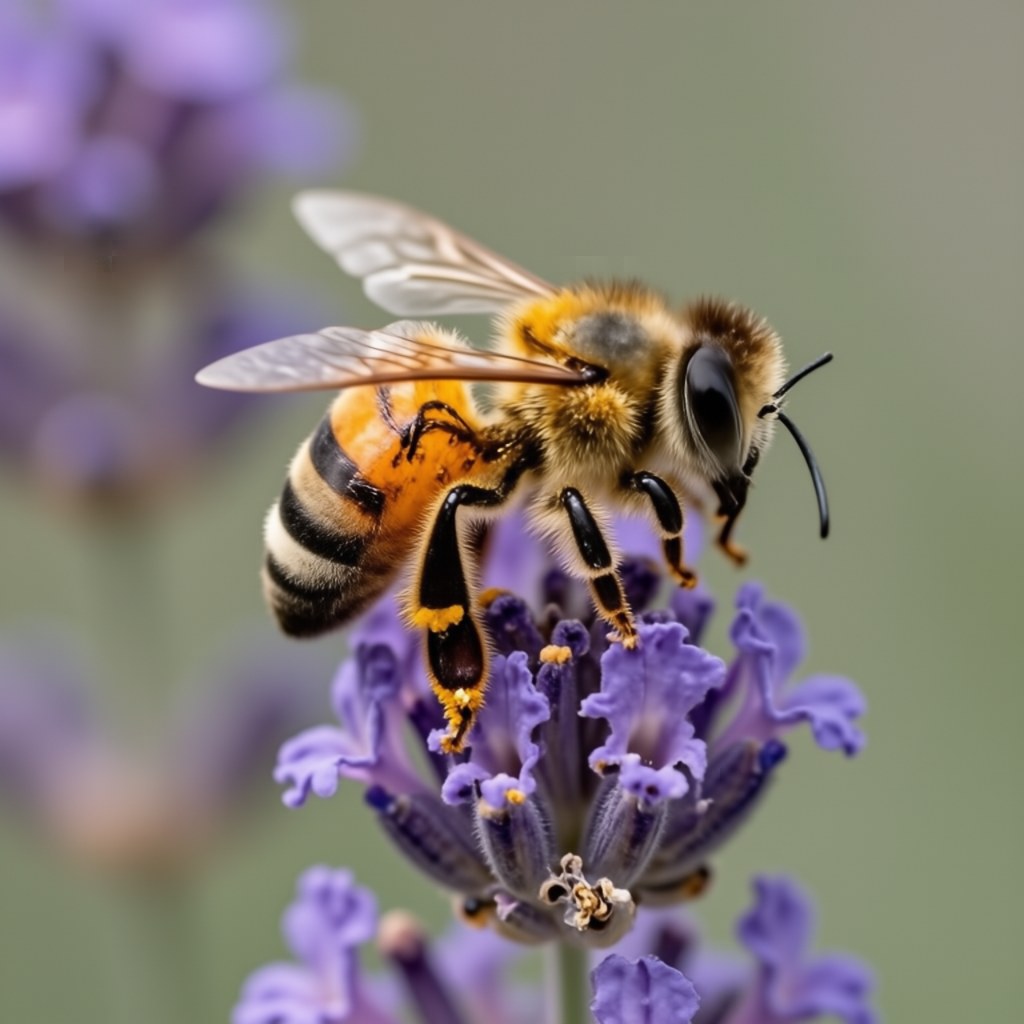
„Macro photograph of a honeybee covered in pollen on a lavender flower, shallow depth of field“. 1024x1024, 1.96 s auf der GPU.
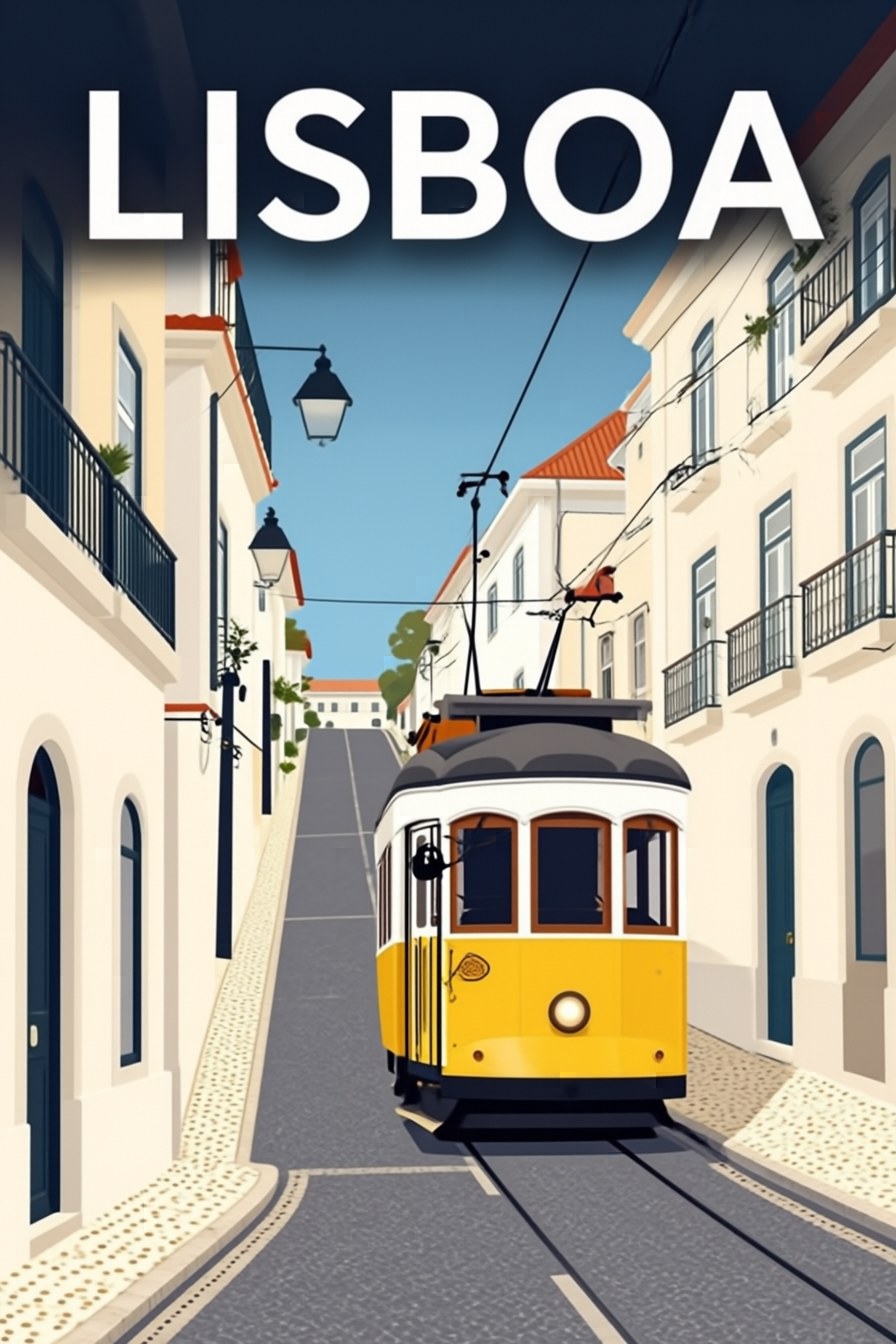
Ein Reiseplakat im flachen Vektorstil. Das Wort LISBOA kam richtig geschrieben heraus. 896x1344, 2.65 s.
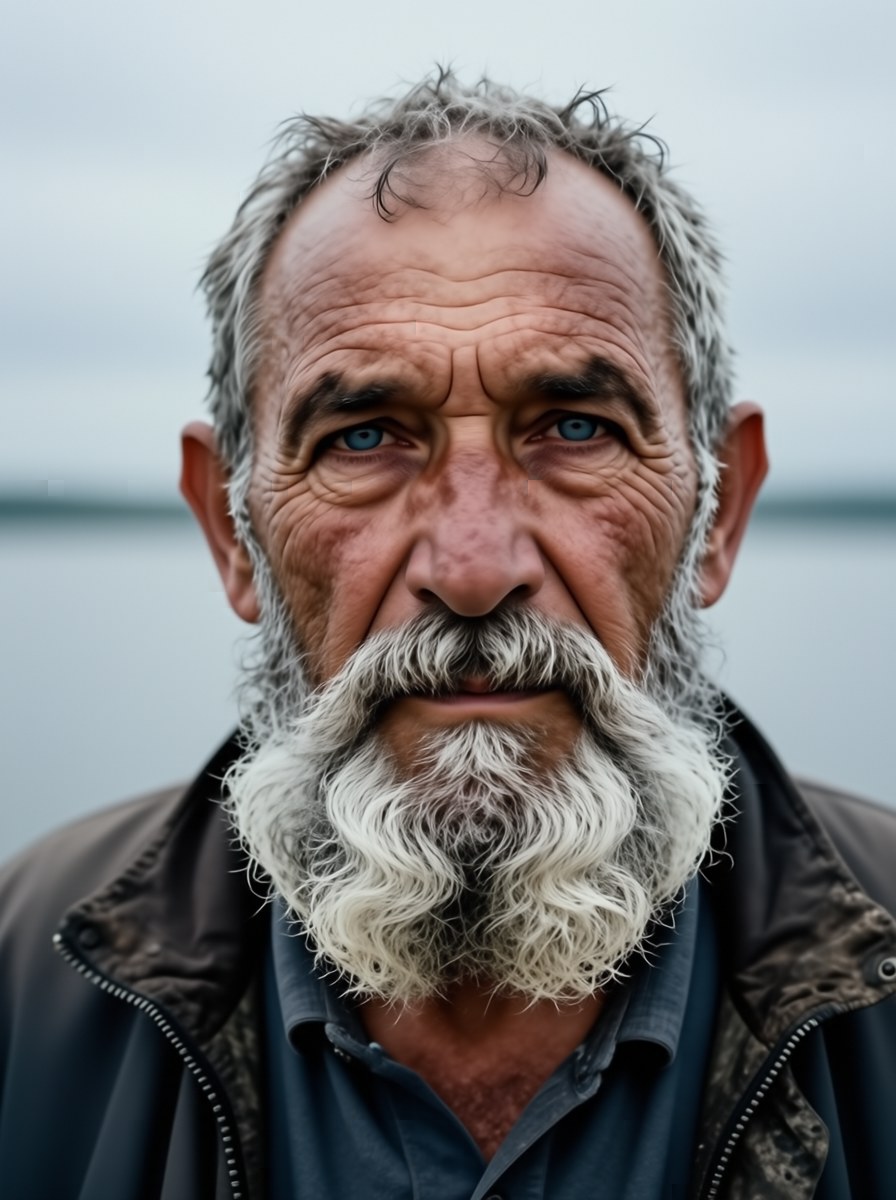
Ein alter Fischer im Stil eines Filmfotos. 896x1200, 2.77 s.
Es hat auch „OPEN LATE“ auf einem Emailschild richtig geschrieben und genau sieben Äpfel gezeichnet, als wir sieben verlangt haben. Drei Prompts gingen schief. Im Panel lieferte „a lighthouse keeper's cat asleep on a windowsill, stormy sea outside, oil painting“ das Fenster und den Leuchtturm, aber keine Katze, die wir hätten sehen können. Wir haben um „two hands of a pianist“ gebeten und bekamen die zwei rechts, dazu eine dritte Hand unten links und einen Teil einer weiteren am oberen linken Rand (die könnte eine Spiegelung im schwarzen Lack sein).
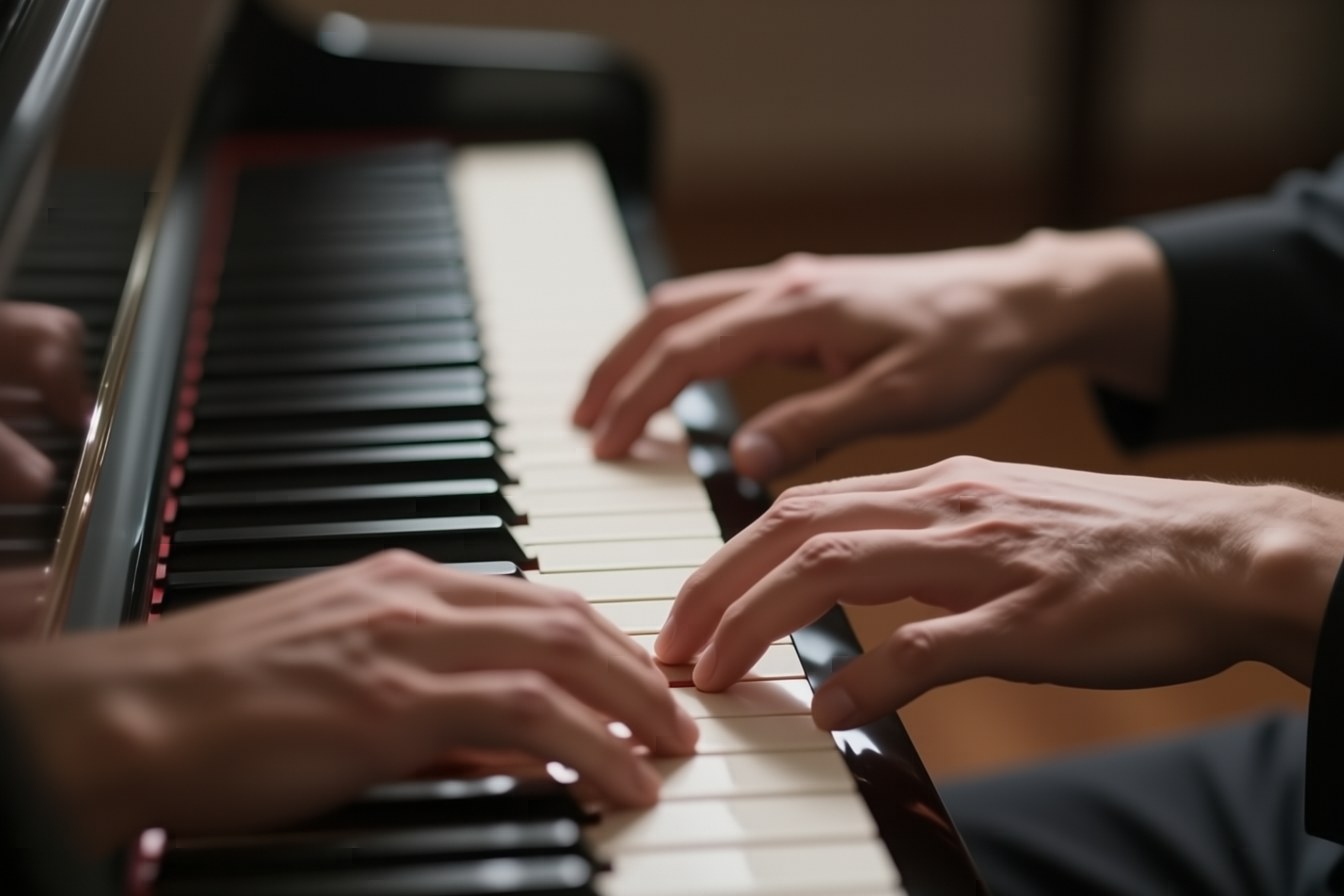
„Close-up of two hands of a pianist playing a grand piano“. Schau unten links. 1344x896, 2.83 s.
Und eine Kreidetafel mit vier Preisen war zu viel. Turbo hat die Dezimalpunkte weggelassen („Cappuccino 320“, „Daily soup 550“). Das Basismodell hat, in 90 Sekunden statt 2, den Dezimalpunkt bei drei der vier Preise gesetzt. Cappuccino kam trotzdem als 320 heraus, und den Espresso-Preis und die Croissant-Zeile hat es doppelt geschrieben.
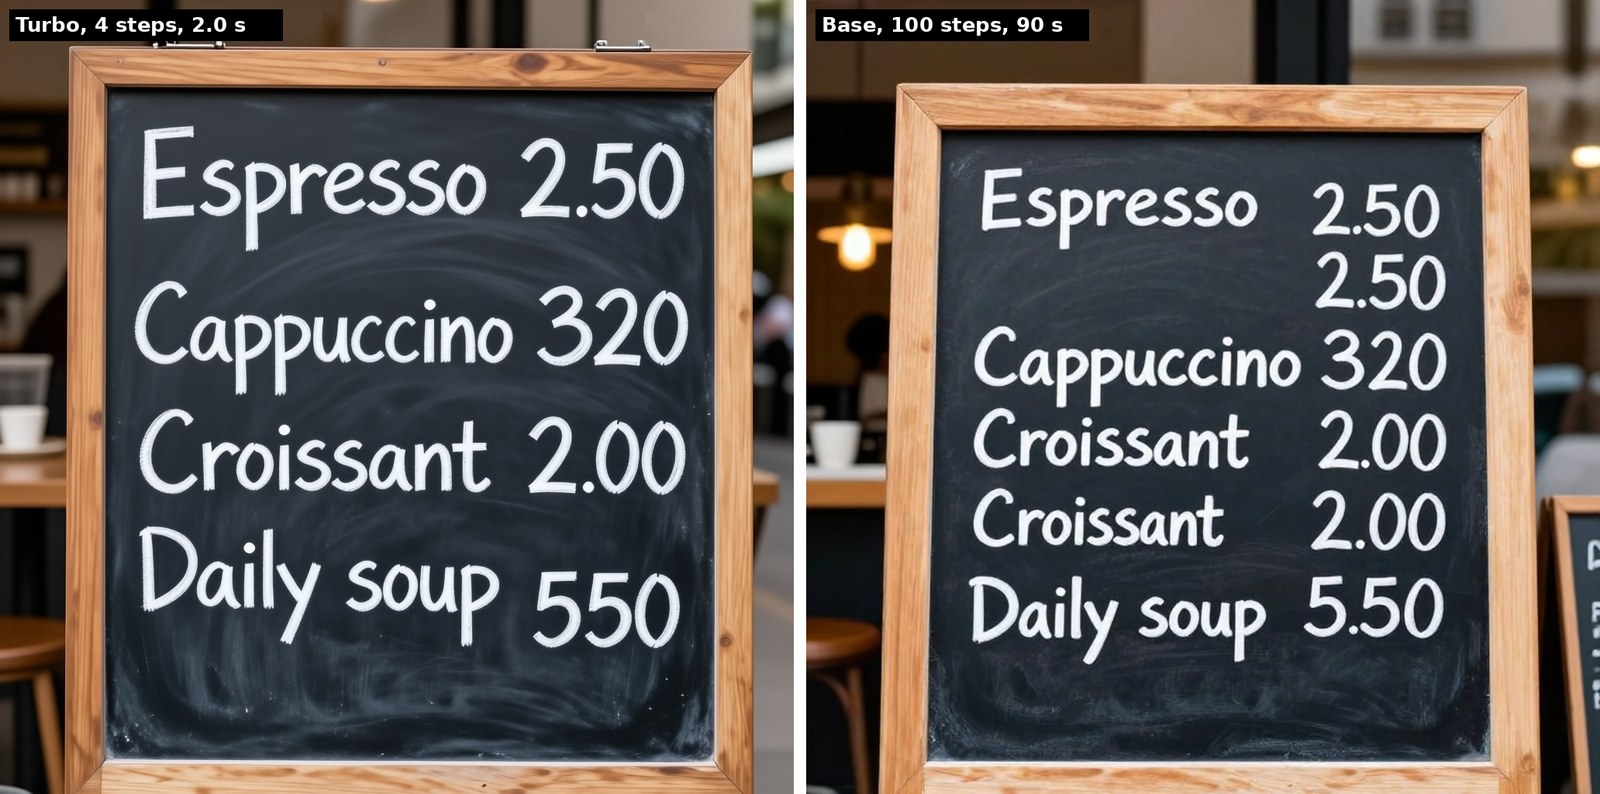
Gleicher Prompt und gleicher Seed, Turbo links, Basis rechts. Der Prompt verlangte „Espresso 2.50, Cappuccino 3.20, Croissant 2.00, Daily soup 5.50“.
Bei einem Foto ohne Text sind die beiden auf den ersten Blick kaum zu unterscheiden, und genau darum geht es bei Turbo:
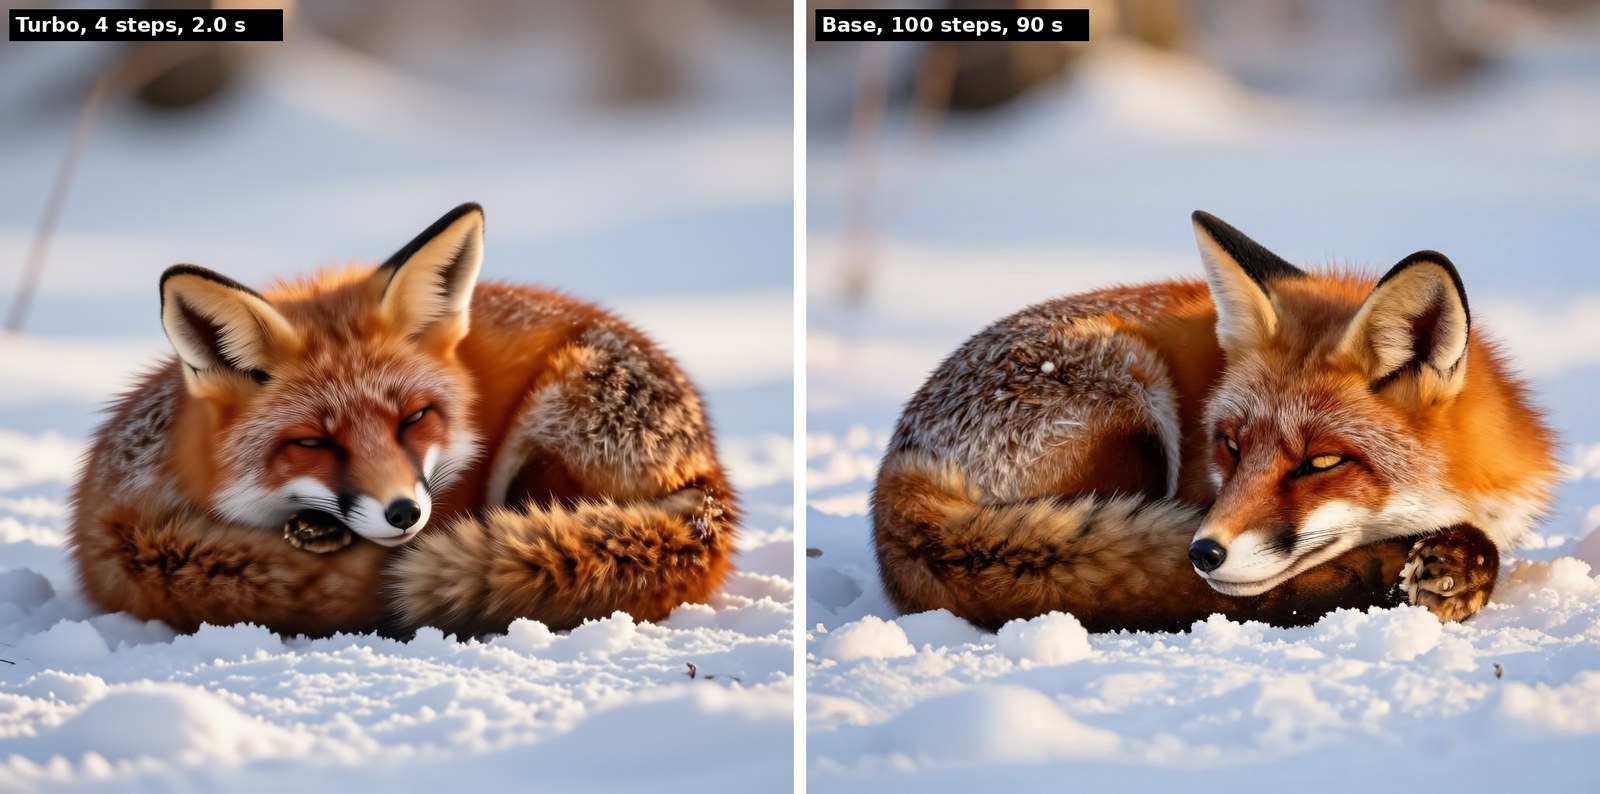
Gleicher Prompt und gleicher Seed. 2 Sekunden gegen 90.
Die Demo
Die 72 Sekunden lange Aufnahme unten zeigt das InferenceKey-Panel während des Tests: beide Iris-Workloads laufen auf der A40 (namens a40-render-01), der Bildtester macht die Biene und das Schild „OPEN LATE“ in je 2.9 Sekunden, und die Live-Ansicht zeigt acht Anfragen, die durchlaufen.
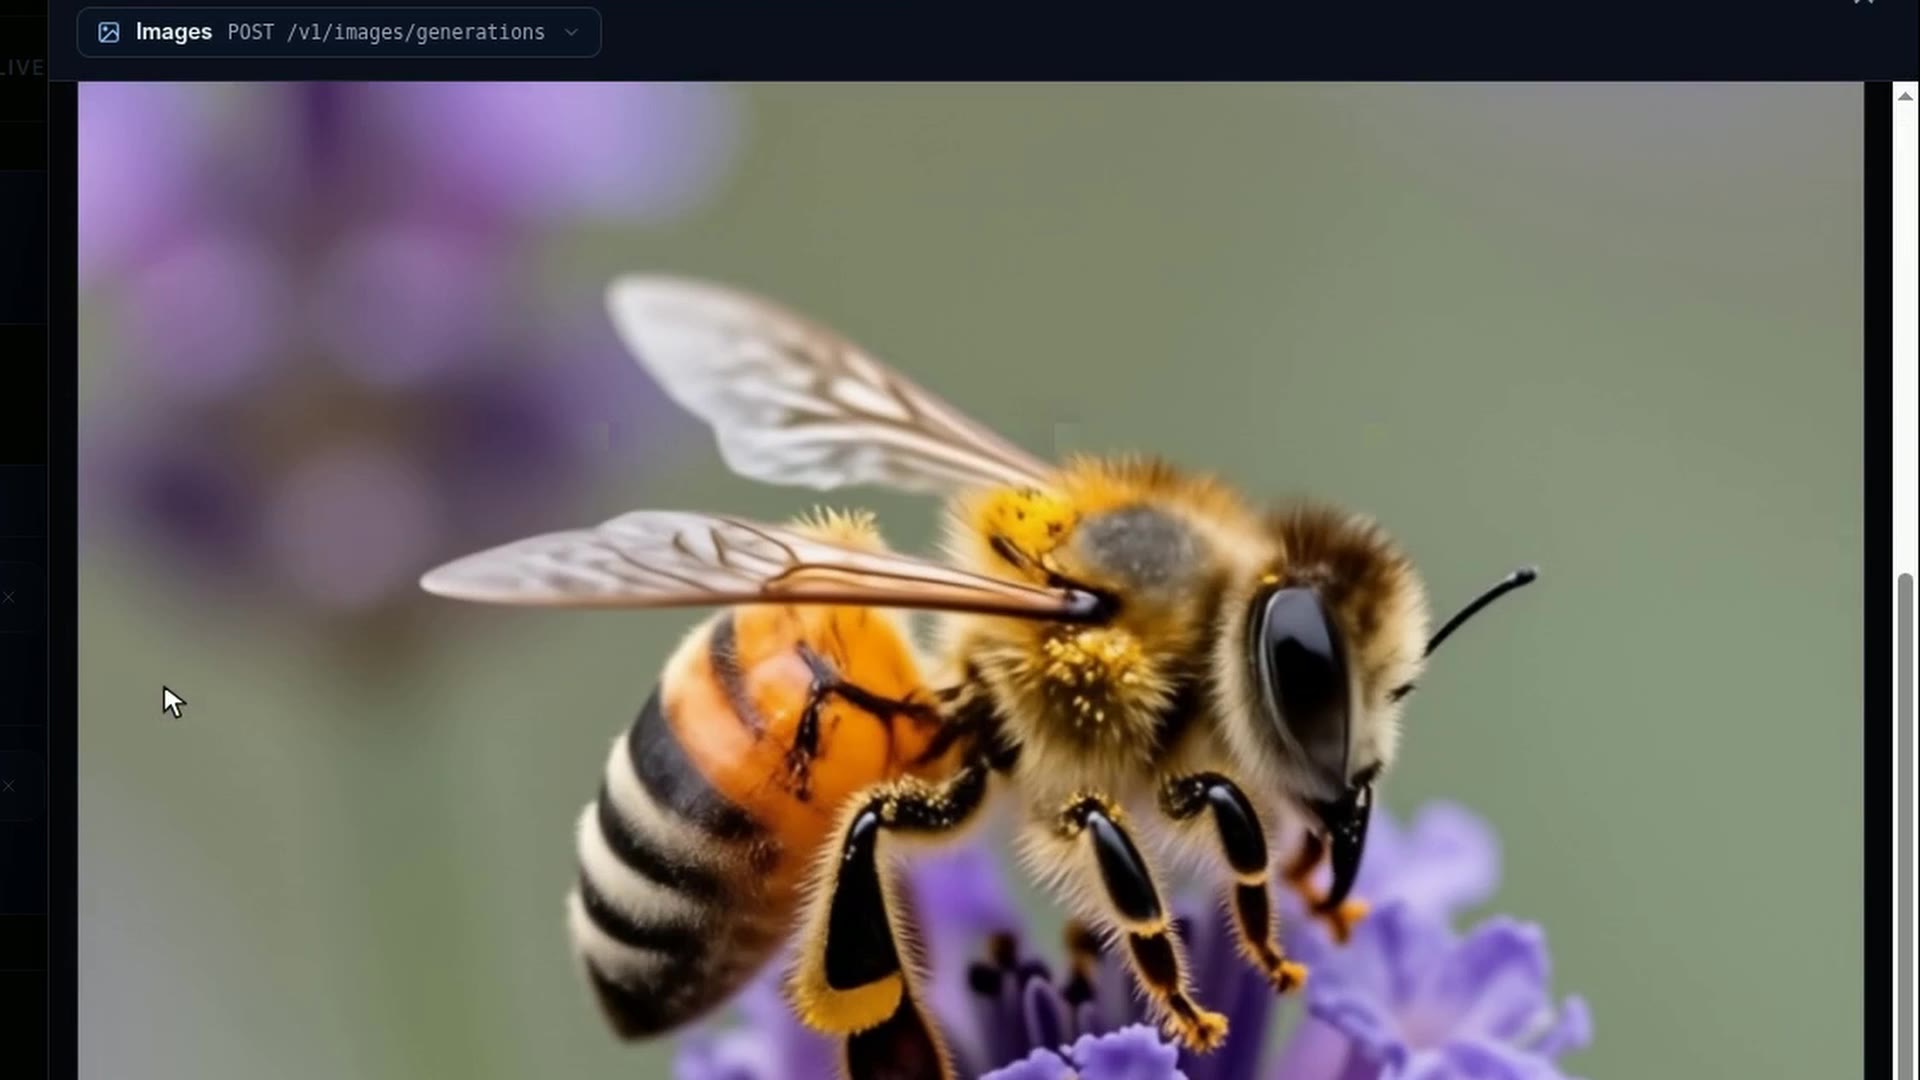
Klick auf das Bild, um das MP4 abzuspielen (72.5 s, 7.4 MB).
Was schiefging, und eine Sache, die gut lief
Turbo lief von Anfang bis Ende, und der Bildtester und die Live-Ansicht des Panels funktionierten mit unserem Backend ohne Änderungen. Unterwegs sind wir auf InferenceKey-Seite auf vier Ecken und Kanten gestoßen, keine davon fatal. Die Nummern 1, 3 und 4 sind so, wie die Plattform heute funktioniert, sie werden also wieder passieren. Nummer 2 haben wir einmal gesehen, in einem Lauf:
- Eine zu große Antwort wurde zu fünf Minuten Warten. Zwei PNG-Bilder in einer Anfrage kamen zusammen auf 9.1 MB, mehr als das Limit von 8 MB für eine einzelne Nachricht innerhalb von InferenceKey. Der Worker wusste es sofort und verwarf das Ergebnis, aber der Aufrufer bekam erst nach etwa 5 Minuten einen generischen Timeout. Unser Beispiel lehnt diesen Fall jetzt sofort mit einem klaren Fehler ab und bietet JPEG oder WebP an, wo vier Bilder in 688 KB passen.
- „Bereit“ kam 50 Sekunden zu früh. Mit zwei Modellen auf einem Worker meldete das Warten-bis-bereit des SDK das Basismodell nach 10 Sekunden als bereit. Das „bereit“, das es sah, kam in Wirklichkeit von Turbo, das auf derselben GPU mit unserem aktualisierten Code neu startete. Keine Anfrage ging verloren: Die erste wartete in der Warteschlange, bis das Basismodell lief.
- Keine Einstellungen pro Workload. Einem Custom Backend lässt sich über die Einstellungen des Workloads nicht sagen „nimm diesmal das Basismodell“. Stattdessen haben wir das Basismodell als zweites Backend unter eigenem Namen veröffentlicht.
- Ein festes Start-Limit. Ein Custom Backend hat 300 Sekunden, um bereit zu werden, und auf einer gemieteten GPU-Maschine, die InferenceKey für dich einrichtet, lässt sich das nicht erhöhen. Unseres brauchte 113 Sekunden, aber ein langsamerer Download könnte das Limit reißen.
Die Sache, die gut lief: Als wir Problem 1 behoben und das Backend neu veröffentlicht haben, hat InferenceKey die Änderung bemerkt und das laufende Modell von selbst mit dem neuen Code neu gestartet, in 23 Sekunden, ohne manuellen Schritt.
Wer was gemacht hat
Iris-3B ist die Arbeit von Sperid Labs: das Modell, die Turbo-Version, die Versionen für Tiefe und Foto-Vergrößerung, die Trainingsskripte, die öffentliche Demo und das Paper von Hanqiu Li Cai und Chema Garabito. Das erste schnelle Iris mit 4 Durchgängen kam aus der Community: pentacoxian-dev hat iris-3b-turbo-lora auf einer einzigen Consumer-GPU gebaut. Qwen3-VL-4B-Instruct, das Modell, das den Prompt liest, stammt vom Qwen-Team von Alibaba. Die Stufe, die jede Kachel in Pixel verwandelt, folgt dem Design von PixelDiT, dem Modell einer anderen Gruppe (den Code dafür haben die Autoren selbst geschrieben). Das Training baut außerdem auf veröffentlichten Methoden anderer Gruppen auf, darunter ein Bildmodell von Meta (DINOv2), das früh im Training als Orientierung dient. Die vollständige Liste steht im Abschnitt für Engineers. Im News-Video von AI Search haben wir zum ersten Mal davon gehört.
Unser Anteil: die Quellen lesen, das Custom Backend und das SDK-Beispiel schreiben, es auf InferenceKey laufen lassen, messen und die Demo aufnehmen.
Was du mitnehmen kannst
Wenn du ein offenes Bildmodell brauchst, das du kommerziell nutzen darfst und das auf einer gemieteten A40 mit 48 GB ein Bild in 1024x1024 in etwa 2 Sekunden macht, ist Iris-3B Turbo einen Test wert. Lade den Turbo-Ordner herunter, nicht das Repo. Bleib bei langem Text und bei Händen realistisch, und probiere deine eigenen Prompts, bevor du dich festlegst: Die Benchmarks des Anbieters und die Rezension von AI Search sehen es beide hinter den besten offenen Modellen, und wir haben keines davon direkt daneben laufen lassen. Die Idee mit dem Pixelraum ist interessante Forschung, und die Autoren sagen dir als Erste, dass sie den Vergleich, den sie selbst aufgesetzt haben, nicht gewonnen hat.
Die Frage, die wir offen gelassen haben, ist die billige Karte. Turbo lag auf der A40 in der Spitze bei etwa 23 GB. Ob es auf einer RTX 4090 mit 24 GB läuft, ist ein python main.py entfernt, auf einem Worker, der eine hat.
Für Engineers
Modell (GitHub-README, Forschungsseite, Paper). 3B-Diffusion-Transformer, der im Pixelraum arbeitet: kein VAE und kein Latent Space (das „Hilfsnetz“ und der „komprimierte Code“ aus dem Erzählteil). 24 Blöcke mit Breite 2560 (8 Dual-Stream + 16 Single-Stream), GQA mit 20 Query- / 5 KV-Heads, Patch-Größe 16, ein Pixel-Transformer-Head (PiT) mit 4 Blöcken, der dem Design des Heads von PixelDiT folgt (eine unabhängige Implementierung, kein PixelDiT-Code), dekodiert jedes Patch-Token zu Pixeln. Rectified Flow, v-Prediction, logit-normale Timesteps. 2D-RoPE, sodass ein Satz Gewichte bei jedem Seitenverhältnis bis etwa 1 MP läuft. Text-Encoder: eingefrorenes Qwen3-VL-4B-Instruct, 12 Hidden Layers, kombiniert durch einen gelernten Layer-Attention-Adapter. Paper: „Iris-3B: Going Beyond the Latent with Pixel-Space Diffusion Training, Conversion and Fine-Tuning“, arXiv 2610.09450 v1, 7. Oktober 2026, 19 Seiten (wir haben den Abstract gelesen, nicht den vollen Text).
Training. Von Grund auf, 256 -> 512 -> 1024 px, dann SFT bei 1024: 665K Schritte (Stufe 1 bis 365K bei Batch 1024 mit REPA auf DINOv2-B/14, Stufe 2 bis 530K, Stufe 3 bis 625K bei Batch 512, SFT 625K-665K). Muon + AdamW, bf16, FSDP2, torchrun --nproc_per_node=8. Die Trainingsskripte sind veröffentlicht. GPU-Stunden werden nicht genannt (die Forschungsseite sagt nur „a fraction“ des Rechenaufwands latenter Modelle).
Basis-Sampling. 1024x1024, 100 Schritte DPM-Solver++ (Ordnung 2), CFG 3. python scripts/sample.py --checkpoint iris-3b --prompt "...", Flags --steps --seed --negative-prompt --txt-file --cfg-scale.
Turbo. Vollständiges Fine-Tuning aller 3B Parameter (kein LoRA) mit Trajectory Distribution Matching, datenfrei, zwei Stufen (6 Schritte für 1,600 Updates, dann 4 Schritte für 500). CFG 3.5 vom Teacher eingebacken, kein CFG und kein Negative Prompt bei der Inferenz, feste Sigmas 1, 0.938, 0.833, 0.625. Sieben Seitenverhältnis-Buckets um 1 MP: 1024x1024, 752x1344, 896x1344, 896x1200 und ihre Transponierten. Gewichte in bf16 exportiert, auf FP32 hochgecastet, ausgeführt unter BF16-Autocast. Python-API iris3b.sampling.generate_few_step. Community-Alternative: iris-3b-turbo-lora von pentacoxian-dev, eine DMD2-Destillation auf 4 Schritte als LoRA mit Rang 64 (460 MB), von uns nicht getestet. Vom Anbieter genannte Grenzen: bei dichtem oder langem Text schwächer als die Basis, weniger Vielfalt über Seeds, mögliche leichte Körnung auf flachen Vektor-Hintergründen, feste 4 Schritte. Generell sind Textdarstellung und exakte Anzahlen nicht immer zuverlässig.
Credits für Methoden. Die Architektur DiT, das Design des PiT-Heads von PixelDiT zum Dekodieren von Patches zu Pixeln, der Optimizer Muon über Microsofts Dion, REPA mit Features von Metas DINOv2-B/14 in Stufe 1 des Basistrainings, der Sampler DPM-Solver++ für das Basismodell, Trajectory Distribution Matching für Turbo, das HYPIR-Rezept für den Upscaler und das Protokoll Marigold V2 für die Bewertung der Tiefe.
Benchmark-Tabelle (ausgewählte Zeilen). Die Iris-Zeilen hat Sperid Labs mit den offiziellen Evaluatoren bei 1024² gemessen, ohne Prompt-Umschreibung, ohne Best-of-N. Die anderen Zeilen zitiert die Forschungsseite als Referenzen aus den Berichten zu Qwen-Image und Z-Image. Die Forschungsseite listet außerdem SDXL, SD3 Medium, SD3.5 Large und Lumina-Image 2.0, hier nicht übernommen. Die Zeile des Community-LoRA stammt von der HF-Card und dem GitHub-README.
| Modell | GenEval | DPG | LongText EN | OneIG EN |
|---|---|---|---|---|
| Iris-3B | 0.798 | 86.52 | 0.857 | 0.540 |
| Iris-3B Turbo | 0.820 | 86.68 | 0.804 | 0.516 |
| iris-3b-turbo-lora r2-1000 (Community) | 0.760 | 85.05 | 0.733 | 0.486 |
| Qwen-Image 20B | 0.87 | 88.3 | 0.943 | 0.539 |
| Z-Image 6B (Prompt-Umschreibung) | 0.84 | 88.1 | 0.935 | 0.546 |
| HiDream-I1-Full | 0.83 | 85.89 | 0.543 | 0.477 |
| Janus-Pro-7B | 0.80 | 84.19 | 0.019 | 0.267 |
| FLUX.1-dev 12B | 0.66 | 83.8 | 0.607 | 0.434 |
Fine-Tunes (Zahlen des Anbieters, von uns nicht getestet). Tiefe (depth/, etwa 12 GB): relative Log-Tiefe, affin-invariant, 10K Schritte, AbsRel 0.071 und delta1 0.946, gemittelt zero-shot über NYUv2, KITTI, ETH3D, ScanNet und DIODE (Protokoll Marigold V2), scripts/depth.py photo.jpg --out depth_out. Upscaler (upscaler/, etwa 12 GB): adversariale Restaurierung in einem Schritt (HYPIR-Rezept), 10K Schritte, 4x, LPIPS 0.292 und PSNR 20.68 auf DIV2K val, Tiles von 1024x1024 mit Stride 512 und Gaussian Blending, Ausgabe standardmäßig auf 2048x4096 begrenzt (21 Tiles), scripts/upscale.py photo.jpg --out upscaled. Beide laufen mit einem Forward Pass, leerem Prompt und ohne Text-Encoder. Die Gradio-Demo mit allen drei Modellen braucht etwa 45 GB, mit IRIS_OFFLOAD=1 etwa 20 GB in der Spitze. Der HF Space läuft auf ZeroGPU.
Dateien (HF-API, 2026-10-12): Root model.safetensors 11,950,112,680 B (Basis in fp32), turbo/model.safetensors 5,975,089,200 B, depth/model.safetensors 11,952,738,184 B, upscaler/model.safetensors 11,950,112,680 B, ganzes Repo 41,911,753,317 B. Qwen3-VL-4B-Instruct safetensors 8.88 GB. Voraussetzungen: Python 3.11+, PyTorch 2.7.1+, NVIDIA-GPU mit CUDA.
Unser Setup. RunPod NVIDIA A40 48 GB, SECURE, EU-SE-1, 0.59 USD/h mit 100 GB Disk, Image runpod/pytorch:1.0.2-cu1281-torch280-ubuntu2404, Treiber 580.159.03 (CUDA 13.0). Worker gebootstrappt von einem lokalen InferenceKey-Manager über HTTP- + TCP-Tunnel. RTX 4090 COMMUNITY damals mit 0.34 USD/h gelistet. Pod erstellt 21:07:30Z (Worker online etwa 21:08:40Z), gelöscht 21:33:35Z. Backend-venv: Python 3.12.3, torch 2.14.1+cu130, transformers 5.19.0, installiert mit uv. Upstream-Code gepinnt auf 73bcdf59 (ein späterer Docs-Commit, cee0c13, kam am selben Tag dazu und wurde nicht getestet).
Backend (backend.py). Ein Custom Backend, weil Iris-3B weder eine Diffusers-Pipeline noch eine GGUF-Datei ist, die Formate, die die eingebauten Backends laden. Slugs iris3b-text2image (Turbo) und iris3b-base-text2image (Basis), Paket 5,209 bis 5,800 Bytes. setup() lädt den Upstream-Tarball am gepinnten Commit herunter (etwa 1 MB), snapshot_download von turbo/* (oder config.yaml + model.safetensors für die Basis), baut IrisDiT auf dem Meta-Device, lädt die Gewichte, castet auf fp32 hoch, baut den Qwen3-VL-Encoder. process() akzeptiert native Eingabe oder das JSON der OpenAI-Images-API, rastet Turbo-Größen auf die 7 Buckets ein, zieht das Rauschen auf der CPU aus dem Seed (dasselbe Startrauschen auf jeder GPU), führt generate_few_step (Turbo) oder generate (Basis, 100 Schritte, CFG 3) unter bf16-Autocast aus und gibt {data: [{b64_json}]} zurück. n 1 bis 4, output_format png, jpeg oder webp, PNG mit n > 1 antwortet 400. Commit des SDK-Beispiels 05869ee auf main.
Messungen (GPU-Zeit = vom Backend gemessen mit cuda.synchronize(), Round Trip = HTTP-Client zum Manager, inklusive Encoding und NATS):
| Fall | GPU s | Round Trip s |
|---|---|---|
Turbo-Kaltstart, ensure() bis bereit | 130 (venv 16, Upstream-Code + Turbo-Download 12.2, Encoder-Download ~72, Laden beider Modelle ~27) | |
| Turbo, erste zwei Aufrufe, 1024x1024 / 1344x752 | 3.45 / 2.75 | 5.80 / 3.73 |
| Turbo 1024x1024, 5 Prompts | 1.956 bis 1.961 | 2.83 bis 2.92 |
| Turbo 1344x752 | 1.91 | 2.79 bis 2.83 |
| Turbo 1344x896 | 2.21 / 2.83 | 3.46 / 3.84 |
| Turbo 896x1200 / 1200x896 / 896x1344 | 2.77 / 2.87 / 2.65 | 3.76 / 3.83 / 3.71 |
| Turbo n=4, 1024x1024, JPEG | 7.02 (1.75 pro Bild) | 7.41 (688 KB) |
| Turbo, 8 sequenzielle JPEG-Anfragen | 2.10 bis 2.25 | |
| Turbo, Bildtester im Panel | 2.86 und 2.92 | |
| Basis 1024x1024, 100 Schritte, CFG 3 | 89.8 / 90.0 | |
| Basis 1344x896 | 106.1 |
Start der Basis mit gecachtem Encoder: bereit 60 s nach ensure() (Gewichte 42.7 s, Laden 11.4 s). VRAM aus nvidia-smi alle 0.5 s: Turbo 20,384 MiB geladen, 21,831 MiB Spitze (19.9 / 21.3 GiB bzw. 21.4 / 22.9 GB). Turbo + Basis 40,455 MiB geladen, 44,890 MiB Spitze (39.5 / 43.8 GiB). Maximale Leistungsaufnahme der Karte 308.8 W bei einem Limit von 300 W.
Plattformprobleme, exakt.
n=2PNG bei 1024x1024 = 9,097,397 Bytes, über der NATS-Max-Payload von 8,388,608 Bytes. Worker:job result refused by JetStream for good (code max_payload: ...); the result is given up and the job is acked. Client: HTTP 504inference_timeoutnach etwa 300 s. Der Worker weiß es sofort, das Gateway merkt es erst durch den Timeout. Im Beispiel abgefangen (400 in 0.08 s).wait_until_ready("iris3b-base")kehrte nach +10 s zurück, während das Basis-Backend um 21:19:52 bereit wurde. Das Event, das es sah, war das Hot Recycling von Turbo auf demselben Worker. Erster Round Trip der Basis 141 s (etwa 50 s in der Queue + 90 s Generierung).- Der Worker startet
python -m inferencekey.backend.serve --port N --backend <entrypoint>ohne--config-json, also bekommt ein Custom Backend keine Konfiguration pro Workload. Workaround: eine zweite Entrypoint-Klasse,Iris3BBaseText2ImageBackend, unter eigenem Slug. INFERENCEKEY_CUSTOM_BACKEND_READY_TIMEOUT_SECSsteht standardmäßig auf 300 s und lässt sich auf vom Manager provisionierten RunPod-Pods nicht setzen. Dieses Setup brauchte 113 s.
Positiv: Das erneute Veröffentlichen des Backends hat den laufenden Workload in 23 s per Hot Recycling neu gestartet (custom backend artifact changed for a running workload; recycling its backend).
Grenzen.
- Ein GPU-Modell (A40), ein Lauf, ein Seed pro Prompt.
- Ein Client, der Anfragen nacheinander schickt (die 8 „Live“-Anfragen liefen sequenziell), und ein Workload, der gleichzeitig Traffic bedient. Kein Test zu Nebenläufigkeit oder Durchsatz unter Last. Eine 24-GB-Karte haben wir nicht getestet, ob Turbo in der Praxis auf eine RTX 4090 oder A5000 passt, ist also offen.
- Die 0.7 s pro Bild des Anbieters auf einer H100 bei Batch 4 haben wir nicht reproduziert. Unsere 1.75 s pro Bild bei Batch 4 sind auf einer A40 gemessen und kein direkt vergleichbarer Check.
- Die Qualitätsurteile sind unsere, aus dem Ansehen jedes Bildes, das wir gemacht haben, ein Seed pro Prompt. Wir haben kein Modell mit komprimiertem Bild (latentes Modell) wie FLUX, Z-Image oder Qwen-Image mit denselben Prompts laufen lassen, der Qualitätsvergleich mit ihnen besteht also aus den Tabellen des Anbieters und der Meinung eines Rezensenten. Vielfalt über Seeds und Körnung auf flachen Hintergründen haben wir nicht bewertet.
- Die Werte für Tiefe und Upscaler, die Benchmark-Werte und die Ergebnisse des Papers sind Angaben von Sperid Labs. Wir haben den Abstract des Papers gelesen, nicht den vollen Text.
- Die Rezension von AI Search sagte, das 12 GB große Basismodell „should fit on most consumer GPUs“. Mit dem fp32-Upcast der Autoren und dem Text-Encoder kam Turbo allein gemessen auf 20,384 MiB (19.9 GiB) geladen, plane also mit mehr als der Dateigröße.
Quellen: Model Card von Iris-3B, GitHub-Repo, Paper, Forschungsseite, HF Space, SDK-Beispiel, Video von AI Search (Kapitel bei 36:35).