Un ChatGPT privé pour cinquante équipes, et une seule facture à répartir
Comment un assistant d'IA privé sert cinquante équipes via une seule adresse, et comment son coût horaire fixe devient une facture par équipe.
Quand une entreprise décide de faire tourner son propre assistant d'IA, la première inquiétude porte en général sur le modèle : un modèle ouvert sera-t-il assez bon ? Les questions plus difficiles arrivent plutôt une fois que l'assistant fonctionne : comment faire entrer plus d'équipes quand les machines sont pleines, et comment dire à la finance quelle équipe a dépensé quoi.
Cette démo répond aux deux : comment un assistant privé peut passer d'une équipe à cinquante sans être reconstruit, et comment son coût reste fixe, prévisible et réparti par équipe en cours de route.
La vidéo (2:47, avec une voix off en anglais) suit Nexora, une entreprise de taille moyenne que nous avons inventée. Nexora ne veut pas envoyer ses contrats, ses tickets de support et ses prévisions financières à un service d'IA public. Dans l'histoire, elle fait donc tourner son propre assistant sur dix machines louées à Francfort, chacune avec une Nvidia H100 (une puce d'IA haut de gamme), et le sert avec InferenceKey. Chaque département appelle le même modèle avec ses propres clés.
La voix off joue le scénario au premier degré, alors autant le dire d'emblée : les machines de cette vidéo sont simulées. Le panneau, les clés, la file d'attente et la comptabilité sont le vrai produit. Les dix "serveurs H100" sont des programmes en mode test qui se comportent comme des serveurs GPU mais répondent avec du texte de remplissage au lieu de faire tourner un modèle. La section sur les limites précise ce que cela implique pour chaque chiffre.
Voici ce que le panneau affichait :
| Quoi | Dans la démo |
|---|---|
| Clés, une par équipe ou par cas d'usage | 50 |
| Ce que chaque clé peut atteindre | 1 adresse, le chat de l'entreprise |
| Machines qui servent le modèle | 10, toutes en ligne, 0 avertissement |
| Charge constante du script de test | environ 4 200 requêtes par minute |
| Coût de dix machines allumées tout le mois | environ 17 500 dollars, quel que soit le trafic |
| Coût enregistré pendant l'existence de la flotte de démo | 326,97 dollars pour 134,53 heures-machine, réparti par clé |
L'idée qui rend le reste simple
Une machine GPU louée se facture à l'heure, comme un local de répétition. Vous payez le local, que le groupe joue un morceau ou quarante. Une API d'IA publique fait l'inverse : elle facture au mot, donc chaque question de plus coûte plus cher. Les abonnements par utilisateur le masquent jusqu'au jour où quelqu'un atteint une limite d'usage.
Cela change le sens de "maîtriser les coûts". Avec vos propres machines, la facture du mois est connue d'avance. Dans cette démo, ce sont dix machines à 1 750 dollars par mois chacune, environ 17 500 dollars par mois, soit 24,31 dollars de l'heure, peu importe ce que tapent les équipes. Il reste deux choses à gérer : garder les machines occupées, parce qu'une heure à vide coûte autant qu'une heure pleine, et savoir qui les a utilisées, pour que chaque équipe voie sa part. Le reste de la démo, ce sont ces deux choses à l'écran.
Une clé par équipe
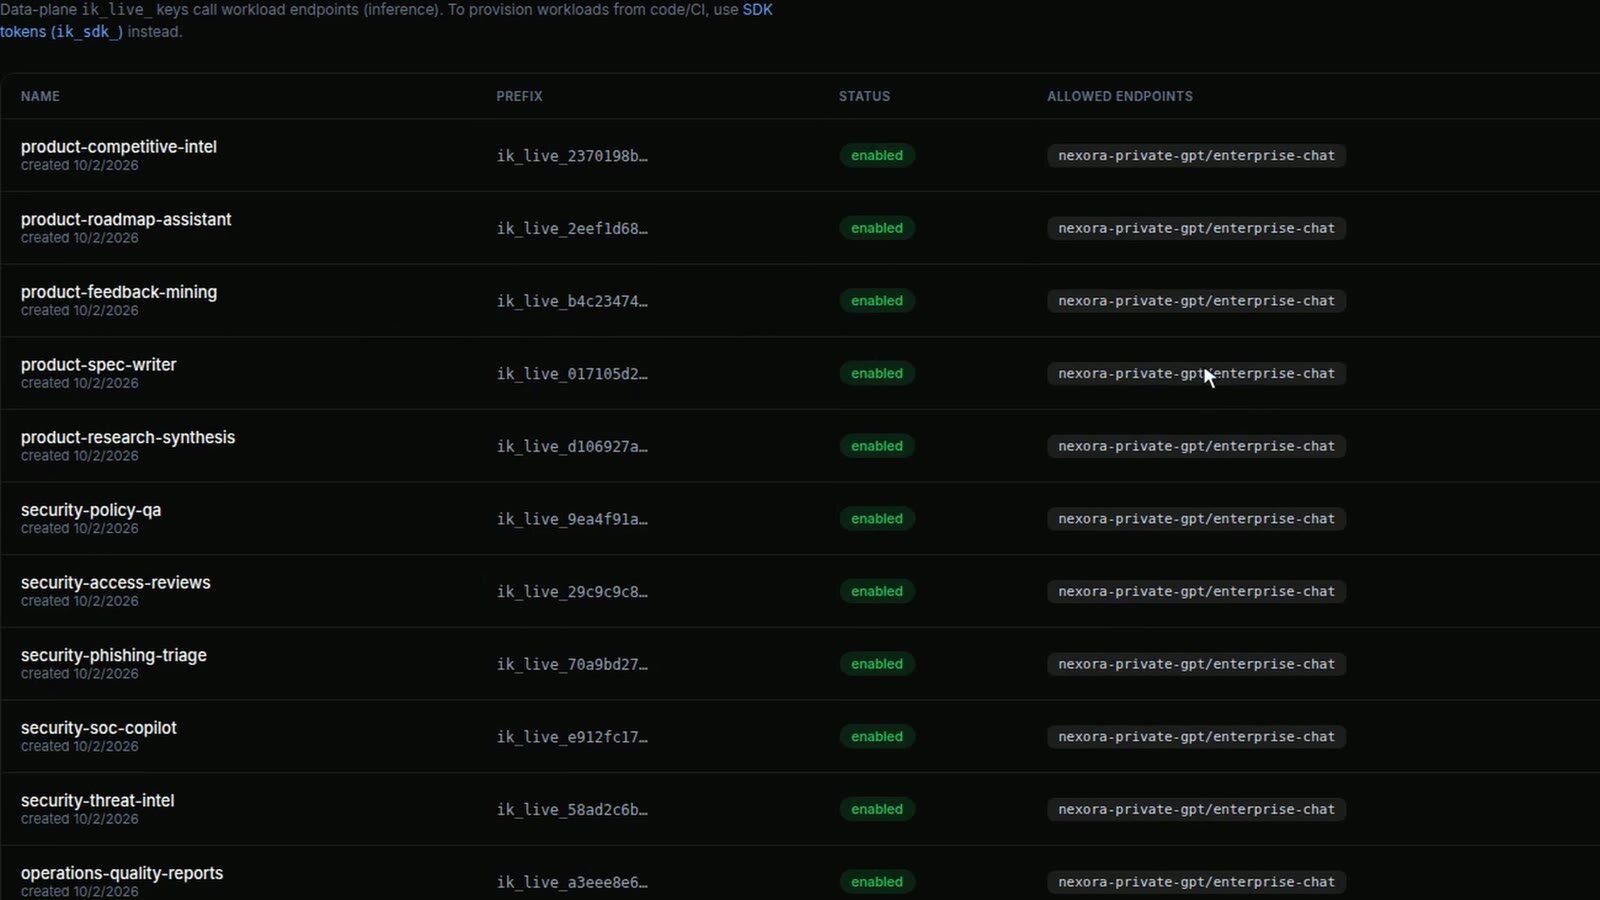
Une clé est un mot de passe qu'un programme utilise pour appeler l'assistant. Chaque équipe a la sienne, et souvent chaque cas d'usage au sein d'une équipe en a une aussi : le produit a des clés pour la veille concurrentielle, la roadmap et les spécifications, la sécurité a son propre jeu de clés, et ainsi de suite pour les opérations, la finance, le support et les RH. Cinquante au total. Chaque clé n'ouvre qu'une seule porte, l'adresse du chat de l'entreprise, donc une clé qui fuite ne peut rien atteindre d'autre parmi ce que Nexora fait tourner sur la plateforme.
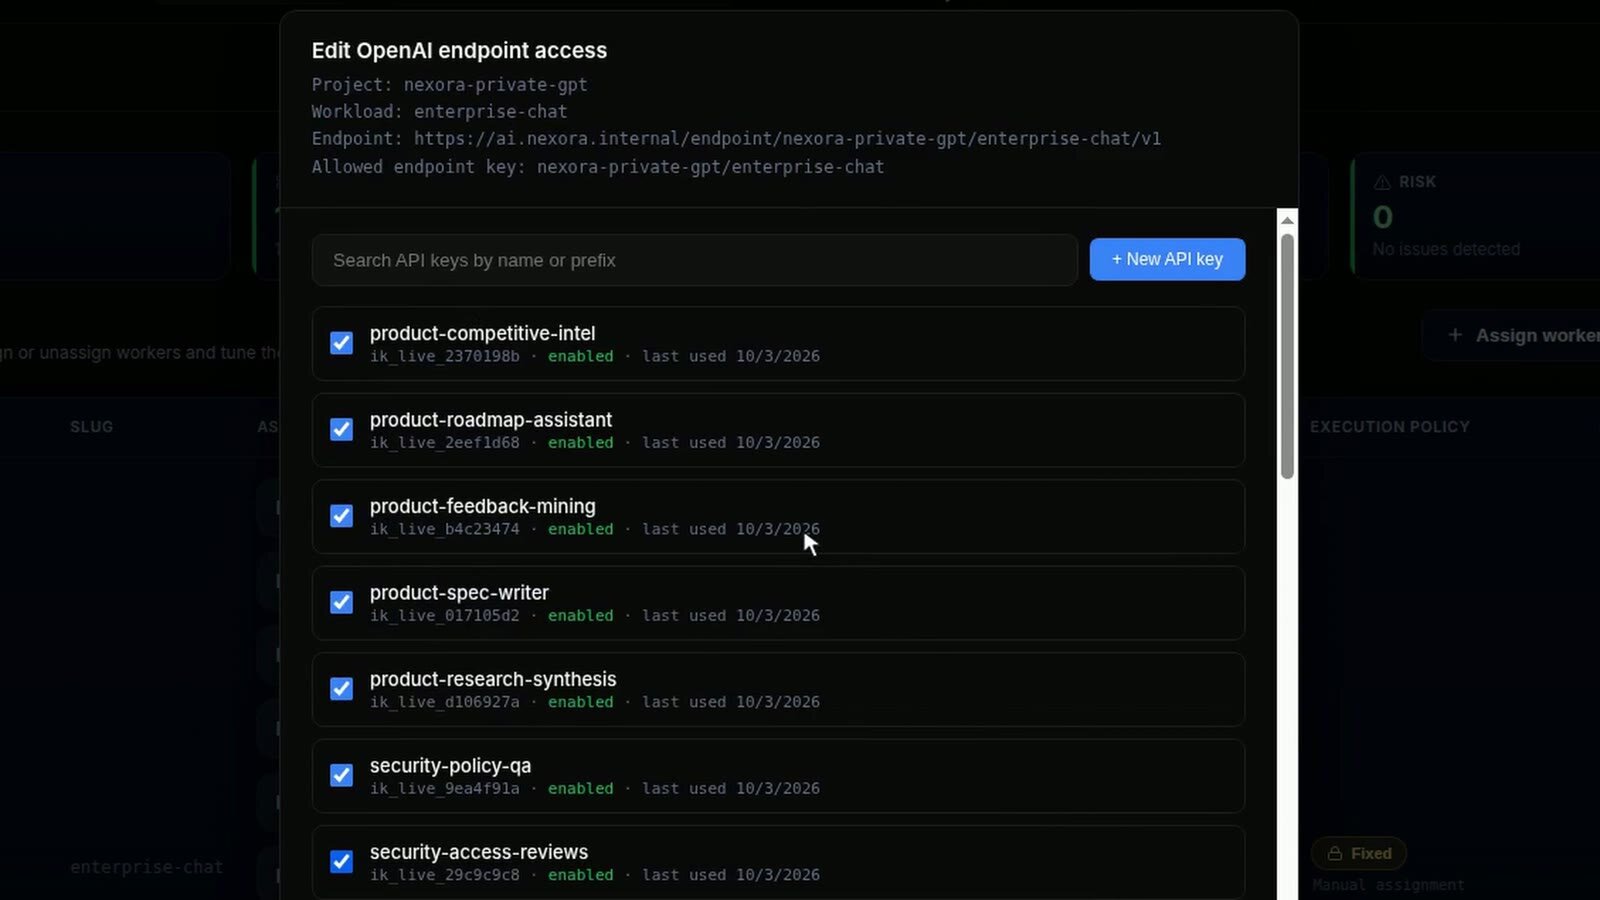
L'accès, c'est une liste de cases à cocher sur cette adresse. Il n'y a pas de fenêtre de chat dans cette démo : l'adresse parle le même format que l'API d'OpenAI, donc n'importe quelle appli de chat ou n'importe quel outil interne qui fonctionne déjà avec OpenAI peut l'utiliser en changeant une adresse et une clé. Ajouter une équipe, c'est créer une clé et la cocher. Retirer une équipe, c'est la décocher ou désactiver sa clé.
Un modèle, dix machines
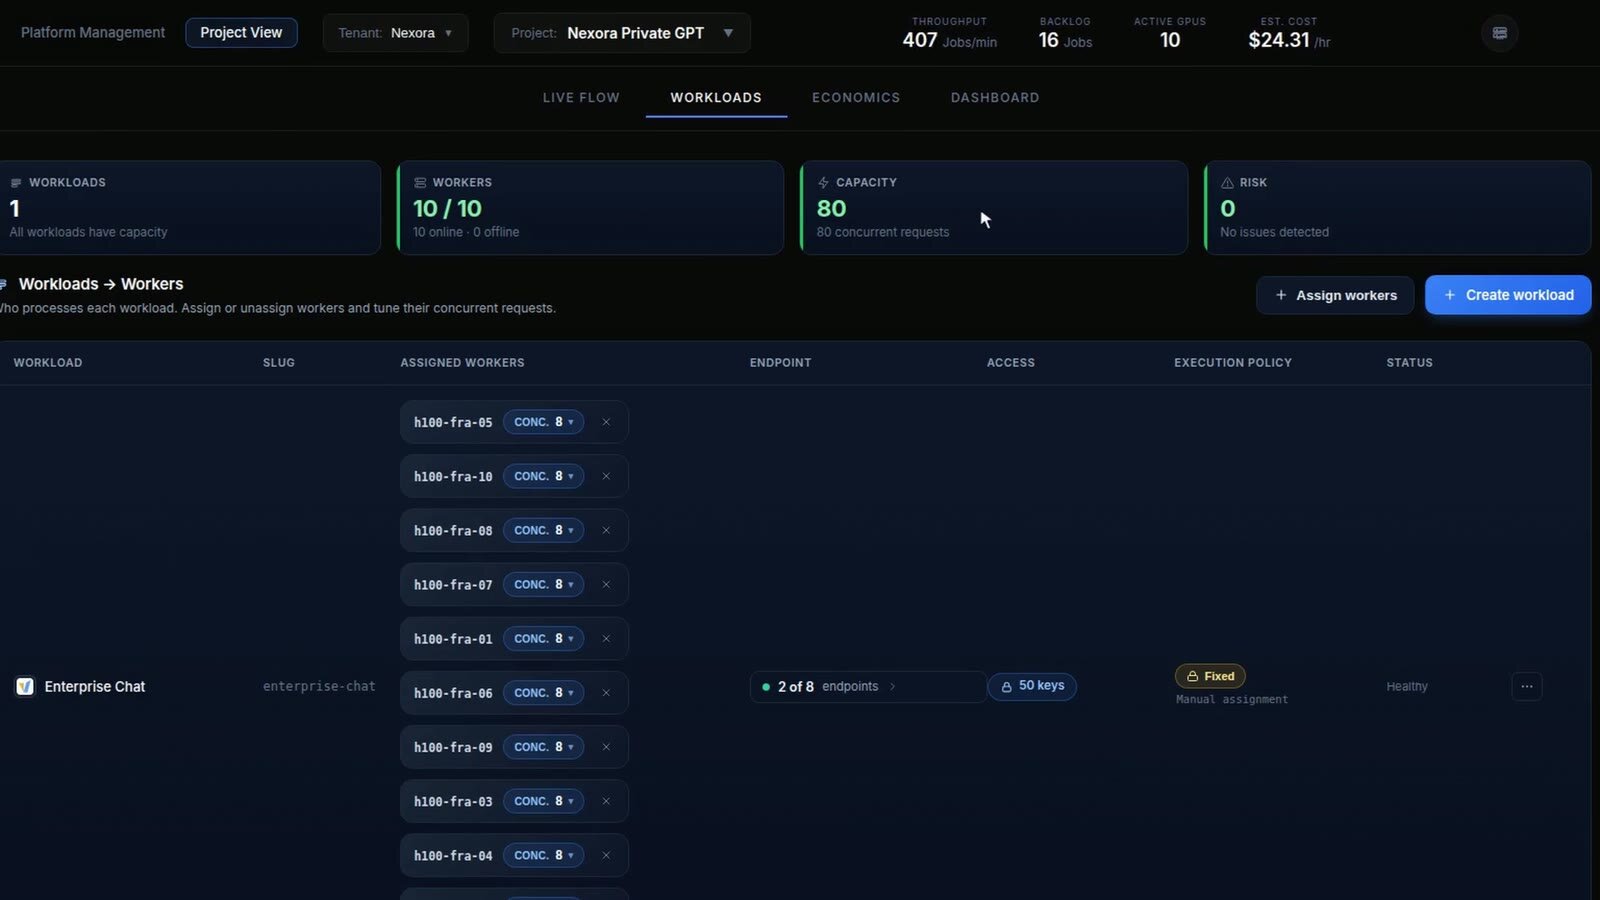
Derrière cette adresse tourne un seul modèle, le chat de l'entreprise. Dix machines le servent (dans l'histoire, chacune avec sa propre copie du modèle), et le panneau appelle chaque machine un worker. Chaque worker prend huit requêtes à la fois, donc la flotte peut traiter 80 requêtes en même temps.
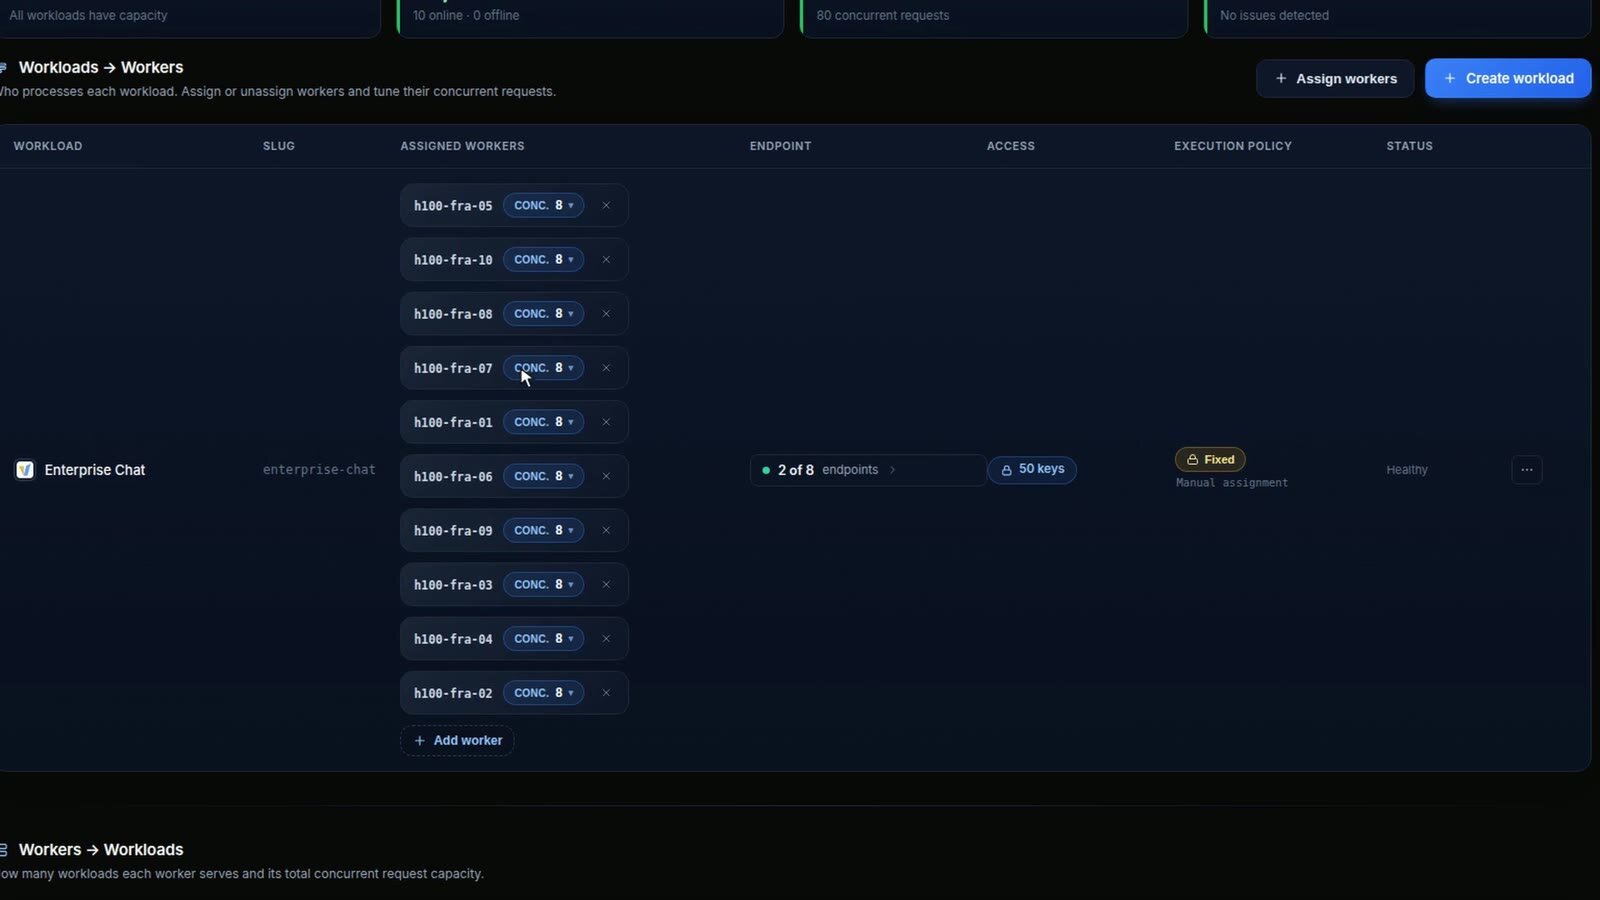
C'est sur cette ligne que l'on grandit. Le premier jour, cela peut être une équipe, une clé et une ou deux machines. Chaque nouvelle équipe ajoute une clé et une case cochée. Quand la file commence à s'allonger, le bouton "Add worker" sous la liste met une machine de plus sur le modèle : vous choisissez une machine enregistrée, ou vous déployez un nouveau GPU dans le cloud, et vous réglez combien de requêtes elle prend à la fois. Une machine de plus comme ces dix ajoute huit requêtes simultanées pour 1 750 dollars de plus par mois. Les équipes gardent leur clé et leur adresse. La facture grandit donc par paliers que vous choisissez, une machine à la fois, et seulement quand la file le demande. Nous n'avons pas appuyé sur ce bouton dans cette prise. Ajouter une machine en plein trafic, c'est une vidéo qu'il nous reste à tourner.
La charge se répartit toute seule
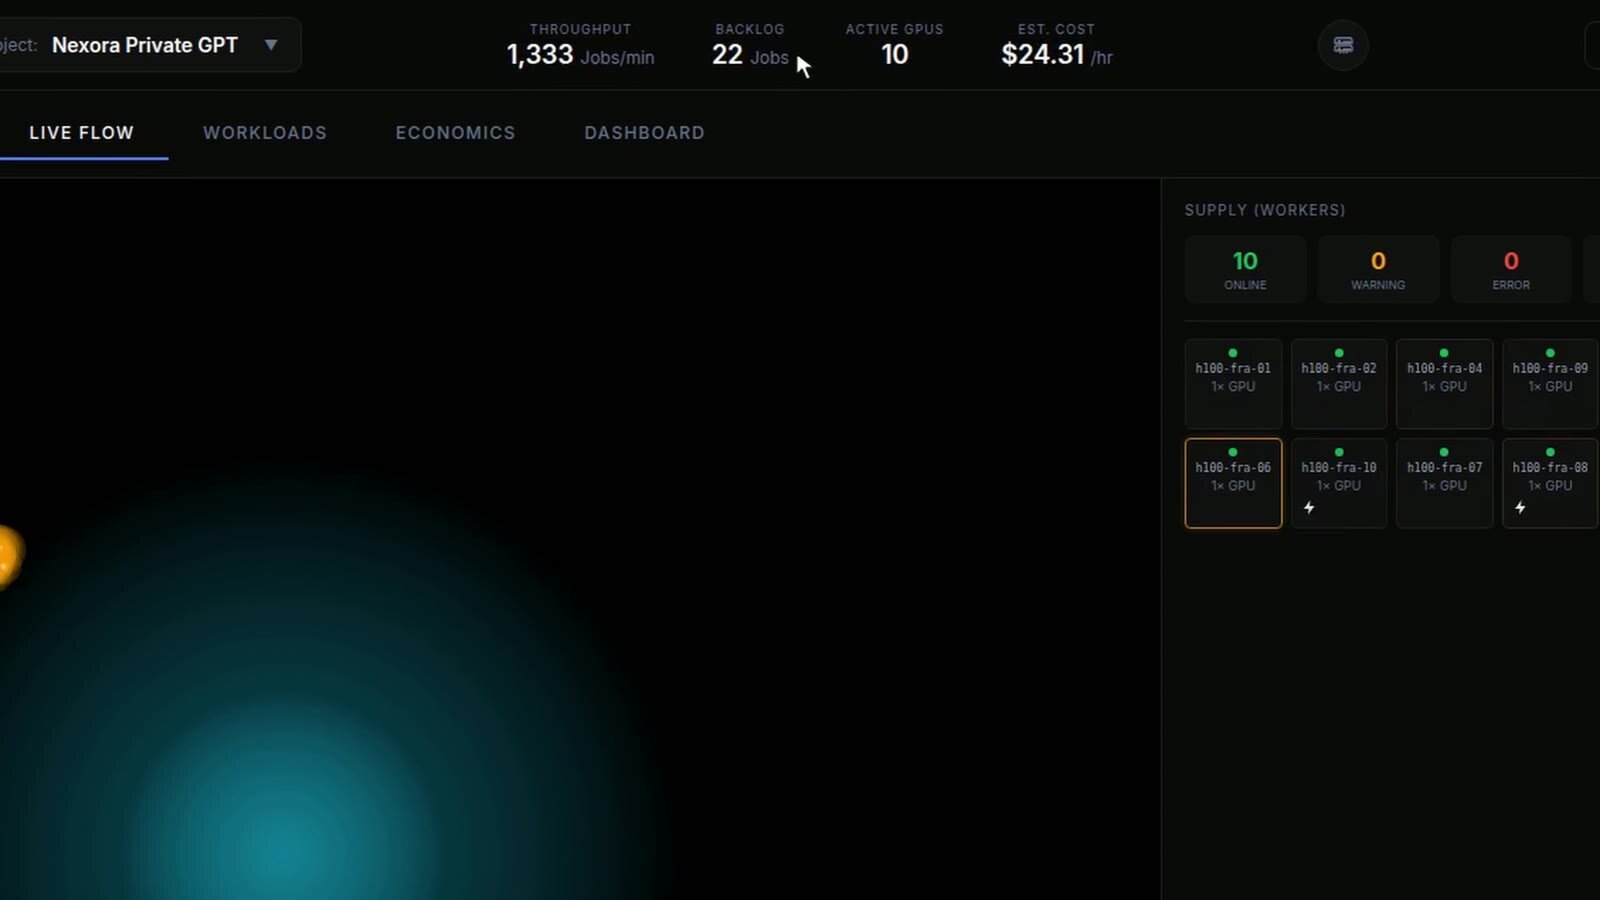
Le script de test a maintenu une charge constante d'environ 70 requêtes par seconde, à peu près 4 200 par minute, réparties sur les cinquante clés, avec quelques équipes bien plus actives que les autres. Le compteur de la barre du haut affiche moins sur cette capture parce qu'il repart de zéro à chaque ouverture de page. À côté : entre 8 et 28 requêtes qui attendent leur tour, dix machines actives, et 24,31 dollars de l'heure.
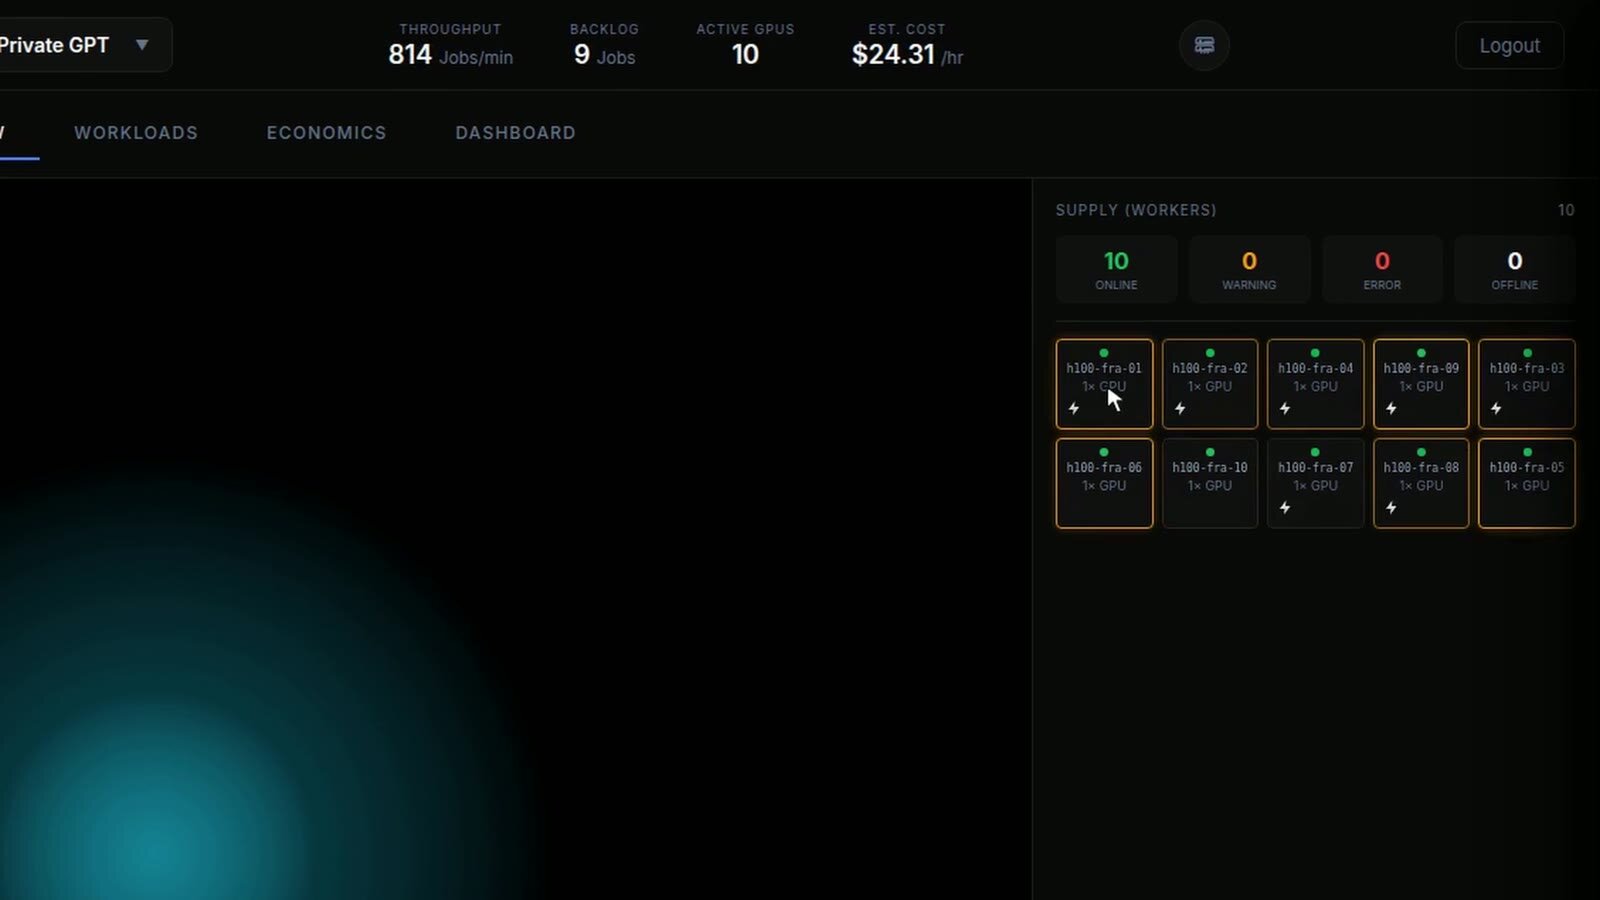
Le panneau Supply montre les dix machines. Celles en surbrillance traitent une requête à cet instant, et la surbrillance saute de l'une à l'autre à mesure que les requêtes arrivent. Vous choisissez quelles machines servent le modèle, mais pas quelle machine prend chaque requête : les requêtes des cinquante équipes entrent dans une seule file, et la première machine qui a une place libre prend la suivante.
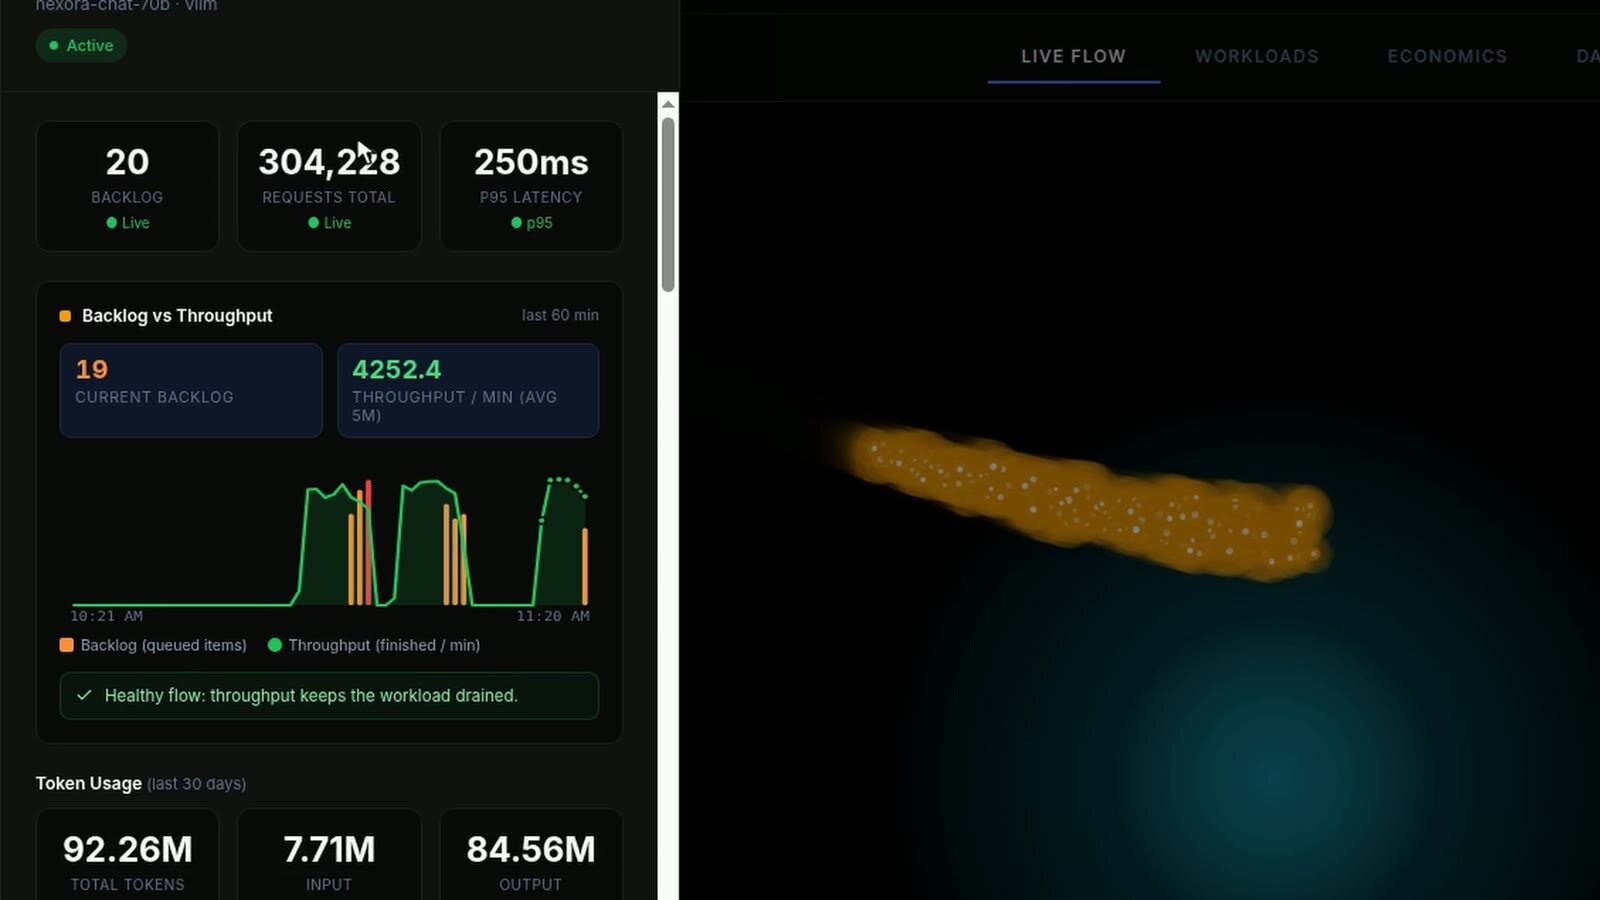
Ouvrez le modèle et le panneau répond à la première question que se pose un opérateur : la file est-elle sous contrôle ? Le graphique montre deux choses : combien de requêtes attendent (les barres) et combien sont terminées chaque minute (la ligne), 4 252 en moyenne sur les cinq dernières minutes. Sous le graphique, une étiquette affiche "Healthy flow" tant que la file ne s'est pas allongée au cours des dernières minutes. Si elle commence à s'allonger, l'étiquette passe à "At risk" ou "Critical", signe que le modèle a besoin d'une machine de plus.
La facture, par équipe
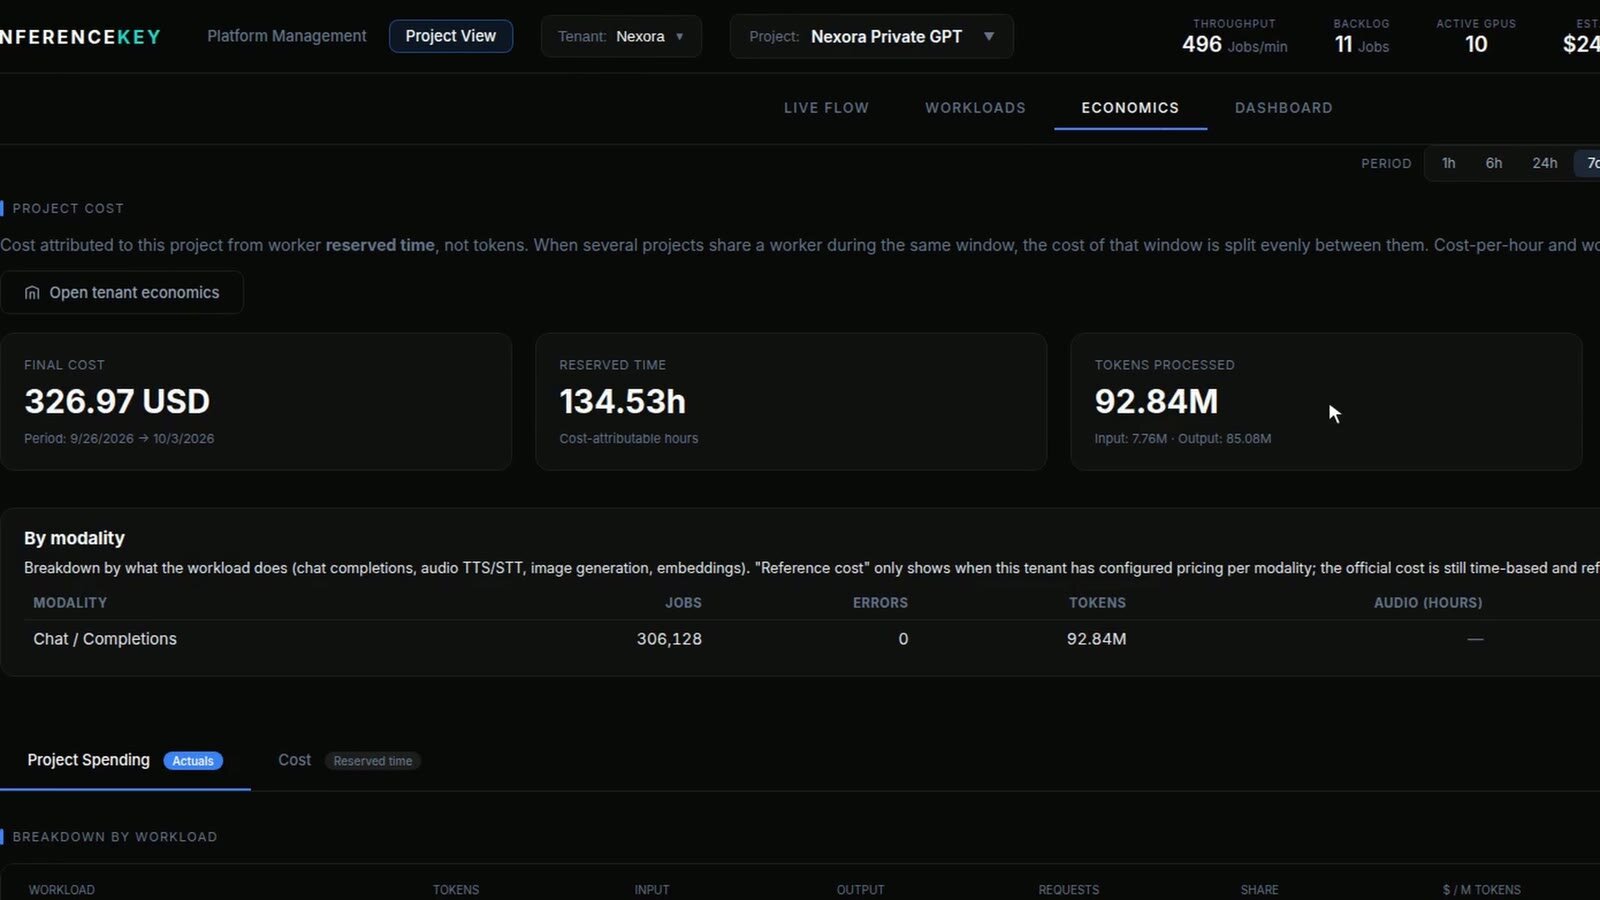
Economics est l'écran qui intéresse la finance. Le panneau prend les heures pendant lesquelles chaque machine a été réservée pour ce projet et les multiplie par le prix de cette machine. Rien n'est estimé à partir d'un nombre de mots.
Le sélecteur de période indique sept jours, mais la flotte de démo n'a existé que pendant une partie d'une journée : 134,53 heures-machine, environ 13 heures et demie par machine. Ces heures ont coûté 326,97 dollars. Pendant ce temps, le trafic de test a produit 306 128 requêtes et 92,84 millions de tokens (un token correspond à peu près aux trois quarts d'un mot). Rapporté à son débit constant, ce trafic représente un peu plus d'une heure sur ces 13 heures et demie, donc la plupart des heures payées étaient à vide. C'est pour cela que les 3,51 dollars par million de tokens affichés dans le panneau mesurent surtout du temps à vide, et ce n'est pas un prix à comparer avec une API publique. Gardez les mêmes machines occupées et les mêmes heures se répartissent sur beaucoup plus de mots : c'est ça, le levier que vous gérez.
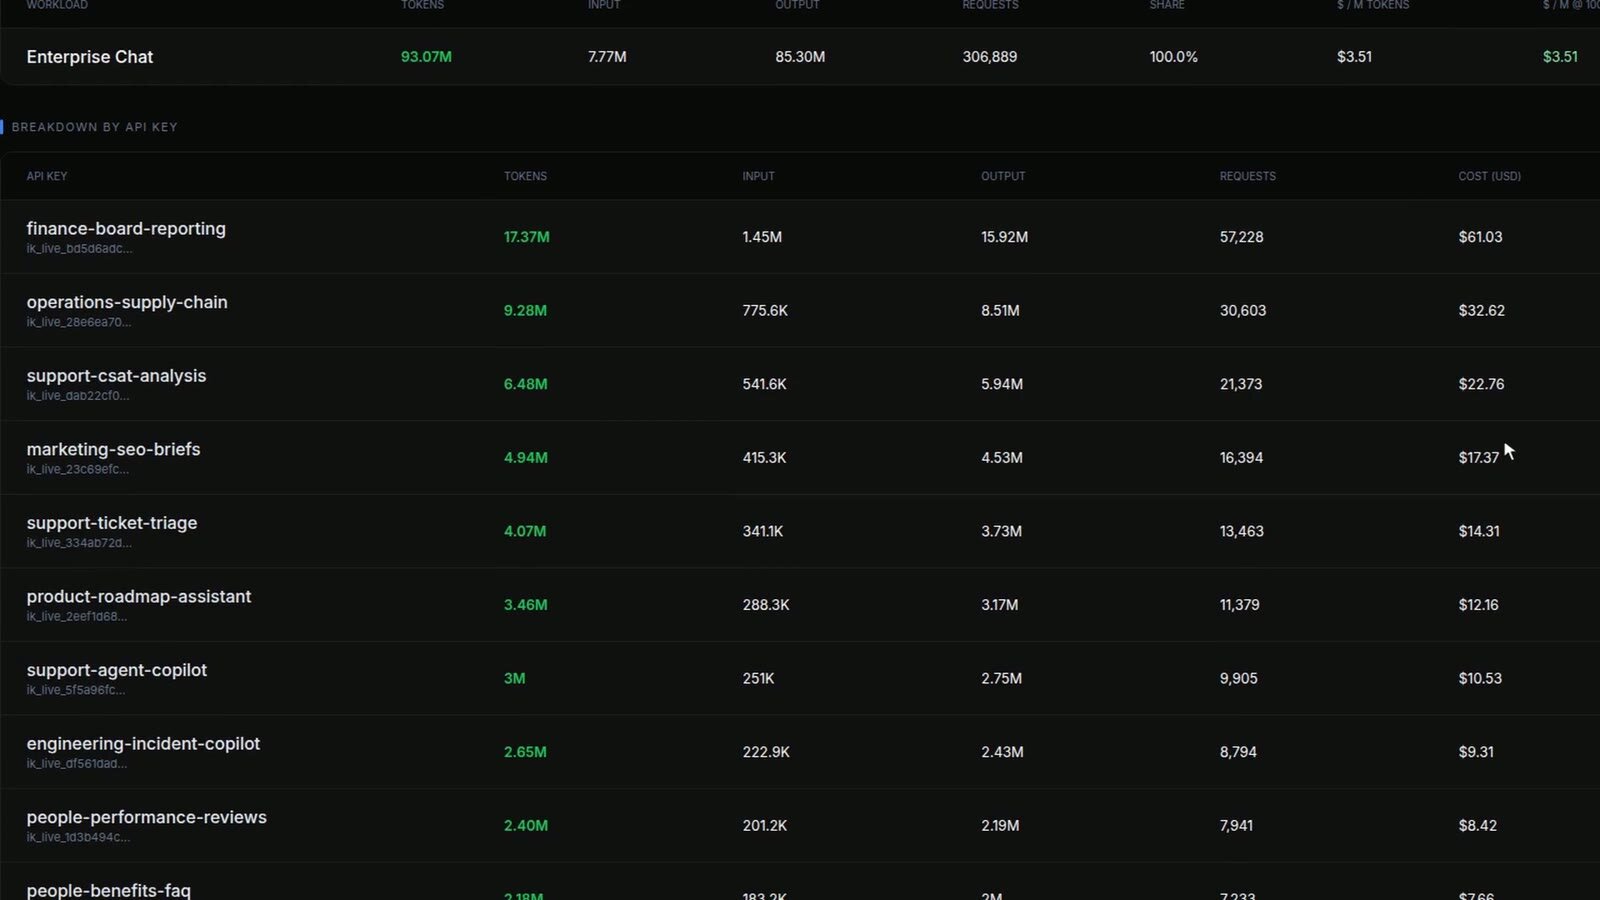
Ensuite, le coût est réparti par clé, au prorata des tokens utilisés par chaque clé. Le reporting de la finance pour le conseil d'administration a utilisé 18,7 % des tokens, il porte donc 18,7 % du coût : 61,03 dollars à ce moment-là. La chaîne d'approvisionnement, 32,62 dollars. L'analyse de la satisfaction client, 22,76 dollars. Le marketing, 17,37 dollars. Il y a cinquante lignes, une par clé, et elles se mettent à jour pendant que le trafic tourne. Si la flotte tournait tout le mois avec la même répartition, le reporting pour le conseil d'administration porterait environ 3 300 dollars sur les 17 500.
C'est comme la table de mixage d'un concert : cinquante voies entrent dans un seul master, et on voit quand même quel micro est trop fort. La finance n'a pas besoin de comprendre les GPU pour la lire. C'est une liste d'équipes avec un chiffre à côté de chacune.
Ce que cela prouve, et ce que cela ne prouve pas
Cela prouve les parties qui ne dépendent pas du GPU. Chacune des cinquante clés ne pouvait atteindre que le chat de l'entreprise. Dix workers se sont partagé la charge depuis une seule file sans que personne n'aiguille les requêtes à la main. Le panneau a gardé ses chiffres en direct à environ 4 200 requêtes par minute, et la facture est sortie des heures-machine, répartie par clé, sans que personne n'exporte de tableur.
Cela ne prouve pas à quelle vitesse répond un vrai modèle, ni combien de personnes dix vraies H100 peuvent servir. Les dix "H100" étaient dix processus en mode test sur une seule machine ordinaire. Le temps de réponse de 250 ms à l'écran vient de ce mode test, tout comme la vitesse de chaque réponse et les 0 erreur : ces workers ne peuvent pas tomber en panne comme un vrai GPU. Les tokens sont comptés sur du texte de remplissage, donc la part de chaque équipe suit la répartition du trafic du script, pas la longueur de vraies réponses. Le script n'a jamais envoyé plus de 32 requêtes à la fois, donc la flotte n'a jamais atteint ses 80. Nexora est inventée, et les 1 750 dollars par mois et par machine sont un prix de location que nous avons configuré, pas un devis.
Le nombre de personnes qu'une vraie machine peut absorber dépend du modèle, de la longueur des réponses et de la façon dont les gens l'utilisent. Pour le savoir, il faut une mesure sur de vrais GPU, et cette démo n'en est pas une.
Pour les ingénieurs
- Configuration. Un projet, un workload (
enterprise-chat, présenté dans le panneau comme un workload vLLMnexora-chat-70b, même si aucun vLLM ne tourne en mode test), assigné à dix workers (h100-fra-01àh100-fra-10) avec une assignation manuelle fixe et une concurrence de 8 chacun, soit 80 slots. Cinquante clés data plane (ik_live_), chacune limitée à l'endpointnexora-private-gpt/enterprise-chat. L'endpoint est compatible OpenAI (.../enterprise-chat/v1). - Trafic. Un script envoie des requêtes de chat depuis les cinquante clés avec des poids de Zipf (quelques clés dominent, longue traîne), 32 flux avec un intervalle de 0,2 s, environ 70 requêtes par seconde. Le tiroir du workload indiquait 4 252 requêtes terminées par minute (moyenne sur 5 minutes). Le compteur de l'en-tête compte les événements
finishedreçus par l'onglet ouvert sur les 60 dernières secondes et repart de zéro à chaque chargement de page, donc ses valeurs dans la prise (de 0 à environ 3 700) sont des rampes, pas la charge. Backlog dans l'en-tête : de 8 à 28. - Workers. Des workers en mode test sur un seul hôte (driver annoncé comme
0.0.mock) : enregistrement réel, prise de jobs réelle depuis la file partagée, chemin de télémétrie réel, sortie générée. La latence (p95 250 ms), la vitesse (142 tokens par seconde par requête), le nombre de tokens et les 0 erreur sont des propriétés du mode test. - Healthy flow. Le tiroir classe le workload comme sain tant que le backlog n'a pas grossi de plus de max(2, 25 %) sur les dernières minutes complètes (jusqu'à 5) et que le débit est supérieur à zéro. Un backlog qui diminue avec un débit qui augmente affiche "Recovering", un backlog qui grossit affiche "At risk", ou "Critical" si le débit baisse aussi.
- Modèle de coût. Coût du projet = heures réservées des workers × prix horaire configuré de chaque worker. Le temps réservé est du temps calendaire tant que le worker est assigné au projet, et les fenêtres partagées entre plusieurs projets sont réparties à parts égales. Ici : 134,53 h × 2,4306 USD/h (1 750 USD / 720 h) = 326,97 USD. Dix workers coûtent 24,31 USD/h, environ 17 500 USD par mois s'ils ne s'arrêtent jamais. Les heures réservées continuent de s'accumuler tant que les workers restent assignés, environ un centime toutes les 1,5 seconde à 24,31 USD/h, donc des captures prises à quelques secondes d'intervalle diffèrent de quelques centimes.
- Par clé. Le coût de chaque clé est sa part des tokens du projet multipliée par le coût du projet : finance-board-reporting avait 17,37M des 93,07M tokens dans la capture 09, soit 18,7 % du coût du projet à ce moment-là, 61,03 USD.
- Coût unitaire. 3,51 USD par million de tokens dans le tableau des workloads, sur une fenêtre où le trafic, à son débit constant, représente environ 72 minutes sur 13,5 heures par worker. Avec une tarification à l'heure, ce chiffre baisse quand l'utilisation augmente. Avec de vrais modèles, c'est le débit de tokens par machine qui tranche.
- Pas montré dans la vidéo. L'ajout d'un onzième worker sous trafic, un worker qui tombe en panne en pleine charge, et la désactivation d'une clé pour voir sa ligne de coût cesser d'augmenter.
Les clés, les scopes et les variables d'environnement sont documentés dans Tokens et clés d'API.