AstaBrief-8B : un rapport de recherche cité à partir de vos propres sources, sur un seul GPU de 24 GB
AstaBrief-8B d'Ai2 transforme une question et vos propres extraits en rapport cité. Nous l'avons testé sur un GPU de 24 GB et compté chaque citation.
"Note that the current year is 2025." (Notez que l'année en cours est 2025.) Cette ligne se trouve au milieu d'un fichier texte d'une page que l'Allen Institute for AI (Ai2) a publié à côté de son nouveau modèle. Ce fichier contient exactement les instructions sur lesquelles AstaBrief-8B a été entraîné, et la fiche du modèle ne prend pas de gants : utilisez un autre prompt et vous risquez un "degraded or inconsistent behavior" (un comportement dégradé ou incohérent). Vous gardez donc le fichier tel quel, 2025 compris, et vous remplissez deux trous : votre question, et les passages d'articles ou de documents que votre propre recherche a trouvés. Il en sort un rapport en sections, avec un court résumé par section et une référence après chaque affirmation. Va-t-il se croire encore en 2025 ? Dans nos rapports, il n'a jamais annoncé la mauvaise année, mais nous n'avons pas vérifié s'il traite les articles de 2025 comme les travaux les plus récents qui existent.
La taille n'a rien de nouveau, puisqu'un modèle de 8 milliards de paramètres tient sur une carte de 24 GB depuis un moment ; c'est l'entraînement qui l'est. AstaBrief est un modèle ouvert de cette taille entraîné pour une seule tâche, l'étape de rédaction de la "deep research" (les outils d'IA qui lisent des dizaines de sources et vous rendent un rapport), avec un prompt fixe, et Ai2 a publié comment il se compare à son propre système en plusieurs étapes, plus lent. Nous l'avons fait tourner sur une seule carte NVIDIA de 24 GB et avons compté chaque référence qu'il a écrite. Voici ce qu'il faut en retenir :
| Quoi | Résultat |
|---|---|
| Modèle | AstaBrief-8B d'Ai2 : le modèle ouvert Qwen3-8B d'Alibaba (8 milliards de paramètres), réentraîné pour écrire des rapports cités. Les poids se téléchargent librement et s'utilisent commercialement (licence Apache 2.0). Le prompt recommandé par Ai2 est réservé à un usage non commercial (voir plus bas). Un téléchargement de 16,4 GB |
| Note d'Ai2 sur 100 vraies questions de recherche | 87,0 sur 100, contre 77,3 pour le modèle de départ |
| GPU utilisé | une NVIDIA RTX A5000, une carte de 24 GB |
| Mémoire utilisée | environ 22 GB sur 24 GB au maximum |
| Vitesse pour un rapport | environ une minute (40 à 65 s), à environ 39 tokens par seconde (un token fait à peu près trois quarts de mot) |
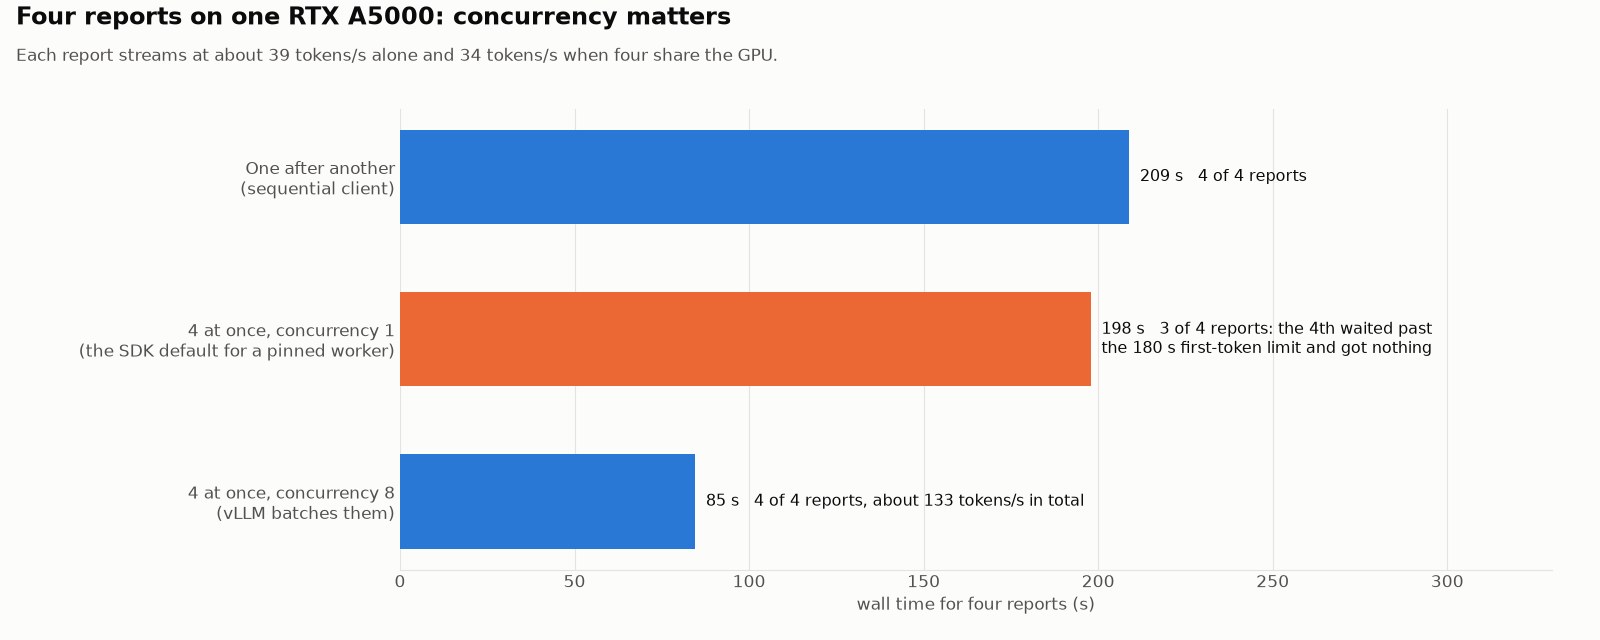
| Quatre rapports à la fois | 85 s pour les quatre, contre 209 s l'un après l'autre |
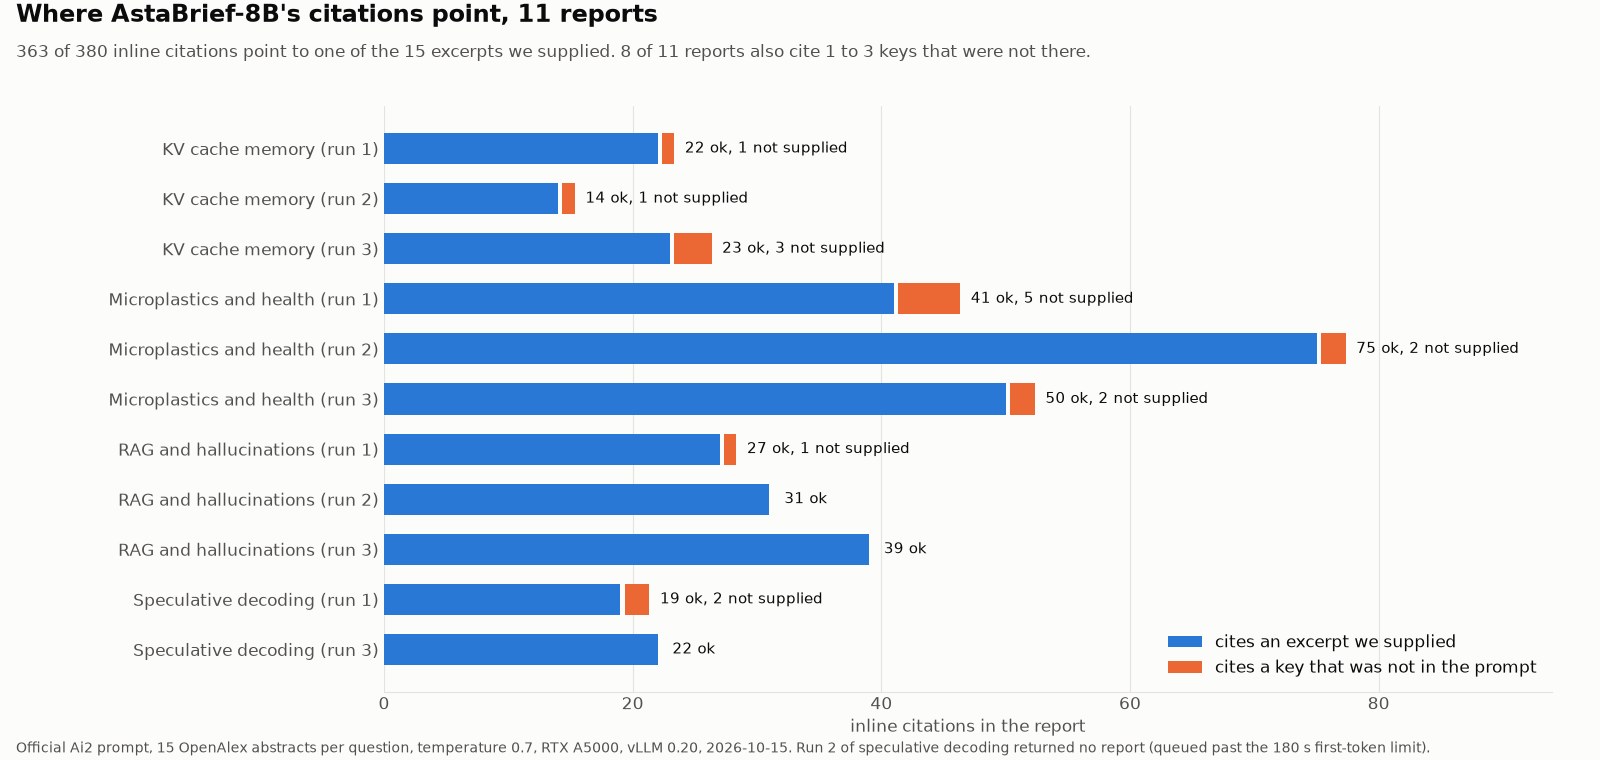
| Références vérifiées | 363 sur 380 renvoient à un passage que nous avons fourni (95,5 %) |
| Le piège | 8 rapports sur 11 citent aussi 1 à 3 sources qui n'étaient pas dans le prompt |
Un examen à livre ouvert avec numéros de page
La façon la plus simple de se représenter ce que fait AstaBrief, c'est un examen à livre ouvert où chaque phrase doit porter un numéro de page. Vous donnez le livre au modèle : 15 courts extraits, chacun avec une étiquette faite d'un identifiant, du premier auteur, de l'année et du nombre de citations (combien d'autres articles citent cet article). Le modèle écrit sa réponse et met entre crochets, après chaque affirmation, l'étiquette de l'extrait qu'il a utilisé. Quand il dit quelque chose qui n'est pas dans le livre, le prompt lui demande de le marquer "(LLM Memory)", le souvenir propre du modèle.
C'est cette séparation qui rend le résultat vérifiable. Une étiquette entre crochets correspond à un extrait que vous lui avez donné, ou pas. Pas besoin de comprendre l'article pour faire cette vérification : il vous faut la liste des étiquettes que vous avez envoyées.
Ce qu'Ai2 a publié
Le 2 octobre, Ai2 a ouvert le code d'AstaBrief, le modèle derrière le "Fast mode" de la fonction de rapports d'Asta, son assistant de recherche. À côté, Asta garde un "Thinking mode" qui tourne avec Claude. L'ancien pipeline travaille par étapes : il résume les extraits récupérés, les regroupe, puis rédige. AstaBrief saute l'étape du milieu et écrit tout le rapport d'un seul jet. Sur l'ensemble du pipeline d'Asta, Ai2 a mesuré en moyenne 51,1 s par rapport en Fast mode contre 178,5 s en Thinking mode.
Ai2 est parti de Qwen3-8B et lui a montré environ 47 000 exemples de rapports écrits par ses outils existants tournant sur des modèles de Claude et d'OpenAI, pour des questions tirées de vraies requêtes des logs d'Asta. Puis il lui a montré environ 6 000 paires de rapports, un meilleur et un moins bon, choisis par deux évaluateurs IA, en ne gardant une paire que si les deux évaluateurs étaient d'accord. Ai2 dit que cette méthode était plus stable et moins chère que les autres, et que le plus gros gain est venu de l'élimination des exemples de rapports avec peu de citations.
Il y a une séparation de licences à connaître avant de construire quoi que ce soit. Le modèle se télécharge sans rien demander et s'utilise commercialement (Apache 2.0), mais le fichier d'instructions et les paires de rapports meilleur/moins bon sont réservés à un usage non commercial (CC-BY-NC-4.0), et Ai2 décrit le modèle comme destiné à la recherche et à l'enseignement. Comme le fichier d'instructions est non commercial, nous n'en livrons pas de copie dans notre code : notre script d'exemple le télécharge chez Ai2 à chaque exécution. Cela ne change rien à ses conditions. Quiconque lance le script utilise le prompt sous la licence non commerciale d'Ai2.
Ai2 défend aussi l'idée de le faire tourner en interne. Son blog dit que les poids ouverts permettent aux institutions de faire tourner AstaBrief sur leur propre infrastructure, "which is necessary when research questions reveal sensitive or unpublished work" (ce qui est nécessaire quand les questions de recherche révèlent des travaux sensibles ou non publiés), et il a publié un exemple de workflow que les chercheurs peuvent adapter pour produire des rapports à partir de leurs propres PDF.
Ce qu'il vaut, d'après les chiffres d'Ai2
Ai2 l'a noté sur 100 questions de recherche en informatique écrites par de vrais utilisateurs. AstaBrief-8B obtient 87,0 sur 100, contre 77,3 pour Qwen3-8B de base, et le gain porte surtout sur les références. Ai2 vérifie si chaque affirmation est entièrement étayée par les sources que le rapport donne pour elle : c'est le cas pour environ 78 affirmations sur 100 avec AstaBrief, contre environ 65 pour le modèle de base. Et parmi les sources qu'il donne, environ 9 sur 10 étayent vraiment l'affirmation, contre environ 3 sur 4 avant. Le seul score qui a baissé, très légèrement, est la mesure d'Ai2 de la part de chaque réponse qui reste dans le sujet : 90,6 avant, 89,0 après.
Dans la comparaison côte à côte d'Ai2 avec le rapport de son système en plusieurs étapes, plus lent, le rapport d'AstaBrief a été préféré sur environ 7 questions de test sur 10 (et sur un peu plus de la moitié d'un autre jeu de questions qu'Ai2 a utilisé pendant le développement). Cette comparaison a été jugée par un modèle d'IA, et le tableau de la fiche du modèle ne dit pas lequel. Le mot d'Ai2 lui-même pour ce résultat est "competitive with" (compétitif avec). Un autre modèle d'Ai2 de la même taille, DR-Tulu-8B, obtient un score légèrement plus élevé sur le même test, et sur un second test AstaBrief arrive dernier des trois, environ 54 contre 56 et 60. Dans une petite étude avec trois chercheurs, DR-Tulu a été préféré globalement, tandis que deux des trois ont préféré AstaBrief pour la précision des citations.
Ai2 nomme aussi une limite que ses scores ne captent pas : un modèle peut citer la bonne étude et quand même exagérer ce qu'elle a trouvé.
Le faire tourner sur InferenceKey
La carte et le logiciel
Pour le logiciel qui le fait tourner, AstaBrief-8B ressemble à n'importe quel autre modèle Qwen3, donc il tourne sur vLLM, le programme open source de service de modèles intégré à InferenceKey, sans code spécifique. Nous avons loué une NVIDIA RTX A5000 sur RunPod, une carte de station de travail de 24 GB dans la même catégorie de mémoire qu'une RTX 4090 de gaming. Notre logiciel a besoin d'un driver NVIDIA récent, donc nous n'avons loué que des machines qui en avaient un. C'est notre exigence, pas celle du modèle.
Le modèle prend 16,4 GB des 24 GB de la carte. Nous avons autorisé chaque requête à aller jusqu'à environ 16 000 tokens (question, extraits et rapport ensemble), la longueur qu'Ai2 a utilisée dans son dernier cycle d'entraînement. Cela laisse de la place pour deux requêtes de cette longueur maximale à la fois, ou environ quatre de la taille que nous avons réellement envoyée (à peu près 7 000 tokens chacune, question plus rapport).
Les étapes
Notre exemple du SDK (un script Python prêt à l'emploi qui utilise la bibliothèque d'InferenceKey) fait tout en un seul script : il demande à InferenceKey de faire tourner le modèle sur votre machine GPU, attend que le modèle soit prêt, construit le prompt d'Ai2 à partir de votre question et de vos extraits, demande un rapport et arrête le modèle à la fin. Le cœur du script :
MODEL = "allenai/AstaBrief_8B"
COMMAND = f"vllm serve {MODEL} --max-model-len 16384 --dtype bfloat16"

spec = WorkloadSpec(
    name="AstaBrief-8B cited reports (vLLM)",
    slug="astabrief-8b",
    model=MODEL,
    backend=Backend.VLLM,
    command=COMMAND,
    task_type="text2text",
    worker_id=os.environ["IK_WORKER_ID"],
    execution_policy=ExecutionPolicy.FIXED,
    execution_policy_config={"replicas": 1},
)
ref = mgmt.ensure(spec)
mgmt.wait_until_ready(ref.workload_slug, timeout=1800)
out = DataClient.from_env().endpoint(ref.workload_slug).generate_text(
    messages=[{"role": "user", "content": build_prompt(query, references)}],
    temperature=0.7, max_tokens=4096,
)
Le script récupère les instructions d'Ai2 et donne à chacun de vos extraits le même genre d'étiquette que celle que le modèle a vue à l'entraînement : un identifiant, l'auteur, l'année et le nombre de citations. Lancez python main.py pour les six extraits d'exemple fournis avec le script, ou python main.py my_references.json pour les vôtres. Le modèle répond dans le même format que le service d'OpenAI, donc le code que votre équipe a déjà écrit pour OpenAI peut lui parler en changeant une seule adresse.
Nous avons fait le test sur une copie privée d'InferenceKey, jamais sur le service en production. Pour travailler sur du vrai matériel, nous avons posé 4 questions (trois sur la façon de rendre les modèles d'IA plus rapides et plus fiables, une sur les microplastiques et la santé) et donné à chacune les résumés de 15 articles d'OpenAlex, un catalogue gratuit d'articles de recherche.
Ce que nous avons mesuré
Un rapport prend environ une minute (41,5 à 64,7 s seul sur la carte). Démarrer le modèle sur une machine fraîchement louée, c'est une attente unique d'environ quatre minutes (245,7 s), dont plus de la moitié (137 s) pour installer le logiciel de service. Le téléchargement du modèle a pris 18 s, et son démarrage environ une minute et quart de plus. Au maximum, la carte a utilisé environ 22 de ses 24 GB.
Un rapport commence à apparaître une seconde et demie après la demande, et un rapport typique fait 1 600 à 2 400 tokens, à peu près quelques pages.
Une seule carte peut-elle écrire plusieurs rapports à la fois ? Oui. Quatre rapports envoyés ensemble ont fini en 85 s, contre 209 s l'un après l'autre. Chaque rapport a pris un peu plus longtemps pris isolément (52 à 85 s au lieu de 42 à 65 s), mais les quatre étaient terminés en moins d'une minute et demie. Les rapports n'étaient pas identiques d'une exécution à l'autre, donc prenez cela comme une image fidèle plutôt que comme un chronométrage exact.
Pour y arriver, il a fallu un réglage : combien de requêtes le modèle peut prendre à la fois (le graphique appelle cela "concurrency"). Le nôtre partait de un, et au premier essai les quatre rapports ont fait la queue : 198 s, et un rapport perdu (voir plus bas).
Vérifier les numéros de page
Retour à l'examen à livre ouvert. Sur 11 rapports (dont un coupé à la limite de 4 096 tokens), le modèle a écrit 380 références, et 363 d'entre elles, 95,5 %, renvoient à un extrait que nous avons fourni. Il a aussi bien utilisé le livre : chaque rapport s'est appuyé sur 11 à 15 de ses 15 sources.
Les 17 autres sont la partie à prévoir. Dans 8 des 11 rapports, le modèle a cité 1 à 3 étiquettes qui n'étaient pas dans le prompt. Certaines sont un article fourni avec une étiquette abîmée : un article de Thapliyal 2025 est revenu sans le W au début de son identifiant, avec le dernier chiffre changé et un nombre de citations de 111 au lieu de 45 (le nombre d'articles qui le citent). D'autres sont des articles tirés de la mémoire du modèle, comme un article de Derraik 2002 avec 2 594 citations, écrit exactement dans le même format d'étiquette que les vrais extraits et sans la marque "(LLM Memory)". Le mécanisme prévu par le prompt pour cette marque a été utilisé une seule fois en 11 rapports.
Nous avons aussi vu des détails dériver. Un rapport s'est trompé sur le nombre de citations d'un article (combien d'autres articles le citent) : il a écrit 25 au lieu de 27, sept fois de suite. Dans le court exemple, le rapport a transformé "un huitième" d'un coût en "1/4 cost", et a ajouté une section sans aucune référence. C'est exactement la limite contre laquelle Ai2 mettait en garde : la bonne source à côté d'une affirmation qui n'est pas tout à fait ce que dit la source.
La réponse pratique ne coûte pas cher. Puisque vous connaissez chaque étiquette envoyée, quelques lignes de code peuvent signaler tout crochet du rapport qui ne correspond à aucune d'elles avant qu'une personne le lise. Les chiffres qui viennent des extraits méritent de toute façon une seconde lecture humaine : vérifier les références reste votre travail.
La vidéo de démo
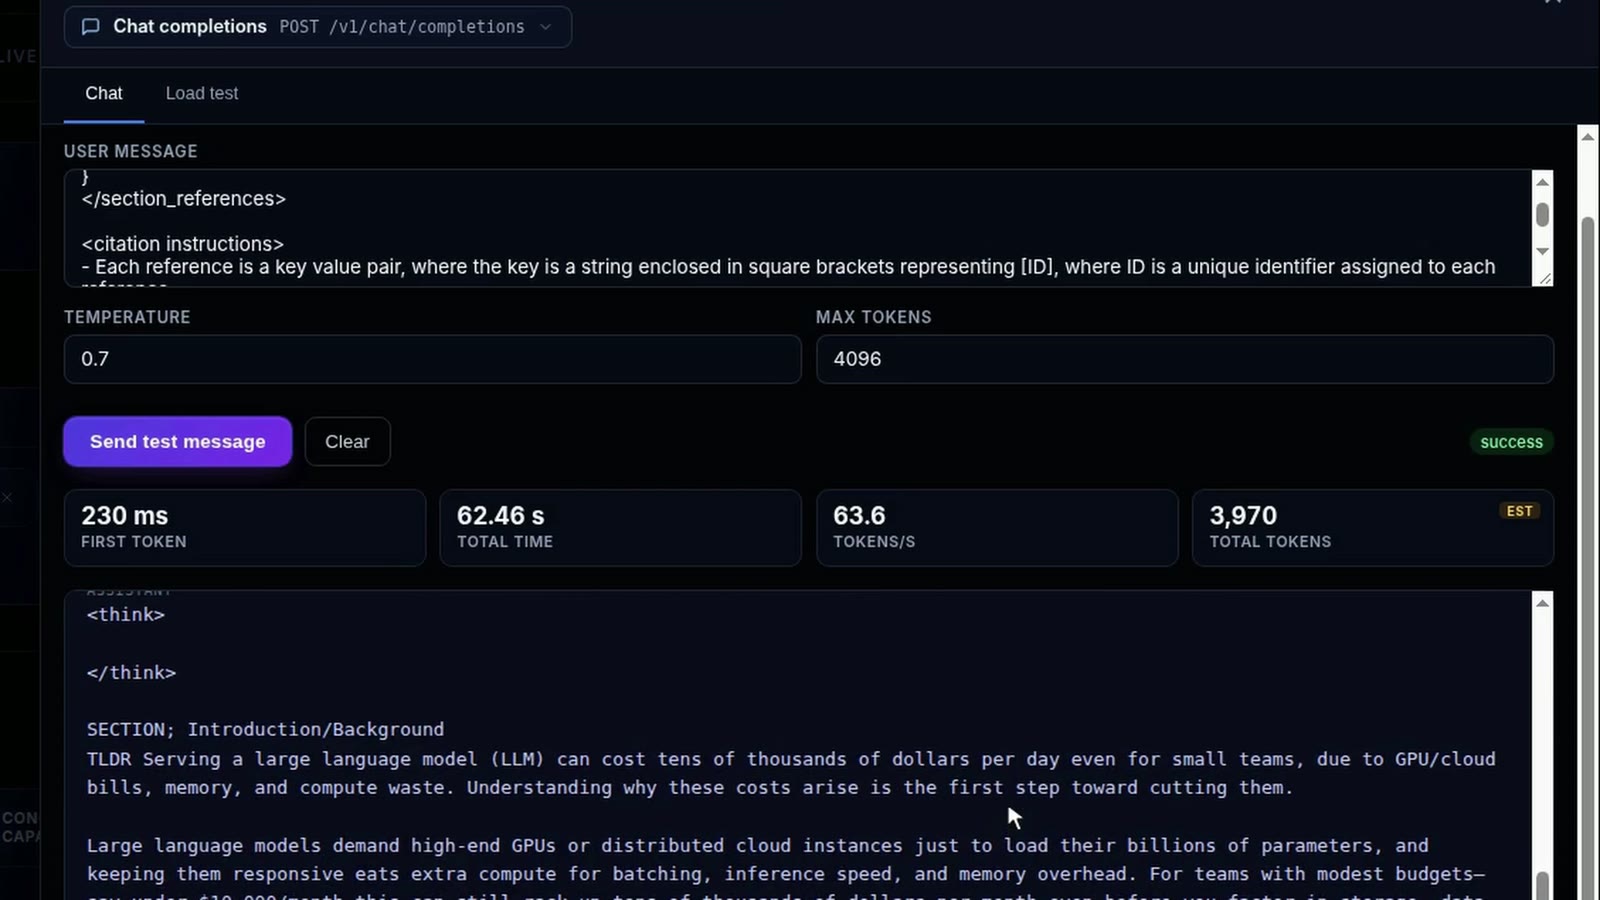
La vidéo montre le modèle qui tourne sur la RTX A5000 dans le tableau de bord d'InferenceKey, le prompt d'Ai2 rempli avec les six extraits d'exemple dans l'écran de test intégré, et le rapport qui apparaît section par section. Avec seulement les six courts extraits d'exemple à lire, au lieu de quinze, les premiers mots sont apparus en moins d'un quart de seconde (230 ms), et le rapport complet a pris environ une minute (62,46 s).
Ce qui a mal tourné
Deux problèmes venaient de nous, dans la plateforme. Le premier a un contournement aujourd'hui ; le second n'a pas encore de correctif.
- Un modèle lié à un GPU ne prend qu'une requête à la fois. Quand notre SDK attache un modèle à une machine GPU précise, la plateforme ne laisse ce modèle prendre qu'une requête à la fois. Ajouté de n'importe quelle autre façon, il en prend jusqu'à 20 par défaut. C'est pour cela que les quatre rapports ci-dessus ont fait la queue. C'est notre bug, et un appel de réglage le corrige aujourd'hui (détails dans "Pour les ingénieurs").
- Une longue attente se termine par une réponse vide. Une requête qui attend plus de 3 minutes son premier mot est fermée avec une réponse vide et sans erreur, pendant que le GPU continue d'écrire le rapport pour personne (107 s de plus dans notre cas). Elle devrait renvoyer une erreur claire et annuler le job. Nous n'avons pas encore de correctif.
Le reste relève du modèle ou du marché de la location. Le résultat a besoin d'un léger nettoyage avant que quelqu'un le lise. Chaque rapport commence par une balise "thinking" vide, comme l'écrivent les modèles Qwen3 quand le raisonnement est activé (nous n'avons pas testé de le désactiver), et les résumés de section sont marqués un peu différemment de ce que demande le prompt. Les deux s'enlèvent facilement avec quelques lignes de code. Passer nos étiquettes de sources à de simples numéros a empêché le modèle d'en faire tomber une lettre, mais il a quand même écrit de mauvaises étiquettes pour deux articles fournis, donc la vérification des étiquettes n'est pas facultative. Nos notes d'exécution signalent aussi un fragment du balisage des données d'entraînement elles-mêmes au milieu d'un rapport ; nous ne l'avons pas revérifié, mais un simple filtre de nettoyage vaut la peine d'être ajouté.
Qui a fait quoi
L'équipe Asta d'Ai2 a construit et publié AstaBrief : les données d'entraînement tirées des logs et des pipelines d'Asta, les deux cycles d'entraînement avec son propre code d'entraînement open source (open-instruct) sur 8 des grands GPU de data center de NVIDIA (H100), l'évaluation et le prompt. Ses rapports d'entraînement venaient de pipelines tournant sur des modèles d'Anthropic et d'OpenAI, les rapports concurrents du second cycle venaient aussi de modèles DeepSeek, et GPT-4.1 et DeepSeek-R1 ont servi d'évaluateurs. Ai2 a aussi publié l'exemple de workflow pour des rapports à partir de vos propres PDF, et a défendu l'idée de faire tourner le modèle sur votre propre infrastructure. L'équipe Qwen a entraîné Qwen3-8B, la base sur laquelle tout repose. Le projet vLLM le sert sans aucune modification. Hugging Face héberge les poids et le prompt, OpenAlex nous a fourni les résumés pour de vrais extraits, et RunPod nous a loué la carte. Nous avons repéré la sortie dans une vidéo d'AI Search.
Notre part : assembler le tout sur InferenceKey, écrire l'exemple du SDK, le faire tourner de bout en bout sur une carte de 24 GB, mesurer la vitesse et la mémoire, et compter chaque référence des rapports.
Ce qu'il faut retenir
Si vous avez déjà une étape de recherche sur vos propres documents, AstaBrief-8B est un rédacteur de rapports que vous pouvez faire tourner à côté sur une carte de 24 GB, environ une minute par rapport et plusieurs à la fois. Notre article sur EmbeddingGemma 2 couvre ce côté recherche. Comme Ai2 le soutient lui-même, la raison de le faire tourner vous-même, c'est le contrôle : la question, les extraits et le rapport restent sur une machine que vous choisissez. Pour une entreprise, il y a une condition. Le prompt recommandé par Ai2 est sous licence pour un usage non commercial uniquement, donc un produit commercial demande soit une vérification de cette licence, soit son propre prompt dans le même format, et la fiche du modèle prévient qu'un autre prompt peut faire moins bien fonctionner le modèle.
Les limites, sans détour. Notre test était petit : 4 questions, 15 résumés chacune, 11 rapports (dont un coupé à la limite de 4 096 tokens). Nous n'avons pas noté les rapports ni ne les avons comparés avec un autre modèle sur nos questions. Les chiffres de qualité ci-dessus sont ceux d'Ai2, et ils ne viennent que de questions d'informatique. Trois de nos quatre questions portaient elles aussi sur l'IA et l'informatique, et une seule (les microplastiques) sortait de ce domaine, donc nous ne pouvons rien dire des autres sujets. Les entrées étaient de courts résumés d'articles publics, pas les documents internes d'entreprise pour lesquels l'outil est présenté. Nos 15 extraits par question remplissaient moins d'un tiers de la place que nous avions prévue (environ 5 000 tokens sur 16 000), donc nous ne savons pas comment il se comporte avec des entrées beaucoup plus longues.
Nous avons vérifié que chaque référence renvoie à un extrait que nous avons envoyé. Nous n'avons pas vérifié que chaque phrase dit ce que dit son extrait. Donc 95,5 % signifie que les références sont réelles, pas que les affirmations sont justes. Les dérives ci-dessus sont ce que nous avons remarqué en chemin, pas une relecture ligne par ligne.
Et le modèle écrit des références sûres d'elles qu'il faut vérifier. L'une des étiquettes qu'il a écrites se lit [4411306415 | Thapliyal et al. | 2025 | Citations: 111]. L'extrait que nous avions envoyé était [W4411306417 | Thapliyal et al. | 2025 | Citations: 45]. Vos lecteurs s'en apercevraient-ils ?
Pour les ingénieurs
Modèle (fiche du modèle, checkpoint SFT, blog d'Ai2, config.json, données DPO, Qwen3-8B de base). Repo HF allenai/AstaBrief_8B, sha 6a34f54d..., modifié pour la dernière fois le 2026-10-03, license:apache-2.0, non gated, 1 979 téléchargements le mois dernier et 66 likes quand nous l'avons récupéré. Lignée : Qwen3-8B-Base, Qwen3-8B, AstaBrief_8B_SFT (SFT sur AstaBrief_SFT_Mix), AstaBrief_8B (DPO offline sur AstaBrief_DPO_Mix), les deux étapes dans open-instruct sur 8x H100. Qwen3ForCausalLM, 36 couches, hidden 4096, intermediate 12288, 32 têtes de requête et 8 têtes KV, head_dim 128, max_position_embeddings 40960, rope_theta 1 000 000, pas de rope_scaling, vocabulaire 151936, bfloat16. generation_config.json : temperature 0,6, top_k 20, top_p 0,95. L'exemple de la fiche utilise temperature 0,7, top_p 0,95, max_tokens 4096, stop_token_ids=[eos]. Quatre shards safetensors, 16 381 516 824 octets, plus quatre shards pytorch_model-*.bin en double et seulement un pytorch_model.bin.index.json.
Entraînement. SFT : 5 epochs, LR 5e-06, warmup 0,03, grad accumulation 4, longueur de séquence max 32 768, BF16. DPO : 7 epochs, LR 5e-06 linéaire, warmup 0,1, loss DPO Norm, beta 10, batch par device 1, grad accumulation 8, longueur de séquence max 16 000, BF16. Le chiffre de 16K correspond donc à l'étape DPO, pas à tout l'entraînement. Blog : environ 90K requêtes issues de logs Asta filtrés, 47K exemples SFT venant de pipelines ScholarQA reposant sur Claude 3.5 Sonnet, Claude 3.7 Sonnet, o3, o4-mini et GPT-4.1, environ 6K paires DPO (un rapport du ScholarQA reposant sur Claude, le concurrent venant d'o3, o4-mini, DeepSeek-V3 ou DeepSeek-R1, le gagnant choisi par les deux juges, GPT-4.1 et DeepSeek-R1, gardé seulement en cas d'accord), 95 % d'accord avec les humains. La fiche du dataset DPO indique 6,6k instances, des requêtes d'OpenScholar et d'Asta ScholarQA jusqu'en juin 2025, CC BY-NC 4.0, les sorties de modèles tiers restant soumises aux conditions des fournisseurs.
Évaluation d'Ai2. Test ScholarQA-CS2 (moyenne / ingredient recall / answer precision / citation precision / citation recall) : Qwen3-8B 77,3 / 77,8 / 90,6 / 76,2 / 64,6, AstaBrief-8B-SFT 83,7 / 85,2 / 90,4 / 87,7 / 71,3, AstaBrief-8B 87,0 / 90,2 / 89,0 / 90,5 / 78,2. Tableau comparatif (SQA-CS2 dev / test / DeepScholarBench) : Asta ScholarQA 87,6 / 86,2 / 60,25, DR-Tulu-8B 86,5 / 88,8 / 56,26 (win rate contre Asta SQA 36 % en dev, 54 % en test), AstaBrief-8B 86,3 / 87,0 / 53,50 (55 % en dev, 72 % en test). Blog : les évaluations ont tourné en 2025 face aux modèles de pointe de l'époque, et les métriques ne mesurent pas si un rapport garde la portée et la force de ses sources. Premiers usages parmi 374 utilisateurs d'Asta : 29,1 % ont utilisé le Fast mode deux jours ou plus, 3,67 fils de rapports en moyenne, 23 % ne sont jamais revenus au Thinking mode, retours positifs 84,2 % en Fast contre 85,2 % en Thinking (peu de données).
Prompt. sft_prompt.txt, 3 154 octets, dataset allenai/AstaBrief_prompts révision 355b7a260fce95820a2bdf359ca1ddec920ee974, CC-BY-NC-4.0 (il contient aussi pairwise_judge_prompt.txt et query_filter_prompt.txt). Placeholders [QUERY] et [SECTION_REFERENCES] dans un bloc <section_references> de paires "[ID]": "quote". Citation dans le texte sous la forme [ID], connaissance propre sous la forme (LLM Memory). Chaque section commence par SECTION; plus un nom, puis TLDR; et un résumé de deux phrases sans citations. Formats LIST ou SYNTHESIS uniquement. Un nombre de citations de 100 ou plus autorise "notable". Les étiquettes d'entraînement ressemblent à [230644543 | Miguel et al. | 2020 | Citations: 5].
Notre installation. RunPod NVIDIA RTX A5000 24 GB, cloud SECURE (location d'environ 0,27 USD de l'heure), image runpod/pytorch:1.0.7-cu1300-torch291-ubuntu2404-cluster. RTX 4090, RTX A5000 et RTX 3090 COMMUNITY ont répondu 409 (rupture de stock). Driver 580.159.04 (CUDA 13.0), limite de puissance 230 W, compute capability 8.6. Pods filtrés avec allowed_cuda_versions de 13.0 à 13.4. Bootstrap du worker 76 s après le POST du pod. Manager InferenceKey local joint via des tunnels HTTP et TCP, production jamais touchée. Backend : vllm intégré, vLLM 0.20.0 (défaut du worker), torch 2.11.0+cu130. Commande vllm serve allenai/AstaBrief_8B --max-model-len 16384 --dtype bfloat16 (gpu-memory-utilization 0,92 est la valeur effective appliquée par le worker, elle ne fait pas partie de la commande). Le script du SDK supprime le workload à la fin sauf si IK_KEEP_ALIVE=1. Exemple du SDK au commit 728d890 sur la branche main d'inferencekey-sdk (main.py, README.md, .env.example, requirements.txt, sample_references.json, .gitignore).
Temps avant d'être prêt. 245,7 s entre ensure() et l'état prêt sur un pod à froid : installation de vLLM 137 s (venv de 8,1 GB), téléchargement des poids 17,94 s (safetensors seulement), chargement des poids 2,82 s, chargement du modèle 15,27 GiB en 21,90 s, initialisation du moteur 40,49 s (compilation 23,42 s), vLLM prêt 91 s après le démarrage.
Mémoire et puissance. KV cache 4,6 GiB = 33 472 tokens, concurrency max 2,04x à 16 384 tokens par requête. Processus vLLM 21 850 MiB, pic GPU total 22 069 MiB sur 24 564. Pic de puissance 230,07 W.
Par requête (prompt officiel, 15 résumés OpenAlex par question, temperature 0,7, max_tokens 4096, streaming via le gateway local, tokens comptés avec le tokenizer du modèle parce que le stream ne portait pas de usage même avec stream_options.include_usage) :
| Exécution | Tok prompt | Tok rapport | Premier token s | Total s | Décodage tok/s |
|---|---|---|---|---|---|
| Séquentiel, 4 questions | 4 374 à 5 068 | 1 570 à 2 444 | 1,37 à 1,58 | 41,5 à 64,7 | 38,7 à 39,1 |
| 4 à la fois, concurrency 1 | 4 359 à 5 053 | 1 472, 1 926, 4 096 (max_tokens atteint), 0 | 1,22, puis 40,4 et 91,5 (en file) | 38,9 à 197,9, une vide à 180,0 | 38,5 à 39,0 |
| 4 à la fois, concurrency 8 | 4 359 à 5 053 | 1 707 à 2 874 | 0,37 à 0,74 (prefix caching) | 51,5 à 84,6 | 33,4 à 34,2 |
Nos prompts (4,4K à 5,1K tokens) sont restés bien en dessous de la limite de 16 384 tokens, et rien n'a été mesuré près de cette limite. Temps total pour quatre rapports : 209 s en séquentiel, 198 s avec une concurrency de 1 (3 sur 4 livrés), 85 s avec une concurrency de 8. Log de vLLM pendant l'exécution en concurrency 8 : Avg generation throughput de 132,0 à 136,0 tokens/s avec Running: 4 reqs. main.py avec les 6 extraits d'exemple (sans streaming) : 40,9 s, 1 171 tokens de prompt, 1 563 tokens de rapport, 8 sections, 6 références citées sur 6. Testeur du panneau : premier token 230 ms, total 62,46 s (ses 63,6 tokens/s et 3 970 tokens au total incluent le prompt estimé).
Citations. 11 rapports (dont un, en concurrency 1, coupé à max_tokens 4096), 380 citations dans le texte, 363 (95,5 %) vers un extrait fourni. Par rapport, fournies/non fournies : 22/1, 14/1, 23/3, 41/5, 75/2, 50/2, 27/1, 31/0, 39/0, 19/2, 22/0. 8 rapports sur 11 citent des étiquettes absentes du prompt : 17 marques, 11 étiquettes distinctes. Copies abîmées d'articles fournis : [4411306415 | Thapliyal et al. | 2025 | Citations: 111] pour [W4411306417 | Thapliyal et al. | 2025 | Citations: 45], [4414281756 | Kadac-Czapska et al. | 2025 | Citations: 13] pour [W4414281754 | Kadac-Czapska et al. | 2025 | Citations: 9] (les deux dans l'exécution avec des identifiants OpenAlex préfixés par W : W supprimé, dernier chiffre changé), et, en abrégé, Sheng et al. 2024 avec 160 citations (étiquette 269117055) et Jiang et al. 2023 avec 20 citations (étiquette 3664640) pour les articles FlexGen et LLMLingua fournis. De mémoire, dans le même format d'étiquette et sans la marque LLM Memory : Santhanam 2023 (163), Sharma 2023 (505), Jiang 2020 (1666), Daza 2021 (87), Sala-Newhausen 2020 (352), Derraik 2002 (2594), Antonini 2021 (102). Sources fournies utilisées par rapport : 11 à 15 sur 15. Une citation [LLM Memory] en 11 rapports.
Format. Avec des identifiants OpenAlex comme W4402683901, le modèle faisait souvent tomber le W en citant, donc les exécutions suivantes ont utilisé des identifiants numériques. Cela a mis fin au W perdu, pas aux mauvaises étiquettes : les exécutions à identifiants numériques ont quand même produit les étiquettes Sheng 2024 et Jiang 2023 ci-dessus pour des articles fournis. Chaque rapport commence par un bloc <think>\n\n</think> vide (Qwen3-8B documente que le bloc est toujours présent, éventuellement vide, quand le raisonnement est activé, et nous n'avons pas testé de le désactiver). 4 à 8 blocs SECTION; par rapport. Aucun des 12 fichiers enregistrés ne contient TLDR; (une prise du testeur l'a montré). Dérive des métadonnées : Nouri 2025 cité avec 25 citations au lieu de 27 (sept fois dans un même rapport), Chen et al./80 pour une étiquette fournie Zixuan/25. L'exemple à 6 extraits a transformé "one eighth" en "1/4 cost" et "Up to 4x cheaper", et a ajouté une section "Operational considerations" sans citation. Nos notes d'exécution signalent un fragment [4]<Paper corpusId="2024" paperTitle="(2024)" isShortName></Paper> dans le rapport de la prise finale de la démo. Nous ne l'avons pas revérifié image par image. Ligne du prompt "Note that the current year is 2025" : un grep sur les fichiers de rapports enregistrés (12 rapports du banc d'essai plus 2 exécutions de l'exemple) n'a trouvé aucune phrase qui annonce l'année en cours ou fait un calcul sur les années ; 2025 et 2026 n'apparaissent que comme années de publication d'articles cités (dans les étiquettes et dans des mentions auteur-année comme "Wang et al. (2025)"). Pas vérifié pour des formulations plus subtiles sur la nouveauté.
Problèmes de la plateforme. (1) ensure() avec un worker_id crée l'assignation avec un max_in_flight littéral de 1 (insert_assignment_with_version(..., wid, 1) dans crates/manager/src/services/workloads.rs), alors que la valeur par défaut de l'API des assignations, DEFAULT_MAX_IN_FLIGHT, est 20. Contournement : PATCH /api/projects/<pid>/assignments/<workload>/<worker> avec {"max_in_flight":8}, réponse 204. (2) Pas encore de contournement. STREAM_FIRST_TOKEN_TIMEOUT_MS = 180_000 dans crates/manager/src/api/openai.rs : un stream en file s'est terminé à 180,02 s avec un HTTP 200, sans contenu et sans finish_reason, et le worker a quand même terminé ce job en 106 767 ms. (3) Les streams via le gateway ne portaient pas de usage.
Données de test. L'API de Semantic Scholar a répondu 429, donc nous avons utilisé OpenAlex : travaux avec résumé, à partir de 2019, plus de 8 citations, 15 par question. Tailles de prompt de 4 359 à 5 068 tokens avec le tokenizer du modèle.
Vidéo et nettoyage. Vidéo de démo : 1920x1080, 131,4 s. Nettoyage : workload et pod supprimés (RunPod répond 404), tunnels, NATS, base de données et bucket MinIO vide supprimés.
Sources : fiche du modèle, fiche du modèle SFT, blog d'Ai2, prompt, données DPO, Qwen3-8B, exemple du SDK, vidéo de démo.