Ternary Bonsai 2 27B : un modèle de raisonnement de 27B en 6 GB qui garde 98 % aux tests de Prism ML
Prism ML a fait tenir Qwen3.8-27B dans un fichier de 5,95 GB à poids ternaires. Sur une RTX 4090 : environ 104 tokens/s pour environ 12 GB de mémoire.
Qwen3.8-27B, le modèle ouvert de raisonnement et de vision de l'équipe Qwen d'Alibaba, pèse environ 54 GB dans sa forme d'origine, en pleine précision, d'après la fiche du modèle de Prism ML. La version que nous avons fait tourner sur une seule carte graphique de gamer est un fichier de 5,95 GB. Nous lui avons demandé de lire un menu sur une photo, de résoudre une énigme de placement à table qui a trois solutions valides et de retrouver un code caché dans un document d'environ 25 000 mots. Chaque question a été posée une ou deux fois, et toutes les réponses étaient justes.
D'après les tests de Prism ML, Ternary Bonsai 2 27B garde 98,2 % de la qualité de l'original. Une réduction classique à presque la même taille en garde 84,1 %. Prism ML l'a publié en septembre sous licence Apache 2.0 (utilisable gratuitement à des fins commerciales). C'est la deuxième tentative de Prism ML avec ce format à trois valeurs sur un modèle de 27 milliards de paramètres, et elle obtient de meilleurs scores que la première. Pour le faire tourner, il vous faut la version modifiée par Prism ML des outils gratuits habituels, parce que les outils standard ne savent pas lire le fichier. Voici ce qu'il faut en retenir :
| Quoi | Résultat |
|---|---|
| Modèle | Ternary Bonsai 2 27B de Prism ML : Qwen3.8-27B (27B paramètres, lit du texte et des images) stocké de sorte que presque chaque nombre interne vaut simplement -1, 0 ou +1 |
| Taille du fichier | 5,95 GB (version la plus petite) ou 7,21 GB, contre environ 54 GB pour l'original |
| Qualité, fiche du modèle de Prism ML | 84,78 contre 86,32 pour l'original sur 14 tests de raisonnement (98,2 %). La méthode classique pour le réduire à une taille similaire : 72,59 |
| GPU utilisé | une NVIDIA RTX 4090, une carte de gamer de 24 GB, louée sur RunPod |
| Mémoire utilisée en service | environ 12 GB sur les 24 de la carte, avec une mémoire de travail de 65 536 tokens partagée par jusqu'à 4 utilisateurs à la fois |
| Vitesse pour un utilisateur | environ 104 tokens par seconde (un token correspond à peu près aux trois quarts d'un mot) |
| Quatre utilisateurs à la fois | environ 159 tokens par seconde au total, après avoir relevé un réglage |
| De la demande du modèle à l'état prêt (machine GPU déjà préparée) | 55 secondes, surtout des téléchargements |
| Le piège | il faut la version modifiée de llama.cpp de Prism ML pour le faire tourner |
Une table de mixage avec des interrupteurs à la place des faders
Physiquement, un modèle de langage est une très longue liste de nombres qu'on appelle des poids. Dans le Qwen3.8-27B d'origine, chacun est stocké sur 16 bits : imaginez une table de mixage où chacun des 27 milliards de faders peut prendre n'importe laquelle de 65 536 positions.
Prism ML a remplacé presque chaque fader par un interrupteur à trois positions : bas, éteint, haut (-1, 0, +1). Ensuite, pour chaque groupe de 128 interrupteurs, il a gardé un fader ordinaire qui règle le volume de tout le groupe. Chaque interrupteur, avec sa part du fader de groupe, coûte moins de 2 bits, contre 16 dans l'original : c'est pour cela que le fichier est environ neuf fois plus petit. Prism ML livre deux versions du fichier, de 5,95 GB et de 7,21 GB. La plus grosse est plus rapide sur certaines cartes graphiques.
Avant de transformer les faders en interrupteurs, Prism ML a aussi recâblé la table selon un schéma fixe. Tout ce qui passe par elle doit traverser le même recâblage, sinon le son sort brouillé. La lecture d'images demande un fichier séparé et facultatif de 0,63 GB.
Les questions faciles cachent les dégâts
Sur une compétition de maths difficile, Bonsai obtient 95,83, et 90,07 sur un test de code, d'après la fiche du modèle. La méthode habituelle pour réduire le modèle à peu près à la même taille (7,27 GB) tombe à 57,5 et 56,4 sur ces mêmes tests, alors qu'elle obtient 88,93 à un quiz de culture générale facile, proche de l'original. La formule de la fiche du modèle : "why casual testing misses the collapse" (pourquoi les tests rapides ne voient pas l'effondrement).
Alors, quand on vous dit qu'un petit modèle "marche bien", la question utile est : sur quoi ? En moyenne sur les 14 tests de la fiche du modèle de Prism ML, tous avec le droit pour le modèle de réfléchir avant de répondre :
| Version | Taille | Moyenne | Part de l'original |
|---|---|---|---|
| Qwen3.8-27B, original | environ 54 GB | 86,32 | 100 % |
| Version 4 bits standard (par Unsloth, une équipe qui publie des modèles réduits) | 17,6 GB | 85,18 | 98,7 % |
| Version 2 bits standard | 7,27 GB | 72,59 | 84,1 % |
| Ternary Bonsai 2 27B | 5,95 GB | 84,78 | 98,2 % |
Les maths et le code passent presque intacts. Les pertes se trouvent dans la culture générale et le raisonnement (79,86 contre 85,55) et dans la lecture d'images (66,19 contre 71,36).
Deux remarques tirées du whitepaper de Prism ML. Sur un travail de code long et en plusieurs étapes, corriger de vrais bugs dans du vrai code, il ne garde qu'environ les trois quarts de l'original (60,8 contre 80,6). Et dans le whitepaper, les 98,2 % sont mesurés avec la réflexion au maximum (un réglage appelé xhigh). Avec une réflexion moyenne, Bonsai obtient 79,3, contre 83,9 avec la réflexion au maximum, et l'original obtient 82,6 en moyenne.
Le llama.cpp standard ne sait pas lire le fichier
llama.cpp est le programme open source qui fait tourner des fichiers de modèle comme celui-ci sur votre propre machine. La fiche du modèle le dit sans détour : "Stock llama.cpp will not run these files." (le llama.cpp standard ne fait pas tourner ces fichiers). Il rejette les deux formats de Bonsai comme inconnus. La page des problèmes connus ajoute que les applications de bureau populaires pour faire tourner des modèles ne peuvent pas les charger non plus. D'anciennes versions du programme standard pouvaient même ouvrir un fichier Bonsai apparenté et répondre n'importe quoi, parce qu'elles sautent le recâblage décrit plus haut. Nous n'avons pas testé le programme standard nous-mêmes.
La solution est la copie modifiée de llama.cpp par Prism ML (un fork), avec des builds prêts à l'emploi pour Linux, Windows, macOS et d'autres. La dernière est sortie le 14 octobre. Sous Linux, la page des problèmes connus de Prism ML conseille de prendre le téléchargement compilé pour l'ancienne version du toolkit de NVIDIA (12.8), parce que la plus récente plante sur certaines machines. Cette page date de septembre, avant la version d'octobre, donc nous ne savons pas si le plantage se produit encore. Nous avons utilisé 12.8 sans aucun plantage.
Le modèle réfléchit aussi beaucoup avant de répondre, et cette réflexion compte dans la limite de longueur que vous fixez. Demandez au plus 256 tokens et vous risquez une réponse vide, parce que le modèle les a tous utilisés pour réfléchir. La fiche recommande une limite de 16 384 tokens.
La vitesse attendue
Sur la RTX 4090, la fiche indique que le plus petit fichier écrit environ 91 tokens par seconde pour un utilisateur, soit environ 68 mots par seconde. Le fichier le plus rapide dépend de la carte graphique, et la section Pour les ingénieurs les détaille.
La plus grande différence, c'est la taille : la version 4 bits habituelle de l'original, par Unsloth, fait 17,6 GB, trois fois les 5,95 GB du fichier Bonsai. Nous n'avons pas mesuré la vitesse du modèle d'origine avec le même logiciel sur la même carte.
Le faire tourner sur InferenceKey
Le GPU et le logiciel
Nous l'avons fait tourner sur une RTX 4090 de 24 GB, louée sur RunPod.
InferenceKey démarre les modèles via de petits adaptateurs que nous appelons des backends. Celui intégré pour llama.cpp installe la version officielle, qui ne sait pas lire ce fichier, donc nous avons écrit le nôtre : un paquet de custom backend d'environ 6 KB qu'InferenceKey exécute sur la machine GPU. Il télécharge le fork de Prism ML, le modèle de 5,95 GB et le fichier de lecture d'images, puis démarre le serveur du fork. Une surprise en chemin : le téléchargement du fork suppose que deux bibliothèques NVIDIA sont déjà présentes sur la machine et ne les inclut pas, donc le backend les installe depuis les paquets Python de NVIDIA.
Le backend gère aussi les habitudes du modèle. Il demande une réflexion moyenne par défaut, laisse à chaque réponse de la place pour 16 384 tokens afin que la réflexion ne mange pas la réponse, et remplace le réglage de réflexion "high", qui renvoie une erreur d'après la page des problèmes connus, par la réflexion au maximum. La fiche dit que le niveau moyen est prévu pour des réponses plus courtes. Sur nos deux échantillons, il n'a pas donné de réponses plus courtes que la réflexion au maximum, et aux tests de Prism ML il obtient un score plus bas (79,3 contre 83,9).
Les étapes
Notre exemple du SDK le fait en deux scripts. publish.py envoie une fois le custom backend sur votre compte. main.py demande à InferenceKey de faire tourner le modèle sur votre machine GPU, attend qu'il soit prêt, pose une question (et éventuellement une sur une image), enregistre la réponse et arrête le modèle. Le cœur du code :
spec = WorkloadSpec(
    name="Ternary Bonsai 2 27B",
    slug="ternary-bonsai-2-27b",
    model="prism-ml/Ternary-Bonsai-2-27B-gguf",
    backend="ternary-bonsai-2-27b",  # the custom backend from publish.py
    task_type="text2text",
    worker_id=os.environ["IK_WORKER_ID"],
    execution_policy=ExecutionPolicy.FIXED,
    execution_policy_config={"replicas": 1},
)
ref = mgmt.ensure(spec)
mgmt.wait_until_ready(ref.workload_slug, timeout=1800)
Sur le GPU, le backend démarre le serveur du fork avec les réglages recommandés par la fiche du modèle et de la place pour 65 536 tokens de conversation. Pour qui veut reproduire l'exécution, la commande est :
llama-server -m Ternary-Bonsai-2-27B-PTQ1_0.gguf --mmproj Ternary-Bonsai-2-27B-mmproj-Q8_0.gguf \
  -ngl 99 -fa on -c 65536 --jinja \
  --temp 1.0 --top-p 0.95 --top-k 20 --min-p 0.05
Ensuite, vous lui parlez avec le même format d'adresse de chat que le service d'OpenAI. Nous avons tout fait tourner depuis une copie privée d'InferenceKey sur notre machine de développement, jamais sur le service en production.
Ce que nous avons mesuré
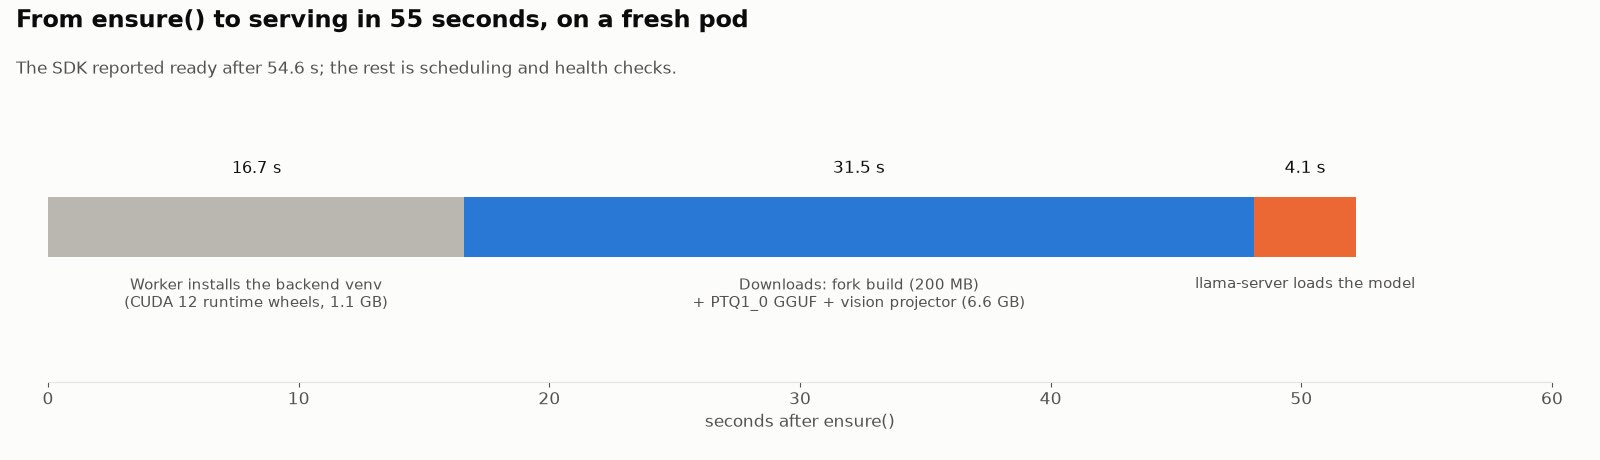
Prêt en 55 secondes. Du moment où le script a demandé le modèle à celui où il a répondu "prêt", sur une machine fraîchement louée où le petit programme agent d'InferenceKey était déjà installé (ce qui avait pris 122 s auparavant) : 16,7 s pour préparer l'environnement Python du backend, 31,5 s pour télécharger 6,6 GB de modèle et les 208 MB du fork, et 4,1 s pour que le serveur le charge.
Environ 12 GB de mémoire. En service, avec une mémoire de travail de 65 536 tokens partagée par jusqu'à quatre utilisateurs et la lecture d'images activée, le GPU n'a jamais utilisé plus d'environ 12 GB sur ses 24, même avec un document de 34 000 tokens et quatre requêtes en parallèle. Le téléchargement est environ neuf fois plus petit que l'original, mais la mémoire utilisée en service fait à peu près le double du fichier, parce que la mémoire de travail de la conversation et la partie image y vivent aussi.
Environ 104 tokens par seconde par utilisateur. Sur 12 vraies requêtes passées par InferenceKey, une à la fois, chaque réponse est sortie entre 101 et 104 tokens par seconde, environ 78 mots par seconde. C'est un peu plus rapide que le chiffre de la fiche du modèle pour ce GPU, 91,1. Nous ne savons pas pourquoi. Le whitepaper donne encore un autre chiffre pour cette carte (96,7), donc les résultats semblent varier selon les machines et les builds.
Les longs documents se lisent vite. Le modèle a lu tout le document de 25 000 mots (34 000 tokens) en environ 12 secondes et a trouvé le code caché. De la question à la réponse, il a fallu 13,5 s.
Quatre utilisateurs à la fois. Quatre questions envoyées en même temps ont toutes fini en 9,6 s, chaque utilisateur recevant 68 à 78 tokens par seconde (environ 159 au total). Il a fallu relever un réglage : par défaut, la plateforme y répondait l'une après l'autre, et la dernière a attendu 22,4 s.
Ce qu'il a répondu
Ce sont nos propres questions, un ou deux essais chacune, donc elles montrent un comportement, pas une qualité de benchmark. Toutes sont revenues justes :
- Une question sur un robot d'entrepôt dont la batterie se vide à chaque mètre : 28 %, juste avec la réflexion moyenne comme avec la réflexion au maximum, la réponse la plus rapide en 3,75 s.
- Une énigme de placement à table : exactement les trois placements valides, avec les deux réglages.
- Une petite tâche de code (fusionner des intervalles qui se chevauchent) : code correct.
- Un résumé en deux phrases en espagnol avec la réflexion désactivée : juste, en 1,9 s.
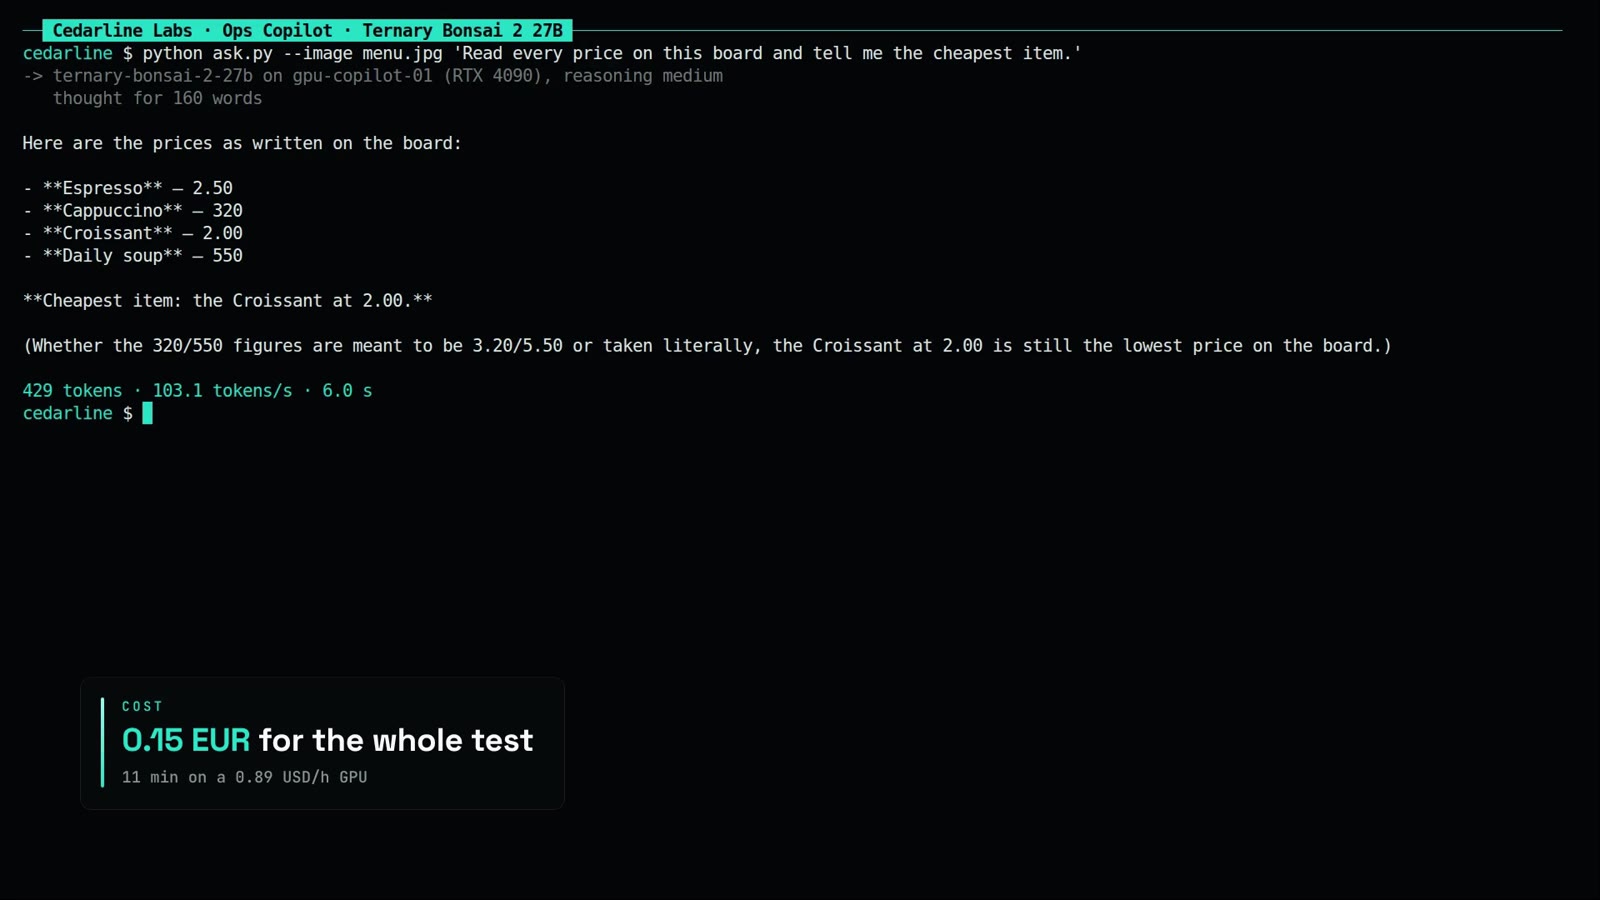
- Une photo de menu : les quatre plats et leurs prix lus exactement.
- Compter des pommes sur une image : sept, juste.
- Le code caché au milieu du document de 34 000 tokens : trouvé.
Sur les 17 requêtes que nous avons chronométrées, aucune n'a bouclé, n'est revenue vide ou n'a été coupée. Une question difficile passe quand même plusieurs secondes à réfléchir d'abord : l'énigme de placement a pris 14,7 s en moyen. Nous n'avons pas testé le modèle en train d'appeler des outils externes (recherche, calculatrice, votre propre API), ce qui tourne parfois mal d'après la page des problèmes connus, ni une très longue réflexion au maximum.
La vidéo de démo
La vidéo montre le modèle qui tourne sur la RTX 4090 dans le tableau de bord d'InferenceKey, puis un terminal qui pose la question du robot (215 tokens à 103,2 tokens par seconde, 3,0 s) et la photo du menu (429 tokens à 103,1 tokens par seconde, 6,0 s).
Ce qui a mal tourné
Le modèle lui-même ne nous a posé aucun problème. L'essentiel de ce qui a cassé venait de nous, dans la plateforme, et cela apparaît parce qu'il s'agissait d'un custom backend et non d'un de nos backends intégrés.
- Pas de streaming pour les custom backends. Demander la réponse mot par mot renvoyait une erreur à l'intérieur d'une réponse par ailleurs normale. Seuls les backends intégrés le prennent en charge aujourd'hui. Le testeur de chat de notre tableau de bord fait toujours du streaming, donc il ne pouvait pas servir pour ce modèle : c'est pour cela que la vidéo utilise un terminal.
- La réponse arrive emballée. La réponse d'un custom backend arrive sous forme de bloc de données brutes dans le message de chat au lieu d'un texte propre, et le compteur d'usage affiche zéro. Notre exemple la nettoie, mais une application de chat standard afficherait le bloc brut.
- Une requête à la fois par défaut. Un modèle lié à une machine commence en acceptant une requête à la fois, le même bug que dans notre test d'AstaBrief-8B. Un appel de réglage le corrige.
- Les réglages n'atteignent pas les custom backends. Les réglages que vous donnez au modèle dans le tableau de bord d'InferenceKey n'arrivent jamais à un custom backend, donc le nôtre les garde dans son propre code.
- Un plafond de cinq minutes. InferenceKey accorde 300 secondes par réponse à un custom backend. À environ 100 tokens par seconde, cela fait à peu près 29 000 tokens de réflexion plus la réponse. Nous n'en avons jamais approché (la réponse la plus longue faisait 1 447 tokens), mais une très longue réflexion au maximum le pourrait.
- Hors de la plateforme : le pool partagé de RTX 4090 de RunPod n'en avait aucune de disponible, donc nous avons utilisé son offre dédiée.
Qui a fait quoi
L'équipe Qwen d'Alibaba a entraîné Qwen3.8-27B et l'a publié sous Apache 2.0. Prism ML en a tiré Ternary Bonsai 2 27B. Ils ont conçu le format, repris l'idée du recâblage dans les travaux SpinQuant de Meta (Liu et al.), écrit dans leur fork de llama.cpp le code qui lit les interrupteurs à la volée, et publié des builds prêts à l'emploi, une démo, un whitepaper et une page détaillée de problèmes connus. La méthode de compression de Mobius Labs a réduit la partie image. Unsloth a fait le build 4 bits de comparaison. Le projet llama.cpp est la base sur laquelle repose le fork. Nous avons repéré la sortie dans une vidéo d'AI Search.
Notre part : le custom backend qui amène le fork de Prism ML dans InferenceKey, l'exemple du SDK, l'exécution de bout en bout sur une RTX 4090, et la mesure de la vitesse, de la mémoire et du temps de démarrage.
Ce qu'il faut retenir
La version 4 bits habituelle de Qwen3.8-27B (17,6 GB) tient aussi sur une carte de 24 GB comme celle-ci, et aux tests de Prism ML elle garde un peu plus de qualité (98,7 % contre 98,2 %). Ce que le fichier de 6 GB vous donne, c'est de la marge : de la place pour un second modèle ou une conversation plus longue sur la même carte, et une chance sur des cartes plus petites. Nous n'avons testé aucune carte de moins de 24 GB, donc ce dernier point reste ouvert. Sur la RTX 4090, il a écrit environ 100 tokens par seconde. Les limites : les chiffres de qualité sont ceux de Prism ML, nos propres vérifications portaient sur environ 20 requêtes avec un ou deux essais par question, le travail de code long et en plusieurs étapes (corriger de vrais bugs) ne garde qu'environ les trois quarts de l'original, et aujourd'hui vous dépendez du fork de Prism ML pour le faire tourner tout court.
Pendant qu'il servait, environ la moitié de cette RTX 4090 restait libre, un peu plus de 12 GB. C'est de la place pour un second modèle, plus petit, sur la même carte, par exemple celui qui fait tourner la recherche dans les documents de votre entreprise. Qu'est-ce que vous mettriez à côté ?
Pour les ingénieurs
Modèle (fiche du modèle, KNOWN_ISSUES, whitepaper, Bonsai-demo, modèle de base). Repo prism-ml/Ternary-Bonsai-2-27B-gguf, sha b072e1d3, créé le 2026-09-16, modifié pour la dernière fois le 2026-09-25, Apache-2.0, non gated. Fichiers (tous préfixés par Ternary-Bonsai-2-27B-) : PTQ1_0.gguf 5 946 648 928 B, PQ2_0.gguf 7 206 168 928 B, F16.gguf 53 808 408 928 B, mmproj-Q8_0.gguf 629 246 976 B, mmproj-BF16.gguf 931 145 856 B. Pas de fichier Q2_0. Les "environ 54 GB" du récit correspondent à la ligne FP16 de la fiche (le whitepaper indique 53,80 GB). 27,36B paramètres : 24,35B pour le backbone de langage (64 blocs), 2,54B pour l'embedding et la tête LM, 0,46B pour la tour de vision (27 blocs). Architecture inchangée par rapport à Qwen3.8-27B (Qwen3_5ForConditionalGeneration) : attention hybride, une couche sur 4 en attention complète (16 complètes, 48 Gated DeltaNet), 24 têtes Q / 4 KV, head_dim 256, SwiGLU, RoPE, RMSNorm, contexte natif de 262 144.
Format. Ternaire g128 : poids dans {-1, 0, +1}, une échelle FP16 pour 128 poids, log2(3) + 16/128 = environ 1,71 bpw sur les tenseurs ternaires, 1,72 pour le modèle entier. Poids stockés dans une base tournée par Hadamard (bloc 1024, vecteur de signes fixe ; le R = (1/sqrt n) H_n S du whitepaper suit SpinQuant, arXiv:2405.16406) intégrée hors ligne ; le runtime applique la transformation correspondante aux activations ou refuse le fichier. Couverture basse précision : embeddings, projections d'attention et de MLP, tête LM. 26,2M paramètres (0,0976 % du LM : chemin de l'état récurrent de l'attention linéaire et normes) restent en précision plus élevée. La rotation est une transformée de Hadamard du type SpinQuant. Projecteur de vision : conteneur Q8_0 de 0,63 GB (whitepaper : HQQ 4 bits) ou BF16 de 0,93 GB. Tableau mémoire de la fiche : FP16 16,0 bpw ~54 GB ; idéal 1,72 bpw 5,8 GB (~9,3x) ; PTQ1_0 trits denses 1,75 bpw 5,95 GB (~9,0x) ; PQ2_0 un trit par emplacement de 2 bits 2,13 bpw 7,21 GB (~7,5x). Le whitepaper donne des chiffres légèrement différents (PTQ1_0 1,76 bpw 5,93 GB, PQ2_0 2,16 bpw 7,25 GB, FP16 53,80 GB). Nous utilisons ceux de la fiche, qui correspondent aux tailles des fichiers sur Hugging Face.
Qualité (fiche). EvalScope + vLLM sur H100, mode thinking, 14 benchmarks : FP16 86,32, UD-Q4_K_XL d'Unsloth (5,2 bpw, 17,6 GB) 85,18, IQ2_XXS (2,16 bpw, 7,27 GB) 72,59, Bonsai 84,78. IQ2_XXS : MMLU-Redux 88,93, AIME26 57,5, LiveCodeBench 56,4. Bonsai AIME26 95,83, LiveCodeBench 90,07. Par catégorie FP16 / Bonsai : connaissances et raisonnement 85,55 / 79,86, maths 97,06 / 96,57, code 89,07 / 89,42, suivi d'instructions 81,25 / 82,66, BFCL v3 76,74 / 74,92, vision (MMMU-Pro, OCR Bench v2) 71,36 / 66,19. Densité de la fiche (D = -log2(1 - score/100) / GB) : Bonsai 2 0,457, précédent Ternary Bonsai 27B 0,416 (80,98 à 5,75 GB), IQ2_XXS 0,257, UD-Q4_K_XL 0,157, FP16 0,053. Whitepaper (20 benchmarks, xhigh) : Bonsai 83,9 contre FP16 85,4 (également 98,2 %), IQ2_XXS 75,2. Terminal-Bench 2.1 52,8 contre 69,7, SWE-bench Verified 60,8 contre 80,6, tau2-Bench 80,2, BFCL v3 74,9, AA-LCR 77,0. Effort medium (Table 11) : 79,3 contre 82,6, AIME25 74,58 contre 86,25, GPQA Diamond 75,56 contre 84,34. Notre backend passe en medium par défaut, attendez-vous donc aux chiffres de la Table 11 sauf si vous envoyez reasoning_effort: "xhigh".
Vitesse (fiche, llama-bench, batch 1, sans tour de vision), tg128 PQ2_0 / PTQ1_0 : RTX 5090 129,9 / 120,5, RTX PRO 6000 Blackwell 124,8 / 117,9, H100 SXM 113,9 / 86,9, RTX 6000 Ada 82,8 / 90,4, RTX 4090 81,2 / 91,1, L40S 74,4 / 81,8, A100 SXM 73,9 / 54,7, L4 29,8 / 32,1. RTX 4090 pp512 : 3 124 / 1 645. PQ2_0 décode plus vite sur Hopper, Ampere data center et Blackwell, et fait le prefill plus vite partout ; PTQ1_0 déplace 17 % de données de poids en moins et gagne au décodage sur Ada et L4. La Table 5 du whitepaper (build du 2026-09-16) diffère, par exemple RTX 5090 142,5 / 134,4, RTX 4090 90,9 / 96,7. KNOWN_ISSUES : les binaires Linux précompilés décodent de façon erratique sur RTX 5090 (#199, compiler avec -DCMAKE_CUDA_ARCHITECTURES=120a-real).
Runtime. Version du fork prism-b10777-e3de715 (commit e3de7152), publiée le 2026-10-14T15:26:33Z. Tarballs Linux CUDA : 12.4 326 799 565 B, 12.8 208 198 074 B, 13.3 183 998 027 B, plus des builds macOS, iOS, Android, CPU, Vulkan, ROCm 7.2, SYCL et Windows. Le setup.sh de Bonsai-demo la fixe (commit #262, 2026-10-15). Fiche : le llama.cpp standard rejette PQ2_0 et PTQ1_0 et charge Q2_0 sans avertissement, en produisant n'importe quoi (pas de runtime d'activation Hadamard). README de Bonsai-demo : le Q2_0 officiel fonctionne avec le llama.cpp upstream actuel qui prend en charge Bonsai 2 ; PQ2_0 et PTQ1_0 ont toujours besoin du fork. MODEL-FORMATS.md : d'anciens builds pouvaient charger Q2_0 sans les transformations et produire du charabia. Ollama et LM Studio (GGUF) ne peuvent pas non plus charger PQ2_0/PTQ1_0. KNOWN_ISSUES (vérifié pour la dernière fois le 2026-09-23, avant b10777, donc certains points peuvent être périmés) : CUDA 13.3 fait un segfault sur certains systèmes Linux (#222, utiliser 12.8 sous Linux, 12.4 sous Windows) ; reasoning_effort: "high" renvoie HTTP 500 (le template accepte low, medium, xhigh ; low se comporte presque comme xhigh) ; 500 quand le message system n'est pas le premier ou qu'il y en a deux ; budget de réflexion dans chat_template_kwargs ignoré ; appels d'outils malformés ou en boucle ; boucles sur certains prompts en xhigh ; le GGUF F16 se charge dans le llama.cpp standard mais la sortie est brouillée ; les PQ2_0/PTQ1_0 quantifiés soi-même n'ont pas les métadonnées prism.hadamard.* et génèrent n'importe quoi. Le quickstart de la fiche utilise llama-cli -c 32768 -n 16384 ; KNOWN_ISSUES suggère -c 65536. Échantillonnage, mode thinking : temperature 1,0, top_p 0,95, top_k 20, min_p 0,05. Bonsai-demo : KV cache FP16 64 KiB/token, BONSAI_KV4=1 environ 18 KiB/token.
Notre installation. RunPod RTX 4090 24 GB, SECURE (COMMUNITY 4090 et L4 ont répondu 409), driver 570.158.01 (CUDA 12.8), limite de 450 W. Worker installé par un manager InferenceKey local via des tunnels HTTP et TCP (ssh.direct après 27,4 s, binaire du worker de 25 243 632 B par SFTP en 62 s, terminé 122 s après le POST du pod). Production jamais touchée. Custom backend Python ternary-bonsai-2-27b 0.1.0 (paquet de 5 957 B) : télécharge le tarball linux-cuda-12.8 du fork, le GGUF PTQ1_0 et le mmproj Q8_0, ajoute nvidia-cuda-runtime-cu12==12.8.* et nvidia-cublas-cu12==12.8.* (le tarball se lie à libcudart.so.12 et libcublas.so.12 sans les fournir) au LD_LIBRARY_PATH, lance llama-server comme ci-dessus sur un port loopback. Met reasoning_effort à medium par défaut, transforme high en xhigh, fusionne les messages system en un seul message en tête, max_tokens 16 384. Exemple du SDK au commit 7a1d7883 sur le main d'inferencekey-sdk.
Temps avant d'être prêt. De ensure() à l'état prêt 54,6 s sur un pod dont le worker était déjà installé : venv + requirements 16,7 s (1,1 GB), téléchargements 31,5 s (environ 210 MB/s), chargement du serveur 4,1 s, setup_s 35,6. PQ2_0 (7,21 GB) téléchargé à part en 24 s.
Mémoire et puissance. En service : llama-server 11 662 MiB ; pic GPU total 11 672 MiB (11,4 GiB, environ 12,2 GB) sur 24 564 avec -c 65536, n_slots = 4, n_ctx_slot = 65536, kv_unified = true, mmproj chargé, prompt de 33 840 tokens et quatre requêtes parallèles compris ; 12 892 MiB libres. Avec kv_unified, le pool KV de 65 536 tokens est partagé par les 4 slots, pas 65K chacun. Le total GPU n'est monté à 19 403 MiB que pendant que llama-bench tournait à côté du serveur. Pic de puissance 445,1 W pendant llama-bench.
llama-bench (build e3de71522 (10777), -ngl 99 -fa 1 -p 512 -n 128 -r 3) : PTQ1_0 (5,53 GiB, 26,90 B) pp512 3 279 +- 427, tg128 105,78 +- 0,56 ; PQ2_0 (6,70 GiB) pp512 3 230 +- 433, tg128 94,50 +- 0,41. Les deux au-dessus de la ligne RTX 4090 de la fiche (91,1 et 81,2). PTQ1_0 a été le plus rapide au décodage sur ce GPU Ada, comme le dit la fiche.
Par requête (/v1/chat/completions sans streaming, prompt system "You are a helpful assistant", max_tokens 16 384, temps mesurés par llama-server) :
| Cas | Effort | Tok prompt | Tok sortie | Génération tok/s | Prompt tok/s | Aller-retour s |
|---|---|---|---|---|---|---|
| batterie du robot | medium | 77 | 371 | 103,9 | 186 | 5,31 |
| batterie du robot | xhigh | 115 | 250 | 103,4 | 413 | 3,75 |
| énigme de placement | medium | 74 | 1 447 | 104,2 | 255 | 14,73 |
| énigme de placement | xhigh | 74 | 670 | 103,7 | 256 | 7,62 |
| merge_intervals | medium | 52 | 756 | 104,2 | 274 | 8,42 |
| résumé en espagnol | aucun | 40 | 73 | 101,4 | 139 | 1,87 |
| OCR du menu | medium | 617 | 230 | 103,2 | 1 189 | 4,34 |
| compter les pommes | medium | 346 | 219 | 103,1 | 832 | 3,79 |
| décrire un ramen | aucun | 607 | 64 | 101,2 | 1 023 | 3,34 |
| aiguille, 33 840 tok | aucun | 33 840 | 11 | 68,0 | 2 843 | 13,53 |
Génération médiane 103,6 tok/s sur 12 requêtes séquentielles (101,2 à 104,4). Surcoût de la plateforme sur les réponses courtes de 0,3 à 0,6 s (aller-retour moins le total du backend, manager local via un tunnel). finish_reason: stop dans les 17 requêtes du banc. Un échantillon chacun à temperature 1,0 : l'énigme de placement a utilisé 1 447 tokens en medium et 670 en xhigh, et la question du robot 371 et 250. Deux échantillons ne permettent pas de dire si medium est en général plus long ou plus court.
Concurrence. Quatre requêtes parallèles avec le max_in_flight par défaut de l'assignation, 1 : 22,4 s au total (allers-retours de 6,7, 10,6, 13,9 et 22,4 s). Après PATCH /api/projects/<pid>/assignments/<workload>/<worker> {"max_in_flight": 8} : 9,6 s au total, de 68,4 à 78,1 tok/s chacune, 1 524 tokens, environ 159 tok/s cumulés.
Problèmes de la plateforme. (1) stream: true avec un custom backend renvoie HTTP 200 avec data: {"error":{"code":"unknown_backend",...}} puis [DONE] : run_streaming_inference dans crates/worker/src/jobs.rs ne gère que les backends intégrés Ollama et compatibles OpenAI. (2) custom_backend_process renvoie output.to_string() et chat_choice_from_out le met dans message.content sous forme de chaîne JSON, usage entièrement à zéro. (3) ensure() avec un worker_id crée l'assignation avec max_in_flight à 1. (4) Le worker lance python -m inferencekey.backend.serve sans --config-json, donc ctx.config est vide. (5) Timeout client de /process du worker de 300 s pour les custom backends. (6) Le backend llamacpp intégré récupère le llama.cpp de ggml-org (asset_download_url codé en dur, tag par défaut b9748). (7) Le SFTP du binaire du worker de 25 MB a pris 62 s. (8) Détails cosmétiques du panneau : colonne Access "No access" avec une clé wildcard qui fonctionne, "GPU telemetry partial".
Nettoyage. Workload et pod supprimés (RunPod 404 ensuite), tunnels, NATS, base de données et objets MinIO supprimés.
Limites. Environ 20 requêtes à nous, un ou deux échantillons par question, temperature 1,0, la plupart en effort medium. Tous les benchmarks de qualité sont ceux de Prism ML. Pas d'appels d'outils, pas de très long raisonnement xhigh, pas de chiffres de service PQ2_0 via InferenceKey (llama-bench uniquement), pas de test du llama.cpp standard, un seul modèle de GPU.
Sources : fiche du modèle, KNOWN_ISSUES, whitepaper, Bonsai-demo, version du fork prism-b10777, Qwen3.8-27B, SpinQuant, exemple du SDK, vidéo de démo, vidéo d'AI Search.