Ternary Bonsai 2 27B: un modelo de razonamiento de 27B en 6 GB que conserva el 98 % en las pruebas de Prism ML
Prism ML ha metido Qwen3.8-27B en un fichero de 5,95 GB con pesos de tres valores. En una RTX 4090 escribió unos 104 tokens/s usando unos 12 GB de la tarjeta.
Qwen3.8-27B, el modelo abierto de razonamiento y visión del equipo Qwen de Alibaba, ocupa unos 54 GB en su forma original, con todo el detalle, según la model card de Prism ML. La versión que ejecutamos en una sola tarjeta gráfica de juegos es un fichero de 5,95 GB. Le pedimos que leyera una carta de restaurante a partir de una foto, que resolviera un acertijo de sitios en la mesa con tres respuestas válidas y que encontrara un código escondido en un documento de unas 25.000 palabras. Cada pregunta se hizo una o dos veces, y acertó todas las respuestas.
Según las pruebas de Prism ML, Ternary Bonsai 2 27B conserva el 98,2 % de la calidad del original. Una reducción convencional a casi el mismo tamaño conserva el 84,1 %. Prism ML lo publicó en septiembre con licencia Apache 2.0 (se puede usar gratis con fines comerciales). Es el segundo intento de Prism ML con este formato de tres valores en un modelo de 27B parámetros, y puntúa más alto que el primero. Para ejecutarlo necesitas la versión modificada por Prism ML de las herramientas gratuitas habituales, porque las estándar no saben leer el fichero. Esto es lo que te llevas:
| Qué | Resultado |
|---|---|
| Modelo | Ternary Bonsai 2 27B de Prism ML: Qwen3.8-27B (27B parámetros, lee texto e imágenes) guardado de forma que casi cada número interno es solo -1, 0 o +1 |
| Tamaño del fichero | 5,95 GB (la versión más pequeña) o 7,21 GB, frente a unos 54 GB del original |
| Calidad, según la model card de Prism ML | 84,78 frente a 86,32 del original en 14 pruebas de razonamiento (98,2 %). La forma convencional de reducirlo a un tamaño parecido: 72,59 |
| GPU que usamos | una NVIDIA RTX 4090, una tarjeta de juegos de 24 GB, alquilada en RunPod |
| Memoria usada mientras sirve | unos 12 GB de los 24 de la tarjeta, con una memoria de trabajo de 65.536 tokens compartida por hasta 4 usuarios a la vez |
| Velocidad para un usuario | unos 104 tokens por segundo (un token equivale más o menos a tres cuartos de una palabra) |
| Cuatro usuarios a la vez | unos 159 tokens por segundo en total, después de subir un ajuste |
| Desde pedir el modelo hasta que está listo (con la máquina de GPU ya preparada) | 55 segundos, casi todo descargas |
| La pega | necesita la versión modificada de llama.cpp de Prism ML para funcionar |
Una mesa de mezclas con interruptores en vez de faders
Un modelo de lenguaje es, físicamente, una lista larguísima de números llamados pesos. En el Qwen3.8-27B original cada uno se guarda con 16 bits, como una mesa de mezclas en la que cada uno de 27.000 millones de faders puede estar en cualquiera de 65.536 posiciones.
Prism ML cambió casi todos los faders por un interruptor de tres posiciones: abajo, apagado, arriba (-1, 0, +1). Después, por cada grupo de 128 interruptores, conservó un fader normal que fija el volumen de todo el grupo. Cada interruptor, más su parte del fader del grupo, cuesta menos de 2 bits, frente a 16 en el original, y por eso el fichero es unas nueve veces más pequeño. Prism ML distribuye dos versiones del fichero, de 5,95 GB y 7,21 GB. La grande es más rápida en algunas tarjetas gráficas.
Antes de convertir los faders en interruptores, Prism ML también recableó la mesa siguiendo un patrón fijo. Todo lo que suene a través de ella tiene que pasar por el mismo recableado, o el sonido sale revuelto. Para leer imágenes hace falta un fichero aparte, opcional, de 0,63 GB.
Las preguntas fáciles esconden el daño
En una competición de matemáticas difícil Bonsai saca 95,83 y en una prueba de programación 90,07, según la model card. La forma habitual de reducir el modelo a más o menos el mismo tamaño (7,27 GB) cae a 57,5 y 56,4 en esas mismas pruebas, aunque saca 88,93 en un test fácil de cultura general, cerca del original. La model card lo resume así: "why casual testing misses the collapse" (por qué las pruebas informales no ven el hundimiento).
Así que cuando alguien te diga que un modelo pequeño "funciona bien", la pregunta útil es: ¿en qué? Esta es la media de las 14 pruebas de la model card de Prism ML, todas con el modelo autorizado a pensar antes de responder:
| Versión | Tamaño | Media | Parte del original |
|---|---|---|---|
| Qwen3.8-27B, original | unos 54 GB | 86,32 | 100 % |
| Versión estándar de 4 bits (de Unsloth, un equipo que publica modelos reducidos) | 17,6 GB | 85,18 | 98,7 % |
| Versión estándar de 2 bits | 7,27 GB | 72,59 | 84,1 % |
| Ternary Bonsai 2 27B | 5,95 GB | 84,78 | 98,2 % |
Las matemáticas y la programación salen casi intactas. Las pérdidas están en cultura general y razonamiento (79,86 frente a 85,55) y en la lectura de imágenes (66,19 frente a 71,36).
Dos notas al margen del whitepaper de Prism ML. En trabajo de programación largo y de varios pasos, arreglar bugs reales en código real, conserva solo unas tres cuartas partes del original (60,8 frente a 80,6). Y en el whitepaper, el 98,2 % se mide con el máximo de pensamiento (un ajuste llamado xhigh). Con pensamiento medio Bonsai saca 79,3, frente a 83,9 con el máximo, y el original saca 82,6 con pensamiento medio.
El llama.cpp estándar no sabe leer el fichero
llama.cpp es el programa de código abierto que ejecuta ficheros de modelo como este en tu propia máquina. La model card lo dice claramente: "Stock llama.cpp will not run these files" (el llama.cpp estándar no ejecuta estos ficheros). Rechaza los dos formatos de Bonsai por desconocidos. La página de problemas conocidos añade que las aplicaciones de escritorio populares para ejecutar modelos tampoco los cargan. Versiones antiguas del programa estándar llegaban incluso a abrir un fichero Bonsai relacionado y a responder con sinsentidos, porque se saltan el recableado que hemos descrito arriba. Nosotros no probamos el programa estándar.
La solución es la copia modificada de llama.cpp de Prism ML (un fork), con builds listas para Linux, Windows, macOS y más. La última salió el 14 de octubre. En Linux, la página de problemas conocidos de Prism ML dice que elijas la descarga compilada para la versión antigua del toolkit de NVIDIA (12.8), porque la más nueva se cuelga en algunas máquinas. Esa página es de septiembre, anterior a la release de octubre, así que no sabemos si el cuelgue sigue pasando. Usamos la 12.8 y no se colgó.
El modelo además piensa mucho antes de responder, y ese pensamiento cuenta para el límite de longitud que pongas. Si pides como mucho 256 tokens puedes recibir una respuesta vacía, porque el modelo los gastó todos pensando. La card recomienda un límite de 16.384 tokens.
Lo rápido que debería ir
En la RTX 4090, la card dice que el fichero pequeño escribe unos 91 tokens por segundo para un usuario, unas 68 palabras por segundo. Cuál de los dos ficheros es más rápido depende de la tarjeta gráfica, y la sección Para ingenieros las enumera.
La diferencia más grande es el tamaño: la versión habitual de 4 bits del original, de Unsloth, ocupa 17,6 GB, el triple que el fichero Bonsai de 5,95 GB. No hemos medido la velocidad del modelo original con el mismo software en la misma tarjeta.
Cómo lo ejecutamos en InferenceKey
La GPU y el software
Lo ejecutamos en una RTX 4090 de 24 GB, alquilada en RunPod.
InferenceKey arranca los modelos a través de unos pequeños adaptadores que llamamos backends. El integrado para llama.cpp instala la versión oficial, que no sabe leer este fichero, así que escribimos el nuestro: un paquete de custom backend de unos 6 KB que InferenceKey ejecuta en la máquina de GPU. Descarga el fork de Prism ML, el modelo de 5,95 GB y el fichero para leer imágenes, y arranca el servidor del fork. Por el camino hubo una sorpresa: la descarga del fork da por hecho que dos librerías de NVIDIA ya están en la máquina y no las incluye, así que el backend las instala desde los paquetes de Python de NVIDIA.
El backend también se ocupa de las manías del modelo. Pide pensamiento medio por defecto, da a cada respuesta margen para 16.384 tokens para que el pensamiento no se coma la respuesta, y cambia el ajuste de pensamiento "high", que según la página de problemas conocidos devuelve un error, por el máximo de pensamiento. La card dice que el medio está pensado para respuestas más cortas. En nuestras dos muestras no dio respuestas más cortas que con el máximo, y en las pruebas de Prism ML puntúa más bajo (79,3 frente a 83,9).
Los pasos
Nuestro ejemplo del SDK lo hace con dos scripts. publish.py sube el custom backend a tu cuenta una sola vez. main.py le dice a InferenceKey que ejecute el modelo en tu máquina de GPU, espera a que esté listo, hace una pregunta (y, si quieres, otra sobre una imagen), guarda la respuesta y apaga el modelo. Lo esencial:
spec = WorkloadSpec(
    name="Ternary Bonsai 2 27B",
    slug="ternary-bonsai-2-27b",
    model="prism-ml/Ternary-Bonsai-2-27B-gguf",
    backend="ternary-bonsai-2-27b",  # the custom backend from publish.py
    task_type="text2text",
    worker_id=os.environ["IK_WORKER_ID"],
    execution_policy=ExecutionPolicy.FIXED,
    execution_policy_config={"replicas": 1},
)
ref = mgmt.ensure(spec)
mgmt.wait_until_ready(ref.workload_slug, timeout=1800)
En la GPU, el backend arranca el servidor del fork con los ajustes que recomienda la model card y margen para 65.536 tokens de conversación. Para quien quiera reproducir la prueba, el comando es:
llama-server -m Ternary-Bonsai-2-27B-PTQ1_0.gguf --mmproj Ternary-Bonsai-2-27B-mmproj-Q8_0.gguf \
  -ngl 99 -fa on -c 65536 --jinja \
  --temp 1.0 --top-p 0.95 --top-k 20 --min-p 0.05
Después hablas con él con el mismo formato de dirección de chat que el servicio de OpenAI. Lo ejecutamos todo desde una copia privada de InferenceKey en nuestra máquina de desarrollo, nunca en el servicio en producción.
Lo que medimos
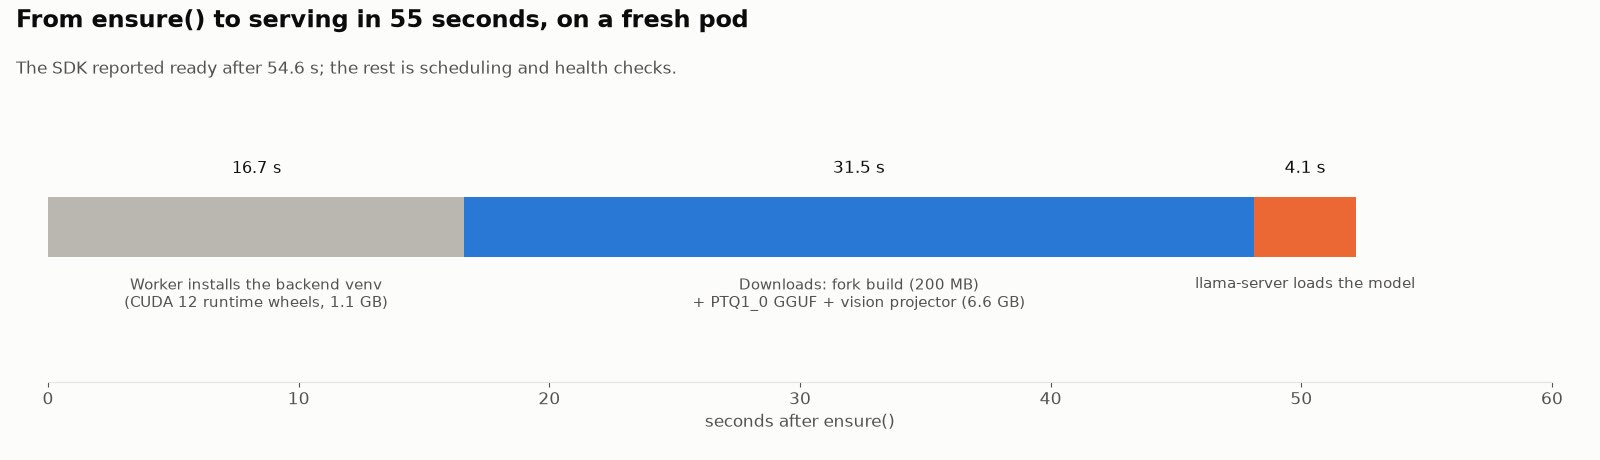
Listo en 55 segundos. Desde que el script pidió el modelo hasta que respondió "ready", en una máquina recién alquilada donde el pequeño programa agente de InferenceKey ya estaba instalado (eso llevó antes 122 s): 16,7 s para preparar el entorno de Python del backend, 31,5 s para descargar 6,6 GB de modelo y el fork de 208 MB, y 4,1 s para que el servidor lo cargara.
Unos 12 GB de memoria. Mientras servía, con una memoria de trabajo de 65.536 tokens compartida por hasta cuatro usuarios y la lectura de imágenes activada, la GPU nunca usó más de unos 12 GB de sus 24, ni siquiera con un documento de 34.000 tokens y cuatro peticiones a la vez. La descarga es unas nueve veces más pequeña que el original, pero la memoria usada mientras sirve es más o menos el doble del fichero, porque ahí viven también la memoria de trabajo de la conversación y la parte de imágenes.
Unos 104 tokens por segundo por usuario. En 12 peticiones reales a través de InferenceKey, una detrás de otra, todas las respuestas salieron a entre 101 y 104 tokens por segundo, unas 78 palabras por segundo. Es algo más rápido que la cifra de la model card para esta GPU, 91,1. No sabemos por qué. El whitepaper da otra cifra distinta para esta tarjeta (96,7), así que los resultados parecen variar entre máquinas y builds.
Los documentos largos se leen rápido. El modelo leyó el documento entero de 25.000 palabras (34.000 tokens) en unos 12 segundos y encontró el código escondido. De la pregunta a la respuesta pasaron 13,5 s.
Cuatro usuarios a la vez. Cuatro preguntas enviadas a la vez terminaron todas en 9,6 s, y cada usuario recibió de 68 a 78 tokens por segundo (unos 159 en total). Para eso hubo que subir un ajuste: por defecto la plataforma las respondía una detrás de otra, y la última esperó 22,4 s.
Lo que respondió
Son preguntas nuestras, con uno o dos intentos cada una, así que muestran cómo se comporta, no su calidad en un benchmark. Todas volvieron bien:
- Una pregunta sobre un robot de almacén con una batería que se gasta por metro: 28 %, correcto tanto con pensamiento medio como con el máximo, y la respuesta más rápida en 3,75 s.
- Un acertijo de sitios en la mesa: exactamente las tres colocaciones válidas, con los dos ajustes.
- Una tarea pequeña de programación (fusionar intervalos que se solapan): código correcto.
- Un resumen de dos frases en español con el pensamiento desactivado: correcto, en 1,9 s.
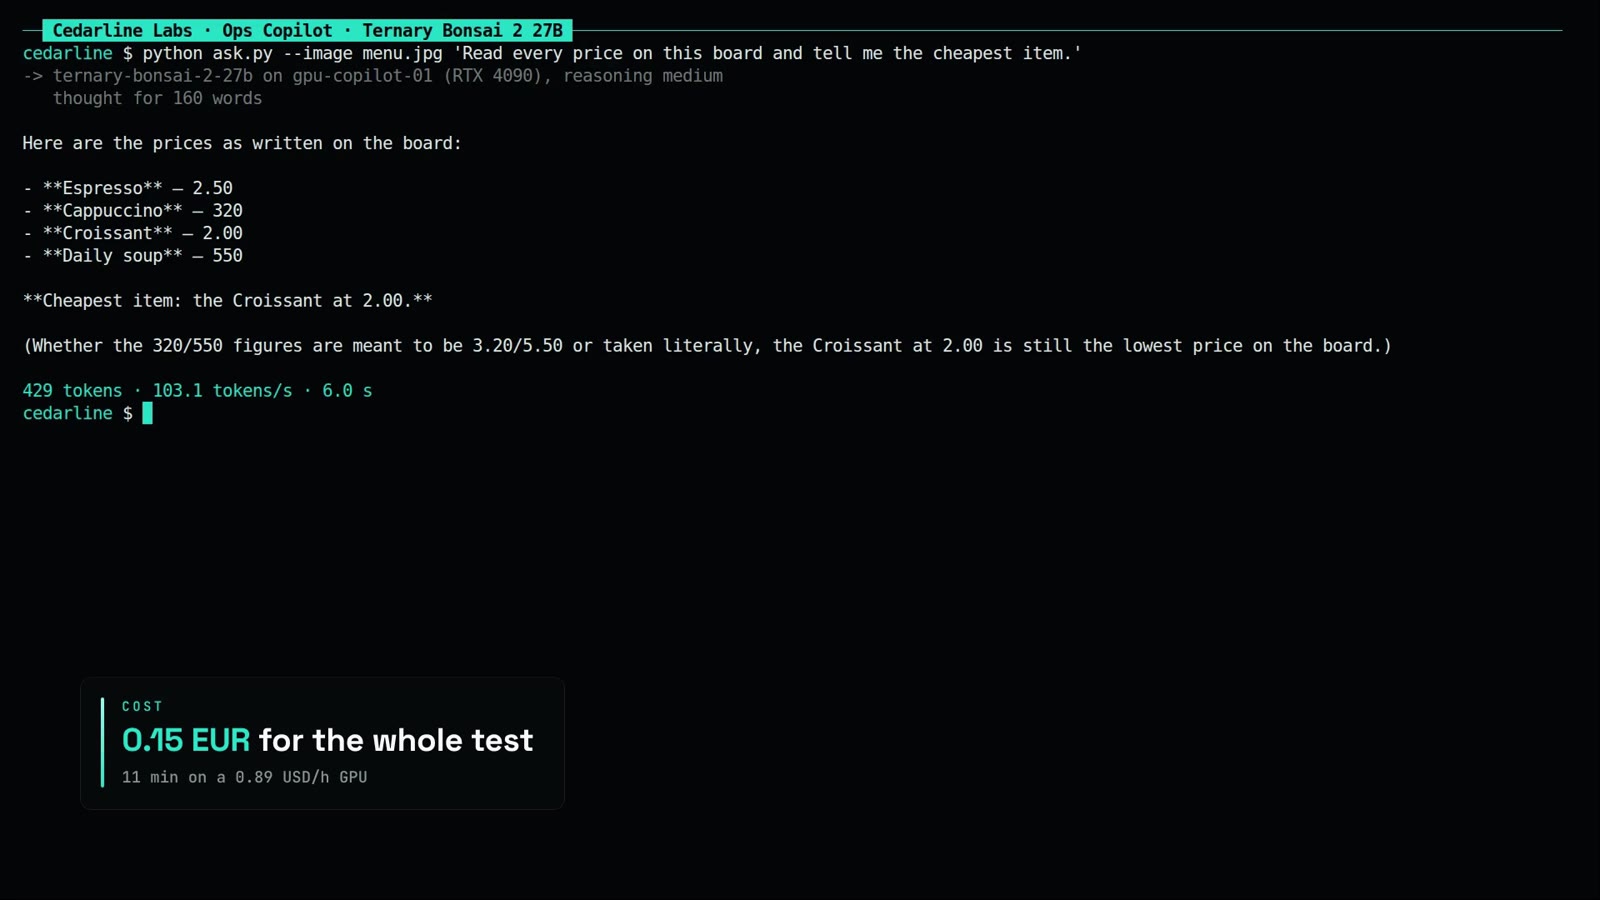
- Una foto de una carta de restaurante: los cuatro platos y sus precios leídos exactamente.
- Contar manzanas en una imagen: siete, correcto.
- El código escondido en mitad del documento de 34.000 tokens: encontrado.
De las 17 peticiones que cronometramos, ninguna entró en bucle, volvió vacía o se cortó. Una pregunta difícil sigue gastando varios segundos en pensar primero: el acertijo de la mesa tardó 14,7 s con pensamiento medio. No probamos que el modelo llame a herramientas externas (búsqueda, una calculadora, tu propia API), algo que según la página de problemas conocidos a veces sale mal, ni pensamientos máximos muy largos.
El vídeo de la demo
El vídeo muestra el modelo funcionando en la RTX 4090 en el panel de InferenceKey, y después un terminal que hace la pregunta del robot (215 tokens a 103,2 tokens por segundo, 3,0 s) y la de la foto de la carta (429 tokens a 103,1 tokens por segundo, 6,0 s).
Lo que salió mal
El modelo en sí no nos dio problemas. Casi todo lo que falló era nuestro, de la plataforma, y aparece porque esto era un custom backend y no uno de los integrados.
- Sin streaming para los custom backends. Pedir la respuesta palabra a palabra devolvía un error dentro de una respuesta por lo demás normal. Hoy solo lo admiten los backends integrados. El tester de chat de nuestro panel siempre usa streaming, así que no servía para este modelo, y por eso el vídeo usa un terminal.
- La respuesta llega envuelta. La respuesta de un custom backend llega como un bloque de datos en bruto dentro del mensaje de chat en lugar de como texto limpio, y el contador de uso marca cero. Nuestro ejemplo lo limpia, pero una aplicación de chat estándar mostraría el bloque en bruto.
- Una petición a la vez por defecto. Un modelo atado a una máquina empieza atendiendo una petición a la vez, el mismo bug que encontramos en nuestra prueba de AstaBrief-8B. Se arregla con una llamada de configuración.
- Los ajustes no llegan a los custom backends. Los ajustes que le das al modelo en el panel de InferenceKey nunca llegan a un custom backend, así que el nuestro los guarda en su propio código.
- Un techo de cinco minutos. InferenceKey da a un custom backend 300 segundos por respuesta. A unos 100 tokens por segundo eso son unos 29.000 tokens entre pensamiento y respuesta. Nunca nos acercamos (la respuesta más larga fue de 1.447 tokens), pero un pensamiento máximo muy largo podría llegar.
- Fuera de la plataforma: el pool compartido de RTX 4090 de RunPod no tenía ninguna disponible, así que usamos su nivel dedicado.
Quién hizo qué
El equipo Qwen de Alibaba entrenó Qwen3.8-27B y lo publicó con licencia Apache 2.0. Prism ML construyó a partir de él Ternary Bonsai 2 27B. Diseñaron el formato, tomaron la idea del recableado de la investigación SpinQuant de Meta (Liu et al.), escribieron en su fork de llama.cpp el código que lee los interruptores sobre la marcha y publicaron builds listas, una demo, un whitepaper y una página detallada de problemas conocidos. El método de compresión de Mobius Labs redujo la parte de imágenes. Unsloth hizo la build de 4 bits de la comparación. El proyecto llama.cpp es la base sobre la que se construye el fork. Vimos la publicación en un vídeo de AI Search.
Nuestra parte fue el custom backend que lleva el fork de Prism ML a InferenceKey, el ejemplo del SDK, ejecutarlo de principio a fin en una RTX 4090 y medir la velocidad, la memoria y el tiempo de arranque.
Qué sacar en claro
La versión habitual de 4 bits de Qwen3.8-27B (17,6 GB) también entra en una tarjeta de 24 GB como esta, y en las pruebas de Prism ML conserva algo más de calidad (98,7 % frente a 98,2 %). Lo que te da el fichero de 6 GB es margen: sitio para un segundo modelo o una conversación más larga en la misma tarjeta, y una posibilidad en tarjetas más pequeñas. No probamos ninguna tarjeta de menos de 24 GB, así que eso último queda abierto. En la RTX 4090 escribió unos 100 tokens por segundo. Los límites: las cifras de calidad son de Prism ML, nuestras propias comprobaciones fueron unas 20 peticiones con uno o dos intentos por pregunta, el trabajo de programación largo y de varios pasos (arreglar bugs reales) conserva solo unas tres cuartas partes del original, y hoy dependes del fork de Prism ML para poder ejecutarlo.
Mientras servía, más o menos la mitad de esa RTX 4090 estaba libre, algo más de 12 GB. Eso es sitio para un segundo modelo, más pequeño, en la misma tarjeta, por ejemplo el que hace funcionar la búsqueda sobre los documentos de tu empresa. ¿Qué pondrías a su lado?
Para ingenieros
Modelo (model card, KNOWN_ISSUES, whitepaper, Bonsai-demo, modelo base). Repo prism-ml/Ternary-Bonsai-2-27B-gguf, sha b072e1d3, creado el 2026-09-16, modificado por última vez el 2026-09-25, Apache-2.0, sin acceso restringido. Ficheros (todos con el prefijo Ternary-Bonsai-2-27B-): PTQ1_0.gguf 5.946.648.928 B, PQ2_0.gguf 7.206.168.928 B, F16.gguf 53.808.408.928 B, mmproj-Q8_0.gguf 629.246.976 B, mmproj-BF16.gguf 931.145.856 B. No hay fichero Q2_0. Los "unos 54 GB" del texto son la fila FP16 de la card (el whitepaper dice 53,80 GB). 27,36B parámetros: 24,35B del backbone de lenguaje (64 bloques), 2,54B de embedding/LM head, 0,46B de la vision tower (27 bloques). Arquitectura sin cambios respecto a Qwen3.8-27B (Qwen3_5ForConditionalGeneration): atención híbrida, una de cada 4 capas con atención completa (16 completas, 48 Gated DeltaNet), 24 cabezas Q / 4 KV, head_dim 256, SwiGLU, RoPE, RMSNorm, 262.144 de contexto nativo.
Formato. Ternary g128: pesos en {-1, 0, +1}, una escala FP16 por cada 128 pesos, log2(3) + 16/128 = unos 1,71 bpw en los tensores ternarios, 1,72 para el modelo entero. Pesos guardados en una base rotada con Hadamard (bloque 1024, vector de signos fijo; la R = (1/sqrt n) H_n S del whitepaper sigue a SpinQuant, arXiv:2405.16406) integrada offline; el runtime aplica la transformación correspondiente a las activaciones o rechaza el fichero. Cobertura de bajo número de bits: embeddings, proyecciones de atención y MLP, LM head. 26,2M parámetros (el 0,0976 % del LM: el camino del estado recurrente de la atención lineal y las normas) se quedan en precisión más alta. La rotación es una transformada de Hadamard del tipo de SpinQuant. Proyector de visión: contenedor Q8_0 de 0,63 GB (whitepaper: HQQ de 4 bits) o BF16 de 0,93 GB. Tabla de memoria de la card: FP16 16,0 bpw ~54 GB; ideal 1,72 bpw 5,8 GB (~9,3x); PTQ1_0 trits densos 1,75 bpw 5,95 GB (~9,0x); PQ2_0 un trit por hueco de 2 bits 2,13 bpw 7,21 GB (~7,5x). El whitepaper da cifras algo distintas (PTQ1_0 1,76 bpw 5,93 GB, PQ2_0 2,16 bpw 7,25 GB, FP16 53,80 GB). Usamos las de la card, que coinciden con los tamaños de los ficheros en Hugging Face.
Calidad (card). EvalScope + vLLM en H100, modo thinking, 14 benchmarks: FP16 86,32, UD-Q4_K_XL de Unsloth (5,2 bpw, 17,6 GB) 85,18, IQ2_XXS (2,16 bpw, 7,27 GB) 72,59, Bonsai 84,78. IQ2_XXS: MMLU-Redux 88,93, AIME26 57,5, LiveCodeBench 56,4. Bonsai AIME26 95,83, LiveCodeBench 90,07. Por categoría FP16 / Bonsai: conocimiento y razonamiento 85,55 / 79,86, matemáticas 97,06 / 96,57, programación 89,07 / 89,42, seguimiento de instrucciones 81,25 / 82,66, BFCL v3 76,74 / 74,92, visión (MMMU-Pro, OCR Bench v2) 71,36 / 66,19. Densidad de la card (D = -log2(1 - score/100) / GB): Bonsai 2 0,457, el Ternary Bonsai 27B anterior 0,416 (80,98 con 5,75 GB), IQ2_XXS 0,257, UD-Q4_K_XL 0,157, FP16 0,053. Whitepaper (20 benchmarks, xhigh): Bonsai 83,9 frente a FP16 85,4 (también 98,2 %), IQ2_XXS 75,2. Terminal-Bench 2.1 52,8 frente a 69,7, SWE-bench Verified 60,8 frente a 80,6, tau2-Bench 80,2, BFCL v3 74,9, AA-LCR 77,0. Esfuerzo medio (Tabla 11): 79,3 frente a 82,6, AIME25 74,58 frente a 86,25, GPQA Diamond 75,56 frente a 84,34. Nuestro backend usa medium por defecto, así que espera las cifras de la Tabla 11 salvo que envíes reasoning_effort: "xhigh".
Velocidad (card, llama-bench, batch 1, sin vision tower), tg128 PQ2_0 / PTQ1_0: RTX 5090 129,9 / 120,5, RTX PRO 6000 Blackwell 124,8 / 117,9, H100 SXM 113,9 / 86,9, RTX 6000 Ada 82,8 / 90,4, RTX 4090 81,2 / 91,1, L40S 74,4 / 81,8, A100 SXM 73,9 / 54,7, L4 29,8 / 32,1. RTX 4090 pp512: 3.124 / 1.645. PQ2_0 es más rápido en decode en Hopper, Ampere de centro de datos y Blackwell, y más rápido en prefill en todas; PTQ1_0 mueve un 17 % menos de datos de pesos y gana en decode en Ada y L4. La Tabla 5 del whitepaper (build del 2026-09-16) es distinta, por ejemplo RTX 5090 142,5 / 134,4, RTX 4090 90,9 / 96,7. KNOWN_ISSUES: los binarios precompilados para Linux hacen decode de forma errática en la RTX 5090 (#199, compilar con -DCMAKE_CUDA_ARCHITECTURES=120a-real).
Runtime. Release del fork prism-b10777-e3de715 (commit e3de7152), publicada el 2026-10-14T15:26:33Z. Tarballs de Linux con CUDA: 12.4 326.799.565 B, 12.8 208.198.074 B, 13.3 183.998.027 B, más builds para macOS, iOS, Android, CPU, Vulkan, ROCm 7.2, SYCL y Windows. El setup.sh de Bonsai-demo la fija (commit #262, 2026-10-15). Card: el llama.cpp estándar rechaza PQ2_0 y PTQ1_0 y carga Q2_0 sin avisar, produciendo basura (sin runtime de activaciones Hadamard). README de Bonsai-demo: el Q2_0 oficial funciona con el llama.cpp upstream actual que tiene soporte para Bonsai 2; PQ2_0 y PTQ1_0 siguen necesitando el fork. MODEL-FORMATS.md: builds antiguas podían cargar Q2_0 sin las transformaciones y producir galimatías. Ollama y LM Studio (GGUF) tampoco cargan PQ2_0/PTQ1_0. KNOWN_ISSUES (revisada por última vez el 2026-09-23, antes de b10777, así que algunos puntos pueden estar desfasados): CUDA 13.3 da segfault en algunos sistemas Linux (#222, usar 12.8 en Linux y 12.4 en Windows); reasoning_effort: "high" devuelve HTTP 500 (la plantilla acepta low, medium y xhigh; low se comporta parecido a xhigh); 500 cuando el mensaje de sistema no va primero o hay dos; el presupuesto de thinking en chat_template_kwargs se ignora; tool calls mal formadas o en bucle; bucles en algunos prompts con xhigh; el GGUF F16 carga en el llama.cpp estándar pero la salida sale estropeada; los PQ2_0/PTQ1_0 cuantizados por uno mismo no tienen los metadatos prism.hadamard.* y generan sinsentidos. El quickstart de la card usa llama-cli -c 32768 -n 16384; KNOWN_ISSUES sugiere -c 65536. Sampling, modo thinking: temperature 1,0, top_p 0,95, top_k 20, min_p 0,05. Bonsai-demo: KV cache FP16 64 KiB/token, BONSAI_KV4=1 unos 18 KiB/token.
Nuestro montaje. RunPod RTX 4090 24 GB, SECURE (COMMUNITY 4090 y L4 respondieron 409), driver 570.158.01 (CUDA 12.8), límite de 450 W. Worker preparado por un manager local de InferenceKey a través de túneles HTTP y TCP (ssh.direct a los 27,4 s, binario del worker de 25.243.632 B por SFTP en 62 s, terminado 122 s después del POST del pod). Sin tocar producción. Custom backend de Python ternary-bonsai-2-27b 0.1.0 (paquete de 5.957 B): descarga el tarball linux-cuda-12.8 del fork, el GGUF PTQ1_0 y el mmproj Q8_0, añade nvidia-cuda-runtime-cu12==12.8.* y nvidia-cublas-cu12==12.8.* (el tarball enlaza libcudart.so.12 y libcublas.so.12 sin incluirlas) a LD_LIBRARY_PATH, y ejecuta llama-server como arriba en un puerto de loopback. Pone reasoning_effort en medium por defecto, convierte high en xhigh, junta los mensajes de sistema en uno solo al principio, max_tokens 16.384. Commit del ejemplo del SDK 7a1d7883 en main de inferencekey-sdk.
Tiempo hasta estar listo. De ensure() a listo 54,6 s en un pod cuyo worker ya estaba preparado: venv + requirements 16,7 s (1,1 GB), descargas 31,5 s (unos 210 MB/s), carga del servidor 4,1 s, setup_s 35,6. PQ2_0 (7,21 GB) descargado aparte en 24 s.
Memoria y potencia. Mientras servía: llama-server 11.662 MiB; pico total de la GPU 11.672 MiB (11,4 GiB, unos 12,2 GB) de 24.564 con -c 65536, n_slots = 4, n_ctx_slot = 65536, kv_unified = true, mmproj cargado, incluido el prompt de 33.840 tokens y cuatro peticiones en paralelo; 12.892 MiB libres. Con kv_unified el pool KV de 65.536 tokens lo comparten los 4 slots, no son 65K para cada uno. El total de la GPU subió a 19.403 MiB solo mientras llama-bench se ejecutaba junto al servidor. Pico de potencia 445,1 W durante llama-bench.
llama-bench (build e3de71522 (10777), -ngl 99 -fa 1 -p 512 -n 128 -r 3): PTQ1_0 (5,53 GiB, 26,90 B) pp512 3.279 +- 427, tg128 105,78 +- 0,56; PQ2_0 (6,70 GiB) pp512 3.230 +- 433, tg128 94,50 +- 0,41. Los dos por encima de la fila de la RTX 4090 de la card (91,1 y 81,2). PTQ1_0 fue el más rápido en decode en esta GPU Ada, como dice la card.
Por petición (/v1/chat/completions sin streaming, prompt de sistema "You are a helpful assistant", max_tokens 16.384, tiempos de llama-server):
| Caso | Esfuerzo | Tok prompt | Tok salida | Gen tok/s | Prompt tok/s | Ida y vuelta s |
|---|---|---|---|---|---|---|
| batería del robot | medium | 77 | 371 | 103,9 | 186 | 5,31 |
| batería del robot | xhigh | 115 | 250 | 103,4 | 413 | 3,75 |
| acertijo de la mesa | medium | 74 | 1.447 | 104,2 | 255 | 14,73 |
| acertijo de la mesa | xhigh | 74 | 670 | 103,7 | 256 | 7,62 |
| merge_intervals | medium | 52 | 756 | 104,2 | 274 | 8,42 |
| resumen en español | none | 40 | 73 | 101,4 | 139 | 1,87 |
| OCR de la carta | medium | 617 | 230 | 103,2 | 1.189 | 4,34 |
| contar manzanas | medium | 346 | 219 | 103,1 | 832 | 3,79 |
| describir ramen | none | 607 | 64 | 101,2 | 1.023 | 3,34 |
| aguja, 33.840 tok | none | 33.840 | 11 | 68,0 | 2.843 | 13,53 |
Mediana de generación 103,6 tok/s en 12 peticiones secuenciales (de 101,2 a 104,4). Sobrecoste de la plataforma en respuestas cortas de 0,3 a 0,6 s (ida y vuelta menos el total del backend, manager local a través de un túnel). finish_reason: stop en las 17 peticiones del benchmark. Una muestra de cada con temperature 1,0: el acertijo de la mesa usó 1.447 tokens con medium y 670 con xhigh, y la pregunta del robot 371 y 250. Con dos muestras no se puede decir si medium suele ser más largo o más corto.
Concurrencia. Cuatro peticiones en paralelo con el max_in_flight por defecto de la asignación, 1: 22,4 s de reloj (idas y vueltas de 6,7, 10,6, 13,9 y 22,4 s). Después de PATCH /api/projects/<pid>/assignments/<workload>/<worker> {"max_in_flight": 8}: 9,6 s de reloj, de 68,4 a 78,1 tok/s cada una, 1.524 tokens, unos 159 tok/s en conjunto.
Problemas de la plataforma. (1) stream: true con un custom backend devuelve HTTP 200 con data: {"error":{"code":"unknown_backend",...}} y luego [DONE]: run_streaming_inference en crates/worker/src/jobs.rs solo maneja los integrados de Ollama y compatibles con OpenAI. (2) custom_backend_process devuelve output.to_string() y chat_choice_from_out lo mete en message.content como una cadena JSON, con usage todo a cero. (3) ensure() con un worker_id crea la asignación con max_in_flight 1. (4) El worker arranca python -m inferencekey.backend.serve sin --config-json, así que ctx.config está vacío. (5) Timeout del cliente /process del worker de 300 s para los custom backends. (6) El backend integrado llamacpp descarga el llama.cpp de ggml-org (asset_download_url fijo en el código, tag por defecto b9748). (7) El SFTP del binario del worker de 25 MB tardó 62 s. (8) Detalles visuales del panel: la columna Access dice "No access" con una clave comodín que funciona, "GPU telemetry partial".
Limpieza. Workload y pod borrados (RunPod devuelve 404 después), túneles, NATS, base de datos y objetos de MinIO eliminados.
Límites. Unas 20 peticiones nuestras, una o dos muestras por pregunta, temperature 1,0, la mayoría con esfuerzo medium. Todos los benchmarks de calidad son de Prism ML. Sin tool calling, sin razonamiento xhigh muy largo, sin cifras de PQ2_0 sirviendo a través de InferenceKey (solo llama-bench), sin prueba del llama.cpp estándar, un solo modelo de GPU.
Fuentes: model card, KNOWN_ISSUES, whitepaper, Bonsai-demo, release del fork prism-b10777, Qwen3.8-27B, SpinQuant, ejemplo del SDK, vídeo de la demo, vídeo de AI Search.