AuK-Flash: un modelo abierto que escribe, clona y edita voz, probado en una tarjeta de 24 GB
AuK-Flash, de Tencent, genera, clona y edita voz con una sola instrucción. En una RTX A5000 alquilada, cada edición tardó menos de un segundo de GPU.
La grabación dice "Our quarterly revenue grew by twelve percent, and the new office opens in March." (los ingresos del trimestre crecieron un doce por ciento y la nueva oficina abre en marzo). Se la mandamos a un modelo de voz con una sola línea de instrucciones (Replace 'twelve percent' with 'eighteen percent'.) y nos devolvió la misma voz diciendo dieciocho. La tarjeta gráfica (GPU), una NVIDIA RTX A5000 alquilada, dedicó 0,73 segundos a hacerlo.
El modelo es AuK-Flash, la versión rápida de AuK, publicada el 9 de septiembre por investigadores de la Universidad Jiao Tong de Shanghái, Tencent Hunyuan y el Shanghai Innovation Institute. El mismo modelo, con el mismo tipo de instrucción en inglés corriente, también se inventa una voz a partir de una descripción escrita, copia una voz con unos pocos segundos de audio, cambia el tono, la velocidad y la emoción, convierte el habla en un susurro, limpia ruido y eco, y saca a un solo hablante de una conversación. Hoy eso suele exigir un montón de herramientas distintas: una para leer texto en voz alta, otra para clonar voces, un editor, un quitarruidos y un separador de hablantes. Aquí es un solo modelo, y un ingeniero puede ponerlo detrás de una sola dirección y cambiar de tarea cambiando la frase. El código y los ficheros del modelo entrenado tienen licencia MIT, que permite el uso comercial. Pero AuK necesita además un segundo modelo, Qwen2.5-Omni-3B de Alibaba, cuya licencia no permite el uso comercial.
Esto es lo que te llevas:
| Qué | Resultado |
|---|---|
| Modelo | AuK-Flash, la versión rápida de AuK: 1,5B parámetros (el tamaño del modelo, lo bastante pequeño para una sola tarjeta). Construye cada clip en 4 pasadas en lugar de 32, lo que según la medición de los autores es 4,5 veces más rápido |
| Tareas en un solo modelo | voz a partir de una descripción, clonación de voz, sustituir o insertar palabras, tono, velocidad, emoción, susurro, quitar ruido y eco, quedarse con un hablante, y más cosas que no probamos |
| Descarga | 18,75 GB en total: 6,76 GB de AuK-Flash, más un modelo obligatorio de 12 GB que lee tu instrucción (Qwen2.5-Omni-3B, el "encoder") |
| Memoria mientras sirve | unos 20 GB en el pico, así que necesita una tarjeta de 24 GB. Unos 11 GB con un ajuste más lento que aparca parte del modelo en la memoria normal |
| Velocidad en una RTX A5000 | de 0,4 a 0,8 s de GPU por petición, entre 4 y 24 veces más rápido de lo que dura el audio |
| Ediciones | todas las ediciones que probamos dejaron el resto de la frase palabra por palabra (comprobado con la transcripción, no de oído) |
| Puntos débiles | a veces lee en voz alta la descripción de la voz, una salida larga repitió una frase y el español salió en parte ininteligible |
| Arranque | 71,6 s desde que pedimos el modelo hasta que estuvo listo para servir, con la máquina de GPU alquilada ya conectada a InferenceKey (sin nada descargado ni instalado todavía). Conectar esa máquina llevó unos 84 s más |
Voz que se edita como un documento
La mejor manera de entender AuK es imaginar un técnico de sonido al que le hablas. En un estudio no tocas tú los faders. Dices "la segunda frase, un poco más cálida, y quita esa tos", y el técnico lo hace. AuK mete a ese técnico en un modelo: le das una grabación (o nada, si tiene que empezar de cero) y una frase con lo que quieres. El cookbook recoge las plantillas de instrucciones que recomiendan los autores, y se leen como notas para una persona:
Say the following with the same voice: "{text}"para clonar una voz a partir de una muestra corta.Replace '{original}' with '{new}'.yAdd '{text}' before '{anchor}'.para cambiar las palabras.Raise the pitch by 2 semitones.oAdjust the speech speed to 1.25x.Keep only the first speaker to start talking and remove all other speakers.Preserve all speakers, remove noise and reverberation, and output clean speech of the same length.
La tabla de tareas del proyecto va más allá de lo que probamos: editar la letra de canto sin instrumentos, el volumen, el carácter de la voz, quitar un acento, añadir o quitar respiraciones, risas y toses, separar música y sacar a un hablante por lo que dice. Los autores lo describen como un modelo general para crear y editar voz, entrenado con millones de horas de audio.
Por qué le importa a un ingeniero: un modelo es una sola cosa que desplegar, vigilar y actualizar, en una sola tarjeta gráfica, detrás de una sola dirección. Una tarea nueva es una frase nueva. La pega es que una sola dirección también es una sola cola: en una sola tarjeta, un trabajo de limpieza largo hace esperar a la petición siguiente.
Cómo lo hace
AuK tiene tres partes, según el informe técnico. El encoder, un modelo que entiende texto y audio a la vez (Qwen2.5-Omni, del equipo Qwen de Alibaba), lee tu instrucción y la grabación de entrada. Después, un generador de sonido, que es AuK propiamente dicho, construye el audio nuevo. Una tercera pieza convierte el resultado en audio normal que se puede reproducir.
El generador trabaja como un pintor que pasa de un boceto borroso a un cuadro terminado. El AuK base afina el boceto 32 veces. En cada paso hace dos versiones, una que sigue tu instrucción y otra que la ignora, y se aleja de la segunda. AuK-Flash se entrenó para terminar en 4 pasos con una sola versión cada vez, lo que según la medición de los autores es 4,5 veces más rápido. El código impone esa receta: si le pides a Flash más pasos o la segunda versión, no te hace caso. Un comentario en el código fuente advierte de que volver a activar la segunda versión hace que la salida suene tan fuerte que se distorsiona ("blows up the amplitude").
El conjunto de entrenamiento es grande: unos 3.000 millones de pares de instrucción y audio, 1,95 millones de horas, en chino y en inglés. Firman el informe Ziyang Ma y otros 32 autores.
Cómo de bueno es, según las cifras de los autores
Estas puntuaciones salen de la Tabla 3 del informe. No las hemos reproducido.
Leyendo en voz alta con una voz clonada, AuK-Flash se equivoca en unas 3 palabras de cada 100 (2,85 %), algo mejor que el sistema anterior más fuerte de la comparación del informe (3,07 %). Solo en inglés es más o menos 1 palabra de cada 100.
Cuando se le pide sustituir o insertar palabras, AuK-Flash hizo bien la edición 87,5 veces de cada 100 en la prueba de edición de los autores (SpeechEditBench), frente a unas 76 del mejor sistema anterior de la tabla.
En limpieza y separación de audio, los autores califican sus resultados de "competitive" (competitivos), no de los mejores. En una prueba de separar dos voces, una herramienta hecha solo para eso lo hace mejor que AuK-Flash.
El informe dice que los mejores resultados siguen necesitando un modelo de lenguaje aparte delante de AuK, que averigüe la tarea y reescriba la petición con la forma de decirlo con la que se entrenó el modelo. Nosotros no usamos ninguno, y se notó en un punto (ver "Cómo suena").
Dos modelos que descargar, 20 GB de memoria
Una instalación que funcione descarga 18,75 GB, porque AuK necesita un segundo modelo, de 12 GB, para leer tus instrucciones. La página de AuK-Flash por sí sola indica 6,8 GB. El vídeo de AI Search donde vimos la publicación (un repaso de noticias publicado el 13 de septiembre) se quedaba aún más corto, "only like 6.12 gigabytes", que es solo el fichero principal.
- El encoder va aparte. AuK necesita Qwen2.5-Omni-3B para entender las instrucciones, y se descarga por separado. Son 11,99 GB además de los 6,76 GB de AuK-Flash.
- Memoria. En nuestra tarjeta usó unos 15,6 GB justo después de cargar y unos 20,3 GB en el pico mientras trabajaba. Eso exige una tarjeta de 24 GB. Un ajuste que deja parte del modelo en la memoria normal del ordenador bajó el pico a unos 11,3 GB, pero entonces cada petición tardaba unos 13 segundos en lugar de menos de uno. Podría caber en una tarjeta de 16 GB, pero no lo hemos probado en ninguna.
- La licencia. El código y los ficheros del modelo de AuK son MIT. Qwen2.5-Omni-3B tiene la Qwen Research Licence, que no permite el uso comercial. Un usuario abrió la issue #13 para señalar que, en la práctica, eso convierte la publicación en no comercial. Un colaborador del proyecto, ZhikangNiu, respondió que la licencia MIT cubre el código y los pesos propios de AuK, que no anula las licencias de terceros y que el equipo tiene previsto cambiar el encoder por uno con licencia permisiva en una versión futura. Hasta entonces, una empresa que lance un producto sobre AuK tal y como está publicado tiene que resolver antes una cuestión de licencias.
Cómo lo ejecutamos en InferenceKey
La GPU y el coste
Ejecutamos AuK-Flash en una NVIDIA RTX A5000 de 24 GB, una tarjeta de estación de trabajo, alquilada en RunPod a 0,27 USD la hora. Cuatro ediciones enviadas a la vez tardaron 5,8 segundos en total. Eso son unas 2.500 ediciones por hora, más o menos una centésima de céntimo de dólar por edición a ese precio de alquiler de la GPU a secas, antes de cualquier tarifa de la plataforma. Está calculado a partir de una sola ráfaga de cuatro peticiones a través de un túnel de desarrollo, no de una prueba de carga larga.
El backend, y por qué uno propio
InferenceKey ejecuta cada modelo a través de un pequeño adaptador que llamamos backend. Ninguno de los que vienen de serie admite AuK todavía. InferenceKey puede ejecutar modelos de texto a audio con vLLM-Omni, un servidor de código abierto. El proyecto vLLM-Omni publicó una receta para AuK, pero para una tarjeta de centro de datos mucho más grande, y no la probamos en 24 GB. Así que escribimos nuestro propio adaptador: un paquete pequeño que descarga el código de Tencent en una versión fija y los ficheros del modelo, los carga y pasa cada petición al código de Tencent. Acepta una instrucción más una grabación opcional, calcula la duración de la salida cuando no se la das, limita las salidas a 30 segundos y ejecuta un solo trabajo a la vez en la GPU.
Los pasos
Nuestro código de ejemplo para la librería de Python de InferenceKey lo hace con dos scripts. publish.py sube el custom backend a tu cuenta una vez. main.py le pide a InferenceKey que ejecute el modelo en tu máquina de GPU y espera a que esté listo. Usa la dirección de chat del modelo, porque nuestra dirección de texto a voz todavía no puede devolver audio desde un adaptador propio (ver "Lo que salió mal"). Después ejecuta una cadena corta que no necesita ninguna grabación tuya: diseña una voz, la clona para una frase nueva, sustituye "small teams" por "two engineers", la acelera 1,25 veces y apaga. Lo esencial:
spec = WorkloadSpec(
    name="AuK-Flash speech generation and editing",
    slug=SLUG,
    model="tencent/AuK-Flash",
    backend=BACKEND_SLUG,  # our own adapter instead of a built-in one
    task_type="text2audio",
    worker_id=os.environ["IK_WORKER_ID"],
    execution_policy=ExecutionPolicy.FIXED,
    execution_policy_config={"replicas": 1},
)
ref = mgmt.ensure(spec)
enable_chat_route(base, project, ref.workload_slug)
mgmt.wait_until_ready(ref.workload_slug, timeout=2400)

out = auk(url, key, "Replace 'small teams' with 'two engineers'.", audio=host, seed=7)
Cada petición va a la dirección de chat del modelo (el mismo tipo de dirección que usa un chatbot), con la instrucción como texto y, en las ediciones, la grabación adjunta. La respuesta vuelve como texto con el audio empaquetado dentro, y el ejemplo lo convierte de nuevo en un fichero WAV normal. Las idas y vueltas se midieron a través de un túnel de desarrollo hasta la tarjeta alquilada y pueden ser distintas en el servicio alojado.
Lo que medimos
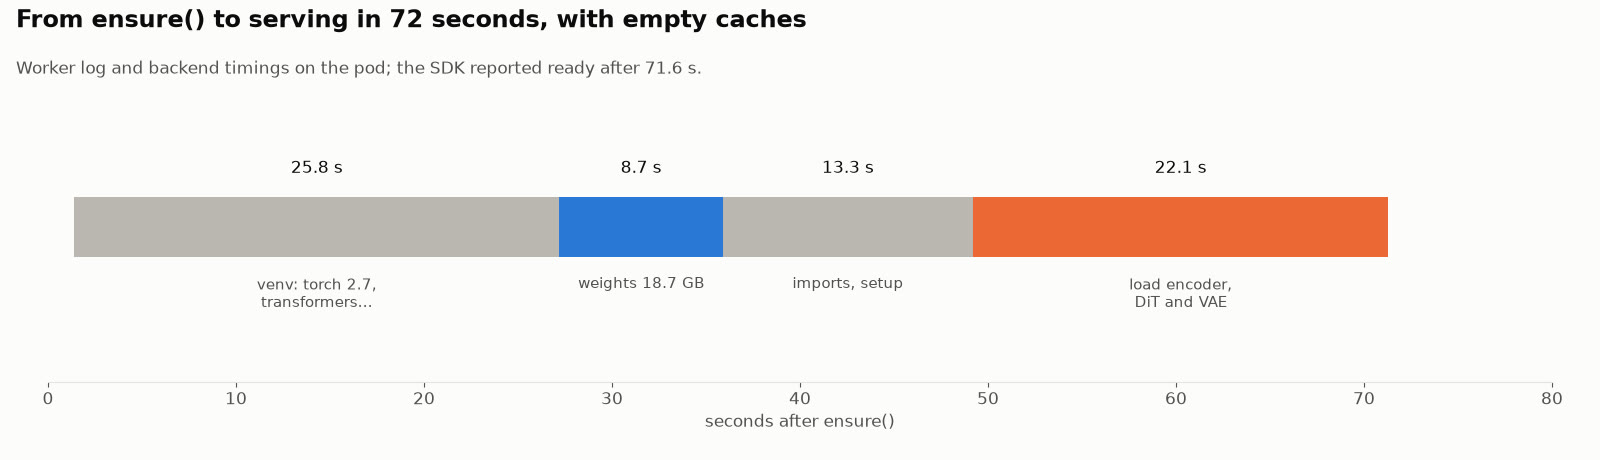
Listo en 72 segundos con la máquina de GPU ya conectada. Desde que pedimos el modelo hasta que estuvo listo para servir pasaron 71,6 s, en una máquina alquilada ya conectada a InferenceKey pero sin el software ni los ficheros del modelo. Conectar esa máquina recién alquilada llevó unos 84 s más. Instalar el software llevó 25,8 s, descargar los 18,75 GB de ficheros del modelo solo 8,7 s y cargar el modelo en la tarjeta 22,1 s. Los 13 s o así restantes fueron de preparación. Un segundo arranque, con los ficheros ya en la máquina, tardó 47,2 s.
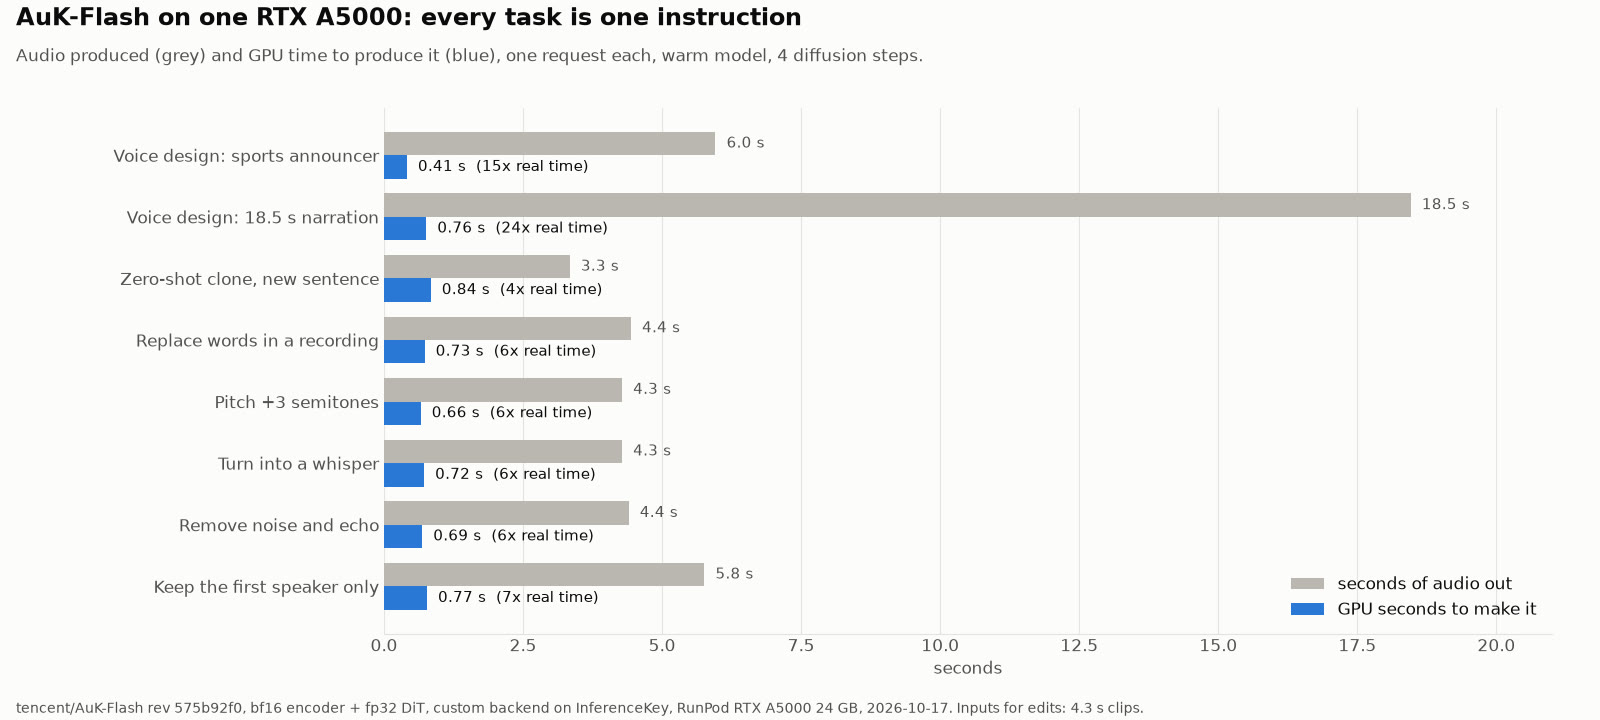
Menos de un segundo de GPU por trabajo. Ya en caliente, cada petición ocupó entre 0,4 y 0,8 segundos de la tarjeta. Una narración de 18,5 segundos tardó 0,76 s, unas 24 veces más rápido de lo que dura. Una edición de 4,4 segundos tardó unos 0,7 s. La clonación fue lo más lento: 0,84 s para 3,3 segundos de voz, aun así 4 veces más rápido de lo que dura. La primerísima petición después de cargar es más lenta, de 1,2 a 2,3 s, mientras la tarjeta se calienta. Contando el viaje por la red desde nuestra máquina de desarrollo hasta la tarjeta alquilada, una edición volvía en unos 1,3 a 1,5 segundos.
Unos 20 GB de memoria en el pico. El modelo ocupó unos 15,6 GB de la memoria de la tarjeta una vez cargado y unos 20,3 GB en su momento de más trabajo. El ajuste de ahorro de memoria llegó a un pico de unos 11,3 GB, pero entonces cada petición tardaba de 13 a 15 segundos, más de lo que dura el propio audio.
Una a una. Cuatro ediciones enviadas a la vez se respondieron por turnos, la última a los 5,8 s. Aquí es así a propósito: el backend ejecuta un solo trabajo a la vez en la GPU.
Cómo suena
Para comprobar la calidad sin fiarnos solo de nuestros oídos, transcribimos cada salida con Whisper de OpenAI (large-v3-turbo) en la misma máquina y comparamos las palabras. Las voces de entrada son sintéticas, hechas con Pocket TTS: voz limpia, como de estudio, que es el caso más fácil para editar y clonar. No probamos grabaciones reales, con ruido de sala, acentos y gente hablando a la vez. Son intentos únicos, no una prueba de escucha.
La edición es el punto fuerte. Todas las ediciones dejaron el resto de la frase palabra por palabra. La transcripción demuestra las palabras. No demuestra que el tono subiera de verdad, que el susurro sea un susurro ni que la palabra sustituida se una al resto sin una costura audible: eso exige un oído o una medición del tono, y no lo medimos. Escucha y juzga tú. Este es el original y lo que salió:
- Original (voz sintética): "Our quarterly revenue grew by twelve percent, and the new office opens in March."
- Sustituir 'twelve percent' por 'eighteen percent' (0,73 s de GPU)
- Añadir 'almost' delante de 'twelve percent' (0,76 s de GPU)
- Subir el tono 3 semitonos (0,66 s de GPU)
- Convertido en susurro (0,72 s de GPU)
Limpiar y separar. Añadimos ruido y eco a la grabación y pedimos voz limpia. La transcripción no cambió, lo que demuestra que las palabras sobrevivieron. No mide lo limpio que queda el resultado, así que eso júzgalo de oído. Para la separación, superpusimos dos voces, y la frase entera del segundo hablante desapareció de la salida.
- Antes: la misma frase con ruido y eco añadidos
- Después: "remove noise and reverberation" (0,69 s de GPU)
- Antes: dos voces hablando a la vez
- Después: "keep only the first speaker" (0,77 s de GPU)
Voces nuevas, y la copia de una. El diseño de voz parte de una descripción escrita y de ningún audio. La clonación toma la voz del clip original de los ingresos y le hace decir algo que nunca dijo.
- Diseño de voz: un locutor deportivo, "And she crosses the line first, a new course record by almost four seconds." (0,41 s de GPU)
- Diseño de voz: una narración documental de 18,5 s sobre un río (0,76 s de GPU)
- Clon de la voz del clip de los ingresos, a partir de esa única muestra y sin entrenamiento: "The board approved the budget, and hiring starts next quarter." (0,84 s de GPU)
No medimos cuánto se parece el clon a la voz original.
El diseño de voz depende de cómo se pida. Con la forma Based on the following description: "...", generate speech content "...". (el ejemplo de línea de comandos del proyecto, que es el que usa el nuestro), 7 de 8 diseños de voz en inglés salieron exactamente bien. El octavo, la narración de 18,5 segundos en otro intento, repitió "the river begins as snow on the high peaks" y se saltó la frase siguiente. Con la forma Generate speech based on the following description: "...". The content to speak is: "...". (la plantilla en inglés del cookbook), el modelo leyó en voz alta parte de la descripción en 8 de 8 intentos ("A sports chatty excited, and she crosses the line first..."). Encaja con lo que dice el informe sobre reescribir antes las peticiones: la forma de decirlo importa.
- La plantilla del cookbook: la descripción se cuela en la voz
El español todavía no está. AuK está entrenado en chino y en inglés. Una frase en español salió en parte ininteligible. Un usuario del repo contó lo mismo con el polaco (issue #17). Siguiendo el consejo de un colaborador del proyecto, ese mismo usuario entrenó después AuK-Base con unas 100 horas de grabaciones en polaco y consiguió que funcionara.
- Diseño de voz en español, en parte ininteligible
Puede que los gritos sean un hueco. Un usuario cuenta que AuK no reproduce gritos ni chillidos a partir de una grabación de referencia (issue #23). La issue sigue abierta y no lo hemos probado.
En unas 60 peticiones no hubo ningún fallo, y ninguna volvió rota.
El vídeo de la demo
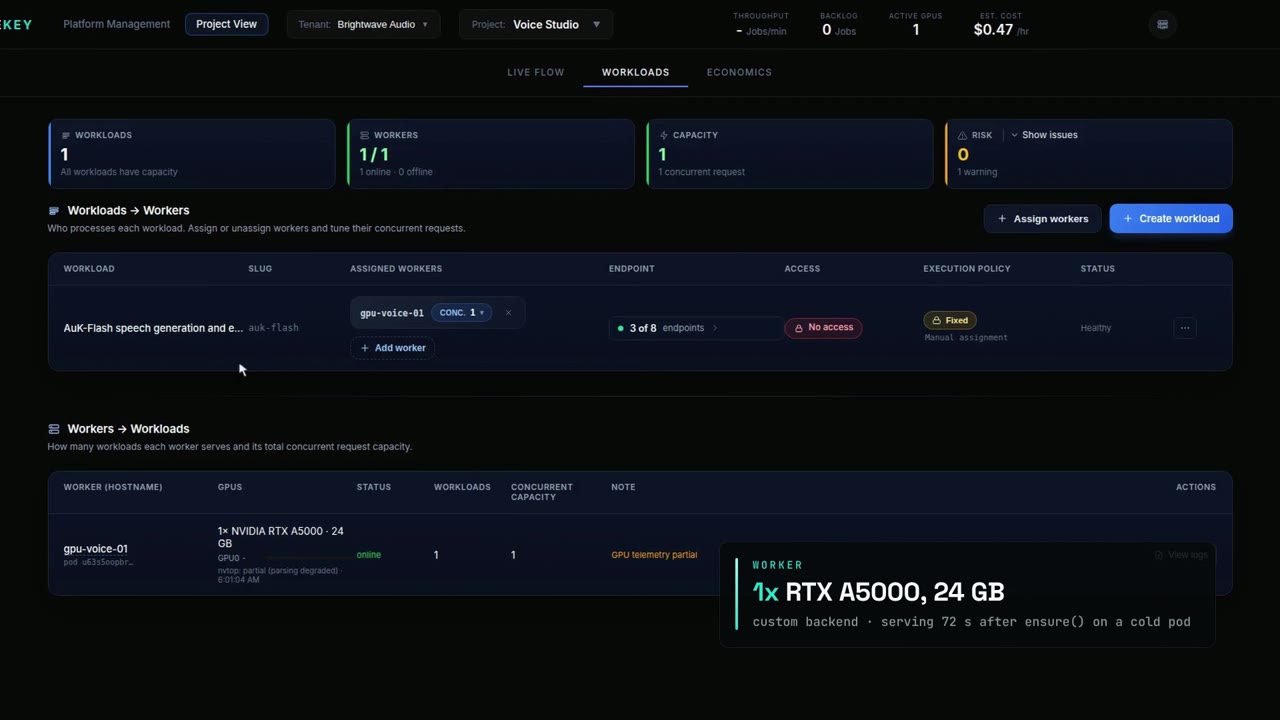
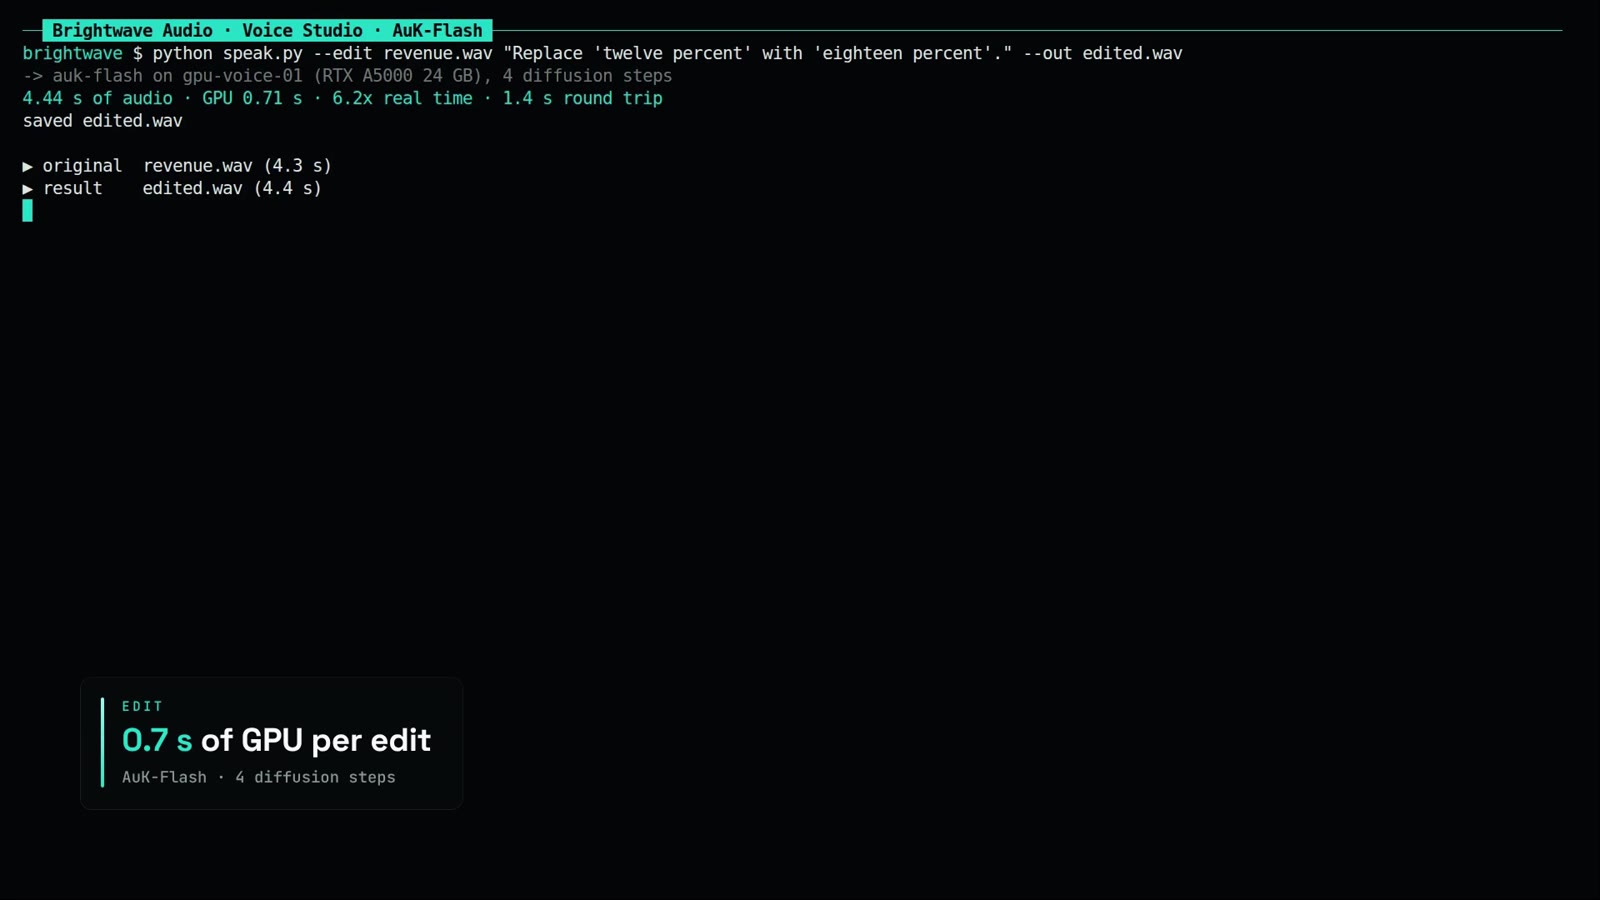
El vídeo muestra el modelo en la RTX A5000 en el panel de InferenceKey y después un terminal pidiendo la sustitución del número (4,44 s de audio, 0,71 s de GPU, 1,4 s de ida y vuelta), la voz del locutor y la eliminación de ruido, con el audio de antes y de después mezclado en la banda sonora para que se oiga.
Lo que salió mal
- La dirección de texto a voz no funciona con custom backends. La dirección natural para este modelo, la estándar de texto a voz, devolvió un error en lugar de audio. Nuestra plataforma todavía no devuelve audio desde un adaptador propio en esa dirección. Es un hueco nuestro. La solución provisional es la dirección de chat, que tuvimos que activar para este modelo. La respuesta llega entonces como texto con el audio empaquetado dentro, no como un fichero de audio normal. El ejemplo hace las dos cosas.
- El primer arranque se cayó durante la descarga. Había dos descargas a la vez y sus barras de progreso chocaron. Desactivar las barras de progreso lo arregló.
- Faltaba un paquete. La primera petición de audio falló porque no estaba instalada una librería que el encoder necesita para leer ficheros de audio (
audioread). La añadimos a los requisitos.
Quién hizo qué
El equipo de AuK, Ziyang Ma y 32 coautores de la Universidad Jiao Tong de Shanghái, Tencent Hunyuan y el Shanghai Innovation Institute, creó AuK y AuK-Flash, escribió el informe técnico y el cookbook, y publicó el código y los ficheros del modelo con licencia MIT. Después de la publicación hizo funcionar una versión de prueba en Macs con Apple Silicon, consiguió que funcionara en tarjetas más pequeñas, recortó unos 8 GB el uso de memoria del encoder y publicó cómo entrenó la versión rápida. Otros proyectos de código abierto que ejecutan modelos en producción pusieron su parte: SGLang-Omni admitió AuK el mismo día de la publicación, vLLM-Omni añadió una receta dos días después y el audio.cpp de 0xShug0 ejecuta AuK como GGUF en un motor de C++ puro, sin Python. El equipo Qwen de Alibaba creó Qwen2.5-Omni, el encoder a través del que escucha AuK. Pocket TTS de Kyutai hizo las voces sintéticas que usamos como entrada, y Whisper de OpenAI hizo nuestras comprobaciones de transcripción. Quienes participan en las issues del repo plantearon la cuestión de la licencia, los resultados en polaco y el aviso sobre los gritos, y los colaboradores del proyecto respondieron en abierto. La persona que contó los resultados en polaco acabó entrenando una versión en polaco que funciona. Vimos la publicación en el vídeo de noticias de AI Search.
Nuestra parte fue el custom backend que lleva el código de inferencia de Tencent a InferenceKey, el ejemplo del SDK, ejecutarlo de principio a fin en una RTX A5000 y medir el tiempo de arranque, la memoria, la velocidad por tarea y si las palabras sobrevivían a cada edición.
Qué sacar en claro
En una tarjeta de 24 GB, todas las ediciones que probamos dejaron el resto de la frase palabra por palabra: una palabra cambiada, una palabra añadida, un segundo hablante eliminado, cada una en menos de un segundo de GPU. Un modelo detrás de una sola dirección hizo el trabajo de cinco herramientas en nuestra prueba, una petición a la vez. Si está a la altura de cada herramienta especializada lo dicen los benchmarks de los autores, no los nuestros, y en una prueba de separación un modelo dedicado supera a AuK-Flash. Los límites son igual de concretos. Necesita unos 20 GB de memoria en el pico. Habla chino e inglés. El diseño de voz es sensible a cómo se pide. Nuestras comprobaciones fueron unas 60 peticiones, casi todas de un solo intento, con voces sintéticas y sin panel de escucha.
Hoy, la licencia del encoder decide casi todo el uso empresarial. El equipo ha dicho que tiene previsto cambiarlo por un encoder con licencia permisiva, y hasta entonces la issue #13 es el hilo que hay que seguir.
Para ingenieros
Modelo (card de AuK-Flash, card de AuK, repo, cookbook, arXiv 2609.08936, página del proyecto). tencent/AuK-Flash sha 575b92f0, modificado por última vez el 2026-09-09, sin acceso restringido, MIT, 6.762.642.715 B almacenados: auk_flash.safetensors 6.122.209.092 B (DiT en fp32), vae.safetensors 637.322.604 B. tencent/AuK (base, auk_base.safetensors) ocupa lo mismo. El README y las cards de HF dicen MIT (la API de GitHub da NOASSERTION). 1.524 estrellas en GitHub, AuK-Flash con 1.599 descargas y 107 likes, AuK con 2.695 descargas y 389 likes (2026-10-17). Idiomas en HF: zh, en. Cronología upstream (noticias del README): MLX en Apple Silicon en la rama feat/mlx-apple-silicon y CPU offload en CUDA el 2026-09-13, PR #19 de memoria del encoder el 2026-09-16, pipeline de entrenamiento por destilación el 2026-10-14 (PR #22).
Arquitectura (sección 4.2 del informe). Qwen2.5-Omni como encoder semántico MLLM, con los hidden states agregados capa a capa; VAE de audio entrenado con voz, audio general y música (latentes a 50 Hz, 64 dimensiones, salida a 24 kHz); Transformer híbrido de rectified flow, 30 capas = 10 MMDiT de doble flujo + 20 DiT de flujo único, hidden 1536, 24 cabezas, unos 1,5B parámetros. Encoder y VAE congelados. Entrenamiento: unas 3,03B instancias de instrucción y audio, 1,95M horas de supervisión efectiva, cinco familias de tareas. AuK-Flash: inicialización por consistencia más Decoupled DMD con enrutado por tarea, 4 pasos, sin CFG, 4,5x de tiempo de reloj frente al profesor de 32 NFE y CFG 2.0. src/auk/infer/infer_auk.py @ 9481474f detecta Flash por el nombre de la config y lo fija a 4 pasos, CFG 0, t-grid [0, 0.0761, 0.2929, 0.6173, 1], ignorando los parámetros de muestreo que pase quien llama. Valores por defecto del base: nfe 32, cfg_strength 2.0.
Tabla 3 del paper (cifras de los autores). WER medio en Seed-TTS-Eval: AuK 2,65, AuK-Flash 2,85, Qwen3-TTS 3,07, Seed-TTS 3,65, VoxCPM2 3,65. SIM medio: AuK 0,795, Flash 0,790, Seed-TTS 0,778. WER en EN: AuK 1,02, Flash 1,03, Qwen3-TTS 1,23. EMR en MMAE(Speech): Flash 13,85, AuK 12,44, Ming-UniAudio 7,04, Step-Audio-EditX 4,69. ACC de contenido en SpeechEditBench: Flash 87,50, AuK 91,83, Ming-UniAudio 76,46, Step-Audio-EditX 16,50. dWER en DNS Challenge: Flash 2,93, AuK 2,66, RE-USE 3,31. WER en Libri2Mix: Flash 10,07, AuK 9,12, MossFormer2-SS 9,34.
VRAM upstream. Tabla del README (A800, bf16, max_memory_allocated): AuK-Flash 24,77 GiB solo con texto y 1,5 s de salida, 16,75 GiB con --cpu_offload; 24,97 / 16,98 GiB con 5 s de audio de referencia. Esa tabla es anterior a la PR #19 (mergeada el 2026-09-16), que pasa a fp32 solo el DiT y mantiene Qwen en bf16, unos 7,5 GiB menos (Qwen 7,515 GiB en bf16, 15,031 GiB pasado a fp32).
Nuestro montaje. RunPod RTX A5000 24.564 MiB, SECURE, CA-MTL-1, 0,27 USD/h (la RTX 4090 COMMUNITY respondió 409), driver 580.178.04 (CUDA 13.0), límite de 230 W, compute 8.6, 7,65 CPUs según el cgroup, 503 GB de RAM en el host, Python 3.12.3, 100,7 MB/s con curl de un solo flujo desde huggingface.co. En una medición aparte del arranque en frío de abajo, un manager local de InferenceKey preparó el worker a través de túneles HTTP y TCP en 84 s desde el POST del pod (ssh a los 38,5 s, binario del worker de 25.243.632 B por SFTP en 14,8 s).
Backend. Custom backend de Python auk-flash-speech 0.1.3, task type text2audio. Versiones fijadas: AuK 9481474f107ee4d8dec959b3aed05b0627cebbf8, AuK-Flash 575b92f0, Qwen2.5-Omni-3B f75b40e3 (solo el Thinker). AukInfer(config, ckpt, dtype="bf16", qwen_path=...). max_gen_seconds 30, chars_per_second 14 para estimar la duración, variables de entorno AUK_* para sobrescribir, AukFlashOffloadBackend pone cpu_offload=True. Devuelve audio_b64 (WAV de 16 bits, 24 kHz mono), seconds, timings {gpu_s, total_s, realtime_factor, peak_vram_mib}. La llamada a la GPU va bajo un lock. publish.py empaqueta con requires_python >=3.10,<3.13. README del ejemplo: mantener las entradas por debajo de unos 15 s para no pasar del límite de 2 MB del cuerpo de la petición de la plataforma; torch 2.7 de PyPI es la build de CUDA 12.6, así que el driver tiene que admitir CUDA 12.6 o superior. Nota: el .env.example del ejemplo dice "about 17 GB of free VRAM"; el pico medido con nvidia-smi fue de 19.390 MiB, así que cuenta con una tarjeta de 24 GB. Commit del ejemplo del SDK aa7e900 en main de inferencekey-sdk.
Arranque en frío. De ensure() a listo en el SDK 71,6 s con las cachés de HF, uv y venv vacías: venv 25,8 s (torch 2.7, transformers 4.57), descargas 8,7 s para 18,75 GB, unos 13 s de imports y preparación, carga 22,1 s (setup_s 44,1, vram_loaded_mib 14.305). Con los pesos en caché y la caché de uv caliente: 47,2 s. Con el venv ya presente: 36,1 s y 19,8 s.
VRAM (nvidia-smi -l 1). 14.837 MiB después de cargar, 19.390 MiB de pico sirviendo, max_memory_allocated de torch de 17.309 a 17.964 MiB por petición. Variante con offload: 1.571 MiB en reposo, 10.755 MiB de pico, de 12,7 a 15,2 s de GPU por petición (de 0,3x a 0,5x tiempo real), no probada en una tarjeta real de 16 GB. Pico de potencia 181 W.
Por petición (en caliente, seed 7, /v1/chat/completions sin streaming, plantilla de la CLI salvo que se indique otra cosa; el tiempo de GPU es el gpu_s sincronizado del backend, y la ida y vuelta la mide el cliente a través del túnel):
| Caso | Entrada | Salida s | GPU s | x tiempo real | Ida y vuelta s | Lo que dice Whisper |
|---|---|---|---|---|---|---|
| Diseño de voz, locutor | ninguna | 5,96 | 0,41 | 14,5 | 0,76 | texto exacto |
| Diseño de voz, narración de 18,5 s | ninguna | 18,46 | 0,76 | 24,3 | 1,23 | texto exacto |
| Clon zero-shot, frase nueva | clip de 4,3 s | 3,34 | 0,84 | 4,0 | 1,81 | texto exacto |
| Sustituir "twelve percent" por "eighteen percent" | 4,3 s | 4,44 | 0,73 | 6,1 | 1,53 | "...grew by 18%, and..." |
| Insertar "almost" | 4,3 s | 4,80 | 0,76 | 6,3 | 1,49 | "...grew by almost 12%..." |
| Tono +3 semitonos | 4,3 s | 4,28 | 0,66 | 6,5 | 1,39 | texto sin cambios |
| Emoción: emocionado | 4,3 s | 4,28 | 0,68 | 6,3 | 1,27 | texto sin cambios |
| Susurro | 4,3 s | 4,28 | 0,72 | 5,9 | 1,33 | texto sin cambios |
| Quitar ruido + reverberación | 4,4 s | 4,40 | 0,69 | 6,4 | 1,29 | texto sin cambios |
| Quedarse con el primer hablante | 5,8 s | 5,76 | 0,77 | 7,5 | 1,40 | solo la frase del hablante 1 |
| Diseño de voz en español | ninguna | 6,96 | 0,43 | 16,3 | 0,79 | en parte ininteligible |
Primera petición después de una carga en frío: de 1,23 a 2,30 s de GPU para un diseño de voz de 6,1 s. Sobrecoste de la plataforma (ida y vuelta menos GPU) de unos 0,3 a 1,0 s en las ediciones, porque la petición y la respuesta llevan cada una un WAV en base64. Cuatro ediciones en paralelo: 5,82 s de reloj, idas y vueltas de 1,42, 2,92, 4,46 y 5,81 s (concurrencia de la asignación 1 más el lock del backend), las cuatro salidas correctas. Velocidad 1,25x: de 6,10 s a 4,88 s. Las "unas 2.500 ediciones por hora" del texto son 3.600 / (5,82 / 4), una proyección a partir de esta única ráfaga de cuatro a través de un túnel de desarrollo; no se hizo ninguna prueba de carga sostenida.
Comprobación de calidad. openai/whisper-large-v3-turbo en el pod. Plantillas de diseño de voz: la del cookbook en inglés, Generate speech based on the following description: "...". The content to speak is: "..."., coló palabras de la descripción en 8 de 8 salidas (4 más 4 con un gen_seconds más corto); la de la CLI, Based on the following description: "...", generate speech content "..."., dio 7 de 8 exactas, y la salida de 18,5 s con seed 8 repitió una frase y se saltó "every spring it melts". El cookbook dice que se pase gen_seconds en las tareas que necesitan una duración de salida explícita (TTS, edición de contenido, velocidad) y que la entrada para editar letras debe ser a capela.
Problemas de la plataforma. (1) /v1/audio/speech con un custom backend devuelve HTTP 500 "worker returned no payload for passthrough route": el worker solo expone como binario el JSON de un custom backend para los tipos de transcripción, embeddings, rerank, forecast e imagen (needs_json_binary_surfacing en crates/worker/src/jobs.rs), y el passthrough del manager exige binary_b64. Solución provisional: PATCH /api/workloads/<id>/endpoint_settings/chat {"enabled":true} y /v1/chat/completions, cuyo contenido del mensaje es el JSON del backend como string. (2) Carrera de tqdm entre dos llamadas snapshot_download en paralelo (AttributeError: type object 'tqdm' has no attribute '_lock'), arreglada con HF_HUB_DISABLE_PROGRESS_BARS=1 en la 0.1.1. (3) No module named 'audioread' en la primera petición de audio (el cliente vio HTTP 503 backend_unavailable), arreglado en la 0.1.2. (4) Los workloads fijos arrancan con concurrencia 1. (5) Detalles cosméticos del panel: Access "No access" con una key comodín que funciona, "GPU telemetry partial".
Límites conocidos upstream. Issue #13 (abierta): licencia del encoder. Issue #17 (abierta): WER mediano en polaco zero-shot de un 80 % frente a un 23 % en inglés; el mismo usuario hizo después fine-tuning de AuK-Base con 103,65 h de polaco de MLS y llegó a un CER medio del 3,3 %. Issue #23 (abierta): un usuario cuenta que AuK y AuK-Flash no reproducen gritos a partir de una referencia. La integración con ComfyUI tiene un presupuesto de 30 s entre origen y destino.
Límites. Unas 60 peticiones nuestras, casi todas con una sola seed, voces de entrada sintéticas, sin métrica de similitud de hablante, sin prueba de escucha, la eliminación de ruido comprobada solo en conservación del contenido. Sin probar: edición de letras, volumen, timbre, quitar acento, ediciones no verbales, separación de música, extracción de un hablante objetivo, eliminar palabras, el AuK base, la variante con offload en una tarjeta real de 16 GB y el Prompt Enhancer. Las cifras de benchmarks son de los autores (precisión de contenido en SpeechEditBench: AuK-Flash 87,50 frente a Ming-UniAudio 76,46; WER medio en Seed-TTS-Eval 2,85 frente a Qwen3-TTS 3,07) y no las hemos reproducido.
Fuentes: AuK-Flash, AuK, GitHub, cookbook, informe técnico, página del proyecto, licencia de Qwen2.5-Omni-3B, ejemplo del SDK, vídeo de la demo, vídeo de AI Search.