AuK-Flash: ein offenes Modell, das Sprache schreibt, klont und bearbeitet, getestet auf einer 24-GB-Karte
AuK-Flash von Tencent erzeugt, klont und bearbeitet Sprache per Anweisung. Auf einer gemieteten RTX A5000 brauchte jede Bearbeitung unter 1 s GPU-Zeit.
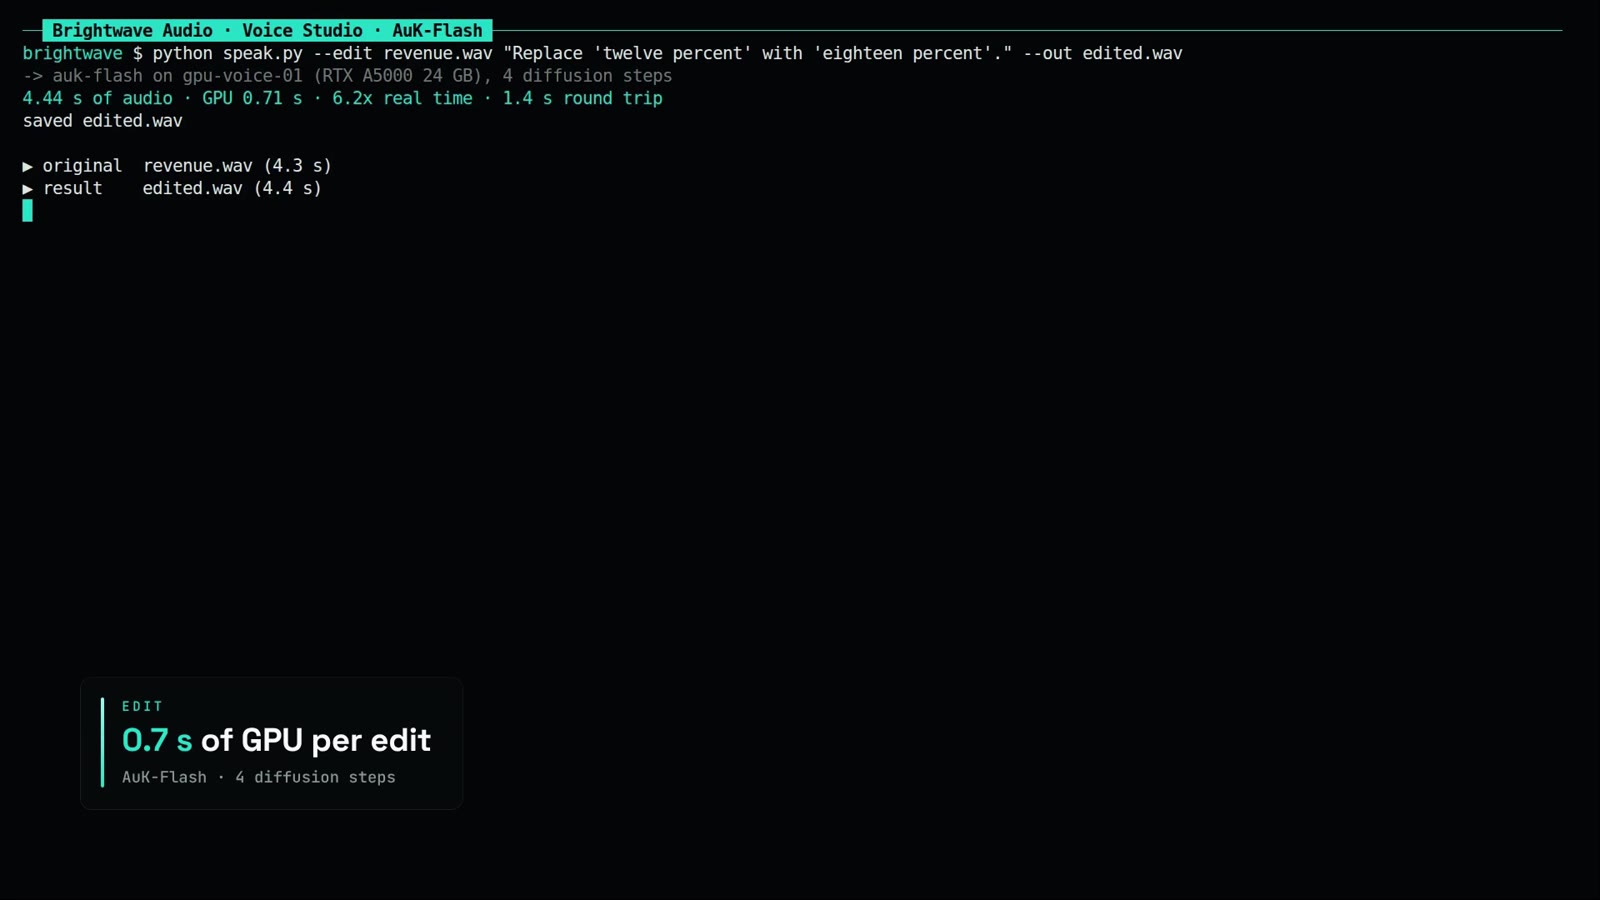
In der Aufnahme heißt es „Our quarterly revenue grew by twelve percent, and the new office opens in March.“ Wir haben sie mit einer einzigen Zeile Anweisung (Replace 'twelve percent' with 'eighteen percent'.) an ein Sprachmodell geschickt und dieselbe Stimme zurückbekommen, die jetzt eighteen sagt. Die Grafikkarte (GPU), eine gemietete NVIDIA RTX A5000, hat dafür 0.73 Sekunden gebraucht.
Das Modell ist AuK-Flash, die schnelle Version von AuK, veröffentlicht am 9. September von Forschenden der Shanghai Jiao Tong University, von Tencent Hunyuan und vom Shanghai Innovation Institute. Dasselbe Modell, gesteuert mit derselben Art von Anweisung in einfachem Englisch, erfindet auch eine Stimme nach einer schriftlichen Beschreibung, kopiert eine Stimme aus ein paar Sekunden Audio, ändert Tonhöhe, Tempo und Emotion, macht aus Sprache ein Flüstern, entfernt Rauschen und Hall und holt einen Sprecher aus einem Gespräch heraus. Heute braucht man dafür meist einen ganzen Stapel einzelner Werkzeuge: eins, das Text vorliest, eins zum Klonen von Stimmen, einen Editor, einen Rauschentferner und einen Sprechertrenner. Hier ist es ein Modell, und ein Engineer kann es hinter eine einzige Adresse stellen und die Aufgabe wechseln, indem er den Satz ändert. Code und trainierte Modelldateien stehen unter der MIT-Lizenz, die kommerzielle Nutzung erlaubt. AuK braucht aber noch ein zweites Modell, Qwen2.5-Omni-3B von Alibaba, und dessen Lizenz erlaubt keine kommerzielle Nutzung.
Das nimmst du mit:
| Was | Ergebnis |
|---|---|
| Modell | AuK-Flash, die schnelle Version von AuK: 1.5B Parameter (die Größe des Modells, klein genug für eine Karte). Es baut jeden Clip in 4 Durchgängen statt 32, was die Autoren als 4.5-mal schneller gemessen haben |
| Aufgaben in einem Modell | Stimme nach Beschreibung, Stimmklonen, Wörter ersetzen oder einfügen, Tonhöhe, Tempo, Emotion, Flüstern, Rauschen und Hall entfernen, einen Sprecher behalten, und mehr, das wir nicht getestet haben |
| Download | insgesamt 18.75 GB: 6.76 GB für AuK-Flash plus ein zwingend nötiges Modell mit 12 GB, das deine Anweisung liest (Qwen2.5-Omni-3B, der „Encoder“) |
| Speicher im Betrieb | in der Spitze etwa 20 GB, es braucht also eine 24-GB-Karte. Etwa 11 GB mit einer langsameren Einstellung, die einen Teil des Modells im normalen Arbeitsspeicher parkt |
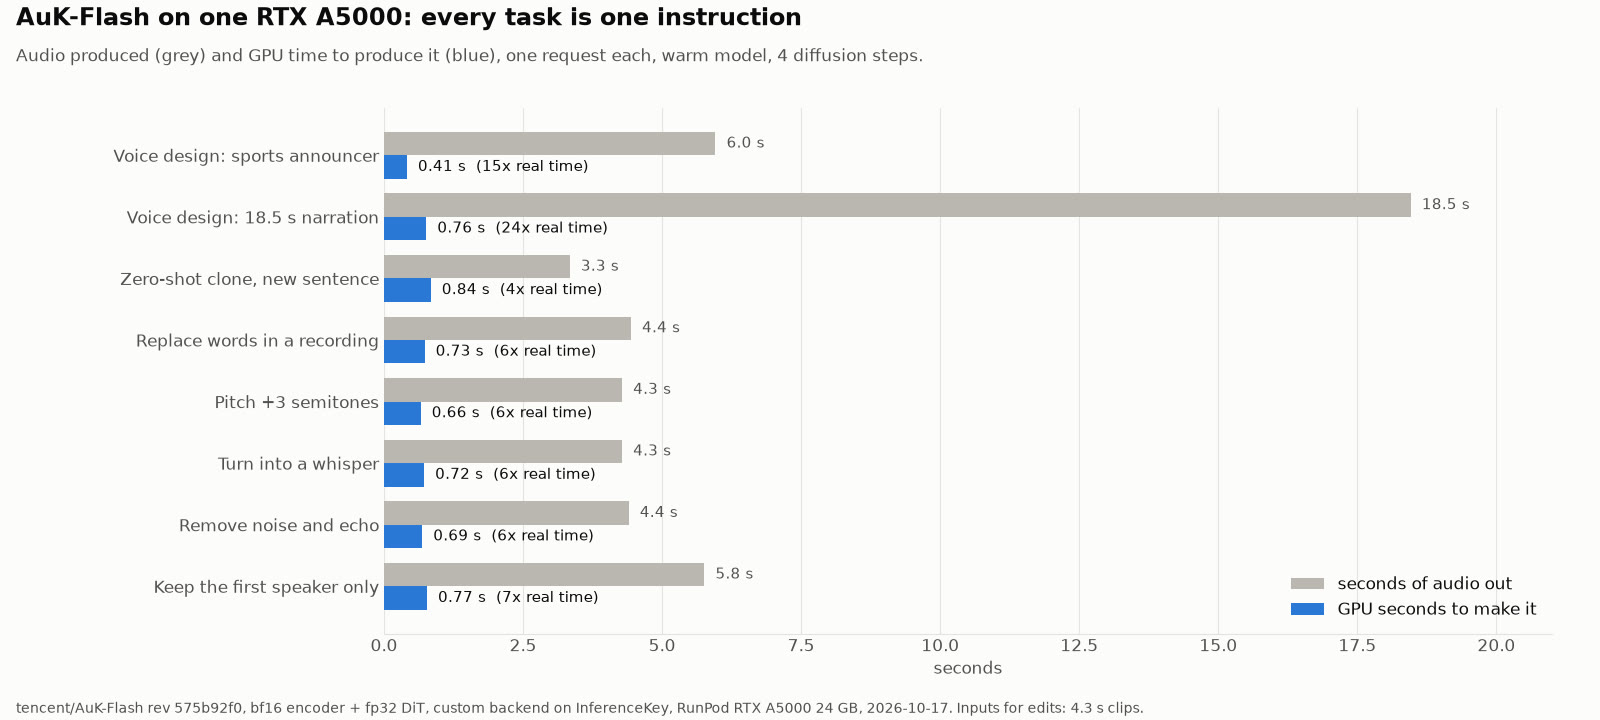
| Tempo auf einer RTX A5000 | 0.4 bis 0.8 s GPU pro Anfrage, 4- bis 24-mal schneller, als das Audio abläuft |
| Bearbeitungen | jede Bearbeitung, die wir probiert haben, ließ den Rest des Satzes Wort für Wort unverändert (per Transkript geprüft, nicht nach Gehör) |
| Schwachstellen | Stimmbeschreibungen werden manchmal laut vorgelesen, eine lange Ausgabe wiederholte eine Phrase, Spanisch kam teilweise verstümmelt heraus |
| Start | 71.6 s von der Anforderung des Modells bis bereit, sobald die gemietete GPU-Maschine mit InferenceKey verbunden war (noch nichts heruntergeladen oder installiert). Das Verbinden dieser Maschine dauerte noch einmal etwa 84 s |
Sprache, die du bearbeitest wie ein Dokument
Am besten stellst du dir AuK als Toningenieur vor, mit dem du redest. Im Studio fasst du die Fader nicht selbst an. Du sagst „die zweite Zeile etwas wärmer, und das Husten raus“, und der Toningenieur macht es. AuK steckt diesen Toningenieur in ein Modell: Du gibst ihm eine Aufnahme (oder gar nichts, wenn es bei null anfangen soll) und einen Satz, der sagt, was du willst. Das Cookbook listet die Vorlagen für Anweisungen auf, die die Autoren empfehlen, und sie lesen sich wie Notizen an einen Menschen:
Say the following with the same voice: "{text}", um eine Stimme aus einer kurzen Probe zu klonen.Replace '{original}' with '{new}'.undAdd '{text}' before '{anchor}'., um die Wörter zu ändern.Raise the pitch by 2 semitones.oderAdjust the speech speed to 1.25x.Keep only the first speaker to start talking and remove all other speakers.Preserve all speakers, remove noise and reverberation, and output clean speech of the same length.
Die Aufgabentabelle des Projekts geht weiter als das, was wir probiert haben: den Text von Gesang ohne Instrumente bearbeiten, Lautstärke, den Charakter der Stimme, einen Akzent entfernen, Atmer, Lacher und Huster hinzufügen oder entfernen, Musik abtrennen und einen Sprecher anhand dessen herausholen, was er sagt. Die Autoren beschreiben es als ein allgemeines Modell zum Erzeugen und Bearbeiten von Sprache, trainiert mit Millionen Stunden Audio.
Warum das für einen Engineer zählt: Ein Modell ist eine Sache, die man ausrollt, überwacht und aktualisiert, auf einer Grafikkarte, hinter einer Adresse. Eine neue Aufgabe ist ein neuer Satz. Der Haken: Eine Adresse ist auch eine Warteschlange. Auf einer einzelnen Karte lässt ein langer Aufräumjob die nächste Anfrage warten.
Wie es das macht
AuK hat laut technischem Bericht drei Teile. Der Encoder, ein Modell, das Text und Audio zusammen versteht (Qwen2.5-Omni vom Qwen-Team von Alibaba), liest deine Anweisung und die Eingabeaufnahme. Ein Klanggenerator, der eigentliche Kern von AuK, baut dann das neue Audio. Ein dritter Teil verwandelt das Ergebnis in normales Audio, das du abspielen kannst.
Der Generator arbeitet wie ein Maler, der von einer verschwommenen Skizze zum fertigen Bild geht. Das Basismodell AuK schärft die Skizze 32-mal nach. Bei jedem Schritt macht es zwei Versionen, eine, die deiner Anweisung folgt, und eine, die sie ignoriert, und rückt von der zweiten ab. AuK-Flash wurde darauf trainiert, in 4 Schritten mit je einer Version fertig zu werden, was die Autoren als 4.5-mal schneller gemessen haben. Der Code erzwingt dieses Rezept: Wenn du Flash um mehr Schritte oder um die zweite Version bittest, ignoriert es dich. Ein Kommentar im Quellcode warnt, dass das Wiedereinschalten der zweiten Version die Ausgabe so laut macht, dass sie verzerrt („blows up the amplitude“).
Der Trainingsdatensatz ist groß: etwa 3 Milliarden Paare aus Anweisung und Audio, 1.95 Millionen Stunden, auf Chinesisch und Englisch. Der Bericht ist von Ziyang Ma und 32 weiteren Autoren unterzeichnet.
Wie gut, nach den Zahlen der Autoren
Diese Werte stammen aus Tabelle 3 des Berichts. Wir haben sie nicht nachgemessen.
Beim Vorlesen mit einer geklonten Stimme liegt AuK-Flash bei etwa 3 von 100 Wörtern daneben (2.85%), etwas besser als das stärkste frühere System im Vergleich des Berichts (3.07%). Nur auf Englisch ist es etwa 1 Wort von 100.
Beim Ersetzen oder Einfügen von Wörtern hat AuK-Flash die Bearbeitung im Bearbeitungstest der Autoren (SpeechEditBench) 87.5-mal von 100 richtig gemacht, gegen etwa 76 beim besten früheren System der Tabelle.
Beim Säubern und Trennen von Audio nennen die Autoren ihre Ergebnisse „competitive“ (konkurrenzfähig), nicht führend. In einem Test, bei dem zwei Stimmen auseinandergezogen werden, schneidet ein Werkzeug, das nur für diese Aufgabe gebaut ist, besser ab als AuK-Flash.
Laut Bericht brauchen die besten Ergebnisse weiterhin ein separates Sprachmodell vor AuK, das die Aufgabe herausfindet und die Anfrage in die Formulierung umschreibt, mit der das Modell trainiert wurde. Wir haben keins genutzt, und das hat sich an einer Stelle gezeigt (siehe „Wie es klingt“).
Zwei Modelle zum Herunterladen, 20 GB Speicher
Eine funktionierende Installation lädt 18.75 GB herunter, weil AuK ein zweites Modell mit 12 GB braucht, um deine Anweisungen zu lesen. Die Seite von AuK-Flash allein nennt 6.8 GB. Das Video von AI Search, in dem wir die Veröffentlichung entdeckt haben (ein Nachrichtenüberblick vom 13. September), ging noch tiefer, „only like 6.12 gigabytes“, und das ist nur die Hauptdatei.
- Der Encoder kommt dazu. AuK braucht Qwen2.5-Omni-3B, um Anweisungen zu verstehen, und das wird separat heruntergeladen. Das sind 11.99 GB zusätzlich zu den 6.76 GB von AuK-Flash.
- Speicher. Auf unserer Karte belegte es direkt nach dem Laden etwa 15.6 GB und in der Spitze bei der Arbeit etwa 20.3 GB. Dafür braucht es eine 24-GB-Karte. Eine Einstellung, die einen Teil des Modells im normalen Arbeitsspeicher des Rechners hält, drückte die Spitze auf etwa 11.3 GB, aber jede Anfrage dauerte dann etwa 13 Sekunden statt unter einer. Das könnte auf eine 16-GB-Karte passen, wir haben es aber nicht auf einer laufen lassen.
- Die Lizenz. Code und Modelldateien von AuK stehen unter MIT. Qwen2.5-Omni-3B steht unter der Qwen Research Licence, die keine kommerzielle Nutzung erlaubt. Ein Nutzer hat Issue #13 eröffnet, um darauf hinzuweisen, dass die Veröffentlichung dadurch in der Praxis nicht kommerziell ist. ZhikangNiu, ein Mitwirkender des Projekts, antwortete, die MIT-Lizenz decke den eigenen Code und die Gewichte von AuK ab, sie setze keine Lizenzen Dritter außer Kraft, und das Team plane, den Encoder in einer künftigen Version durch einen mit freizügiger Lizenz zu ersetzen. Bis dahin muss ein Unternehmen, das ein Produkt auf AuK in der veröffentlichten Form baut, zuerst eine Lizenzfrage klären.
So läuft es auf InferenceKey
Die GPU und die Kosten
Wir haben AuK-Flash auf einer NVIDIA RTX A5000 mit 24 GB laufen lassen, einer Workstation-Karte, gemietet bei RunPod für 0.27 USD pro Stunde. Vier zusammen geschickte Bearbeitungen dauerten insgesamt 5.8 Sekunden. Das sind grob 2,500 Bearbeitungen pro Stunde oder etwa ein Hundertstel eines US-Cents pro Bearbeitung zum reinen GPU-Mietpreis, vor jeder Plattformgebühr. Gerechnet ist das aus einem einzigen Schub von vier Anfragen über einen Entwicklungstunnel, nicht aus einem langen Lasttest.
Das Backend, und warum ein eigenes
InferenceKey betreibt jedes Modell über einen kleinen Adapter, den wir Backend nennen. Keins der fertigen kann AuK bisher. InferenceKey kann Text-to-Audio-Modelle über vLLM-Omni betreiben, einen Open-Source-Server. Das Projekt vLLM-Omni hat ein Rezept für AuK veröffentlicht, aber für eine viel größere Rechenzentrumskarte, und wir haben es nicht mit 24 GB probiert. Also haben wir einen eigenen Adapter geschrieben: ein kleines Paket, das den Code von Tencent in einer festen Version und die Modelldateien herunterlädt, sie lädt und jede Anfrage an den Code von Tencent weiterreicht. Es nimmt eine Anweisung plus eine optionale Aufnahme an, schätzt die Ausgabelänge, wenn du keine angibst, begrenzt Ausgaben auf 30 Sekunden und lässt immer nur einen Job auf einmal auf der GPU laufen.
Die Schritte
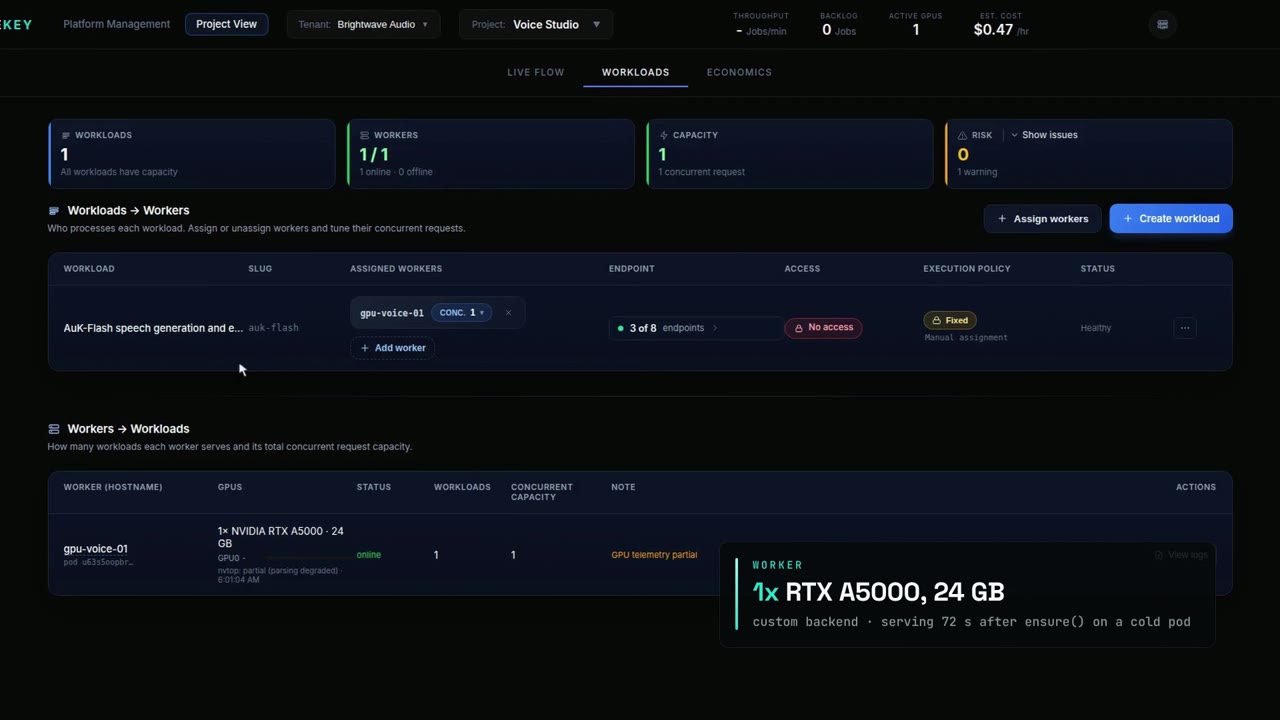
Unser Beispielcode für die Python-Bibliothek von InferenceKey erledigt das in zwei Skripten. publish.py lädt das Custom Backend einmal in dein Konto hoch. main.py bittet InferenceKey, das Modell auf deiner GPU-Maschine laufen zu lassen, und wartet, bis es bereit ist. Es nutzt die Chat-Adresse des Modells, weil unsere Text-to-Speech-Adresse bei einem Custom Adapter noch kein Audio zurückgeben kann (siehe „Was schiefging“). Dann läuft eine kurze Kette, die keine eigene Aufnahme von dir braucht: eine Stimme entwerfen, sie für einen neuen Satz klonen, „small teams“ durch „two engineers“ ersetzen, 1.25-mal schneller machen und herunterfahren. Der Kern davon:
spec = WorkloadSpec(
    name="AuK-Flash speech generation and editing",
    slug=SLUG,
    model="tencent/AuK-Flash",
    backend=BACKEND_SLUG,  # our own adapter instead of a built-in one
    task_type="text2audio",
    worker_id=os.environ["IK_WORKER_ID"],
    execution_policy=ExecutionPolicy.FIXED,
    execution_policy_config={"replicas": 1},
)
ref = mgmt.ensure(spec)
enable_chat_route(base, project, ref.workload_slug)
mgmt.wait_until_ready(ref.workload_slug, timeout=2400)

out = auk(url, key, "Replace 'small teams' with 'two engineers'.", audio=host, seed=7)
Jede Anfrage geht an die Chat-Adresse des Modells (dieselbe Art von Adresse, die ein Chatbot nutzt), mit der Anweisung als Text und, bei Bearbeitungen, mit der angehängten Aufnahme. Die Antwort kommt als Text zurück, in dem das Audio verpackt steckt, und das Beispiel macht daraus wieder eine normale WAV-Datei. Die Round Trips wurden über einen Entwicklungstunnel zur gemieteten Karte gemessen und können beim gehosteten Dienst anders ausfallen.
Was wir gemessen haben
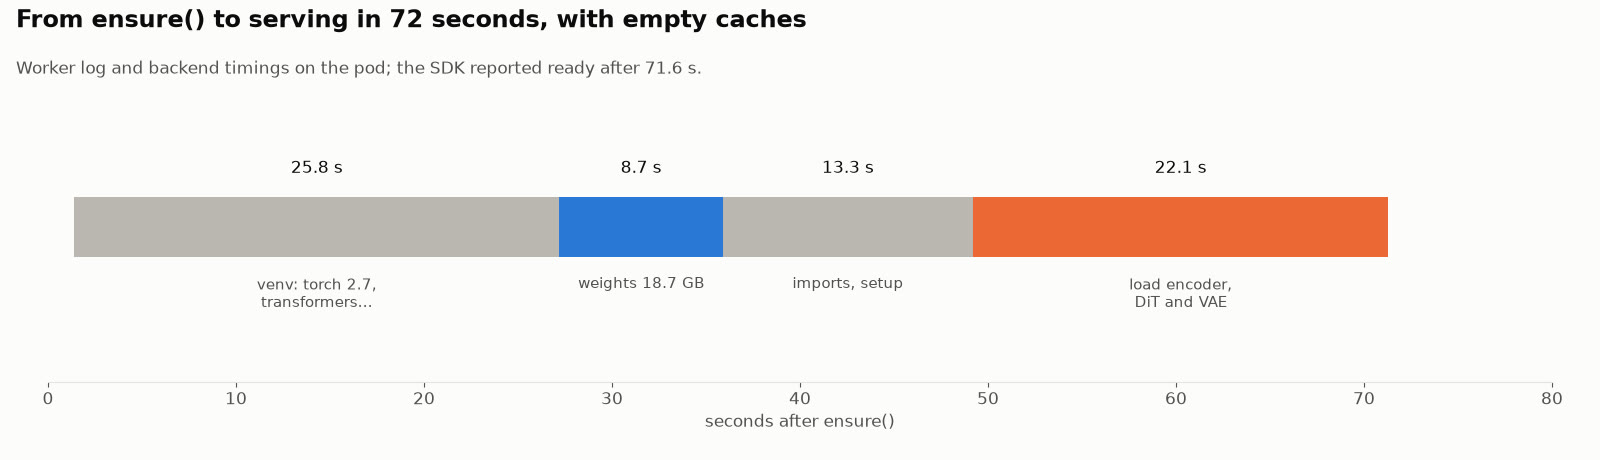
Bereit in 72 Sekunden, sobald die GPU-Maschine verbunden war. Vom Moment, in dem wir das Modell angefordert haben, bis es bereit war, vergingen 71.6 s, auf einer gemieteten Maschine, die schon mit InferenceKey verbunden war, aber noch keine Modellsoftware und keine Dateien hatte. Diese frisch gemietete Maschine zu verbinden dauerte noch einmal etwa 84 s. Die Installation der Software dauerte 25.8 s, der Download der 18.75 GB Modelldateien nur 8.7 s und das Laden des Modells auf die Karte 22.1 s. Die restlichen etwa 13 s waren Einrichtung. Ein zweiter Start, mit den Dateien schon auf der Maschine, dauerte 47.2 s.
Unter einer Sekunde GPU pro Job. Einmal warm, brauchte jede Anfrage 0.4 bis 0.8 Sekunden Zeit der Karte. Ein Sprechertext von 18.5 Sekunden brauchte 0.76 s, etwa 24-mal schneller, als er abläuft. Eine Bearbeitung von 4.4 Sekunden brauchte etwa 0.7 s. Am langsamsten war das Klonen: 0.84 s für 3.3 Sekunden Sprache, immer noch 4-mal schneller, als sie abläuft. Die allererste Anfrage nach dem Laden ist langsamer, 1.2 bis 2.3 s, während die Karte warmläuft. Mit der Netzwerkstrecke von unserer Entwicklungsmaschine zur gemieteten Karte kam eine Bearbeitung in etwa 1.3 bis 1.5 Sekunden zurück.
Etwa 20 GB Speicher in der Spitze. Das Modell belegte nach dem Laden etwa 15.6 GB des Kartenspeichers und in der stärksten Phase etwa 20.3 GB. Die speichersparende Einstellung kam in der Spitze auf etwa 11.3 GB, aber jede Anfrage dauerte dann 13 bis 15 Sekunden, länger als das Audio selbst.
Eins nach dem anderen. Vier zusammen geschickte Bearbeitungen wurden der Reihe nach beantwortet, die letzte nach 5.8 s. Das ist hier so gewollt: Das Backend lässt immer nur einen Job auf einmal auf der GPU laufen.
Wie es klingt
Um die Qualität zu prüfen, ohne uns nur auf unsere Ohren zu verlassen, haben wir jede Ausgabe mit Whisper von OpenAI (large-v3-turbo) auf derselben Maschine transkribiert und die Wörter verglichen. Die Eingabestimmen sind synthetisch, erzeugt mit Pocket TTS: saubere Sprache wie aus dem Studio, der einfachste Fall für Bearbeiten und Klonen. Echte Aufnahmen mit Raumgeräuschen, Akzenten und Leuten, die durcheinanderreden, haben wir nicht getestet. Das sind Einzelversuche, kein Hörtest.
Das Bearbeiten ist die Stärke. Jede Bearbeitung ließ den Rest des Satzes Wort für Wort unverändert. Das Transkript beweist die Wörter. Es beweist nicht, dass die Tonhöhe wirklich stieg, dass das Flüstern ein Flüstern ist oder dass sich das ersetzte Wort ohne hörbare Naht an den Rest anschließt: Dafür braucht es ein Ohr oder eine Tonhöhenmessung, und die haben wir nicht gemacht. Hör rein und urteile selbst. Hier das Original und was herauskam:
- Original (synthetische Stimme): „Our quarterly revenue grew by twelve percent, and the new office opens in March.“
- 'twelve percent' durch 'eighteen percent' ersetzen (0.73 s GPU)
- 'almost' vor 'twelve percent' einfügen (0.76 s GPU)
- Tonhöhe um 3 Halbtöne anheben (0.66 s GPU)
- In ein Flüstern verwandelt (0.72 s GPU)
Säubern und Trennen. Wir haben der Aufnahme Rauschen und Hall hinzugefügt und um saubere Sprache gebeten. Das Transkript blieb gleich, was beweist, dass die Wörter überlebt haben. Wie sauber das Ergebnis ist, misst es nicht, das musst du nach Gehör beurteilen. Für die Trennung haben wir zwei Stimmen übereinandergelegt, und der ganze Satz des zweiten Sprechers verschwand aus der Ausgabe.
- Vorher: derselbe Satz mit hinzugefügtem Rauschen und Hall
- Nachher: „remove noise and reverberation“ (0.69 s GPU)
- Vorher: zwei Stimmen, die durcheinanderreden
- Nachher: „keep only the first speaker“ (0.77 s GPU)
Neue Stimmen und die Kopie einer Stimme. Das Stimmdesign beginnt mit einer schriftlichen Beschreibung und ganz ohne Audio. Das Klonen nimmt die Stimme des ursprünglichen Umsatz-Clips und lässt sie etwas sagen, was sie nie gesagt hat.
- Stimmdesign: ein Sportkommentator, „And she crosses the line first, a new course record by almost four seconds.“ (0.41 s GPU)
- Stimmdesign: ein Dokumentarfilm-Sprechertext von 18.5 s über einen Fluss (0.76 s GPU)
- Klon der Stimme aus dem Umsatz-Clip, aus dieser einen Probe und ohne Training: „The board approved the budget, and hiring starts next quarter.“ (0.84 s GPU)
Wie nah der Klon an der Originalstimme liegt, haben wir nicht gemessen.
Das Stimmdesign hängt von der Formulierung ab. Formuliert als Based on the following description: "...", generate speech content "...". (das Kommandozeilenbeispiel des Projekts, das unseres nutzt), kamen 7 von 8 englischen Stimmdesigns genau richtig heraus. Das achte, der Sprechertext von 18.5 Sekunden bei einem weiteren Versuch, wiederholte „the river begins as snow on the high peaks“ und ließ die nächste Phrase weg. Formuliert als Generate speech based on the following description: "...". The content to speak is: "...". (die englische Vorlage des Cookbooks), las das Modell in 8 von 8 Versuchen einen Teil der Beschreibung laut vor („A sports chatty excited, and she crosses the line first...“). Das passt zu dem, was der Bericht über das vorherige Umschreiben von Anfragen sagt: Die Formulierung zählt.
- Die Vorlage des Cookbooks: Die Beschreibung rutscht in die Sprache
Spanisch ist noch nicht so weit. AuK ist auf Chinesisch und Englisch trainiert. Ein spanischer Satz kam teilweise verstümmelt heraus. Ein Nutzer im Repo hat dasselbe für Polnisch gemeldet (Issue #17). Auf den Rat eines Mitwirkenden des Projekts hin hat derselbe Nutzer AuK-Base später mit etwa 100 Stunden polnischer Aufnahmen weitertrainiert und es zum Laufen gebracht.
- Spanisches Stimmdesign, teilweise verstümmelt
Schreien ist vielleicht eine Lücke. Ein Nutzer berichtet, dass AuK Schreien oder Brüllen aus einer Referenzaufnahme nicht nachbilden kann (Issue #23). Das Issue ist noch offen, und wir haben es nicht getestet.
Bei etwa 60 Anfragen gab es keine Abstürze, und keine kam kaputt zurück.
Das Demovideo
Das Video zeigt das Modell auf der RTX A5000 im Dashboard von InferenceKey, dann ein Terminal, das um das Ersetzen der Zahl bittet (4.44 s Audio, 0.71 s GPU, 1.4 s Round Trip), die Stimme des Kommentators und das Entfernen des Rauschens, mit dem Audio von vorher und nachher in die Tonspur gemischt, damit du es hören kannst.
Was schiefging
- Die Text-to-Speech-Adresse funktioniert nicht mit Custom Backends. Die naheliegende Adresse für dieses Modell, die normale Text-to-Speech-Adresse, gab einen Fehler statt Audio zurück. Unsere Plattform gibt auf dieser Adresse noch kein Audio aus einem selbst gebauten Adapter zurück. Das ist eine Lücke auf unserer Seite. Der Workaround ist die Chat-Adresse, die wir für dieses Modell einschalten mussten. Die Antwort kommt dann als Text mit dem darin verpackten Audio an, nicht als einfache Audiodatei. Das Beispiel macht beides.
- Der erste Start stürzte beim Download ab. Zwei Downloads liefen gleichzeitig, und ihre Fortschrittsbalken kamen sich in die Quere. Die Fortschrittsbalken abzuschalten hat es behoben.
- Ein fehlendes Paket. Die erste Audioanfrage schlug fehl, weil eine Bibliothek, die der Encoder zum Lesen von Audiodateien braucht (
audioread), nicht installiert war. Wir haben sie zu den Requirements hinzugefügt.
Wer was gemacht hat
Das AuK-Team, Ziyang Ma und 32 Mitautoren von der Shanghai Jiao Tong University, von Tencent Hunyuan und vom Shanghai Innovation Institute, hat AuK und AuK-Flash gebaut, den technischen Bericht und das Cookbook geschrieben und Code und Modelldateien unter MIT veröffentlicht. Nach der Veröffentlichung hat es eine Testversion auf Macs mit Apple Silicon zum Laufen gebracht, es auf kleineren Karten lauffähig gemacht, den Speicherbedarf des Encoders um etwa 8 GB gesenkt und veröffentlicht, wie die schnelle Version trainiert wurde. Andere Open-Source-Projekte, die Modelle in Produktion betreiben, haben ihren eigenen Teil beigetragen: SGLang-Omni hat AuK am Tag der Veröffentlichung unterstützt, vLLM-Omni hat zwei Tage später ein Rezept ergänzt, und audio.cpp von 0xShug0 betreibt AuK als GGUF in einer reinen C++-Engine ohne Python. Das Qwen-Team von Alibaba hat Qwen2.5-Omni gebaut, den Encoder, über den AuK zuhört. Pocket TTS von Kyutai hat die synthetischen Stimmen erzeugt, die wir als Eingabe genutzt haben, und Whisper von OpenAI hat unsere Transkriptionsprüfungen erledigt. Beitragende in den Issues des Repos haben die Lizenzfrage, die polnischen Ergebnisse und den Bericht über das Schreien eingebracht, und Mitwirkende des Projekts haben öffentlich geantwortet. Die Person, die die polnischen Ergebnisse gemeldet hat, hat danach eine funktionierende polnische Version trainiert. Auf die Veröffentlichung sind wir im Nachrichtenvideo von AI Search gestoßen.
Unser Teil war das Custom Backend, das den Inferenzcode von Tencent in InferenceKey bringt, das SDK-Beispiel, der Lauf von Anfang bis Ende auf einer RTX A5000 und die Messung von Startzeit, Speicher, Tempo pro Aufgabe und davon, ob die Wörter jede Bearbeitung überstanden haben.
Was du mitnehmen kannst
Auf einer 24-GB-Karte ließ jede Bearbeitung, die wir probiert haben, den Rest des Satzes Wort für Wort unverändert: ein Wort geändert, ein Wort hinzugefügt, ein zweiter Sprecher entfernt, jedes in unter einer Sekunde GPU-Zeit. Ein Modell hinter einer Adresse hat in unserem Test die Arbeit von fünf Werkzeugen erledigt, eine Anfrage nach der anderen. Ob es mit jedem spezialisierten Werkzeug mithält, ist der Benchmark der Autoren, nicht unserer, und in einem Trennungstest schlägt ein dediziertes Modell AuK-Flash. Die Grenzen sind genauso konkret. Es braucht in der Spitze etwa 20 GB Speicher. Es spricht Chinesisch und Englisch. Das Stimmdesign reagiert empfindlich auf die Formulierung. Unsere Prüfungen waren etwa 60 Anfragen, meist mit einem Versuch je Fall, mit synthetischen Stimmen und ohne Hörpanel.
Über die meisten geschäftlichen Einsätze entscheidet heute die Lizenz des Encoders. Das Team hat angekündigt, einen Encoder mit freizügiger Lizenz einbauen zu wollen, und bis dahin ist Issue #13 der Thread, den man im Auge behalten sollte.
Für Engineers
Modell (Card von AuK-Flash, Card von AuK, Repo, Cookbook, arXiv 2609.08936, Projektseite). tencent/AuK-Flash sha 575b92f0, zuletzt geändert am 2026-09-09, nicht gated, MIT, 6,762,642,715 B gespeichert: auk_flash.safetensors 6,122,209,092 B (fp32 DiT), vae.safetensors 637,322,604 B. tencent/AuK (Basis, auk_base.safetensors) gleicher Speicherbedarf. README und HF-Cards sagen MIT (die GitHub-API meldet NOASSERTION). 1,524 GitHub-Sterne, AuK-Flash 1,599 Downloads und 107 Likes, AuK 2,695 Downloads und 389 Likes (2026-10-17). HF-Sprachen: zh, en. Upstream-Zeitleiste (News im README): MLX auf Apple Silicon im Branch feat/mlx-apple-silicon und CUDA-CPU-Offload 2026-09-13, PR #19 Speicher des Encoders 2026-09-16, Trainingspipeline für die Destillation 2026-10-14 (PR #22).
Architektur (Abschnitt 4.2 des Berichts). Qwen2.5-Omni als semantischer MLLM-Encoder mit schichtweise aggregierten Hidden States; Audio-VAE trainiert auf Sprache, allgemeinem Audio und Musik (Latents mit 50 Hz, 64 Dimensionen, Ausgabe mit 24 kHz); hybrider Rectified-Flow-Transformer, 30 Schichten = 10 Dual-Stream-MMDiT + 20 Single-Stream-DiT, Hidden 1536, 24 Heads, etwa 1.5B Parameter. Encoder und VAE eingefroren. Training: etwa 3.03B Instanzen aus Anweisung und Audio, 1.95M Stunden effektive Supervision, fünf Aufgabenfamilien. AuK-Flash: Consistency-Initialisierung plus aufgabengeroutetes Decoupled DMD, 4 Schritte, CFG-frei, 4.5x Wall Clock gegenüber dem Teacher mit 32 NFE und CFG 2.0. src/auk/infer/infer_auk.py @ 9481474f erkennt Flash am Namen der Config und fixiert es auf 4 Schritte, CFG 0, t-Raster [0, 0.0761, 0.2929, 0.6173, 1], und ignoriert die Sampling-Regler des Aufrufers. Standardwerte der Basis: nfe 32, cfg_strength 2.0.
Tabelle 3 des Papers (Zahlen der Autoren). Seed-TTS-Eval mittlere WER: AuK 2.65, AuK-Flash 2.85, Qwen3-TTS 3.07, Seed-TTS 3.65, VoxCPM2 3.65. Mittlere SIM: AuK 0.795, Flash 0.790, Seed-TTS 0.778. EN WER: AuK 1.02, Flash 1.03, Qwen3-TTS 1.23. MMAE(Speech) EMR: Flash 13.85, AuK 12.44, Ming-UniAudio 7.04, Step-Audio-EditX 4.69. SpeechEditBench Content ACC: Flash 87.50, AuK 91.83, Ming-UniAudio 76.46, Step-Audio-EditX 16.50. DNS Challenge dWER: Flash 2.93, AuK 2.66, RE-USE 3.31. Libri2Mix WER: Flash 10.07, AuK 9.12, MossFormer2-SS 9.34.
VRAM laut Upstream. Tabelle im README (A800, bf16, max_memory_allocated): AuK-Flash 24.77 GiB nur Text mit 1.5 s Ausgabe, 16.75 GiB mit --cpu_offload; 24.97 / 16.98 GiB mit 5 s Referenzaudio. Diese Tabelle ist älter als PR #19 (gemergt am 2026-09-16), der nur den DiT nach fp32 castet und Qwen in bf16 belässt, etwa 7.5 GiB weniger (Qwen 7.515 GiB in bf16, 15.031 GiB hochgecastet).
Unser Setup. RunPod RTX A5000 24,564 MiB, SECURE, CA-MTL-1, 0.27 USD/h (RTX 4090 COMMUNITY antwortete mit 409), Treiber 580.178.04 (CUDA 13.0), Limit 230 W, Compute 8.6, 7.65 CPUs laut cgroup, 503 GB Host-RAM, Python 3.12.3, 100.7 MB/s mit curl über einen einzelnen Stream von huggingface.co. In einer vom Kaltstart unten getrennten Messung wurde der Worker von einem lokalen InferenceKey-Manager über HTTP- und TCP-Tunnel in 84 s nach dem POST des Pods eingerichtet (ssh nach 38.5 s, Worker-Binary mit 25,243,632 B per SFTP in 14.8 s).
Backend. Custom Python Backend auk-flash-speech 0.1.3, Task-Typ text2audio. Pins: AuK 9481474f107ee4d8dec959b3aed05b0627cebbf8, AuK-Flash 575b92f0, Qwen2.5-Omni-3B f75b40e3 (nur Thinker). AukInfer(config, ckpt, dtype="bf16", qwen_path=...). max_gen_seconds 30, chars_per_second 14 für die Längenschätzung, Overrides per Env AUK_*, AukFlashOffloadBackend setzt cpu_offload=True. Gibt audio_b64 (16-Bit-WAV, 24 kHz mono), seconds, timings {gpu_s, total_s, realtime_factor, peak_vram_mib} zurück. GPU-Aufruf unter einem Lock. publish.py paketiert mit requires_python >=3.10,<3.13. README des Beispiels: Eingaben unter etwa 15 s halten, um unter dem Limit der Plattform von 2 MB für den Request Body zu bleiben; torch 2.7 von PyPI ist der Build für CUDA 12.6, der Treiber muss also CUDA 12.6+ unterstützen. Hinweis: .env.example des Beispiels sagt „about 17 GB of free VRAM“; die gemessene Spitze in nvidia-smi war 19,390 MiB, plan also eine 24-GB-Karte ein. Commit des SDK-Beispiels aa7e900 auf inferencekey-sdk main.
Kaltstart. ensure() bis SDK bereit 71.6 s mit leeren Caches für HF, uv und venv: venv 25.8 s (torch 2.7, transformers 4.57), Downloads 8.7 s für 18.75 GB, etwa 13 s Imports und Einrichtung, Laden 22.1 s (setup_s 44.1, vram_loaded_mib 14,305). Gewichte im Cache und warmer uv-Cache: 47.2 s. Mit vorhandenem venv: 36.1 s und 19.8 s.
VRAM (nvidia-smi -l 1). 14,837 MiB nach dem Laden, 19,390 MiB Spitze im Betrieb, torch max_memory_allocated 17,309 bis 17,964 MiB pro Anfrage. Offload-Variante: 1,571 MiB im Leerlauf, 10,755 MiB Spitze, 12.7 bis 15.2 s GPU pro Anfrage (0.3x bis 0.5x Echtzeit), nicht auf einer 16-GB-Karte getestet. Spitzenleistung 181 W.
Pro Anfrage (warm, Seed 7, /v1/chat/completions ohne Streaming, CLI-Vorlage, wenn nicht anders angegeben; GPU-Zeit ist das synchronisierte gpu_s des Backends, Round Trip vom Client über den Tunnel gemessen):
| Fall | Eingabe | Ausgabe s | GPU s | x Echtzeit | Round Trip s | Whisper sagt |
|---|---|---|---|---|---|---|
| Stimmdesign, Kommentator | keine | 5.96 | 0.41 | 14.5 | 0.76 | exakter Text |
| Stimmdesign, Sprechertext 18.5 s | keine | 18.46 | 0.76 | 24.3 | 1.23 | exakter Text |
| Zero-Shot-Klon, neuer Satz | Clip 4.3 s | 3.34 | 0.84 | 4.0 | 1.81 | exakter Text |
| „twelve percent“ durch „eighteen percent“ ersetzen | 4.3 s | 4.44 | 0.73 | 6.1 | 1.53 | "...grew by 18%, and..." |
| „almost“ einfügen | 4.3 s | 4.80 | 0.76 | 6.3 | 1.49 | "...grew by almost 12%..." |
| Tonhöhe +3 Halbtöne | 4.3 s | 4.28 | 0.66 | 6.5 | 1.39 | Text unverändert |
| Emotion: aufgeregt | 4.3 s | 4.28 | 0.68 | 6.3 | 1.27 | Text unverändert |
| Flüstern | 4.3 s | 4.28 | 0.72 | 5.9 | 1.33 | Text unverändert |
| Entrauschen + Enthallen | 4.4 s | 4.40 | 0.69 | 6.4 | 1.29 | Text unverändert |
| Ersten Sprecher behalten | 5.8 s | 5.76 | 0.77 | 7.5 | 1.40 | nur der Satz von Sprecher 1 |
| Spanisches Stimmdesign | keine | 6.96 | 0.43 | 16.3 | 0.79 | teilweise verstümmelt |
Erste Anfrage nach einem kalten Laden: 1.23 bis 2.30 s GPU für ein Stimmdesign von 6.1 s. Overhead der Plattform (Round Trip minus GPU) etwa 0.3 bis 1.0 s bei Bearbeitungen, da Anfrage und Antwort je ein WAV in base64 tragen. Vier parallele Bearbeitungen: Wall Time 5.82 s, Round Trips 1.42, 2.92, 4.46, 5.81 s (Concurrency der Zuweisung 1 plus der Lock des Backends), alle vier Ausgaben korrekt. Tempo 1.25x: 6.10 s auf 4.88 s. Die „grob 2,500 Bearbeitungen pro Stunde“ im Text sind 3,600 / (5.82 / 4), eine Hochrechnung aus diesem einen Schub von vier über einen Dev-Tunnel; ein Lauf unter Dauerlast wurde nicht gemacht.
Qualitätsprüfung. openai/whisper-large-v3-turbo auf dem Pod. Vorlagen für das Stimmdesign: die EN-Vorlage des Cookbooks Generate speech based on the following description: "...". The content to speak is: "...". ließ in 8 von 8 Ausgaben Wörter der Beschreibung durchrutschen (4 plus 4 mit kürzerem gen_seconds); die CLI-Vorlage Based on the following description: "...", generate speech content "...". ergab 7 von 8 exakt, die Ausgabe von 18.5 s mit Seed 8 wiederholte eine Phrase und ließ „every spring it melts“ weg. Das Cookbook sagt, gen_seconds sei für Aufgaben zu übergeben, die eine explizite Ausgabelänge brauchen (TTS, Bearbeiten des Inhalts, Tempo), und die Eingabe für das Bearbeiten von Liedtexten müsse a cappella sein.
Probleme der Plattform. (1) /v1/audio/speech mit einem Custom Backend gibt HTTP 500 „worker returned no payload for passthrough route“ zurück: Der Worker gibt JSON eines Custom Backends nur bei den Arten Transkription, Embeddings, Rerank, Forecast und Bild als Binärdaten weiter (needs_json_binary_surfacing in crates/worker/src/jobs.rs), und das Passthrough des Managers verlangt binary_b64. Workaround: PATCH /api/workloads/<id>/endpoint_settings/chat {"enabled":true} und /v1/chat/completions, dessen Message Content das JSON des Backends als String ist. (2) tqdm-Race zwischen zwei parallelen Aufrufen von snapshot_download (AttributeError: type object 'tqdm' has no attribute '_lock'), behoben mit HF_HUB_DISABLE_PROGRESS_BARS=1 in 0.1.1. (3) No module named 'audioread' bei der ersten Audioanfrage (der Client sah HTTP 503 backend_unavailable), behoben in 0.1.2. (4) Feste Workloads starten mit Concurrency 1. (5) Kosmetik im Panel: Access „No access“ mit einem funktionierenden Wildcard-Key, „GPU telemetry partial“.
Bekannte Grenzen upstream. Issue #13 (offen): Lizenz des Encoders. Issue #17 (offen): Zero-Shot-Polnisch mit einer Median-WER von etwa 80% gegen 23% für Englisch; derselbe Melder hat AuK-Base später mit 103.65 h polnischem MLS feinabgestimmt und 3.3% mittlere CER erreicht. Issue #23 (offen): Ein Nutzer berichtet, dass AuK und AuK-Flash Schreien aus einer Referenz nicht nachbilden. Die ComfyUI-Integration hat ein Budget von 30 s für Quelle plus Ziel.
Grenzen. Etwa 60 eigene Anfragen, meist mit je einem Seed, synthetische Eingabestimmen, keine Metrik für Sprecherähnlichkeit, kein Hörtest, Entrauschen nur auf Erhalt des Inhalts geprüft. Nicht getestet: Bearbeiten von Liedtexten, Lautstärke, Timbre, Akzententfernung, nonverbale Bearbeitungen, Musiktrennung, Extraktion eines Zielsprechers, Entfernen von Wörtern, AuK Basis, die Offload-Variante auf einer echten 16-GB-Karte, der Prompt Enhancer. Die Benchmark-Zahlen sind die der Autoren (SpeechEditBench Content Accuracy: AuK-Flash 87.50 gegen Ming-UniAudio 76.46; Seed-TTS-Eval mittlere WER 2.85 gegen Qwen3-TTS 3.07), von uns nicht nachgemessen.
Quellen: AuK-Flash, AuK, GitHub, Cookbook, technischer Bericht, Projektseite, Lizenz von Qwen2.5-Omni-3B, SDK-Beispiel, Demovideo, Video von AI Search.