AuK-Flash : un modèle ouvert qui écrit, clone et retouche la voix, testé sur une carte de 24 GB
AuK-Flash de Tencent génère, clone et retouche la voix sur une seule instruction. Sur une RTX A5000 louée, chaque retouche a pris moins d'une seconde de GPU.
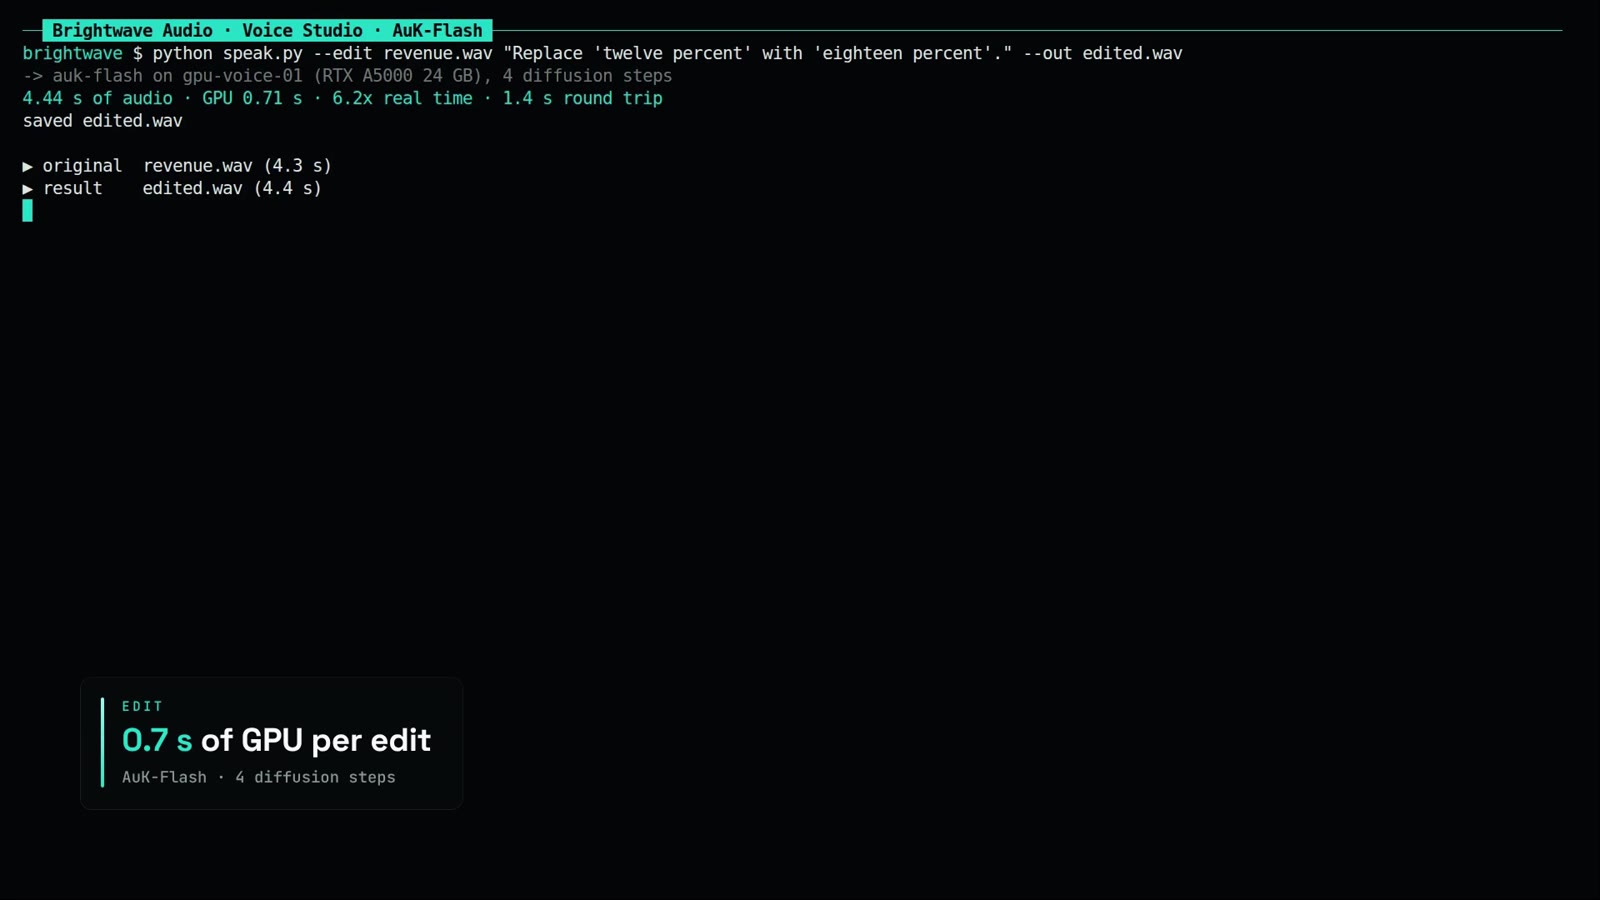
L'enregistrement dit "Our quarterly revenue grew by twelve percent, and the new office opens in March." (notre chiffre d'affaires trimestriel a augmenté de douze pour cent, et le nouveau bureau ouvre en mars). Nous l'avons envoyé à un modèle vocal avec une seule ligne d'instruction (Replace 'twelve percent' with 'eighteen percent'.) et nous avons récupéré la même voix qui disait dix-huit. La carte graphique (GPU), une NVIDIA RTX A5000 louée, y a passé 0,73 seconde.
Le modèle s'appelle AuK-Flash, la version rapide d'AuK, publiée le 9 septembre par des chercheurs de l'université Jiao Tong de Shanghai, de Tencent Hunyuan et du Shanghai Innovation Institute. Le même modèle, piloté par le même genre d'instruction en anglais courant, sait aussi inventer une voix à partir d'une description écrite, copier une voix à partir de quelques secondes d'audio, changer la hauteur, la vitesse et l'émotion, transformer la parole en chuchotement, nettoyer le bruit et l'écho, et isoler un locuteur dans une conversation. Aujourd'hui, cela demande d'habitude une pile d'outils séparés : un pour lire du texte à voix haute, un pour cloner des voix, un éditeur, un outil de suppression du bruit et un séparateur de locuteurs. Ici, c'est un seul modèle, et un ingénieur peut le mettre derrière une seule adresse et changer de tâche en changeant la phrase. Le code et les fichiers du modèle entraîné sont sous licence MIT, qui autorise l'usage commercial. AuK a aussi besoin d'un second modèle, Qwen2.5-Omni-3B d'Alibaba, dont la licence n'autorise pas l'usage commercial.
Ce qu'il faut en retenir :
| Quoi | Résultat |
|---|---|
| Modèle | AuK-Flash, la version rapide d'AuK : 1,5B paramètres (la taille du modèle, assez petite pour une seule carte). Il construit chaque clip en 4 passes au lieu de 32, ce que les auteurs ont mesuré comme 4,5 fois plus rapide |
| Tâches dans un seul modèle | voix à partir d'une description, clonage de voix, remplacer ou insérer des mots, hauteur, vitesse, émotion, chuchotement, suppression du bruit et de l'écho, garder un seul locuteur, et d'autres que nous n'avons pas testées |
| Téléchargement | 18,75 GB au total : 6,76 GB pour AuK-Flash, plus un modèle obligatoire de 12 GB qui lit votre instruction (Qwen2.5-Omni-3B, l'"encodeur") |
| Mémoire en service | environ 20 GB au pic, donc il faut une carte de 24 GB. Environ 11 GB avec un réglage plus lent qui gare une partie du modèle dans la mémoire normale |
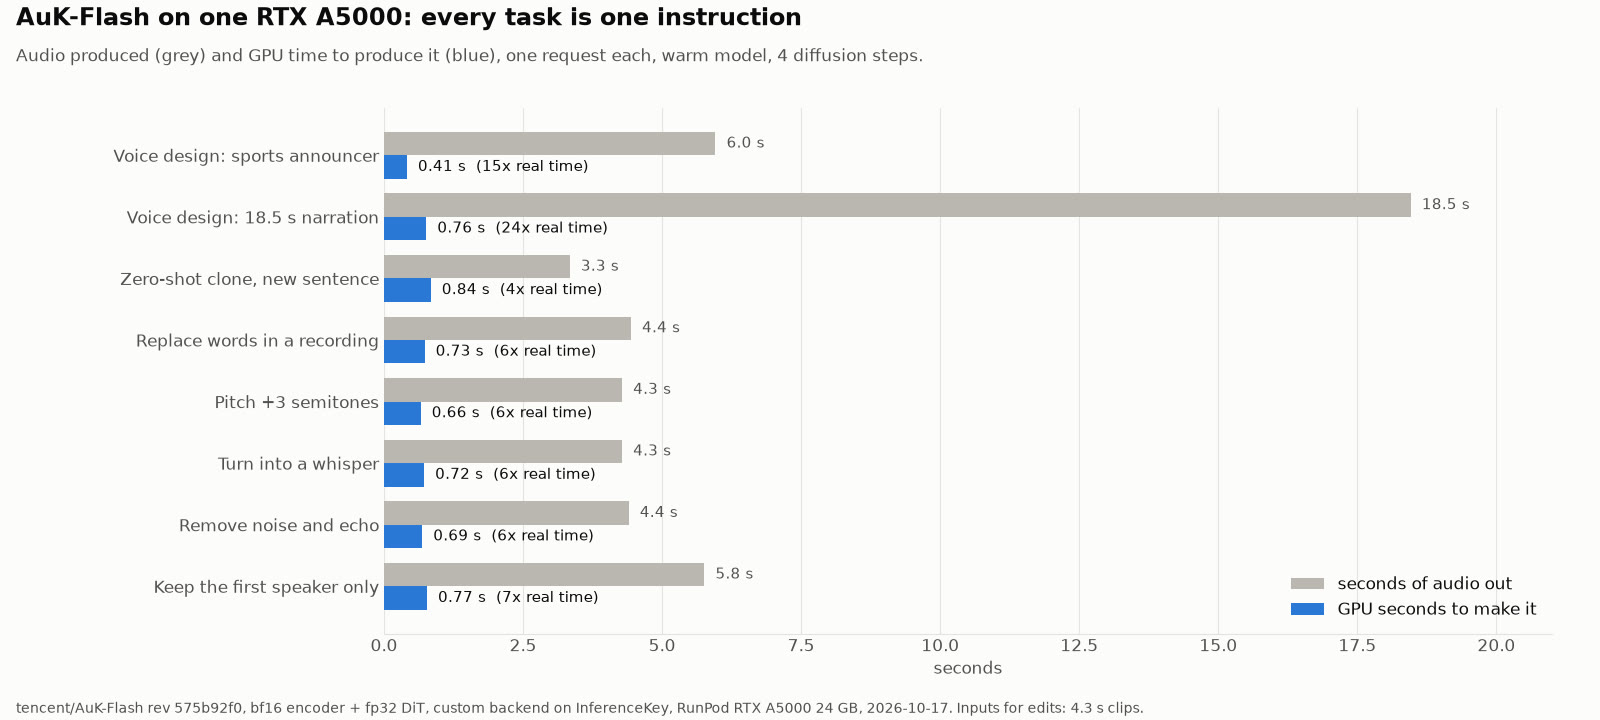
| Vitesse sur une RTX A5000 | 0,4 à 0,8 s de GPU par requête, 4 à 24 fois plus vite que la durée de l'audio |
| Retouches | chaque retouche essayée a gardé le reste de la phrase mot pour mot (vérifié par transcription, pas à l'oreille) |
| Points faibles | les descriptions de voix sont parfois lues à voix haute, une sortie longue a répété une phrase, l'espagnol est sorti en partie brouillé |
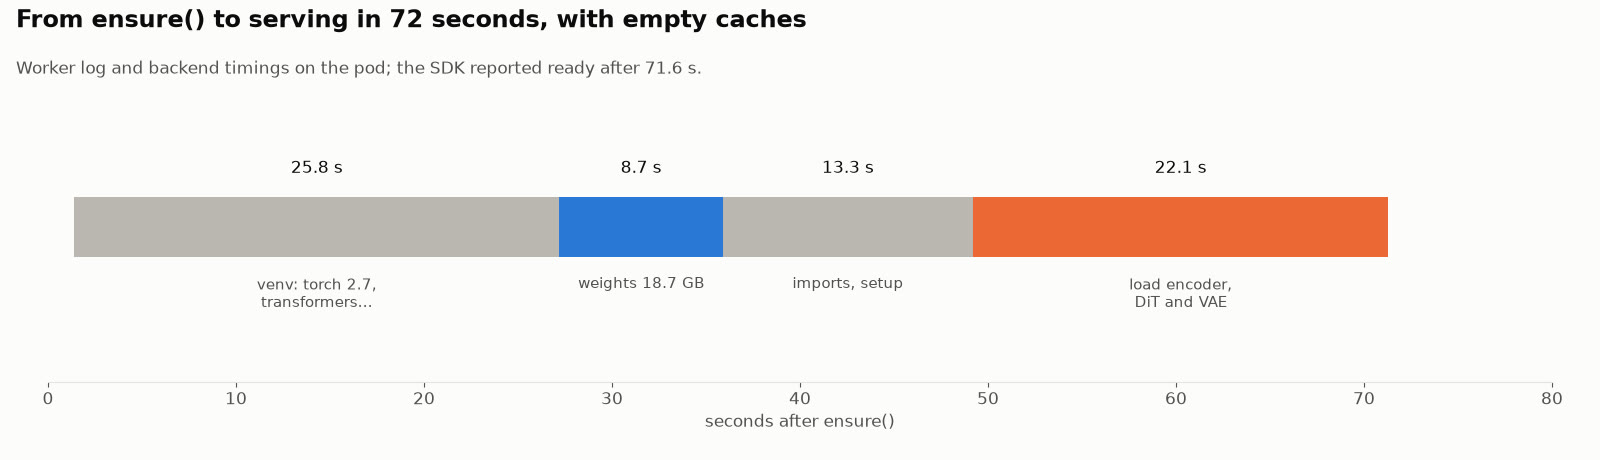
| Démarrage | 71,6 s entre la demande du modèle et l'état prêt à servir, une fois la machine GPU louée connectée à InferenceKey (rien de téléchargé ni d'installé à ce stade). Connecter cette machine a pris environ 84 s de plus |
Une voix qu'on retouche comme un document
La bonne façon de voir AuK, c'est un ingénieur du son à qui l'on parle. En studio, vous ne touchez pas les faders vous-même. Vous dites "la deuxième ligne, un peu plus chaude, et enlève cette toux", et l'ingénieur s'en charge. AuK met cet ingénieur dans un modèle : vous lui donnez un enregistrement (ou rien, s'il doit partir de zéro) et une phrase qui dit ce que vous voulez. Le cookbook liste les modèles d'instructions que recommandent les auteurs, et ils se lisent comme des notes laissées à quelqu'un :
Say the following with the same voice: "{text}"pour cloner une voix à partir d'un court échantillon.Replace '{original}' with '{new}'.etAdd '{text}' before '{anchor}'.pour changer les mots.Raise the pitch by 2 semitones.ouAdjust the speech speed to 1.25x.Keep only the first speaker to start talking and remove all other speakers.Preserve all speakers, remove noise and reverberation, and output clean speech of the same length.
Le tableau des tâches du projet va plus loin que ce que nous avons essayé : modifier les paroles d'un chant sans instruments, le volume, le caractère de la voix, supprimer un accent, ajouter ou enlever des respirations, des rires et des toux, séparer la musique, et isoler un locuteur d'après ce qu'il dit. Les auteurs le décrivent comme un modèle général pour créer et retoucher la parole, entraîné sur des millions d'heures d'audio.
Pourquoi c'est important pour un ingénieur : un seul modèle, c'est une seule chose à déployer, surveiller et mettre à jour, sur une seule carte graphique, derrière une seule adresse. Une nouvelle tâche, c'est une nouvelle phrase. Le revers, c'est qu'une seule adresse est aussi une seule file d'attente : sur une seule carte, un long travail de nettoyage fait attendre la requête suivante.
Comment il s'y prend
AuK a trois parties, d'après le rapport technique. L'encodeur, un modèle qui comprend à la fois le texte et l'audio (Qwen2.5-Omni, de l'équipe Qwen d'Alibaba), lit votre instruction et l'enregistrement d'entrée. Un générateur de son, la partie qui est AuK à proprement parler, construit ensuite le nouvel audio. Une troisième pièce transforme le résultat en audio ordinaire que l'on peut écouter.
Le générateur travaille comme un peintre qui passe d'une esquisse floue à un tableau fini. L'AuK de base précise l'esquisse 32 fois. À chaque étape, il fait deux versions, une qui suit votre instruction et une qui l'ignore, et s'éloigne de la seconde. AuK-Flash a été entraîné pour finir en 4 étapes avec une seule version à chaque fois, ce que les auteurs ont mesuré comme 4,5 fois plus rapide. Le code impose cette recette : si vous demandez à Flash plus d'étapes ou la seconde version, il vous ignore. Un commentaire dans le code source prévient que réactiver la seconde version rend la sortie si forte qu'elle sature ("blows up the amplitude", fait exploser l'amplitude).
Le jeu d'entraînement est vaste : environ 3 milliards de paires instruction et audio, 1,95 million d'heures, en chinois et en anglais. Le rapport est signé par Ziyang Ma et 32 autres auteurs.
Quelle qualité, d'après les chiffres des auteurs
Ces scores viennent de la Table 3 du rapport. Nous ne les avons pas reproduits.
En lecture à voix haute avec une voix clonée, AuK-Flash se trompe sur environ 3 mots sur 100 (2,85 %), un peu mieux que le meilleur système antérieur de la comparaison du rapport (3,07 %). En anglais seul, c'est environ 1 mot sur 100.
Quand on lui demande de remplacer ou d'insérer des mots, AuK-Flash a réussi la retouche 87,5 fois sur 100 au test de retouche des auteurs (SpeechEditBench), contre environ 76 pour le meilleur système antérieur du tableau.
Pour le nettoyage et la séparation de l'audio, les auteurs qualifient leurs résultats de "competitive" (compétitifs), pas de meilleurs. Sur un test qui consiste à séparer deux voix, un outil conçu uniquement pour cette tâche fait mieux qu'AuK-Flash.
Le rapport indique que les meilleurs résultats demandent encore un modèle de langage séparé devant AuK, pour identifier la tâche et réécrire la demande dans la formulation sur laquelle le modèle a été entraîné. Nous n'en avons pas utilisé, et cela s'est vu à un endroit (voir "À quoi ça ressemble à l'écoute").
Deux modèles à télécharger, 20 GB de mémoire
Une installation qui fonctionne télécharge 18,75 GB, parce qu'AuK a besoin d'un second modèle de 12 GB pour lire vos instructions. La page d'AuK-Flash seule indique 6,8 GB. La vidéo d'AI Search où nous avons repéré la sortie (une revue d'actualité publiée le 13 septembre) descendait encore plus bas, "only like 6.12 gigabytes" (seulement environ 6,12 gigaoctets), ce qui correspond au fichier principal seul.
- L'encodeur s'ajoute. AuK a besoin de Qwen2.5-Omni-3B pour comprendre les instructions, téléchargé à part. Cela fait 11,99 GB en plus des 6,76 GB d'AuK-Flash.
- La mémoire. Sur notre carte, il utilisait environ 15,6 GB juste après le chargement et environ 20,3 GB au pic en plein travail. Il faut donc une carte de 24 GB. Un réglage qui garde une partie du modèle dans la mémoire normale de l'ordinateur a fait descendre le pic à environ 11,3 GB, mais chaque requête prenait alors environ 13 secondes au lieu de moins d'une. Cela pourrait tenir sur une carte de 16 GB, mais nous ne l'avons pas fait tourner sur une telle carte.
- La licence. Le code et les fichiers du modèle d'AuK sont sous MIT. Qwen2.5-Omni-3B est sous Qwen Research Licence, qui n'autorise pas l'usage commercial. Un utilisateur a ouvert l'issue #13 pour faire remarquer que cela rend la publication non commerciale en pratique. Un collaborateur du projet, ZhikangNiu, a répondu que la licence MIT couvre le code et les poids propres à AuK, qu'elle ne remplace pas les licences de tiers, et que l'équipe prévoit de remplacer l'encodeur par un encodeur sous licence permissive dans une future version. D'ici là, une entreprise qui livre un produit sur AuK tel qu'il est publié a d'abord une question de licence à régler.
Le faire tourner sur InferenceKey
Le GPU et le coût
Nous avons fait tourner AuK-Flash sur une NVIDIA RTX A5000 de 24 GB, une carte de station de travail, louée sur RunPod à 0,27 USD de l'heure. Quatre retouches envoyées ensemble ont pris 5,8 secondes au total. Cela fait à peu près 2 500 retouches par heure, soit environ un centième de cent américain par retouche à ce prix brut de location du GPU, avant tout frais de plateforme. Le calcul part d'une seule rafale de quatre requêtes passées par un tunnel de développement, pas d'un long test de charge.
Le backend, et pourquoi un backend sur mesure
InferenceKey fait tourner chaque modèle à travers un petit adaptateur que nous appelons un backend. Aucun des backends prêts à l'emploi ne gère encore AuK. InferenceKey peut faire tourner des modèles texte-vers-audio avec vLLM-Omni, un serveur open source. Le projet vLLM-Omni a publié une recette pour AuK, mais pour une carte de data center beaucoup plus grosse, et nous ne l'avons pas essayée sur 24 GB. Nous avons donc écrit notre propre adaptateur : un petit paquet qui télécharge le code de Tencent à une version fixe et les fichiers du modèle, les charge et transmet chaque requête au code de Tencent. Il accepte une instruction plus un enregistrement facultatif, estime la durée de la sortie quand vous ne la donnez pas, plafonne les sorties à 30 secondes et fait tourner un seul travail à la fois sur le GPU.
Les étapes
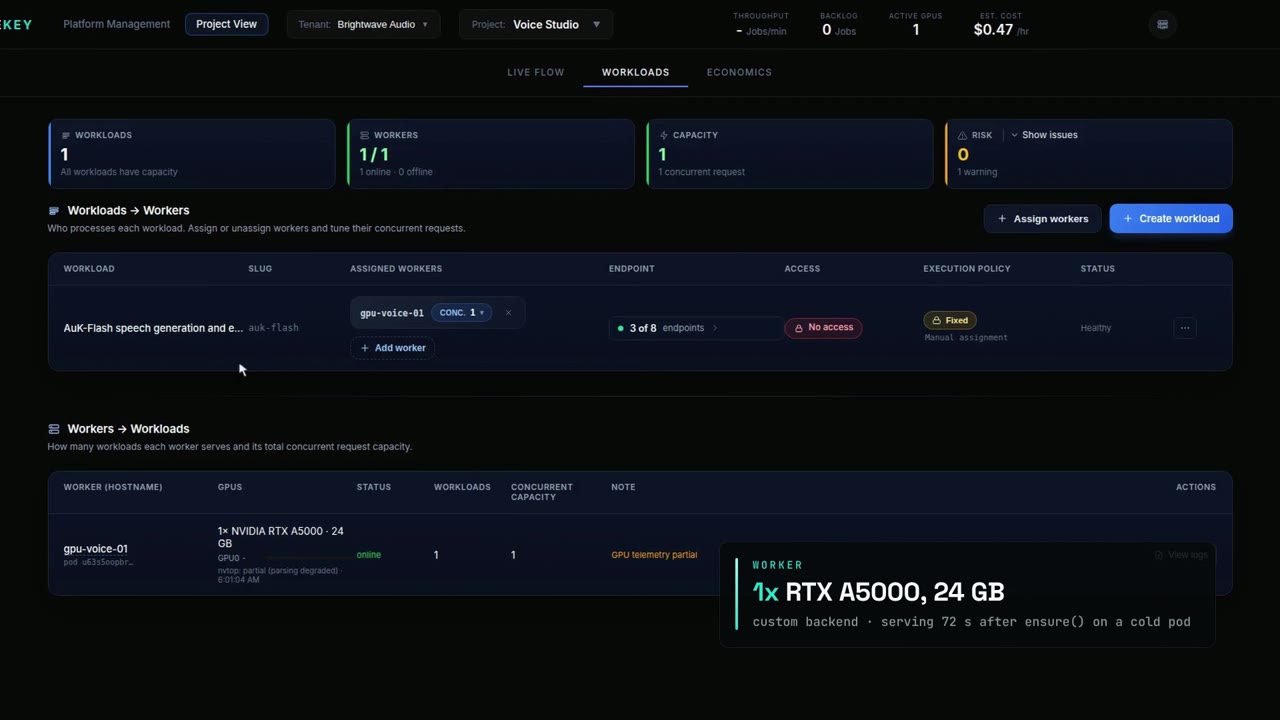
Notre code d'exemple pour la bibliothèque Python d'InferenceKey le fait en deux scripts. publish.py envoie une fois le custom backend sur votre compte. main.py demande à InferenceKey de faire tourner le modèle sur votre machine GPU et attend qu'il soit prêt. Il utilise l'adresse de chat du modèle, parce que notre adresse de synthèse vocale ne sait pas encore renvoyer de l'audio depuis un adaptateur sur mesure (voir "Ce qui a mal tourné"). Ensuite, il enchaîne une courte série qui n'a besoin d'aucun enregistrement de votre part : créer une voix, la cloner pour une nouvelle phrase, remplacer "small teams" par "two engineers", l'accélérer 1,25 fois, puis tout arrêter. Le cœur du code :
spec = WorkloadSpec(
    name="AuK-Flash speech generation and editing",
    slug=SLUG,
    model="tencent/AuK-Flash",
    backend=BACKEND_SLUG,  # our own adapter instead of a built-in one
    task_type="text2audio",
    worker_id=os.environ["IK_WORKER_ID"],
    execution_policy=ExecutionPolicy.FIXED,
    execution_policy_config={"replicas": 1},
)
ref = mgmt.ensure(spec)
enable_chat_route(base, project, ref.workload_slug)
mgmt.wait_until_ready(ref.workload_slug, timeout=2400)

out = auk(url, key, "Replace 'small teams' with 'two engineers'.", audio=host, seed=7)
Chaque requête va à l'adresse de chat du modèle (le même genre d'adresse qu'utilise un chatbot), avec l'instruction en texte et, pour les retouches, l'enregistrement en pièce jointe. La réponse revient sous forme de texte avec l'audio emballé à l'intérieur, et l'exemple le retransforme en fichier WAV normal. Les allers-retours ont été mesurés à travers un tunnel de développement vers la carte louée et peuvent être différents sur le service hébergé.
Ce que nous avons mesuré
Prêt en 72 secondes une fois la machine GPU connectée. Entre le moment où nous avons demandé le modèle et l'état prêt à servir, il s'est passé 71,6 s, sur une machine louée déjà connectée à InferenceKey mais sans aucun logiciel ni fichier du modèle. Connecter cette machine fraîchement louée a pris environ 84 s de plus. L'installation des logiciels a pris 25,8 s, le téléchargement des 18,75 GB de fichiers du modèle seulement 8,7 s, et le chargement du modèle sur la carte 22,1 s. Les 13 s environ qui restent étaient de la préparation. Un second démarrage, avec les fichiers déjà présents sur la machine, a pris 47,2 s.
Moins d'une seconde de GPU par travail. Une fois à chaud, chaque requête a pris de 0,4 à 0,8 seconde du temps de la carte. Une narration de 18,5 secondes a pris 0,76 s, environ 24 fois plus vite que sa durée. Une retouche de 4,4 secondes a pris environ 0,7 s. Le clonage était le plus lent : 0,84 s pour 3,3 secondes de parole, toujours 4 fois plus vite que sa durée. La toute première requête après le chargement est plus lente, de 1,2 à 2,3 s, le temps que la carte chauffe. En comptant le trajet réseau entre notre machine de développement et la carte louée, une retouche revenait en environ 1,3 à 1,5 seconde.
Environ 20 GB de mémoire au pic. Le modèle occupait environ 15,6 GB de la mémoire de la carte une fois chargé et environ 20,3 GB au plus fort de l'activité. Le réglage d'économie de mémoire avait un pic d'environ 11,3 GB, mais chaque requête prenait alors de 13 à 15 secondes, plus que l'audio lui-même.
Un à la fois. Quatre retouches envoyées ensemble ont reçu leur réponse chacune à leur tour, la dernière après 5,8 s. C'est voulu ici : le backend fait tourner un seul travail à la fois sur le GPU.
À quoi ça ressemble à l'écoute
Pour vérifier la qualité sans nous fier à nos seules oreilles, nous avons transcrit chaque sortie avec Whisper d'OpenAI (large-v3-turbo) sur la même machine et comparé les mots. Les voix d'entrée sont synthétiques, faites avec Pocket TTS : une parole propre, comme en studio, ce qui est le cas le plus facile pour la retouche et le clonage. Les vrais enregistrements, avec le bruit de la pièce, les accents et des gens qui parlent en même temps, n'ont pas été testés. Ce sont des essais uniques, pas un test d'écoute.
La retouche est le point fort. Chaque retouche a gardé le reste de la phrase mot pour mot. La transcription prouve les mots. Elle ne prouve pas que la hauteur a réellement monté, que le chuchotement est un vrai chuchotement, ni que le mot remplacé se raccorde au reste sans couture audible : pour cela, il faut une oreille ou une mesure de la hauteur, et nous ne l'avons pas mesurée. Écoutez et jugez. Voici l'original et ce qui en est sorti :
- Original (voix synthétique) : "Our quarterly revenue grew by twelve percent, and the new office opens in March."
- Remplacer 'twelve percent' par 'eighteen percent' (0,73 s de GPU)
- Ajouter 'almost' avant 'twelve percent' (0,76 s de GPU)
- Hauteur relevée de 3 demi-tons (0,66 s de GPU)
- Transformé en chuchotement (0,72 s de GPU)
Nettoyer et séparer. Nous avons ajouté du bruit et de l'écho à l'enregistrement et demandé une parole propre. La transcription est restée la même, ce qui prouve que les mots ont survécu. Elle ne mesure pas à quel point le résultat est propre, donc jugez-en à l'oreille. Pour la séparation, nous avons superposé deux voix, et toute la phrase du second locuteur a disparu de la sortie.
- Avant : la même phrase avec du bruit et de l'écho ajoutés
- Après : "remove noise and reverberation" (0,69 s de GPU)
- Avant : deux voix qui parlent en même temps
- Après : "keep only the first speaker" (0,77 s de GPU)
De nouvelles voix, et la copie d'une voix. La création de voix part d'une description écrite et d'aucun audio. Le clonage prend la voix du clip original sur le chiffre d'affaires et lui fait dire quelque chose qu'elle n'a jamais dit.
- Création de voix : un commentateur sportif, "And she crosses the line first, a new course record by almost four seconds." (0,41 s de GPU)
- Création de voix : une narration documentaire de 18,5 s sur une rivière (0,76 s de GPU)
- Clone de la voix du clip sur le chiffre d'affaires, à partir de ce seul échantillon et sans entraînement : "The board approved the budget, and hiring starts next quarter." (0,84 s de GPU)
Nous n'avons pas mesuré à quel point le clone est proche de la voix originale.
La création de voix dépend de la formulation. Formulées ainsi, Based on the following description: "...", generate speech content "...". (l'exemple en ligne de commande du projet, celui qu'utilise le nôtre), 7 créations de voix en anglais sur 8 sont sorties exactement justes. La huitième, la narration de 18,5 secondes lors d'un autre essai, a répété "the river begins as snow on the high peaks" et sauté la phrase suivante. Formulé ainsi, Generate speech based on the following description: "...". The content to speak is: "...". (le modèle d'instruction anglais du cookbook), le modèle a lu une partie de la description à voix haute dans 8 essais sur 8 ("A sports chatty excited, and she crosses the line first..."). Cela concorde avec ce que dit le rapport sur la réécriture préalable des demandes : la formulation compte.
- Le modèle d'instruction du cookbook : la description déborde dans la parole
L'espagnol n'y est pas encore. AuK est entraîné sur le chinois et l'anglais. Une phrase en espagnol est sortie en partie brouillée. Un utilisateur du repo a signalé la même chose pour le polonais (issue #17). Sur le conseil d'un collaborateur du projet, ce même utilisateur a ensuite poursuivi l'entraînement d'AuK-Base sur environ 100 heures d'enregistrements en polonais et l'a fait fonctionner.
- Création de voix en espagnol, en partie brouillée
Les cris sont peut-être une lacune. Un utilisateur signale qu'AuK ne sait pas reproduire des cris ou des hurlements à partir d'un enregistrement de référence (issue #23). L'issue est toujours ouverte, et nous ne l'avons pas testé.
Sur environ 60 requêtes, il n'y a eu aucun plantage, et aucune n'est revenue cassée.
La vidéo de démo
La vidéo montre le modèle sur la RTX A5000 dans le tableau de bord d'InferenceKey, puis un terminal qui demande le remplacement du chiffre (4,44 s d'audio, 0,71 s de GPU, 1,4 s d'aller-retour), la voix du commentateur et la suppression du bruit, avec l'audio avant et après mixé dans la bande-son pour que vous puissiez les entendre.
Ce qui a mal tourné
- L'adresse de synthèse vocale ne fonctionne pas avec les custom backends. L'adresse naturelle pour ce modèle, celle de synthèse vocale standard, a renvoyé une erreur au lieu de l'audio. Notre plateforme ne renvoie pas encore d'audio depuis un adaptateur maison sur cette adresse. C'est une lacune de notre côté. Le contournement est l'adresse de chat, que nous avons dû activer pour ce modèle. La réponse arrive alors sous forme de texte avec l'audio emballé à l'intérieur, pas comme un simple fichier audio. L'exemple fait les deux.
- Le premier démarrage a planté pendant le téléchargement. Deux téléchargements tournaient en même temps et leurs barres de progression se sont télescopées. Désactiver les barres de progression a réglé le problème.
- Un paquet manquant. La première requête audio a échoué parce qu'une bibliothèque dont l'encodeur a besoin pour lire les fichiers audio (
audioread) n'était pas installée. Nous l'avons ajoutée aux dépendances.
Qui a fait quoi
L'équipe AuK, Ziyang Ma et 32 coauteurs de l'université Jiao Tong de Shanghai, de Tencent Hunyuan et du Shanghai Innovation Institute, a construit AuK et AuK-Flash, écrit le rapport technique et le cookbook, et publié le code et les fichiers du modèle sous MIT. Après la sortie, ils ont fait tourner une version de test sur les Mac Apple Silicon, l'ont fait tourner sur des cartes plus petites, ont réduit la mémoire utilisée par l'encodeur d'environ 8 GB, et ont publié comment ils ont entraîné la version rapide. D'autres projets open source qui font tourner des modèles en production ont fait leur part : SGLang-Omni a pris en charge AuK le jour de la sortie, vLLM-Omni a ajouté une recette deux jours plus tard, et audio.cpp de 0xShug0 fait tourner AuK en GGUF dans un moteur en C++ pur, sans Python. L'équipe Qwen d'Alibaba a créé Qwen2.5-Omni, l'encodeur par lequel AuK écoute. Pocket TTS de Kyutai a produit les voix synthétiques que nous avons utilisées en entrée, et Whisper d'OpenAI a fait nos vérifications par transcription. Des contributeurs dans les issues du repo ont soulevé la question de la licence, les résultats en polonais et le signalement sur les cris, et des collaborateurs du projet ont répondu publiquement. La personne qui a signalé les résultats en polonais a ensuite entraîné une version polonaise qui fonctionne. Nous avons repéré la sortie dans la vidéo d'actualité d'AI Search.
Notre part : le custom backend qui amène le code d'inférence de Tencent dans InferenceKey, l'exemple du SDK, l'exécution de bout en bout sur une RTX A5000, et la mesure du temps de démarrage, de la mémoire, de la vitesse par tâche et de la survie des mots à chaque retouche.
Ce qu'il faut retenir
Sur une carte de 24 GB, chaque retouche essayée a gardé le reste de la phrase mot pour mot : un mot changé, un mot ajouté, un second locuteur supprimé, chaque fois en moins d'une seconde de GPU. Un seul modèle derrière une seule adresse a fait le travail de cinq outils dans notre test, une requête à la fois. Savoir s'il égale chaque outil spécialisé relève du benchmark des auteurs, pas du nôtre, et sur un test de séparation un modèle dédié bat AuK-Flash. Les limites sont tout aussi concrètes. Il lui faut environ 20 GB de mémoire au pic. Il parle chinois et anglais. La création de voix est sensible à la formulation. Nos vérifications ont porté sur environ 60 requêtes, pour la plupart un seul essai chacune, avec des voix synthétiques et sans panel d'écoute.
La licence de l'encodeur décide aujourd'hui de la plupart des usages professionnels. L'équipe a dit prévoir de passer à un encodeur sous licence permissive, et d'ici là, l'issue #13 est le fil à suivre.
Pour les ingénieurs
Modèle (fiche AuK-Flash, fiche AuK, repo, cookbook, arXiv 2609.08936, page du projet). tencent/AuK-Flash sha 575b92f0, modifié pour la dernière fois le 2026-09-09, non gated, MIT, 6 762 642 715 B stockés : auk_flash.safetensors 6 122 209 092 B (DiT fp32), vae.safetensors 637 322 604 B. tencent/AuK (base, auk_base.safetensors) même stockage. Le README et les fiches HF indiquent MIT (l'API GitHub renvoie NOASSERTION). 1 524 étoiles GitHub, AuK-Flash 1 599 téléchargements et 107 likes, AuK 2 695 téléchargements et 389 likes (2026-10-17). Langues HF : zh, en. Chronologie upstream (news du README) : MLX sur Apple Silicon sur la branche feat/mlx-apple-silicon et offload CPU CUDA le 2026-09-13, PR #19 mémoire de l'encodeur le 2026-09-16, pipeline d'entraînement par distillation le 2026-10-14 (PR #22).
Architecture (section 4.2 du rapport). Qwen2.5-Omni comme encodeur sémantique MLLM avec agrégation des hidden states couche par couche ; VAE audio entraîné sur de la parole, de l'audio général et de la musique (latents à 50 Hz, 64 dimensions, sortie à 24 kHz) ; Transformer rectified-flow hybride, 30 couches = 10 MMDiT dual-stream + 20 DiT single-stream, hidden 1536, 24 têtes, environ 1,5B paramètres. Encodeur et VAE gelés. Entraînement : environ 3,03B instances instruction-audio, 1,95M heures de supervision effective, cinq familles de tâches. AuK-Flash : initialisation par consistency plus Decoupled DMD routé par tâche, 4 étapes, sans CFG, 4,5x en temps réel mesuré face au teacher à 32 NFE et CFG 2.0. src/auk/infer/infer_auk.py @ 9481474f détecte Flash par le nom de config et le verrouille à 4 étapes, CFG 0, t-grid [0, 0.0761, 0.2929, 0.6173, 1], en ignorant les réglages d'échantillonnage de l'appelant. Valeurs par défaut de la base : nfe 32, cfg_strength 2.0.
Table 3 de l'article (chiffres des auteurs). WER moyen Seed-TTS-Eval : AuK 2,65, AuK-Flash 2,85, Qwen3-TTS 3,07, Seed-TTS 3,65, VoxCPM2 3,65. SIM moyen : AuK 0,795, Flash 0,790, Seed-TTS 0,778. WER EN : AuK 1,02, Flash 1,03, Qwen3-TTS 1,23. EMR MMAE(Speech) : Flash 13,85, AuK 12,44, Ming-UniAudio 7,04, Step-Audio-EditX 4,69. ACC de contenu SpeechEditBench : Flash 87,50, AuK 91,83, Ming-UniAudio 76,46, Step-Audio-EditX 16,50. dWER DNS Challenge : Flash 2,93, AuK 2,66, RE-USE 3,31. WER Libri2Mix : Flash 10,07, AuK 9,12, MossFormer2-SS 9,34.
VRAM upstream. Tableau du README (A800, bf16, max_memory_allocated) : AuK-Flash 24,77 GiB texte seul pour 1,5 s de sortie, 16,75 GiB avec --cpu_offload ; 24,97 / 16,98 GiB avec 5 s d'audio de référence. Ce tableau est antérieur à la PR #19 (mergée le 2026-09-16), qui ne convertit que le DiT en fp32 et garde Qwen en bf16, soit environ 7,5 GiB de moins (Qwen 7,515 GiB en bf16, 15,031 GiB converti).
Notre installation. RunPod RTX A5000 24 564 MiB, SECURE, CA-MTL-1, 0,27 USD/h (RTX 4090 COMMUNITY a répondu 409), driver 580.178.04 (CUDA 13.0), limite de 230 W, compute 8.6, 7,65 CPU par cgroup, 503 GB de RAM sur l'hôte, Python 3.12.3, 100,7 MB/s en curl mono-flux depuis huggingface.co. Dans une mesure séparée du démarrage à froid ci-dessous, le worker a été installé par un manager InferenceKey local via des tunnels HTTP et TCP en 84 s après le POST du pod (ssh après 38,5 s, binaire du worker de 25 243 632 B par SFTP en 14,8 s).
Backend. Custom backend Python auk-flash-speech 0.1.3, task type text2audio. Versions fixées : AuK 9481474f107ee4d8dec959b3aed05b0627cebbf8, AuK-Flash 575b92f0, Qwen2.5-Omni-3B f75b40e3 (Thinker uniquement). AukInfer(config, ckpt, dtype="bf16", qwen_path=...). max_gen_seconds 30, chars_per_second 14 pour l'estimation de la durée, surcharges par variables d'environnement AUK_*, AukFlashOffloadBackend met cpu_offload=True. Renvoie audio_b64 (WAV 16 bits, 24 kHz mono), seconds, timings {gpu_s, total_s, realtime_factor, peak_vram_mib}. Appel GPU sous un verrou. publish.py empaquette avec requires_python >=3.10,<3.13. README de l'exemple : garder les entrées sous environ 15 s pour rester sous la limite de 2 MB du corps de requête de la plateforme ; torch 2.7 depuis PyPI est le build CUDA 12.6, donc le driver doit prendre en charge CUDA 12.6+. Remarque : le .env.example de l'exemple indique "about 17 GB of free VRAM" (environ 17 GB de VRAM libre) ; le pic mesuré par nvidia-smi était de 19 390 MiB, prévoyez donc une carte de 24 GB. Exemple du SDK au commit aa7e900 sur le main d'inferencekey-sdk.
Démarrage à froid. De ensure() à l'état prêt côté SDK 71,6 s avec les caches HF, uv et venv vides : venv 25,8 s (torch 2.7, transformers 4.57), téléchargements 8,7 s pour 18,75 GB, environ 13 s d'imports et de préparation, chargement 22,1 s (setup_s 44,1, vram_loaded_mib 14 305). Poids en cache et cache uv chaud : 47,2 s. Avec le venv présent : 36,1 s et 19,8 s.
VRAM (nvidia-smi -l 1). 14 837 MiB après chargement, 19 390 MiB au pic en service, max_memory_allocated de torch de 17 309 à 17 964 MiB par requête. Variante offload : 1 571 MiB au repos, 10 755 MiB au pic, de 12,7 à 15,2 s de GPU par requête (0,3x à 0,5x le temps réel), non testée sur une carte de 16 GB. Pic de puissance 181 W.
Par requête (à chaud, seed 7, /v1/chat/completions sans streaming, template CLI sauf mention contraire ; le temps GPU est le gpu_s synchronisé du backend, l'aller-retour est mesuré par le client à travers le tunnel) :
| Cas | Entrée | Sortie s | GPU s | x temps réel | Aller-retour s | Whisper entend |
|---|---|---|---|---|---|---|
| Création de voix, commentateur | aucune | 5,96 | 0,41 | 14,5 | 0,76 | texte exact |
| Création de voix, narration de 18,5 s | aucune | 18,46 | 0,76 | 24,3 | 1,23 | texte exact |
| Clone zero-shot, nouvelle phrase | clip de 4,3 s | 3,34 | 0,84 | 4,0 | 1,81 | texte exact |
| Remplacer "twelve percent" par "eighteen percent" | 4,3 s | 4,44 | 0,73 | 6,1 | 1,53 | "...grew by 18%, and..." |
| Insérer "almost" | 4,3 s | 4,80 | 0,76 | 6,3 | 1,49 | "...grew by almost 12%..." |
| Hauteur +3 demi-tons | 4,3 s | 4,28 | 0,66 | 6,5 | 1,39 | texte inchangé |
| Émotion : enthousiaste | 4,3 s | 4,28 | 0,68 | 6,3 | 1,27 | texte inchangé |
| Chuchotement | 4,3 s | 4,28 | 0,72 | 5,9 | 1,33 | texte inchangé |
| Débruitage + déréverbération | 4,4 s | 4,40 | 0,69 | 6,4 | 1,29 | texte inchangé |
| Garder le premier locuteur | 5,8 s | 5,76 | 0,77 | 7,5 | 1,40 | seulement la phrase du locuteur 1 |
| Création de voix en espagnol | aucune | 6,96 | 0,43 | 16,3 | 0,79 | en partie brouillé |
Première requête après un chargement à froid : de 1,23 à 2,30 s de GPU pour une création de voix de 6,1 s. Surcoût de la plateforme (aller-retour moins GPU) d'environ 0,3 à 1,0 s pour les retouches, puisque la requête et la réponse transportent chacune un WAV en base64. Quatre retouches parallèles : 5,82 s au total, allers-retours de 1,42, 2,92, 4,46 et 5,81 s (concurrence d'assignation à 1 plus le verrou du backend), les quatre sorties correctes. Vitesse 1,25x : de 6,10 s à 4,88 s. Les "environ 2 500 retouches par heure" du récit valent 3 600 / (5,82 / 4), une projection à partir de cette seule rafale de quatre requêtes à travers un tunnel de développement ; aucun test de charge soutenue n'a été fait.
Vérification de la qualité. openai/whisper-large-v3-turbo sur le pod. Templates de création de voix : le template EN du cookbook Generate speech based on the following description: "...". The content to speak is: "...". a laissé fuir des mots de la description dans 8 sorties sur 8 (4 plus 4 avec un gen_seconds plus court) ; le template CLI Based on the following description: "...", generate speech content "...". a donné 7 sur 8 exacts, la sortie de 18,5 s avec la seed 8 a répété une phrase et sauté "every spring it melts". Le cookbook dit de passer gen_seconds pour les tâches qui demandent une durée de sortie explicite (TTS, retouche de contenu, vitesse) et que l'entrée d'une retouche de paroles doit être a cappella.
Problèmes de la plateforme. (1) /v1/audio/speech avec un custom backend renvoie un HTTP 500 "worker returned no payload for passthrough route" : le worker ne fait remonter le JSON d'un custom backend en binaire que pour les types transcription, embeddings, rerank, forecast et image (needs_json_binary_surfacing dans crates/worker/src/jobs.rs), et le passthrough du manager exige binary_b64. Contournement : PATCH /api/workloads/<id>/endpoint_settings/chat {"enabled":true} et /v1/chat/completions, dont le contenu du message est le JSON du backend sous forme de chaîne. (2) Course de tqdm entre deux appels snapshot_download parallèles (AttributeError: type object 'tqdm' has no attribute '_lock'), corrigée avec HF_HUB_DISABLE_PROGRESS_BARS=1 en 0.1.1. (3) No module named 'audioread' à la première requête audio (le client a vu un HTTP 503 backend_unavailable), corrigé en 0.1.2. (4) Les workloads fixes démarrent avec une concurrence de 1. (5) Détails cosmétiques du panneau : Access affiche "No access" avec une clé wildcard qui fonctionne, "GPU telemetry partial".
Limites connues upstream. Issue #13 (ouverte) : licence de l'encodeur. Issue #17 (ouverte) : WER médian en polonais zero-shot d'environ 80 % contre 23 % pour l'anglais ; le même auteur a ensuite fine-tuné AuK-Base sur 103,65 h de MLS polonais et atteint un CER moyen de 3,3 %. Issue #23 (ouverte) : un utilisateur signale qu'AuK et AuK-Flash ne reproduisent pas les cris d'une référence. L'intégration ComfyUI a un budget de 30 s source plus cible.
Limites. Environ 60 requêtes de notre part, une seed chacune pour la plupart, voix d'entrée synthétiques, pas de métrique de similarité du locuteur, pas de test d'écoute, débruitage vérifié uniquement pour la préservation du contenu. Non testés : retouche de paroles chantées, volume, timbre, suppression d'accent, retouches non verbales, séparation de la musique, extraction d'un locuteur cible, suppression de mots, AuK base, la variante offload sur une vraie carte de 16 GB, le Prompt Enhancer. Les chiffres de benchmark sont ceux des auteurs (exactitude du contenu SpeechEditBench : AuK-Flash 87,50 contre Ming-UniAudio 76,46 ; WER moyen Seed-TTS-Eval 2,85 contre Qwen3-TTS 3,07), non reproduits par nous.
Sources : AuK-Flash, AuK, GitHub, cookbook, rapport technique, page du projet, licence de Qwen2.5-Omni-3B, exemple du SDK, vidéo de démo, vidéo d'AI Search.