Ternary Bonsai 2 27B: ein 27B-Reasoning-Modell in 6 GB, das in den Tests von Prism ML 98% behält
Prism ML packt Qwen3.8-27B in eine 5.95-GB-Datei mit dreiwertigen Gewichten. Auf einer RTX 4090 schrieb es etwa 104 Tokens/s und belegte rund 12 GB Speicher.
Qwen3.8-27B, das offene Reasoning- und Vision-Modell des Qwen-Teams von Alibaba, belegt in seiner ursprünglichen Form mit voller Genauigkeit etwa 54 GB, so steht es in der Model Card von Prism ML. Die Version, die wir auf einer einzigen Gaming-Grafikkarte laufen ließen, ist eine Datei mit 5.95 GB. Wir haben sie eine Speisekarte von einem Foto ablesen lassen, ein Sitzordnungsrätsel mit drei gültigen Lösungen lösen lassen und sie einen Code suchen lassen, der in einem Dokument von etwa 25,000 Wörtern versteckt war. Jede Frage haben wir ein- oder zweimal gestellt, und jede Antwort war richtig.
Nach den Tests von Prism ML behält Ternary Bonsai 2 27B 98.2% der Qualität des Originals. Eine herkömmliche Verkleinerung auf fast dieselbe Größe behält 84.1%. Prism ML hat es im September unter der Lizenz Apache 2.0 veröffentlicht (kommerziell frei nutzbar). Es ist der zweite Anlauf von Prism ML mit diesem dreiwertigen Format bei einem Modell mit 27 Milliarden Parametern, und es schneidet besser ab als der erste. Um es zu betreiben, brauchst du die angepasste Version von Prism ML der üblichen freien Werkzeuge, denn die Standardversionen können die Datei nicht lesen. Das nimmst du mit:
| Was | Ergebnis |
|---|---|
| Modell | Ternary Bonsai 2 27B von Prism ML: Qwen3.8-27B (27B Parameter, liest Text und Bilder), so gespeichert, dass fast jede interne Zahl nur -1, 0 oder +1 ist |
| Dateigröße | 5.95 GB (kleinste Version) oder 7.21 GB, gegen etwa 54 GB für das Original |
| Qualität, Model Card von Prism ML | 84.78 gegen 86.32 für das Original über 14 Reasoning-Tests (98.2%). Der herkömmliche Weg, es auf eine ähnliche Größe zu verkleinern: 72.59 |
| Unsere GPU | eine NVIDIA RTX 4090, eine Gaming-Karte mit 24 GB, gemietet bei RunPod |
| Belegter Speicher im Betrieb | etwa 12 GB der 24 GB der Karte, mit einem Arbeitsspeicher von 65,536 Tokens, den sich bis zu 4 Nutzer gleichzeitig teilen |
| Tempo für einen Nutzer | etwa 104 Tokens pro Sekunde (ein Token ist ungefähr drei Viertel eines Wortes) |
| Vier Nutzer gleichzeitig | insgesamt etwa 159 Tokens pro Sekunde, nachdem wir eine Einstellung hochgesetzt hatten |
| Von der Anforderung des Modells bis bereit (GPU-Maschine schon eingerichtet) | 55 Sekunden, größtenteils Downloads |
| Der Haken | braucht zum Laufen die angepasste Version von llama.cpp von Prism ML |
Ein Mischpult mit Schaltern statt Fadern
Ein Sprachmodell ist, physisch betrachtet, eine sehr lange Liste von Zahlen, die man Gewichte nennt. Im ursprünglichen Qwen3.8-27B ist jede davon mit 16 Bit gespeichert. Stell dir ein Mischpult vor, bei dem jeder von 27 Milliarden Fadern auf jeder von 65,536 Positionen stehen kann.
Prism ML hat fast jeden Fader durch einen Schalter mit drei Stellungen ersetzt: runter, aus, hoch (-1, 0, +1). Dann hat es für jede Gruppe von 128 Schaltern einen normalen Fader behalten, der die Lautstärke der ganzen Gruppe regelt. Jeder Schalter samt seinem Anteil am Gruppenfader kostet unter 2 Bit, gegen 16 im Original, deshalb ist die Datei etwa neunmal kleiner. Prism ML liefert zwei Versionen der Datei aus, 5.95 GB und 7.21 GB. Die größere ist auf manchen Grafikkarten schneller.
Bevor Prism ML die Fader in Schalter verwandelt hat, hat es das Pult außerdem nach einem festen Muster neu verkabelt. Alles, was hindurchläuft, muss durch dieselbe Neuverkabelung, sonst kommt nur Kauderwelsch heraus. Zum Lesen von Bildern braucht es eine separate, optionale Datei mit 0.63 GB.
Leichte Fragen verstecken den Schaden
In einem schweren Mathematikwettbewerb kommt Bonsai auf 95.83 und in einem Programmiertest auf 90.07, laut Model Card. Der übliche Weg, das Modell auf etwa dieselbe Größe (7.27 GB) zu verkleinern, fällt in denselben Tests auf 57.5 und 56.4, obwohl er in einem leichten Allgemeinwissensquiz mit 88.93 nah am Original liegt. Die Model Card formuliert es so: „why casual testing misses the collapse“ (warum flüchtiges Testen den Einbruch übersieht).
Wenn dir also jemand erzählt, ein kleines Modell „funktioniert gut“, lautet die nützliche Frage: wobei? Gemittelt über die 14 Tests der Model Card von Prism ML, alle mit der Erlaubnis für das Modell, vor der Antwort nachzudenken:
| Version | Größe | Durchschnitt | Anteil am Original |
|---|---|---|---|
| Qwen3.8-27B, Original | etwa 54 GB | 86.32 | 100% |
| Standardversion mit 4 Bit (von Unsloth, einem Team, das verkleinerte Modelle veröffentlicht) | 17.6 GB | 85.18 | 98.7% |
| Standardversion mit 2 Bit | 7.27 GB | 72.59 | 84.1% |
| Ternary Bonsai 2 27B | 5.95 GB | 84.78 | 98.2% |
Mathematik und Programmieren kommen fast unbeschadet durch. Die Verluste liegen bei Allgemeinwissen und Reasoning (79.86 gegen 85.55) und beim Lesen von Bildern (66.19 gegen 71.36).
Zwei Fußnoten aus dem Whitepaper von Prism ML. Bei langer Programmierarbeit über viele Schritte, also echte Bugs in echtem Code beheben, behält es nur etwa drei Viertel des Originals (60.8 gegen 80.6). Und im Whitepaper sind die 98.2% mit maximalem Nachdenken gemessen (eine Einstellung namens xhigh). Mit mittlerem Nachdenken kommt Bonsai auf 79.3, gegen 83.9 mit maximalem, und das Original kommt mit mittlerem auf 82.6.
Das normale llama.cpp kann die Datei nicht lesen
llama.cpp ist das Open-Source-Programm, das Modelldateien wie diese auf deiner eigenen Maschine ausführt. Die Model Card sagt es klar: „Stock llama.cpp will not run these files.“ (Das normale llama.cpp führt diese Dateien nicht aus.) Es lehnt beide Bonsai-Formate als unbekannt ab. Die Seite mit den bekannten Problemen ergänzt, dass auch die beliebten Desktop-Apps zum Ausführen von Modellen sie nicht laden können. Ältere Versionen des Standardprogramms konnten sogar eine verwandte Bonsai-Datei öffnen und mit Unsinn antworten, weil sie die oben beschriebene Neuverkabelung überspringen. Das Standardprogramm haben wir selbst nicht getestet.
Die Lösung ist die angepasste Kopie von llama.cpp von Prism ML (ein Fork), mit fertigen Builds für Linux, Windows, macOS und mehr. Der neueste kam am 14. Oktober heraus. Für Linux rät die Seite mit den bekannten Problemen von Prism ML, den Download zu nehmen, der für die ältere Toolkit-Version von NVIDIA (12.8) gebaut ist, weil die neueste auf manchen Maschinen abstürzt. Diese Seite stammt aus dem September, also von vor dem Release im Oktober, wir wissen daher nicht, ob der Absturz noch passiert. Wir haben 12.8 genommen und hatten keinen Absturz.
Das Modell denkt außerdem viel nach, bevor es antwortet, und dieses Nachdenken zählt gegen die Längengrenze, die du setzt. Erlaubst du höchstens 256 Tokens, bekommst du womöglich eine leere Antwort, weil das Modell alle zum Nachdenken verbraucht hat. Die Card empfiehlt eine Grenze von 16,384 Tokens.
Wie schnell es sein sollte
Auf der RTX 4090 schreibt die kleinere Datei laut Card etwa 91 Tokens pro Sekunde für einen Nutzer, rund 68 Wörter pro Sekunde. Welche Datei schneller ist, hängt von der Grafikkarte ab, der Abschnitt „Für Engineers“ listet sie auf.
Der größere Unterschied ist die Größe: Die übliche 4-Bit-Version des Originals von Unsloth hat 17.6 GB, dreimal so viel wie die Bonsai-Datei mit 5.95 GB. Das Tempo des Originalmodells haben wir nicht mit derselben Software auf derselben Karte gemessen.
So läuft es auf InferenceKey
Die GPU und die Software
Wir haben es auf einer RTX 4090 mit 24 GB laufen lassen, gemietet bei RunPod.
InferenceKey startet Modelle über kleine Adapter, die wir Backends nennen. Das eingebaute Backend für llama.cpp installiert die offizielle Version, die diese Datei nicht lesen kann, also haben wir unser eigenes geschrieben: ein Custom-Backend-Paket von etwa 6 KB, das InferenceKey auf der GPU-Maschine ausführt. Es lädt den Fork von Prism ML, das Modell mit 5.95 GB und die Datei zum Lesen von Bildern herunter und startet den Server des Forks. Eine Überraschung unterwegs: Der Download des Forks erwartet, dass zwei NVIDIA-Bibliotheken schon auf der Maschine liegen, und bringt sie nicht mit, also installiert das Backend sie aus den Python-Paketen von NVIDIA.
Das Backend kümmert sich auch um die Eigenheiten des Modells. Es fordert standardmäßig mittleres Nachdenken an, gibt jeder Antwort Platz für 16,384 Tokens, damit das Nachdenken die Antwort nicht auffrisst, und ersetzt die Einstellung „high“, die laut der Seite mit den bekannten Problemen einen Fehler zurückgibt, durch maximales Nachdenken. Laut Card ist mittleres Nachdenken für kürzere Antworten gedacht. In unseren zwei Stichproben gab es keine kürzeren Antworten als mit maximalem Nachdenken, und in den Tests von Prism ML schneidet es schlechter ab (79.3 gegen 83.9).
Die Schritte
Unser SDK-Beispiel erledigt das in zwei Skripten. publish.py lädt das Custom Backend einmal in dein Konto hoch. main.py sagt InferenceKey, dass es das Modell auf deiner GPU-Maschine starten soll, wartet, bis es bereit ist, stellt eine Frage (und optional eine zu einem Bild), speichert die Antwort und fährt das Modell wieder herunter. Der Kern davon:
spec = WorkloadSpec(
    name="Ternary Bonsai 2 27B",
    slug="ternary-bonsai-2-27b",
    model="prism-ml/Ternary-Bonsai-2-27B-gguf",
    backend="ternary-bonsai-2-27b",  # the custom backend from publish.py
    task_type="text2text",
    worker_id=os.environ["IK_WORKER_ID"],
    execution_policy=ExecutionPolicy.FIXED,
    execution_policy_config={"replicas": 1},
)
ref = mgmt.ensure(spec)
mgmt.wait_until_ready(ref.workload_slug, timeout=1800)
Auf der GPU startet das Backend den Server des Forks mit den empfohlenen Einstellungen der Model Card und Platz für 65,536 Tokens Konversation. Für alle, die den Lauf nachstellen wollen, ist das der Befehl:
llama-server -m Ternary-Bonsai-2-27B-PTQ1_0.gguf --mmproj Ternary-Bonsai-2-27B-mmproj-Q8_0.gguf \
  -ngl 99 -fa on -c 65536 --jinja \
  --temp 1.0 --top-p 0.95 --top-k 20 --min-p 0.05
Danach sprichst du mit ihm über dasselbe Adressformat für Chats wie beim Dienst von OpenAI. Alles lief über eine private Kopie von InferenceKey auf unserer Entwicklungsmaschine, nie über den Live-Dienst.
Was wir gemessen haben
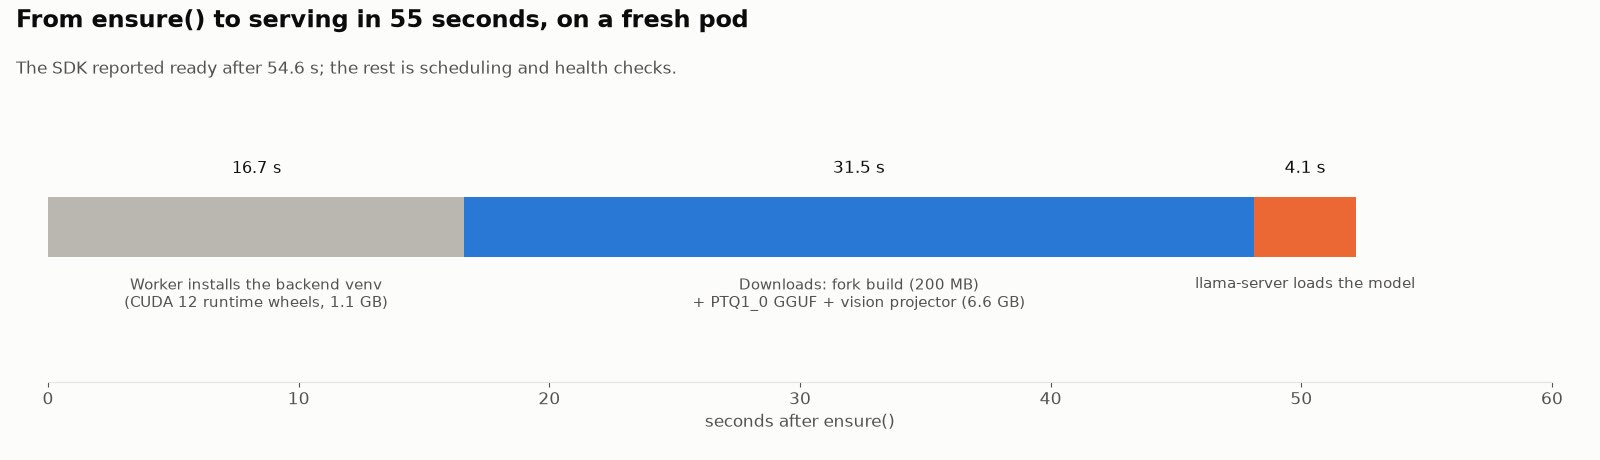
Bereit in 55 Sekunden. Von dem Moment, in dem das Skript das Modell angefordert hat, bis zu dem Moment, in dem es „bereit“ meldete, auf einer frisch gemieteten Maschine, auf der das kleine Agentenprogramm von InferenceKey schon installiert war (das hatte vorher 122 s gedauert): 16.7 s, um die Python-Umgebung des Backends einzurichten, 31.5 s, um 6.6 GB Modell und den Fork mit 208 MB herunterzuladen, und 4.1 s, bis der Server es geladen hatte.
Etwa 12 GB Speicher. Im Betrieb, mit einem Arbeitsspeicher von 65,536 Tokens für bis zu vier Nutzer und eingeschaltetem Bildlesen, hat die GPU nie mehr als etwa 12 GB ihrer 24 GB belegt, auch nicht mit einem Dokument von 34,000 Tokens und vier gleichzeitig laufenden Anfragen. Der Download ist etwa neunmal kleiner als das Original, aber der Speicher im Betrieb ist ungefähr doppelt so groß wie die Datei, weil dort auch der Arbeitsspeicher der Konversation und der Bildteil liegen.
Etwa 104 Tokens pro Sekunde pro Nutzer. Über 12 echte Anfragen durch InferenceKey, eine nach der anderen, kam jede Antwort mit 101 bis 104 Tokens pro Sekunde heraus, etwa 78 Wörter pro Sekunde. Das ist etwas schneller als der Wert der Model Card für diese GPU, 91.1. Warum, wissen wir nicht. Das Whitepaper nennt für diese Karte noch einen anderen Wert (96.7), die Ergebnisse scheinen also zwischen Maschinen und Builds zu schwanken.
Lange Dokumente werden schnell gelesen. Das Modell hat das ganze Dokument mit 25,000 Wörtern (34,000 Tokens) in etwa 12 Sekunden gelesen und den versteckten Code gefunden. Von der Frage bis zur Antwort vergingen 13.5 s.
Vier Nutzer gleichzeitig. Vier gleichzeitig geschickte Fragen waren alle nach 9.6 s fertig, jeder Nutzer bekam 68 bis 78 Tokens pro Sekunde (insgesamt etwa 159). Dafür mussten wir eine Einstellung hochsetzen: Standardmäßig hat die Plattform sie nacheinander beantwortet, und die letzte wartete 22.4 s.
Was es geantwortet hat
Das sind unsere eigenen Fragen, mit ein oder zwei Versuchen pro Frage, sie zeigen also Verhalten, keine Benchmark-Qualität. Jede Antwort war richtig:
- Eine Frage zu einem Lagerroboter, dessen Akku pro Meter abnimmt: 28%, richtig sowohl mit mittlerem als auch mit maximalem Nachdenken, die schnellste Antwort in 3.75 s.
- Ein Sitzordnungsrätsel: genau die drei gültigen Sitzordnungen, in beiden Einstellungen.
- Eine kleine Programmieraufgabe (überlappende Intervalle zusammenführen): korrekter Code.
- Eine Zusammenfassung auf Spanisch in zwei Sätzen mit ausgeschaltetem Nachdenken: richtig, in 1.9 s.
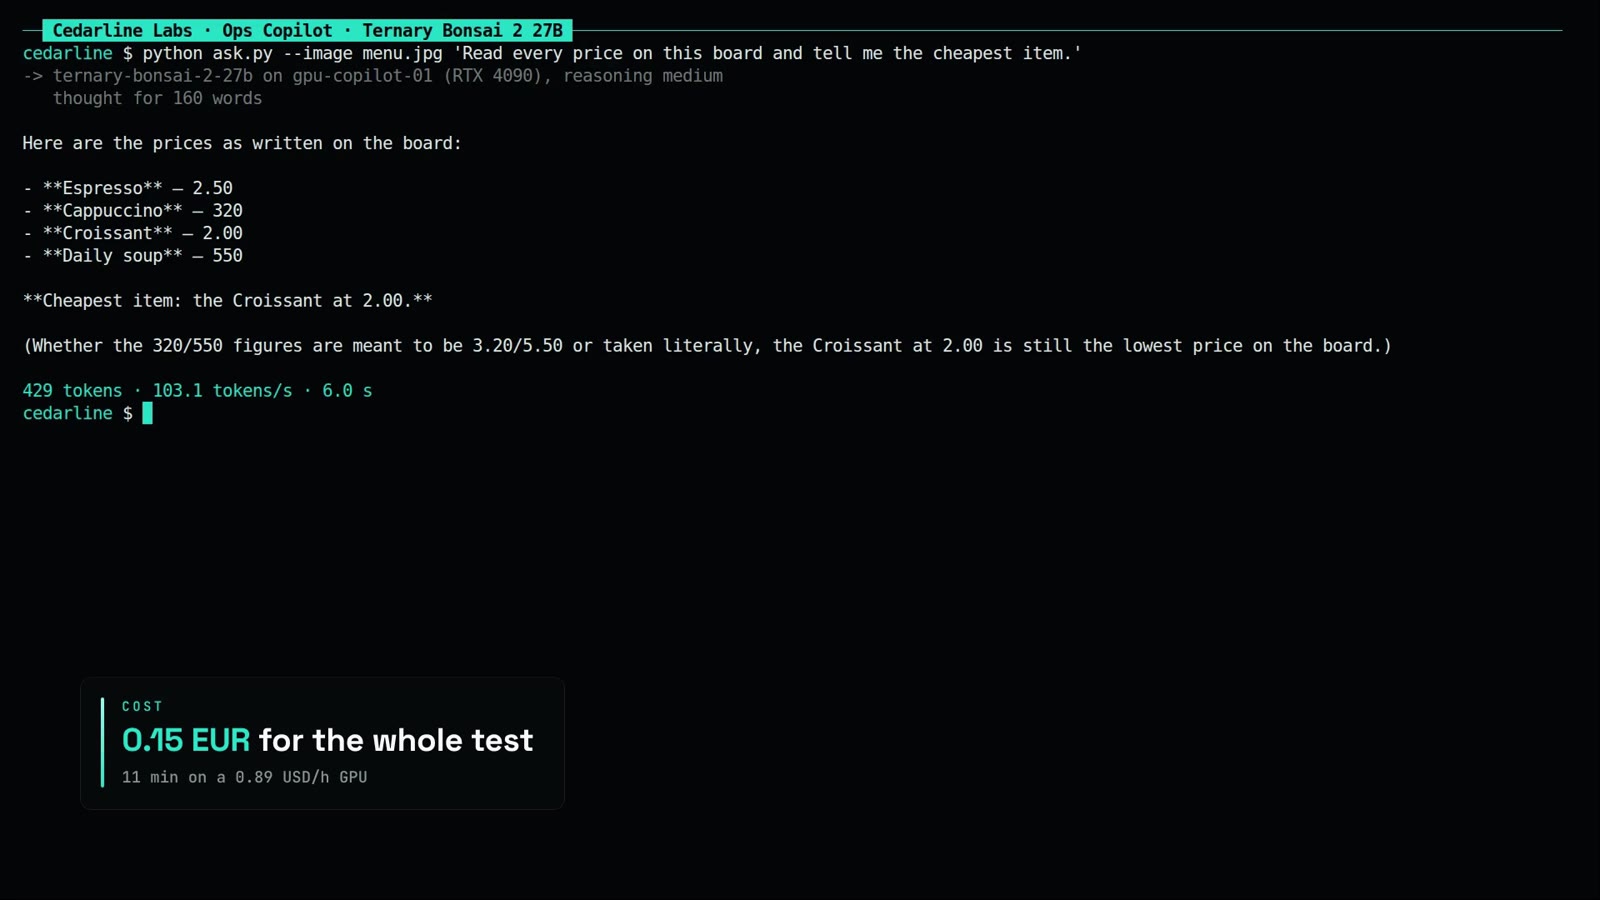
- Ein Foto einer Speisekarte: alle vier Gerichte und Preise exakt abgelesen.
- Äpfel auf einem Bild zählen: sieben, richtig.
- Der Code, versteckt in der Mitte des Dokuments mit 34,000 Tokens: gefunden.
Von den 17 Anfragen, die wir gemessen haben, geriet keine in eine Schleife, kam leer zurück oder wurde abgeschnitten. Eine schwere Frage verbringt trotzdem erst einige Sekunden mit Nachdenken: Das Sitzordnungsrätsel brauchte mit mittlerem Nachdenken 14.7 s. Nicht getestet haben wir, wie das Modell externe Werkzeuge aufruft (Suche, einen Taschenrechner, deine eigene API), was laut der Seite mit den bekannten Problemen manchmal schiefgeht, und auch kein sehr langes maximales Nachdenken.
Das Demovideo
Das Video zeigt das Modell, wie es auf der RTX 4090 im Dashboard von InferenceKey läuft, dann ein Terminal, das die Roboterfrage stellt (215 Tokens mit 103.2 Tokens pro Sekunde, 3.0 s) und das Foto der Speisekarte (429 Tokens mit 103.1 Tokens pro Sekunde, 6.0 s).
Was schiefging
Das Modell selbst hat uns keine Probleme gemacht. Das meiste, was kaputtging, lag bei uns, in der Plattform, und es zeigt sich, weil das hier ein Custom Backend war und keins unserer eingebauten.
- Kein Streaming für Custom Backends. Wer die Antwort Wort für Wort anforderte, bekam einen Fehler innerhalb einer ansonsten normalen Antwort. Heute unterstützen das nur die eingebauten Backends. Der Chat-Tester in unserem Dashboard streamt immer, er war für dieses Modell also nicht nutzbar, deshalb zeigt das Video ein Terminal.
- Die Antwort kommt verpackt an. Die Antwort eines Custom Backends kommt als Block roher Daten in der Chatnachricht an statt als sauberer Text, und der Nutzungszähler steht auf null. Unser Beispiel räumt das auf, aber eine normale Chat-App würde den rohen Block anzeigen.
- Standardmäßig eine Anfrage auf einmal. Ein Modell, das an eine Maschine gebunden ist, nimmt anfangs nur eine Anfrage auf einmal an, derselbe Bug wie in unserem Test von AstaBrief-8B. Ein einziger Aufruf der Einstellungen behebt ihn.
- Einstellungen kommen bei Custom Backends nicht an. Einstellungen, die du dem Modell im Dashboard von InferenceKey gibst, erreichen ein Custom Backend nie, unseres hält sie deshalb in seinem eigenen Code.
- Eine Obergrenze von fünf Minuten. InferenceKey gibt einem Custom Backend 300 Sekunden pro Antwort. Bei etwa 100 Tokens pro Sekunde sind das ungefähr 29,000 Tokens Nachdenken plus Antwort. Wir sind nie in die Nähe gekommen (die längste Antwort hatte 1,447 Tokens), aber sehr langes maximales Nachdenken könnte es.
- Außerhalb der Plattform: Im geteilten RTX-4090-Pool von RunPod war keine Karte frei, also haben wir die dedizierte Stufe genommen.
Wer was gemacht hat
Das Qwen-Team von Alibaba hat Qwen3.8-27B trainiert und unter Apache 2.0 veröffentlicht. Prism ML hat daraus Ternary Bonsai 2 27B gebaut. Sie haben das Format entworfen, die Idee der Neuverkabelung aus der SpinQuant-Forschung von Meta übernommen (Liu et al.), den Code in ihrem llama.cpp-Fork geschrieben, der die Schalter im Betrieb ausliest, und fertige Builds, eine Demo, ein Whitepaper und eine ausführliche Seite mit bekannten Problemen veröffentlicht. Die Kompressionsmethode von Mobius Labs hat den Bildteil verkleinert. Unsloth hat den 4-Bit-Build für den Vergleich erstellt. Das Projekt llama.cpp ist die Basis, auf der der Fork aufbaut. Auf die Veröffentlichung sind wir in einem Video von AI Search gestoßen.
Unser Teil war das Custom Backend, das den Fork von Prism ML in InferenceKey bringt, das SDK-Beispiel, der Lauf von Anfang bis Ende auf einer RTX 4090 und die Messung von Tempo, Speicher und Startzeit.
Was du mitnehmen kannst
Die übliche 4-Bit-Version von Qwen3.8-27B (17.6 GB) passt ebenfalls auf eine Karte mit 24 GB wie diese, und in den Tests von Prism ML behält sie etwas mehr Qualität (98.7% gegen 98.2%). Was dir die Datei mit 6 GB bringt, ist Spielraum: Platz für ein zweites Modell oder eine längere Konversation auf derselben Karte, und eine Chance auf kleineren Karten. Wir haben keine Karte unter 24 GB getestet, der letzte Punkt ist also offen. Auf der RTX 4090 schrieb es etwa 100 Tokens pro Sekunde. Die Grenzen: Die Qualitätszahlen sind die von Prism ML, unsere eigenen Prüfungen waren etwa 20 Anfragen mit ein oder zwei Versuchen pro Frage, lange Programmierarbeit über viele Schritte (echte Bugs beheben) behält nur etwa drei Viertel des Originals, und heute hängst du vom Fork von Prism ML ab, um es überhaupt laufen zu lassen.
Während es lief, war etwa die Hälfte dieser RTX 4090 frei, etwas mehr als 12 GB. Das ist Platz für ein zweites, kleineres Modell auf derselben Karte, zum Beispiel für das, das die Suche über die Dokumente deines Unternehmens antreibt. Was würdest du daneben stellen?
Für Engineers
Modell (Model Card, KNOWN_ISSUES, Whitepaper, Bonsai-demo, Basismodell). Repo prism-ml/Ternary-Bonsai-2-27B-gguf, sha b072e1d3, erstellt am 2026-09-16, zuletzt geändert am 2026-09-25, Apache-2.0, nicht gated. Dateien (alle mit dem Präfix Ternary-Bonsai-2-27B-): PTQ1_0.gguf 5,946,648,928 B, PQ2_0.gguf 7,206,168,928 B, F16.gguf 53,808,408,928 B, mmproj-Q8_0.gguf 629,246,976 B, mmproj-BF16.gguf 931,145,856 B. Keine Q2_0-Datei. Die „etwa 54 GB“ im Text sind die FP16-Zeile der Card (das Whitepaper nennt 53.80 GB). 27.36B Parameter: 24.35B Sprach-Backbone (64 Blöcke), 2.54B Embedding/LM-Head, 0.46B Vision-Tower (27 Blöcke). Architektur unverändert gegenüber Qwen3.8-27B (Qwen3_5ForConditionalGeneration): hybride Attention, jede 4. Schicht volle Attention (16 volle, 48 Gated DeltaNet), 24 Q- / 4 KV-Heads, head_dim 256, SwiGLU, RoPE, RMSNorm, 262,144 nativer Kontext.
Format. Ternary g128: Gewichte in {-1, 0, +1}, ein FP16-Skalierungsfaktor pro 128 Gewichte, log2(3) + 16/128 = etwa 1.71 bpw bei den ternären Tensoren, 1.72 für das ganze Modell. Gewichte in einer Hadamard-rotierten Basis gespeichert (Block 1024, fester Vorzeichenvektor; das R = (1/sqrt n) H_n S des Whitepapers folgt SpinQuant, arXiv:2405.16406), offline eingerechnet; die Runtime wendet die passende Transformation auf die Aktivierungen an oder verweigert die Datei. Abdeckung mit wenigen Bits: Embeddings, Attention- und MLP-Projektionen, LM-Head. 26.2M Parameter (0.0976% des LM: Pfad des rekurrenten Zustands der linearen Attention und Norms) bleiben in höherer Präzision. Die Rotation ist eine Hadamard-Transformation nach Art von SpinQuant. Vision-Projektor: Q8_0-Container 0.63 GB (Whitepaper: HQQ 4-Bit) oder BF16 0.93 GB. Speichertabelle der Card: FP16 16.0 bpw ~54 GB; ideal 1.72 bpw 5.8 GB (~9.3x); PTQ1_0 dichte Trits 1.75 bpw 5.95 GB (~9.0x); PQ2_0 ein Trit pro 2-Bit-Slot 2.13 bpw 7.21 GB (~7.5x). Das Whitepaper nennt leicht abweichende Werte (PTQ1_0 1.76 bpw 5.93 GB, PQ2_0 2.16 bpw 7.25 GB, FP16 53.80 GB). Wir nutzen die der Card, die zu den Dateigrößen auf Hugging Face passen.
Qualität (Card). EvalScope + vLLM auf H100, Thinking-Modus, 14 Benchmarks: FP16 86.32, UD-Q4_K_XL von Unsloth (5.2 bpw, 17.6 GB) 85.18, IQ2_XXS (2.16 bpw, 7.27 GB) 72.59, Bonsai 84.78. IQ2_XXS: MMLU-Redux 88.93, AIME26 57.5, LiveCodeBench 56.4. Bonsai AIME26 95.83, LiveCodeBench 90.07. Nach Kategorie FP16 / Bonsai: Wissen und Reasoning 85.55 / 79.86, Mathematik 97.06 / 96.57, Programmieren 89.07 / 89.42, Befolgen von Anweisungen 81.25 / 82.66, BFCL v3 76.74 / 74.92, Vision (MMMU-Pro, OCR Bench v2) 71.36 / 66.19. Dichte laut Card (D = -log2(1 - score/100) / GB): Bonsai 2 0.457, das vorherige Ternary Bonsai 27B 0.416 (80.98 bei 5.75 GB), IQ2_XXS 0.257, UD-Q4_K_XL 0.157, FP16 0.053. Whitepaper (20 Benchmarks, xhigh): Bonsai 83.9 gegen FP16 85.4 (ebenfalls 98.2%), IQ2_XXS 75.2. Terminal-Bench 2.1 52.8 gegen 69.7, SWE-bench Verified 60.8 gegen 80.6, tau2-Bench 80.2, BFCL v3 74.9, AA-LCR 77.0. Mittlerer Effort (Tabelle 11): 79.3 gegen 82.6, AIME25 74.58 gegen 86.25, GPQA Diamond 75.56 gegen 84.34. Unser Backend nutzt standardmäßig medium, rechne also mit den Zahlen aus Tabelle 11, außer du schickst reasoning_effort: "xhigh".
Tempo (Card, llama-bench, Batch 1, ohne Vision-Tower), tg128 PQ2_0 / PTQ1_0: RTX 5090 129.9 / 120.5, RTX PRO 6000 Blackwell 124.8 / 117.9, H100 SXM 113.9 / 86.9, RTX 6000 Ada 82.8 / 90.4, RTX 4090 81.2 / 91.1, L40S 74.4 / 81.8, A100 SXM 73.9 / 54.7, L4 29.8 / 32.1. RTX 4090 pp512: 3,124 / 1,645. PQ2_0 decodiert auf Hopper, Ampere im Rechenzentrum und Blackwell schneller und ist überall beim Prefill schneller; PTQ1_0 bewegt 17% weniger Gewichtsdaten und gewinnt beim Decode auf Ada und L4. Tabelle 5 des Whitepapers (Build vom 2026-09-16) weicht ab, zum Beispiel RTX 5090 142.5 / 134.4, RTX 4090 90.9 / 96.7. KNOWN_ISSUES: Die fertigen Linux-Binaries decodieren auf der RTX 5090 unregelmäßig (#199, mit -DCMAKE_CUDA_ARCHITECTURES=120a-real bauen).
Runtime. Fork-Release prism-b10777-e3de715 (Commit e3de7152), veröffentlicht am 2026-10-14T15:26:33Z. Linux-CUDA-Tarballs: 12.4 326,799,565 B, 12.8 208,198,074 B, 13.3 183,998,027 B, dazu Builds für macOS, iOS, Android, CPU, Vulkan, ROCm 7.2, SYCL und Windows. setup.sh von Bonsai-demo pinnt es (Commit #262, 2026-10-15). Card: Das normale llama.cpp lehnt PQ2_0 und PTQ1_0 ab und lädt Q2_0 ohne Warnung, mit Müll als Ausgabe (keine Hadamard-Aktivierungs-Runtime). README von Bonsai-demo: Das offizielle Q2_0 funktioniert mit aktuellem Upstream-llama.cpp, das Bonsai 2 unterstützt; PQ2_0 und PTQ1_0 brauchen weiterhin den Fork. MODEL-FORMATS.md: Ältere Builds konnten Q2_0 ohne die Transformationen laden und Kauderwelsch erzeugen. Ollama und LM Studio (GGUF) können PQ2_0/PTQ1_0 ebenfalls nicht laden. KNOWN_ISSUES (zuletzt geprüft am 2026-09-23, vor b10777, manche Punkte können also veraltet sein): CUDA 13.3 segfaultet auf manchen Linux-Systemen (#222, unter Linux 12.8 nehmen, unter Windows 12.4); reasoning_effort: "high" gibt HTTP 500 zurück (das Template akzeptiert low, medium, xhigh; low verhält sich ähnlich wie xhigh); 500, wenn die Systemnachricht nicht zuerst kommt oder es zwei gibt; Thinking-Budget in chat_template_kwargs wird ignoriert; fehlerhafte oder sich wiederholende Tool Calls; Schleifen bei manchen Prompts mit xhigh; das F16-GGUF lädt im normalen llama.cpp, aber die Ausgabe ist verstümmelt; selbst quantisierte PQ2_0/PTQ1_0 haben keine prism.hadamard.*-Metadaten und erzeugen Unsinn. Der Quickstart der Card nutzt llama-cli -c 32768 -n 16384; KNOWN_ISSUES schlägt -c 65536 vor. Sampling im Thinking-Modus: temperature 1.0, top_p 0.95, top_k 20, min_p 0.05. Bonsai-demo: FP16-KV-Cache 64 KiB/Token, BONSAI_KV4=1 etwa 18 KiB/Token.
Unser Setup. RunPod RTX 4090 24 GB, SECURE (COMMUNITY 4090 und L4 antworteten mit 409), Treiber 570.158.01 (CUDA 12.8), Limit 450 W. Worker per Bootstrap von einem lokalen InferenceKey-Manager über HTTP- und TCP-Tunnel eingerichtet (ssh.direct nach 27.4 s, Worker-Binary mit 25,243,632 B per SFTP in 62 s, fertig 122 s nach dem POST des Pods). Produktion nie angefasst. Custom Python Backend ternary-bonsai-2-27b 0.1.0 (Paket mit 5,957 B): lädt den Tarball linux-cuda-12.8 des Forks, das PTQ1_0-GGUF und mmproj Q8_0 herunter, ergänzt nvidia-cuda-runtime-cu12==12.8.* und nvidia-cublas-cu12==12.8.* (der Tarball linkt libcudart.so.12 und libcublas.so.12, ohne sie mitzuliefern) in LD_LIBRARY_PATH, startet llama-server wie oben auf einem Loopback-Port. Setzt reasoning_effort standardmäßig auf medium, bildet high auf xhigh ab, fasst Systemnachrichten zu einer führenden Nachricht zusammen, max_tokens 16,384. Commit des SDK-Beispiels 7a1d7883 auf inferencekey-sdk main.
Zeit bis bereit. ensure() bis bereit 54.6 s auf einem Pod, dessen Worker schon eingerichtet war: venv + Requirements 16.7 s (1.1 GB), Downloads 31.5 s (etwa 210 MB/s), Laden des Servers 4.1 s, setup_s 35.6. PQ2_0 (7.21 GB) separat in 24 s heruntergeladen.
Speicher und Leistung. Im Betrieb: llama-server 11,662 MiB; Spitze der GPU insgesamt 11,672 MiB (11.4 GiB, etwa 12.2 GB) von 24,564 mit -c 65536, n_slots = 4, n_ctx_slot = 65536, kv_unified = true, mmproj geladen, einschließlich des Prompts mit 33,840 Tokens und vier parallelen Anfragen; 12,892 MiB frei. Mit kv_unified teilen sich die 4 Slots den KV-Pool von 65,536 Tokens, nicht 65K pro Slot. Die GPU insgesamt stieg nur auf 19,403 MiB, während llama-bench neben dem Server lief. Spitzenleistung 445.1 W während llama-bench.
llama-bench (Build e3de71522 (10777), -ngl 99 -fa 1 -p 512 -n 128 -r 3): PTQ1_0 (5.53 GiB, 26.90 B) pp512 3,279 +- 427, tg128 105.78 +- 0.56; PQ2_0 (6.70 GiB) pp512 3,230 +- 433, tg128 94.50 +- 0.41. Beide über der RTX-4090-Zeile der Card (91.1 und 81.2). PTQ1_0 decodierte auf dieser Ada-GPU schneller, wie es die Card sagt.
Pro Anfrage (/v1/chat/completions ohne Streaming, System-Prompt "You are a helpful assistant", max_tokens 16,384, Zeiten von llama-server):
| Fall | Effort | Prompt-Tok | Ausgabe-Tok | Gen tok/s | Prompt tok/s | Round Trip s |
|---|---|---|---|---|---|---|
| Roboterakku | medium | 77 | 371 | 103.9 | 186 | 5.31 |
| Roboterakku | xhigh | 115 | 250 | 103.4 | 413 | 3.75 |
| Sitzordnungsrätsel | medium | 74 | 1,447 | 104.2 | 255 | 14.73 |
| Sitzordnungsrätsel | xhigh | 74 | 670 | 103.7 | 256 | 7.62 |
| merge_intervals | medium | 52 | 756 | 104.2 | 274 | 8.42 |
| Spanische Zusammenfassung | none | 40 | 73 | 101.4 | 139 | 1.87 |
| Speisekarte OCR | medium | 617 | 230 | 103.2 | 1,189 | 4.34 |
| Äpfel zählen | medium | 346 | 219 | 103.1 | 832 | 3.79 |
| Ramen beschreiben | none | 607 | 64 | 101.2 | 1,023 | 3.34 |
| Nadel, 33,840 Tok | none | 33,840 | 11 | 68.0 | 2,843 | 13.53 |
Median der Generierung 103.6 tok/s über 12 aufeinanderfolgende Anfragen (101.2 bis 104.4). Overhead der Plattform bei kurzen Antworten 0.3 bis 0.6 s (Round Trip minus Gesamtzeit des Backends, lokaler Manager über einen Tunnel). finish_reason: stop bei allen 17 Benchmark-Anfragen. Je eine Stichprobe bei temperature 1.0: Das Sitzordnungsrätsel brauchte 1,447 Tokens mit medium und 670 mit xhigh, die Roboterfrage 371 und 250. Zwei Stichproben können nicht sagen, ob medium normalerweise länger oder kürzer ist.
Concurrency. Vier parallele Anfragen mit dem Standardwert der Zuweisung max_in_flight 1: 22.4 s Wall Time (Round Trips 6.7, 10.6, 13.9, 22.4 s). Nach PATCH /api/projects/<pid>/assignments/<workload>/<worker> {"max_in_flight": 8}: 9.6 s Wall Time, 68.4 bis 78.1 tok/s pro Anfrage, 1,524 Tokens, etwa 159 tok/s insgesamt.
Probleme der Plattform. (1) stream: true mit einem Custom Backend gibt HTTP 200 mit data: {"error":{"code":"unknown_backend",...}} und dann [DONE] zurück: run_streaming_inference in crates/worker/src/jobs.rs behandelt nur die eingebauten Backends für Ollama und OpenAI-kompatible Server. (2) custom_backend_process gibt output.to_string() zurück, und chat_choice_from_out legt das als JSON-String in message.content, usage komplett null. (3) ensure() mit einer worker_id legt die Zuweisung mit max_in_flight 1 an. (4) Der Worker startet python -m inferencekey.backend.serve ohne --config-json, also ist ctx.config leer. (5) Client-Timeout des Workers für /process 300 s bei Custom Backends. (6) Das eingebaute Backend llamacpp zieht llama.cpp von ggml-org (asset_download_url hart codiert, Standard-Tag b9748). (7) SFTP der Worker-Binary mit 25 MB dauerte 62 s. (8) Kosmetik im Panel: Spalte Access zeigt "No access" bei einem funktionierenden Wildcard-Key, "GPU telemetry partial".
Aufräumen. Workload und Pod gelöscht (RunPod danach 404), Tunnel, NATS, Datenbank und MinIO-Objekte entfernt.
Grenzen. Etwa 20 eigene Anfragen, ein oder zwei Stichproben pro Frage, temperature 1.0, die meisten mit mittlerem Effort. Alle Qualitäts-Benchmarks sind die von Prism ML. Kein Tool Calling, kein sehr langes Reasoning mit xhigh, keine Betriebszahlen für PQ2_0 über InferenceKey (nur llama-bench), kein Test mit dem normalen llama.cpp, ein einziges GPU-Modell.
Quellen: Model Card, KNOWN_ISSUES, Whitepaper, Bonsai-demo, Fork-Release prism-b10777, Qwen3.8-27B, SpinQuant, SDK-Beispiel, Demovideo, Video von AI Search.