AstaBrief-8B: un informe de investigación con citas a partir de tus propias fuentes, en una GPU de 24 GB
AstaBrief-8B de Ai2 convierte una pregunta y tus propios fragmentos en un informe con citas. Lo probamos en una GPU de 24 GB y contamos cada cita.
"Note that the current year is 2025." Esa línea está en mitad de un fichero de texto de una página que el Allen Institute for AI (Ai2) publicó junto a su nuevo modelo. El fichero contiene exactamente las instrucciones con las que se entrenó AstaBrief-8B, y la model card lo dice sin rodeos: si usas otro prompt puedes obtener un "degraded or inconsistent behavior" (un comportamiento peor o incoherente). Así que dejas el fichero tal cual, con su 2025 incluido, y rellenas dos huecos: tu pregunta y los pasajes de artículos o documentos que haya encontrado tu propia búsqueda. Lo que sale es un informe por secciones, con un resumen corto en cada sección y una referencia detrás de cada afirmación. ¿Creerá que sigue siendo 2025? En nuestros informes nunca afirmó un año equivocado, aunque no comprobamos si trata los artículos de 2025 como lo más reciente que existe.
El tamaño no es nuevo, porque un modelo de 8B parámetros lleva tiempo entrando en una tarjeta de 24 GB; lo nuevo es el entrenamiento. AstaBrief es un modelo abierto de ese tamaño entrenado para una sola tarea, el paso de redacción del "deep research" (las herramientas de IA que leen decenas de fuentes y te entregan un informe), con un prompt fijo, y Ai2 ha publicado cómo puntúa frente a su propio sistema de varios pasos, más lento. Lo ejecutamos en una sola tarjeta NVIDIA de 24 GB y contamos cada referencia que escribió. Esto es lo que te llevas:
| Qué | Resultado |
|---|---|
| Modelo | AstaBrief-8B de Ai2: el modelo abierto Qwen3-8B de Alibaba (8B parámetros), reentrenado para escribir informes con citas. Los pesos se pueden descargar libremente y usar con fines comerciales (licencia Apache 2.0). El prompt que recomienda Ai2 es solo para uso no comercial (ver más abajo). Una descarga de 16,4 GB |
| Nota de Ai2 en 100 preguntas de investigación reales | 87,0 sobre 100, frente a 77,3 del modelo del que partió |
| GPU que usamos | una NVIDIA RTX A5000, una tarjeta de 24 GB |
| Memoria usada | unos 22 GB de 24 GB en el pico |
| Velocidad para un informe | alrededor de un minuto (de 40 a 65 s), escribiendo unos 39 tokens por segundo (un token equivale más o menos a tres cuartos de una palabra) |
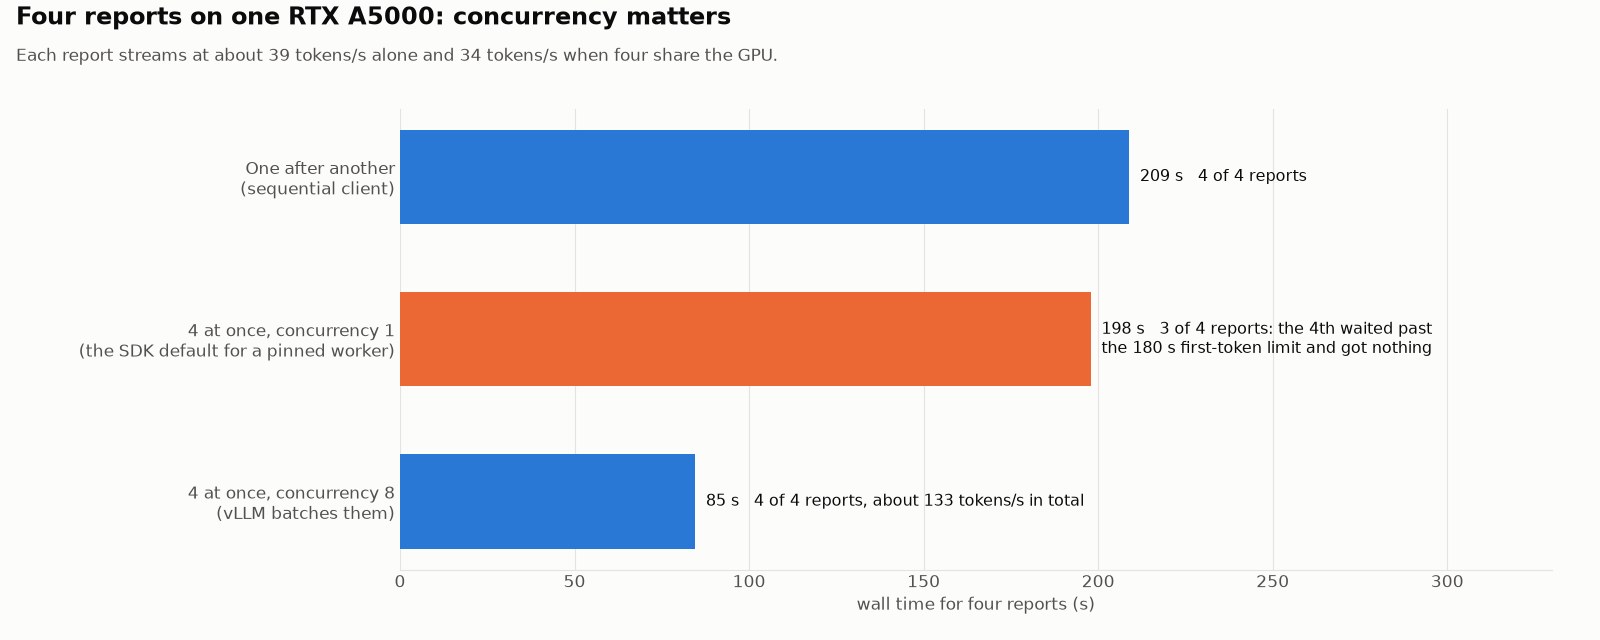
| Cuatro informes a la vez | 85 s para los cuatro, frente a 209 s uno detrás de otro |
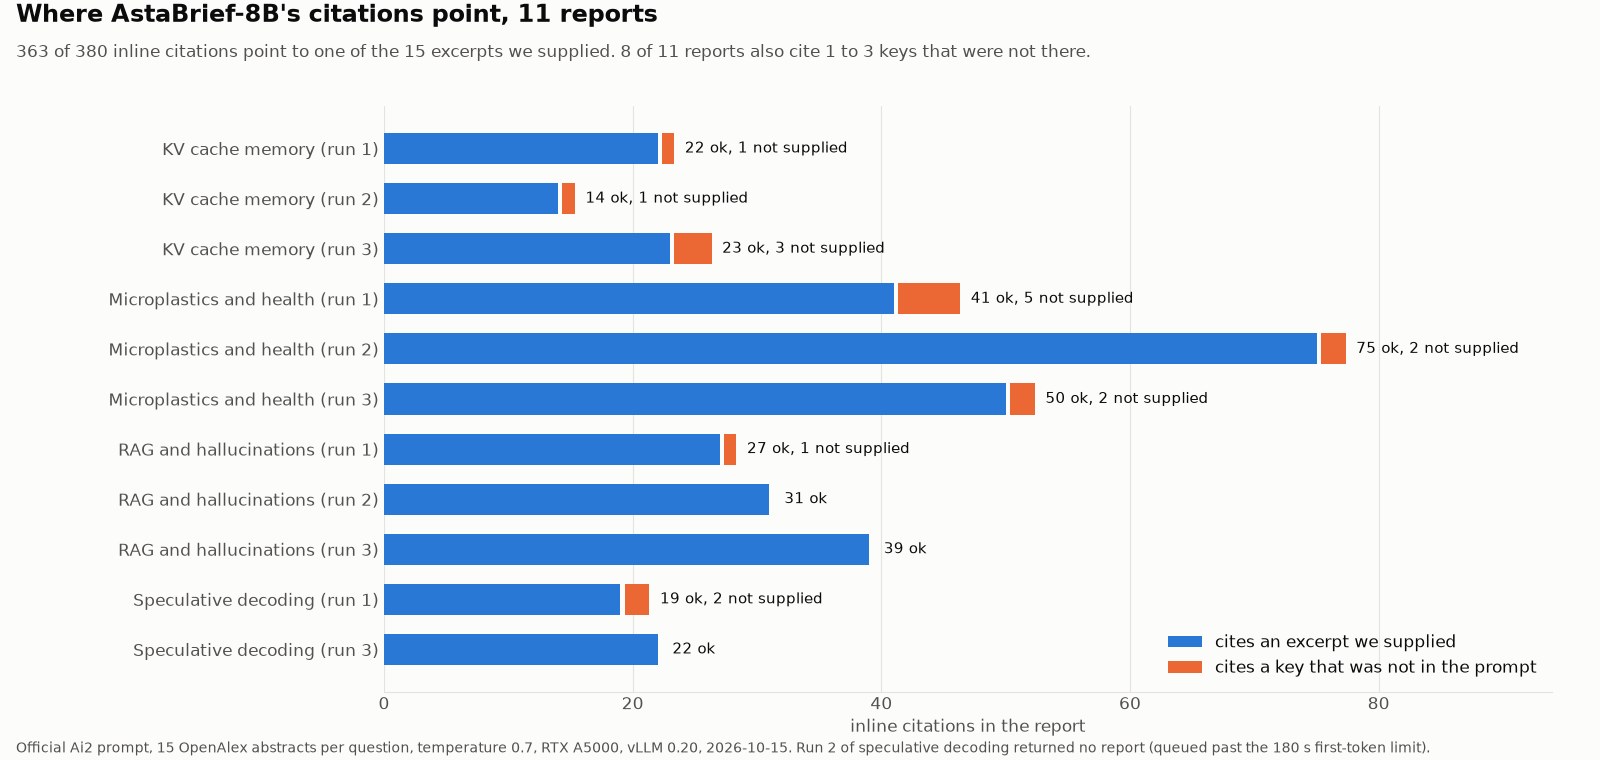
| Referencias comprobadas | 363 de 380 apuntan a un pasaje que le dimos (95,5 %) |
| La pega | 8 de 11 informes citan además de 1 a 3 fuentes que no estaban en el prompt |
Un examen a libro abierto con números de página
La forma más fácil de entender lo que hace AstaBrief es imaginar un examen a libro abierto en el que cada frase tiene que llevar un número de página. Le das al modelo el libro: 15 fragmentos cortos, cada uno con una etiqueta formada por un ID, el primer autor, el año y el número de citas (cuántos otros artículos citan ese artículo). El modelo escribe su respuesta y pone entre corchetes, detrás de cada afirmación, la etiqueta del fragmento que ha usado. Cuando dice algo que no está en el libro, el prompt le pide que lo marque como "(LLM Memory)", lo que el modelo recuerda por su cuenta.
Esta separación es lo que hace que el resultado se pueda comprobar. Una etiqueta entre corchetes o coincide con un fragmento que le diste, o no coincide. Para hacer esa comprobación no necesitas entender el artículo, te basta con la lista de etiquetas que enviaste.
Qué ha publicado Ai2
El 2 de octubre Ai2 publicó AstaBrief como código abierto, el modelo que hay detrás del "Fast mode" de la función de informes de Asta, su asistente de investigación. A su lado, Asta mantiene un "Thinking mode" que funciona con Claude. El sistema anterior trabaja por etapas: resume los fragmentos recuperados, los agrupa y luego redacta. AstaBrief se salta el paso intermedio y escribe el informe entero de una vez. Con todo el sistema de Asta, Ai2 midió una media de 51,1 s por informe en Fast mode frente a 178,5 s en Thinking mode.
Ai2 partió de Qwen3-8B y le enseñó unos 47.000 informes de ejemplo escritos por sus herramientas existentes funcionando con modelos de Claude y de OpenAI, para preguntas sacadas de consultas reales de los registros de Asta. Después le enseñó unos 6.000 pares de informes, uno mejor y otro peor, elegidos por dos evaluadores de IA, y solo se quedó con un par cuando los dos evaluadores coincidían. Ai2 dice que esto fue más estable y más barato que las alternativas, y que la mayor mejora vino de descartar los informes de ejemplo con pocas citas.
Hay una diferencia de licencias que conviene conocer antes de construir nada. El modelo se puede descargar sin pedir permiso y usar con fines comerciales (Apache 2.0), pero el fichero de instrucciones y los pares de informes mejor/peor son solo para uso no comercial (CC-BY-NC-4.0), y Ai2 describe el modelo como pensado para investigación y educación. Como el fichero de instrucciones es no comercial, no incluimos una copia en nuestro código: nuestro script de ejemplo lo descarga de Ai2 cada vez que se ejecuta. Eso no cambia sus condiciones. Quien ejecute el script usa el prompt bajo la licencia no comercial de Ai2.
Ai2 también defiende ejecutarlo en casa. Su blog dice que los pesos abiertos permiten a las instituciones ejecutar AstaBrief en su propia infraestructura, "which is necessary when research questions reveal sensitive or unpublished work" (algo necesario cuando las preguntas de investigación revelan trabajo sensible o sin publicar), y ha publicado un flujo de ejemplo que los investigadores pueden adaptar para hacer informes a partir de sus propios PDF.
Lo bueno que es, según las cifras de Ai2
Ai2 lo evaluó con 100 preguntas de investigación en informática escritas por usuarios reales. AstaBrief-8B saca 87,0 sobre 100, frente a 77,3 del Qwen3-8B sin modificar, y la mejora está sobre todo en las referencias. Ai2 comprueba si cada afirmación está totalmente respaldada por las fuentes que el informe da para ella: eso se cumple en unas 78 de cada 100 afirmaciones con AstaBrief, frente a unas 65 con el modelo sin modificar. Y de las fuentes que da, unas 9 de cada 10 respaldan de verdad la afirmación, cuando antes eran unas 3 de cada 4. La única puntuación que bajó, muy ligeramente, es la medida de Ai2 de cuánto de cada respuesta se ciñe a la pregunta: 90,6 antes, 89,0 después.
En la comparación directa de Ai2 con el informe de su sistema de varios pasos, más lento, se prefirió el informe de AstaBrief en unas 7 de cada 10 preguntas de prueba (y en algo más de la mitad de otro conjunto de preguntas que Ai2 usó durante el desarrollo). Esa comparación la juzgó un modelo de IA, y la tabla de la model card no dice cuál. La propia Ai2 describe el resultado como "competitive with" (competitivo con). Otro modelo de Ai2 del mismo tamaño, DR-Tulu-8B, puntúa algo más alto en la misma prueba, y en una segunda prueba AstaBrief queda el último de los tres, con unos 54 frente a 56 y 60. En un estudio pequeño con tres investigadores, DR-Tulu fue el preferido en conjunto, mientras que dos de los tres prefirieron AstaBrief por la precisión de sus citas.
Ai2 señala además un límite que sus puntuaciones no detectan: un modelo puede citar el estudio correcto y aun así exagerar lo que encontró.
Cómo lo ejecutamos en InferenceKey
La tarjeta y el software
Para el software que lo ejecuta, AstaBrief-8B es un modelo Qwen3 más, así que funciona en vLLM, el programa de código abierto para servir modelos que viene integrado en InferenceKey, sin código a medida. Alquilamos una NVIDIA RTX A5000 en RunPod, una tarjeta de estación de trabajo de 24 GB, de la misma clase de memoria que una RTX 4090 para juegos. Nuestro software necesita un driver de NVIDIA reciente, así que solo alquilamos máquinas que lo tuvieran. Ese requisito es nuestro, no del modelo.
El modelo ocupa 16,4 GB de los 24 GB de la tarjeta. Dejamos que cada petición llegara a unos 16.000 tokens (pregunta, fragmentos e informe juntos), la longitud que usó Ai2 en su última ronda de entrenamiento. Eso deja sitio para dos peticiones de esa longitud máxima a la vez, o para unas cuatro del tamaño que enviamos en realidad (unos 7.000 tokens cada una, pregunta más informe).
Los pasos
Nuestro ejemplo del SDK (un script de Python listo para usar con la librería de InferenceKey) lo hace todo en un solo script: le dice a InferenceKey que ejecute el modelo en tu máquina con GPU, espera a que el modelo esté listo, construye el prompt de Ai2 a partir de tu pregunta y tus fragmentos, pide un informe y apaga el modelo al final. Lo esencial:
MODEL = "allenai/AstaBrief_8B"
COMMAND = f"vllm serve {MODEL} --max-model-len 16384 --dtype bfloat16"

spec = WorkloadSpec(
    name="AstaBrief-8B cited reports (vLLM)",
    slug="astabrief-8b",
    model=MODEL,
    backend=Backend.VLLM,
    command=COMMAND,
    task_type="text2text",
    worker_id=os.environ["IK_WORKER_ID"],
    execution_policy=ExecutionPolicy.FIXED,
    execution_policy_config={"replicas": 1},
)
ref = mgmt.ensure(spec)
mgmt.wait_until_ready(ref.workload_slug, timeout=1800)
out = DataClient.from_env().endpoint(ref.workload_slug).generate_text(
    messages=[{"role": "user", "content": build_prompt(query, references)}],
    temperature=0.7, max_tokens=4096,
)
El script descarga las instrucciones de Ai2 y le pone a cada uno de tus fragmentos el mismo tipo de etiqueta que el modelo vio en el entrenamiento: un ID, el autor, el año y el número de citas. Ejecuta python main.py para los seis fragmentos de ejemplo que trae, o python main.py my_references.json para los tuyos. El modelo responde en el mismo formato que el servicio de OpenAI, así que el código que tu equipo ya escribió para OpenAI puede hablar con él cambiando una dirección.
Hicimos la prueba con una copia privada de InferenceKey, nunca con el servicio en producción. Para usar material real, hicimos 4 preguntas (tres sobre cómo hacer los modelos de IA más rápidos y fiables, y una sobre microplásticos y salud) y a cada una le dimos los resúmenes de 15 artículos de OpenAlex, un catálogo gratuito de artículos de investigación.
Lo que medimos
Un informe tarda alrededor de un minuto (de 41,5 a 64,7 s con la tarjeta para él solo). Arrancar el modelo en una máquina recién alquilada es una espera única de unos cuatro minutos (245,7 s), más de la mitad (137 s) instalando el software que lo sirve. Descargar el modelo llevó 18 s, y arrancarlo, más o menos otro minuto y cuarto. En el pico, la tarjeta usó unos 22 de sus 24 GB.
Un informe empieza a aparecer segundo y medio después de pedirlo, y un informe típico tiene de 1.600 a 2.400 tokens, unas cuantas páginas.
¿Puede una tarjeta escribir varios informes a la vez? Sí. Cuatro informes enviados juntos terminaron en 85 s, frente a 209 s uno detrás de otro. Cada informe tardó un poco más por separado (de 52 a 85 s en lugar de 42 a 65 s), pero los cuatro estaban listos en menos de minuto y medio. Los informes no salían idénticos de una ejecución a otra, así que tómalo como una imagen fiel más que como un tiempo exacto.
Para llegar ahí hizo falta un ajuste: cuántas peticiones puede atender el modelo a la vez (el gráfico lo llama "concurrency"). El nuestro empezó en una, y en el primer intento los cuatro informes se pusieron en cola: 198 s, y un informe perdido (ver más abajo).
Comprobando los números de página
Volvamos al examen a libro abierto. En 11 informes (uno de ellos cortado en el tope de 4.096 tokens), el modelo escribió 380 referencias, y 363 de ellas, el 95,5 %, apuntan a un fragmento que le dimos. Además aprovechó bien el libro: cada informe usó entre 11 y 15 de sus 15 fuentes.
Las otras 17 son lo que hay que tener previsto. En 8 de los 11 informes el modelo citó de 1 a 3 etiquetas que no estaban en el prompt. Algunas son un artículo que le dimos con la etiqueta estropeada: un artículo de Thapliyal de 2025 volvió sin la W al principio de su ID, con el último dígito cambiado y un número de citas de 111 en lugar de 45 (los artículos que lo citan). Otras son artículos que salen de la memoria del modelo, como un artículo de Derraik de 2002 con 2.594 citas, escrito exactamente con el mismo formato de etiqueta que los fragmentos reales y sin la marca "(LLM Memory)". El mecanismo que el propio prompt prevé para esa marca se usó una vez en 11 informes.
También vimos que los detalles se desvían. Un informe se equivocó en el número de citas de un artículo (cuántos otros artículos lo citan): escribió 25 en lugar de 27, siete veces. En la ejecución corta de ejemplo, el informe convirtió "un octavo" de un coste en "1/4 cost", y añadió una sección sin ninguna referencia. Es justo el límite del que avisaba Ai2: la fuente correcta junto a una afirmación que no es exactamente lo que dice la fuente.
La solución práctica es barata. Como conoces todas las etiquetas que enviaste, unas pocas líneas de código pueden marcar cualquier corchete del informe que no coincida con ninguna de ellas antes de que lo lea una persona. Las cifras que vienen de los fragmentos merecen en cualquier caso una segunda lectura de una persona: comprobar las referencias sigue siendo trabajo tuyo.
El vídeo de la demo
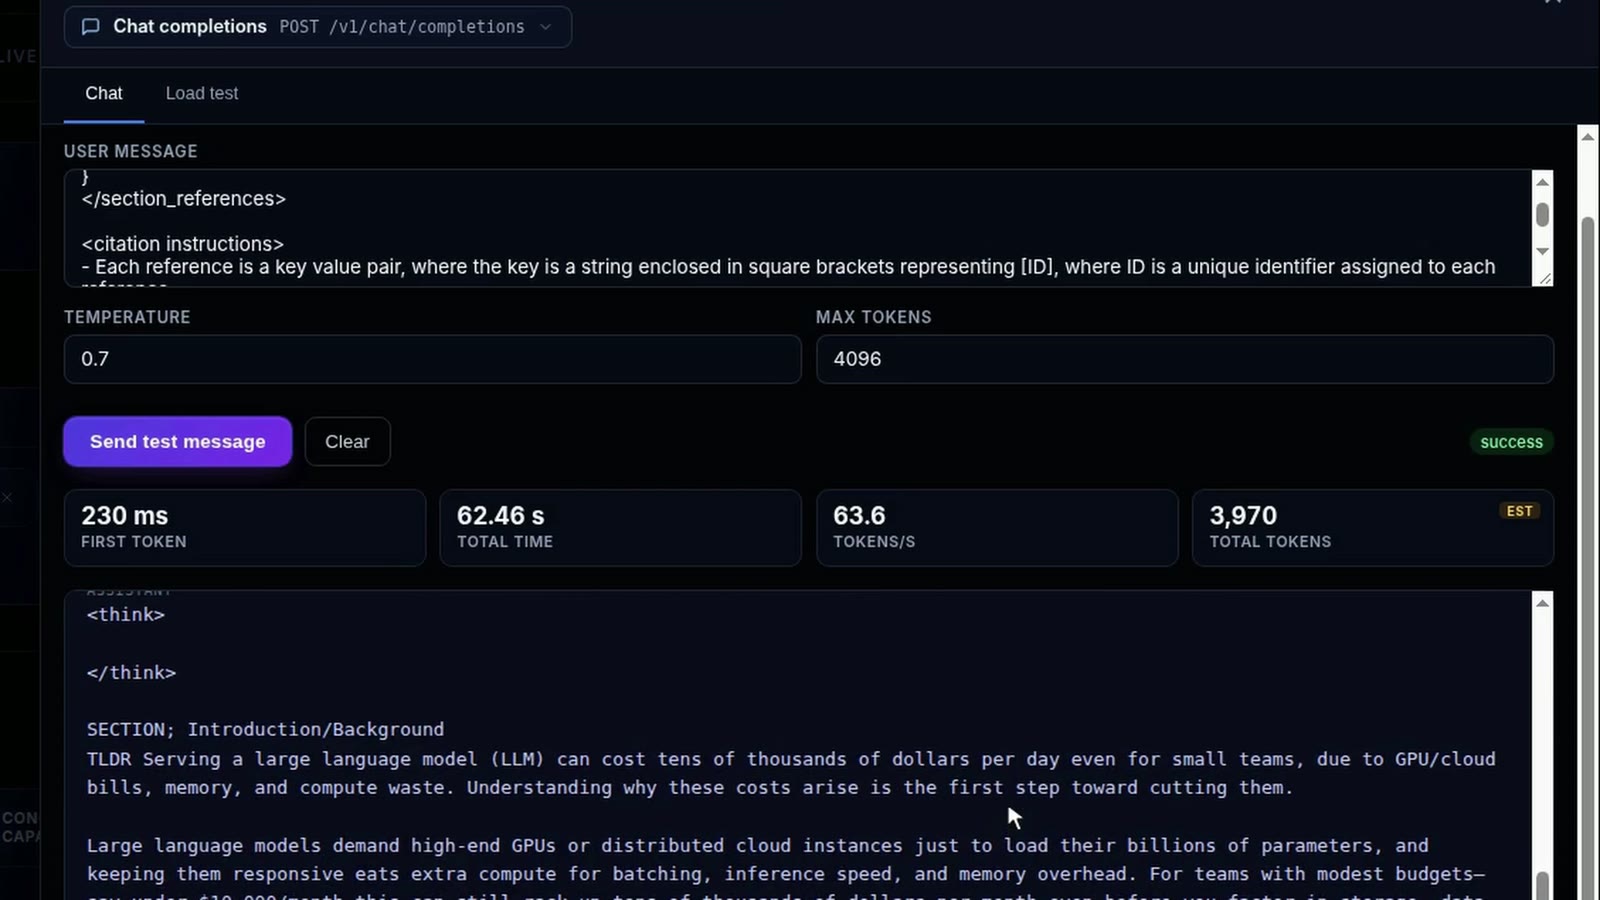
El vídeo muestra el modelo funcionando en la RTX A5000 en el panel de InferenceKey, el prompt de Ai2 relleno con los seis fragmentos de ejemplo en la pantalla de pruebas integrada, y el informe apareciendo sección a sección. Con solo seis fragmentos cortos de ejemplo que leer, en lugar de quince, las primeras palabras aparecieron en menos de un cuarto de segundo (230 ms), y el informe entero tardó alrededor de un minuto (62,46 s).
Qué salió mal
Dos problemas fueron nuestros, de la plataforma. El primero tiene hoy un apaño; el segundo todavía no tiene arreglo.
- Un modelo atado a una GPU atiende una sola petición a la vez. Cuando nuestro SDK fija un modelo a una máquina con GPU concreta, la plataforma solo le deja atender una petición a la vez. Si se añade de cualquier otra forma, atiende hasta 20 por defecto. Por eso se pusieron en cola los cuatro informes de arriba. Es un bug nuestro, y hoy se arregla con una llamada de configuración (detalles en "Para ingenieros").
- Una espera larga acaba en una respuesta vacía. Una petición que espera más de 3 minutos a su primera palabra se cierra con una respuesta vacía y sin error, mientras la GPU sigue escribiendo el informe para nadie (107 s más en nuestro caso). Debería devolver un error claro y cancelar el trabajo. Todavía no tenemos arreglo para esto.
El resto es cosa del modelo o del mercado de alquiler. La salida necesita una limpieza ligera antes de que nadie la lea. Todos los informes empiezan con una etiqueta de "thinking" vacía, como escriben los modelos Qwen3 cuando el razonamiento está activado (no probamos a desactivarlo), y los resúmenes de sección vienen marcados de forma algo distinta a lo que pide el prompt. Las dos cosas se quitan fácilmente con unas pocas líneas de código. Cambiar nuestras etiquetas de fuente por números simples hizo que el modelo dejara de comerse una letra, pero aun así escribió etiquetas equivocadas para dos artículos que le dimos, así que la comprobación de etiquetas no es opcional. Nuestras notas de la ejecución también recogen un trozo del propio marcado de los datos de entrenamiento en mitad de un informe; no lo volvimos a comprobar, pero merece la pena añadir un filtro de limpieza sencillo.
Quién hizo qué
El equipo de Asta de Ai2 construyó y publicó AstaBrief: los datos de entrenamiento a partir de los registros y sistemas de Asta, las dos rondas de entrenamiento con su propio código de entrenamiento de código abierto (open-instruct) en 8 de las grandes GPU de centro de datos de NVIDIA (H100), la evaluación y el prompt. Sus informes de entrenamiento salieron de sistemas que funcionaban con modelos de Anthropic y de OpenAI, los informes rivales de la segunda ronda también salieron de modelos de DeepSeek, y GPT-4.1 y DeepSeek-R1 hicieron de evaluadores. Ai2 publicó además el flujo de ejemplo para informes a partir de tus propios PDF, y defendió ejecutar el modelo en tu propia infraestructura. El equipo de Qwen entrenó Qwen3-8B, la base sobre la que se apoya todo. El proyecto vLLM lo sirve sin cambios. Hugging Face aloja los pesos y el prompt, OpenAlex nos dio los resúmenes para tener fragmentos reales, y RunPod nos alquiló la tarjeta. Vimos el lanzamiento en un vídeo de AI Search.
Nuestra parte fue montarlo en InferenceKey, escribir el ejemplo del SDK, ejecutarlo de principio a fin en una tarjeta de 24 GB, medir velocidad y memoria, y contar cada referencia de los informes.
Qué sacar en claro
Si ya tienes un paso de búsqueda sobre tus propios documentos, AstaBrief-8B es un redactor de informes que puedes ejecutar a su lado en una tarjeta de 24 GB, con alrededor de un minuto por informe y varios a la vez. Nuestro post sobre EmbeddingGemma 2 cubre esa parte de la búsqueda. Como defiende la propia Ai2, el motivo para ejecutarlo tú mismo es el control: la pregunta, los fragmentos y el informe se quedan en una máquina que eliges tú. Para una empresa hay una condición. El prompt que recomienda Ai2 tiene una licencia solo para uso no comercial, así que un producto comercial necesita o revisar esa licencia o un prompt propio con el mismo formato, y la model card avisa de que con otro prompt el modelo puede funcionar peor.
Los límites, claros. Nuestra prueba fue pequeña: 4 preguntas, 15 resúmenes cada una, 11 informes (uno cortado en el tope de 4.096 tokens). No pusimos nota a los informes ni los comparamos con otro modelo en nuestras preguntas. Las cifras de calidad de arriba son de Ai2, y salen solo de preguntas de informática. Tres de nuestras cuatro preguntas también eran sobre IA e informática, y solo una (microplásticos) quedaba fuera de ese campo, así que no podemos decir nada de otros temas. Las entradas eran resúmenes cortos de artículos públicos, no los documentos internos de empresa para los que se plantea. Nuestros 15 fragmentos por pregunta llenaron menos de un tercio del espacio que permitimos (unos 5.000 de 16.000 tokens), así que no sabemos cómo se comporta con entradas mucho más largas.
Comprobamos que cada referencia apunta a un fragmento que enviamos. No comprobamos que cada frase diga lo que dice su fragmento. Así que el 95,5 % significa que las referencias son reales, no que las afirmaciones sean correctas. Las desviaciones de arriba son lo que vimos por el camino, no una revisión línea a línea.
Y el modelo escribe referencias con total seguridad que tienes que comprobar. Una de las etiquetas que escribió dice [4411306415 | Thapliyal et al. | 2025 | Citations: 111]. El fragmento que enviamos era [W4411306417 | Thapliyal et al. | 2025 | Citations: 45]. ¿Se darían cuenta tus lectores?
Para ingenieros
Modelo (model card, checkpoint SFT, blog de Ai2, config.json, datos DPO, Qwen3-8B base). Repo de HF allenai/AstaBrief_8B, sha 6a34f54d..., modificado por última vez el 2026-10-03, license:apache-2.0, sin acceso restringido, 1.979 descargas el último mes y 66 likes cuando lo consultamos. Linaje: Qwen3-8B-Base, Qwen3-8B, AstaBrief_8B_SFT (SFT sobre AstaBrief_SFT_Mix), AstaBrief_8B (DPO offline sobre AstaBrief_DPO_Mix), las dos etapas en open-instruct sobre 8x H100. Qwen3ForCausalLM, 36 capas, hidden 4096, intermediate 12288, 32 cabezas de query y 8 cabezas KV, head_dim 128, max_position_embeddings 40960, rope_theta 1.000.000, sin rope_scaling, vocabulario 151936, bfloat16. generation_config.json: temperature 0,6, top_k 20, top_p 0,95. El ejemplo de la card usa temperature 0,7, top_p 0,95, max_tokens 4096, stop_token_ids=[eos]. Cuatro shards safetensors, 16.381.516.824 bytes, más cuatro shards duplicados pytorch_model-*.bin y solo un pytorch_model.bin.index.json.
Entrenamiento. SFT: 5 epochs, LR 5e-06, warmup 0,03, grad accumulation 4, longitud máxima de secuencia 32.768, BF16. DPO: 7 epochs, LR 5e-06 lineal, warmup 0,1, pérdida DPO Norm, beta 10, batch por dispositivo 1, grad accumulation 8, longitud máxima de secuencia 16.000, BF16. Así que la cifra de 16K es la de la etapa DPO, no la de todo el entrenamiento. Blog: unas 90K consultas de registros de Asta filtrados, 47K ejemplos de SFT de sistemas ScholarQA con Claude 3.5 Sonnet, Claude 3.7 Sonnet, o3, o4-mini y GPT-4.1, unos 6K pares DPO (un informe de ScholarQA con Claude, el rival de o3, o4-mini, DeepSeek-V3 o DeepSeek-R1, ganador elegido por los dos jueces, GPT-4.1 y DeepSeek-R1, conservado solo si coinciden), 95 % de acuerdo con humanos. La card del dataset DPO dice 6,6k instancias, consultas de OpenScholar y Asta ScholarQA hasta junio de 2025, CC BY-NC 4.0, con las salidas de modelos de terceros sujetas a las condiciones de cada proveedor.
Evaluación de Ai2. Test ScholarQA-CS2 (media / ingredient recall / answer precision / citation precision / citation recall): Qwen3-8B 77,3 / 77,8 / 90,6 / 76,2 / 64,6, AstaBrief-8B-SFT 83,7 / 85,2 / 90,4 / 87,7 / 71,3, AstaBrief-8B 87,0 / 90,2 / 89,0 / 90,5 / 78,2. Tabla comparativa (SQA-CS2 dev / test / DeepScholarBench): Asta ScholarQA 87,6 / 86,2 / 60,25, DR-Tulu-8B 86,5 / 88,8 / 56,26 (win rate frente a Asta SQA 36 % dev, 54 % test), AstaBrief-8B 86,3 / 87,0 / 53,50 (55 % dev, 72 % test). Blog: las evaluaciones se hicieron en 2025 frente a los modelos punteros de entonces, y las métricas no miden si un informe respeta el alcance y la fuerza de sus fuentes. Uso inicial entre 374 usuarios de Asta: el 29,1 % usó Fast mode dos o más días, 3,67 hilos de informe de media, el 23 % nunca volvió a Thinking mode, feedback positivo 84,2 % Fast frente a 85,2 % Thinking (escaso).
Prompt. sft_prompt.txt, 3.154 bytes, dataset allenai/AstaBrief_prompts revisión 355b7a260fce95820a2bdf359ca1ddec920ee974, CC-BY-NC-4.0 (también contiene pairwise_judge_prompt.txt y query_filter_prompt.txt). Placeholders [QUERY] y [SECTION_REFERENCES] dentro de un bloque <section_references> de pares "[ID]": "quote". Cita en línea como [ID], conocimiento propio como (LLM Memory). Cada sección empieza con SECTION; más un nombre, luego TLDR; y un resumen de dos frases sin citas. Solo formatos LIST o SYNTHESIS. Un número de citas de 100 o más permite "notable". Las claves de entrenamiento son del tipo [230644543 | Miguel et al. | 2020 | Citations: 5].
Nuestro montaje. RunPod NVIDIA RTX A5000 24 GB, SECURE cloud (se alquila por unos 0,27 USD la hora), imagen runpod/pytorch:1.0.7-cu1300-torch291-ubuntu2404-cluster. RTX 4090, RTX A5000 y RTX 3090 COMMUNITY respondieron 409 (sin stock). Driver 580.159.04 (CUDA 13.0), límite de potencia de 230 W, compute capability 8.6. Pods filtrados con allowed_cuda_versions de 13.0 a 13.4. Bootstrap del worker 76 s después del POST del pod. Manager local de InferenceKey accesible por túneles HTTP y TCP, sin tocar producción. Backend: vllm integrado, vLLM 0.20.0 (por defecto del worker), torch 2.11.0+cu130. Comando vllm serve allenai/AstaBrief_8B --max-model-len 16384 --dtype bfloat16 (gpu-memory-utilization 0.92 es el valor efectivo que aplica el worker, no forma parte del comando). El script del SDK borra el workload al final salvo con IK_KEEP_ALIVE=1. Commit del ejemplo del SDK 728d890 en main de inferencekey-sdk (main.py, README.md, .env.example, requirements.txt, sample_references.json, .gitignore).
Tiempo hasta estar listo. 245,7 s desde ensure() hasta listo en un pod en frío: instalación de vLLM 137 s (venv de 8,1 GB), descarga de pesos 17,94 s (solo safetensors), carga de pesos 2,82 s, carga del modelo 15,27 GiB en 21,90 s, inicialización del motor 40,49 s (compilación 23,42 s), vLLM listo 91 s después de arrancar.
Memoria y potencia. KV cache 4,6 GiB = 33.472 tokens, concurrencia máxima 2,04x a 16.384 tokens por petición. Proceso de vLLM 21.850 MiB, pico total de la GPU 22.069 MiB de 24.564. Pico de potencia 230,07 W.
Por petición (prompt oficial, 15 resúmenes de OpenAlex por pregunta, temperature 0,7, max_tokens 4096, en streaming a través del gateway local, tokens contados con el tokenizador del modelo porque el stream no traía usage ni siquiera con stream_options.include_usage):
| Ejecución | Tok. prompt | Tok. informe | Primer token s | Total s | Decode tok/s |
|---|---|---|---|---|---|
| Secuencial, 4 preguntas | 4.374 a 5.068 | 1.570 a 2.444 | 1,37 a 1,58 | 41,5 a 64,7 | 38,7 a 39,1 |
| 4 a la vez, concurrency 1 | 4.359 a 5.053 | 1.472, 1.926, 4.096 (llegó a max_tokens), 0 | 1,22, luego 40,4 y 91,5 (en cola) | 38,9 a 197,9, una vacía a los 180,0 | 38,5 a 39,0 |
| 4 a la vez, concurrency 8 | 4.359 a 5.053 | 1.707 a 2.874 | 0,37 a 0,74 (prefix caching) | 51,5 a 84,6 | 33,4 a 34,2 |
Nuestros prompts (de 4,4K a 5,1K tokens) se quedaron muy por debajo del límite de 16.384 tokens, y no se midió nada cerca de él. Tiempo total para cuatro informes: 209 s en secuencia, 198 s con concurrency 1 (3 de 4 entregados), 85 s con concurrency 8. Log de vLLM durante la ejecución con concurrency 8: Avg generation throughput de 132,0 a 136,0 tokens/s con Running: 4 reqs. main.py con los 6 fragmentos de ejemplo (sin streaming): 40,9 s, 1.171 tokens de prompt, 1.563 tokens de informe, 8 secciones, 6 de 6 referencias citadas. Tester del panel: primer token 230 ms, total 62,46 s (sus 63,6 tokens/s y 3.970 tokens totales incluyen el prompt estimado).
Citas. 11 informes (uno, con concurrency 1, cortado en max_tokens 4096), 380 citas en línea, 363 (95,5 %) a un fragmento que le dimos. Por informe, dadas/no dadas: 22/1, 14/1, 23/3, 41/5, 75/2, 50/2, 27/1, 31/0, 39/0, 19/2, 22/0. 8 de 11 informes citan claves que no estaban en el prompt: 17 marcas, 11 claves distintas. Copias estropeadas de artículos que le dimos: [4411306415 | Thapliyal et al. | 2025 | Citations: 111] por [W4411306417 | Thapliyal et al. | 2025 | Citations: 45], [4414281756 | Kadac-Czapska et al. | 2025 | Citations: 13] por [W4414281754 | Kadac-Czapska et al. | 2025 | Citations: 9] (las dos en la ejecución con IDs de OpenAlex con prefijo W: W eliminada, último dígito cambiado), y, abreviados, Sheng et al. 2024 con 160 citas (clave 269117055) y Jiang et al. 2023 con 20 citas (clave 3664640) por los artículos de FlexGen y LLMLingua que le dimos. De memoria, con el mismo formato de clave y sin la marca LLM Memory: Santhanam 2023 (163), Sharma 2023 (505), Jiang 2020 (1666), Daza 2021 (87), Sala-Newhausen 2020 (352), Derraik 2002 (2594), Antonini 2021 (102). Fuentes dadas usadas por informe: de 11 a 15 de 15. Una cita [LLM Memory] en 11 informes.
Formato. Con IDs de OpenAlex como W4402683901 el modelo solía quitar la W al citar, así que las ejecuciones posteriores usaron IDs numéricos. Eso acabó con la W perdida, no con las claves equivocadas: las ejecuciones con IDs numéricos siguieron produciendo las claves de Sheng 2024 y Jiang 2023 de arriba para artículos que le dimos. Todos los informes empiezan con un bloque <think>\n\n</think> vacío (Qwen3-8B documenta que el bloque siempre está presente, posiblemente vacío, cuando el thinking está activado, y no probamos a desactivarlo). De 4 a 8 bloques SECTION; por informe. 0 de 12 ficheros guardados contienen TLDR; (una toma del tester sí lo mostró). Desviación de metadatos: Nouri 2025 citado con 25 citas en lugar de 27 (siete veces en un informe), Chen et al./80 para una clave Zixuan/25 que le dimos. La muestra de 6 fragmentos convirtió "one eighth" en "1/4 cost" y "Up to 4x cheaper", y añadió una sección "Operational considerations" sin citas. Nuestras notas de la ejecución recogen un fragmento [4]<Paper corpusId="2024" paperTitle="(2024)" isShortName></Paper> en el informe de la toma final de la demo. No lo volvimos a comprobar fotograma a fotograma. Línea del prompt "Note that the current year is 2025": un grep sobre los ficheros de informe guardados (12 informes del benchmark más 2 ejecuciones de ejemplo) no encontró ninguna frase que afirme el año actual ni haga cuentas con años; 2025 y 2026 solo aparecen como años de publicación de artículos citados (en las claves y en menciones autor-año como "Wang et al. (2025)"). No comprobamos encuadres más sutiles de lo reciente.
Problemas de la plataforma. (1) ensure() con un worker_id crea la asignación con un max_in_flight literal de 1 (insert_assignment_with_version(..., wid, 1) en crates/manager/src/services/workloads.rs), mientras que el valor por defecto de la API de asignaciones, DEFAULT_MAX_IN_FLIGHT, es 20. Apaño: PATCH /api/projects/<pid>/assignments/<workload>/<worker> con {"max_in_flight":8}, que respondió 204. (2) Todavía sin apaño. STREAM_FIRST_TOKEN_TIMEOUT_MS = 180_000 en crates/manager/src/api/openai.rs: un stream en cola terminó a los 180,02 s con HTTP 200, sin contenido y sin finish_reason, y el worker aun así completó ese trabajo en 106.767 ms. (3) Los streams a través del gateway no traían usage.
Datos de prueba. La API de Semantic Scholar respondió 429, así que usamos OpenAlex: trabajos con resumen, desde 2019, con más de 8 citas, 15 por pregunta. Tamaños de prompt de 4.359 a 5.068 tokens con el tokenizador del propio modelo.
Vídeo y limpieza. Vídeo de la demo: 1920x1080, 131,4 s. Limpieza: workload y pod borrados (RunPod devuelve 404), túneles, NATS, base de datos y el bucket vacío de MinIO eliminados.
Fuentes: model card, model card del SFT, blog de Ai2, prompt, datos DPO, Qwen3-8B, ejemplo del SDK, vídeo de la demo.