Un ChatGPT privado para cincuenta equipos, y una factura que se puede repartir
Cómo un asistente de IA privado atiende a cincuenta equipos desde una sola dirección y cómo su coste fijo por hora se convierte en una factura por equipo.
Cuando una empresa decide montar su propio asistente de IA, lo primero que preocupa suele ser el modelo: ¿será suficiente un modelo abierto? Las preguntas difíciles llegan cuando el asistente ya funciona: cómo dejar entrar a más equipos cuando las máquinas se llenan, y cómo decirle a finanzas qué equipo ha gastado qué.
Esta demo responde a las dos: cómo un asistente privado puede pasar de un equipo a cincuenta sin rehacerlo, y cómo su coste se mantiene fijo, previsible y repartido por equipos por el camino.
El vídeo (2:47, con voz en off en inglés) sigue a Nexora, una empresa mediana que nos hemos inventado. Nexora no quiere mandar sus contratos, sus tickets de soporte ni sus previsiones financieras a un servicio de IA público, así que en la historia monta su propio asistente sobre diez máquinas alquiladas en Fráncfort, cada una con una Nvidia H100 (un chip de IA de gama alta), y lo sirve con InferenceKey. Todos los departamentos llaman al mismo modelo, cada uno con sus propias claves.
La voz en off cuenta la historia como si fuera real, así que conviene decirlo desde el principio: las máquinas del vídeo son simuladas. El panel, las claves, la cola y la contabilidad son el producto de verdad. Los diez "servidores H100" son programas en modo de prueba que se comportan como servidores con GPU, pero responden con texto de relleno en vez de ejecutar un modelo. La sección de límites explica qué significa eso para cada cifra.
Esto es lo que enseñó el panel:
| Qué | En la demo |
|---|---|
| Claves, una por equipo o por caso de uso | 50 |
| A qué llega cada clave | 1 dirección, el chat de la empresa |
| Máquinas sirviendo el modelo | 10, todas en línea, 0 avisos |
| Carga constante del script de prueba | unas 4.200 peticiones por minuto |
| Coste de diez máquinas encendidas todo el mes | unos 17.500 dólares, haya el tráfico que haya |
| Coste registrado mientras existió la flota de la demo | 326,97 dólares por 134,53 horas de máquina, repartidos por clave |
La idea que hace fácil todo lo demás
Una máquina con GPU alquilada se paga por horas, como un local de ensayo. Pagas el local tanto si el grupo toca una canción como si toca cuarenta. Una API de IA pública funciona al revés: cobra por palabra, así que cada pregunta de más cuesta más. Las suscripciones por usuario lo esconden hasta que alguien choca con un límite de uso.
Eso cambia lo que significa "controlar el gasto". Con tus propias máquinas, la factura del mes se sabe de antemano. En esta demo son diez máquinas a 1.750 dólares al mes cada una, unos 17.500 dólares al mes, o 24,31 dólares la hora, escriban lo que escriban los equipos. Quedan dos cosas por gestionar: que las máquinas estén ocupadas, porque una hora parada cuesta lo mismo que una hora llena, y saber quién las ha usado, para que cada equipo vea su parte. El resto de la demo son esas dos cosas en pantalla.
Una clave por equipo
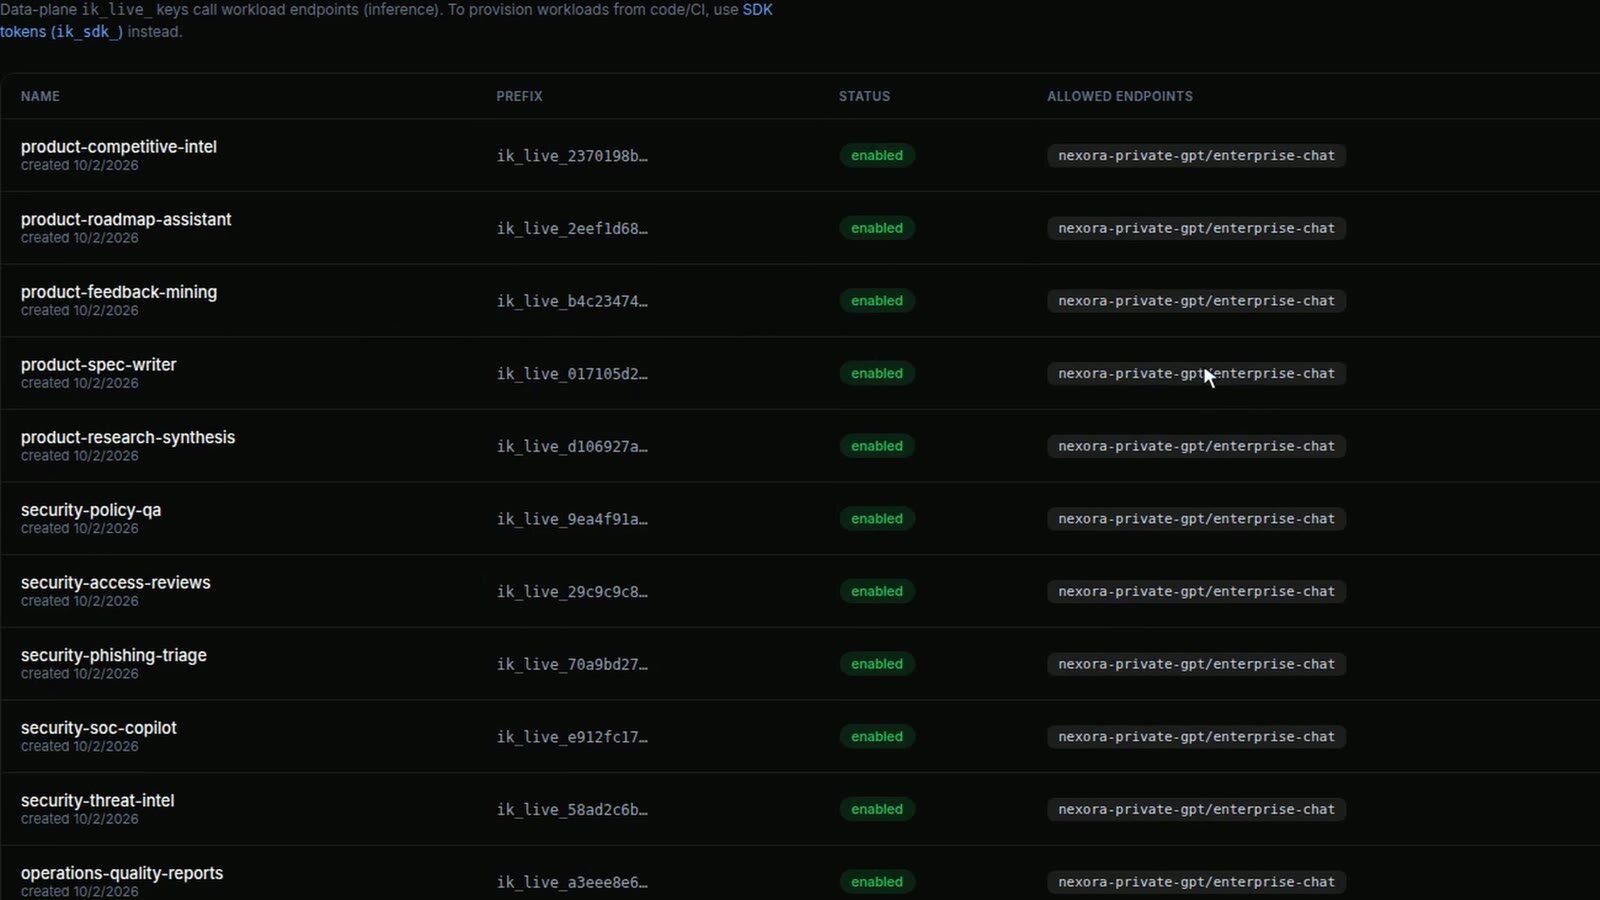
Una clave es una contraseña que usa un programa para llamar al asistente. Cada equipo tiene la suya, y a menudo cada caso de uso dentro de un equipo tiene otra: producto tiene claves para inteligencia competitiva, la hoja de ruta y las especificaciones, seguridad tiene su propio juego, y así con operaciones, finanzas, soporte y personas. Cincuenta en total. Cada clave abre una sola puerta, la dirección del chat de la empresa, así que si una clave se filtra no llega a nada más de lo que Nexora tiene en la plataforma.
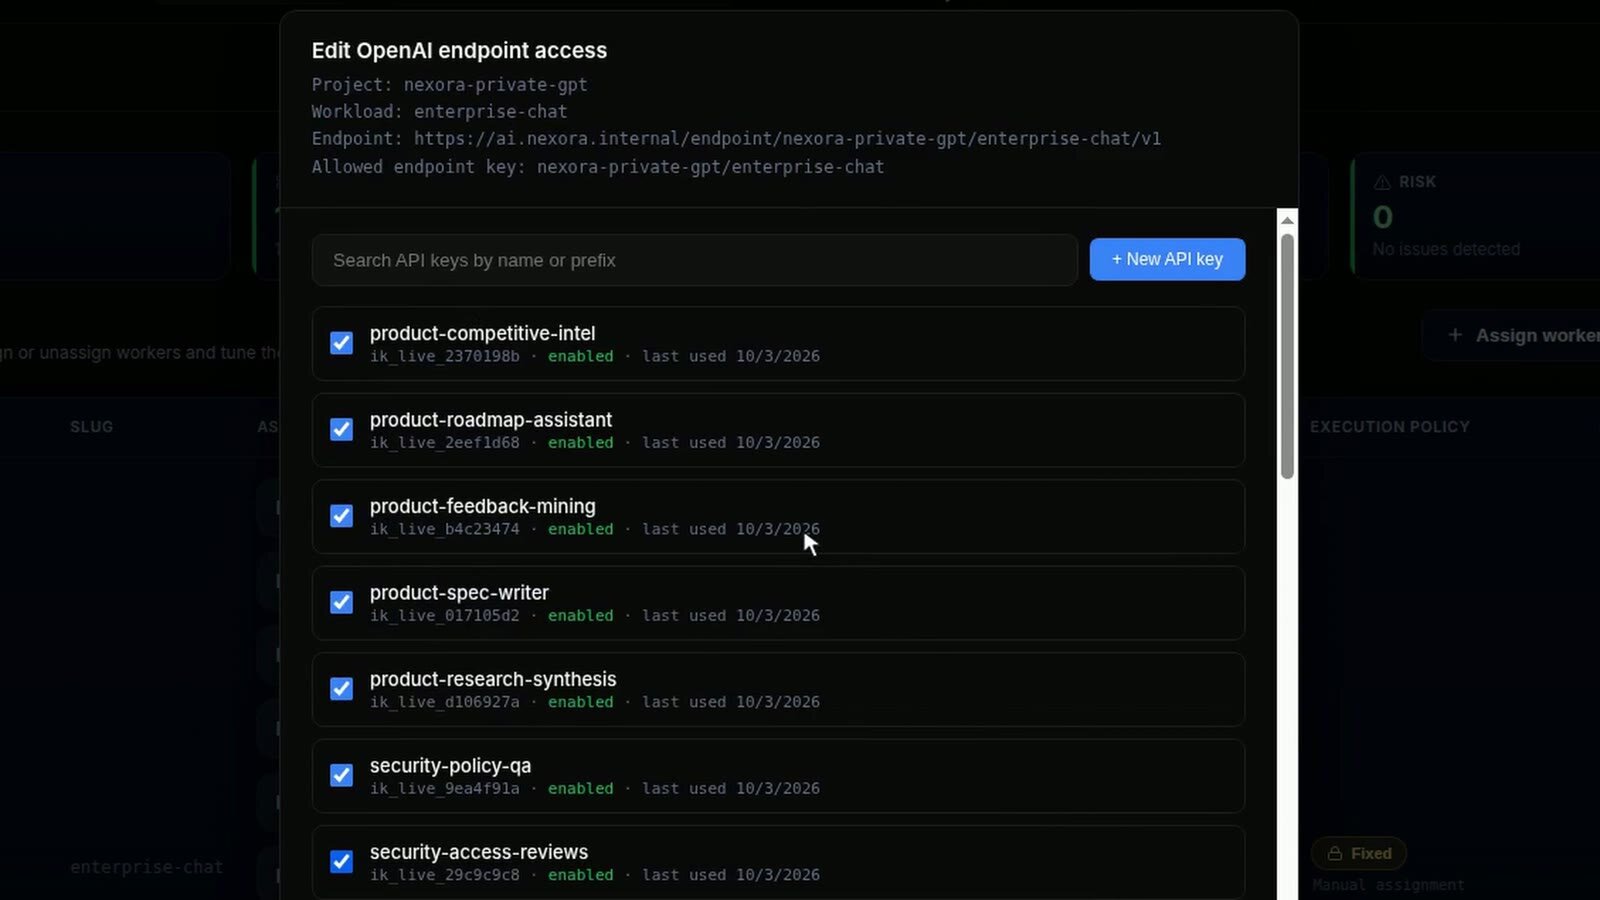
El acceso es una lista de casillas sobre esa dirección. En esta demo no hay ventana de chat: la dirección habla el mismo formato que la API de OpenAI, así que cualquier aplicación de chat o herramienta interna que ya funcione con OpenAI puede usarla cambiando una dirección y una clave. Dar de alta a un equipo es crear una clave y marcarla. Darlo de baja es desmarcarla o desactivar su clave.
Un modelo, diez máquinas
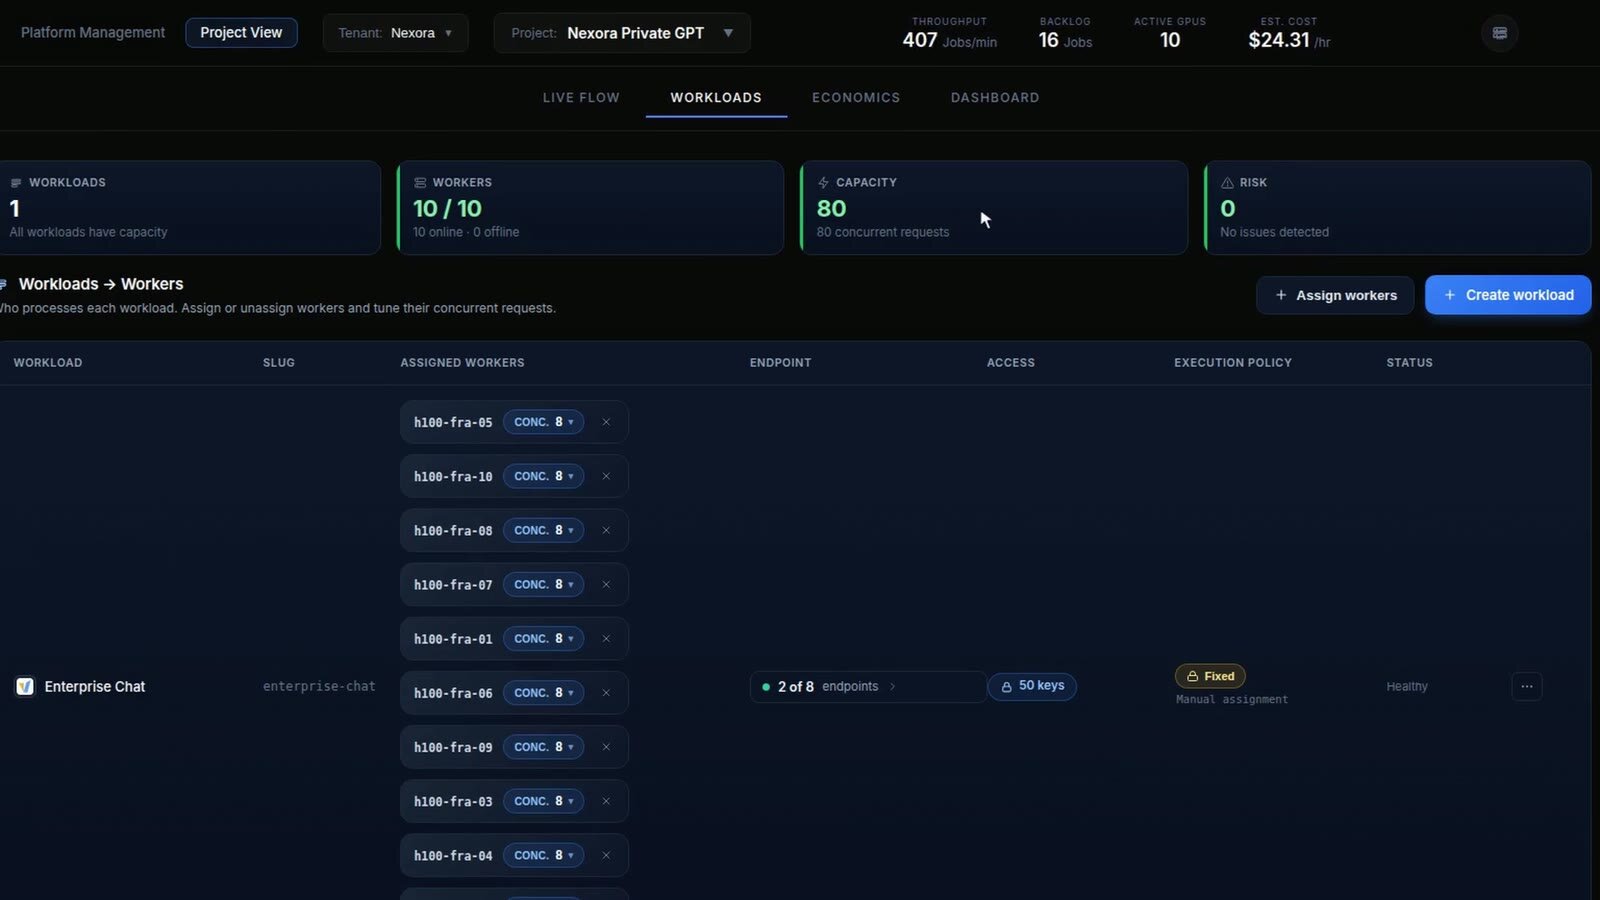
Detrás de esa dirección hay un solo modelo, el chat de la empresa. Lo sirven diez máquinas (en la historia, cada una con su propia copia del modelo), y el panel llama worker a cada máquina. Cada worker atiende ocho peticiones a la vez, así que la flota puede trabajar en 80 peticiones al mismo tiempo.
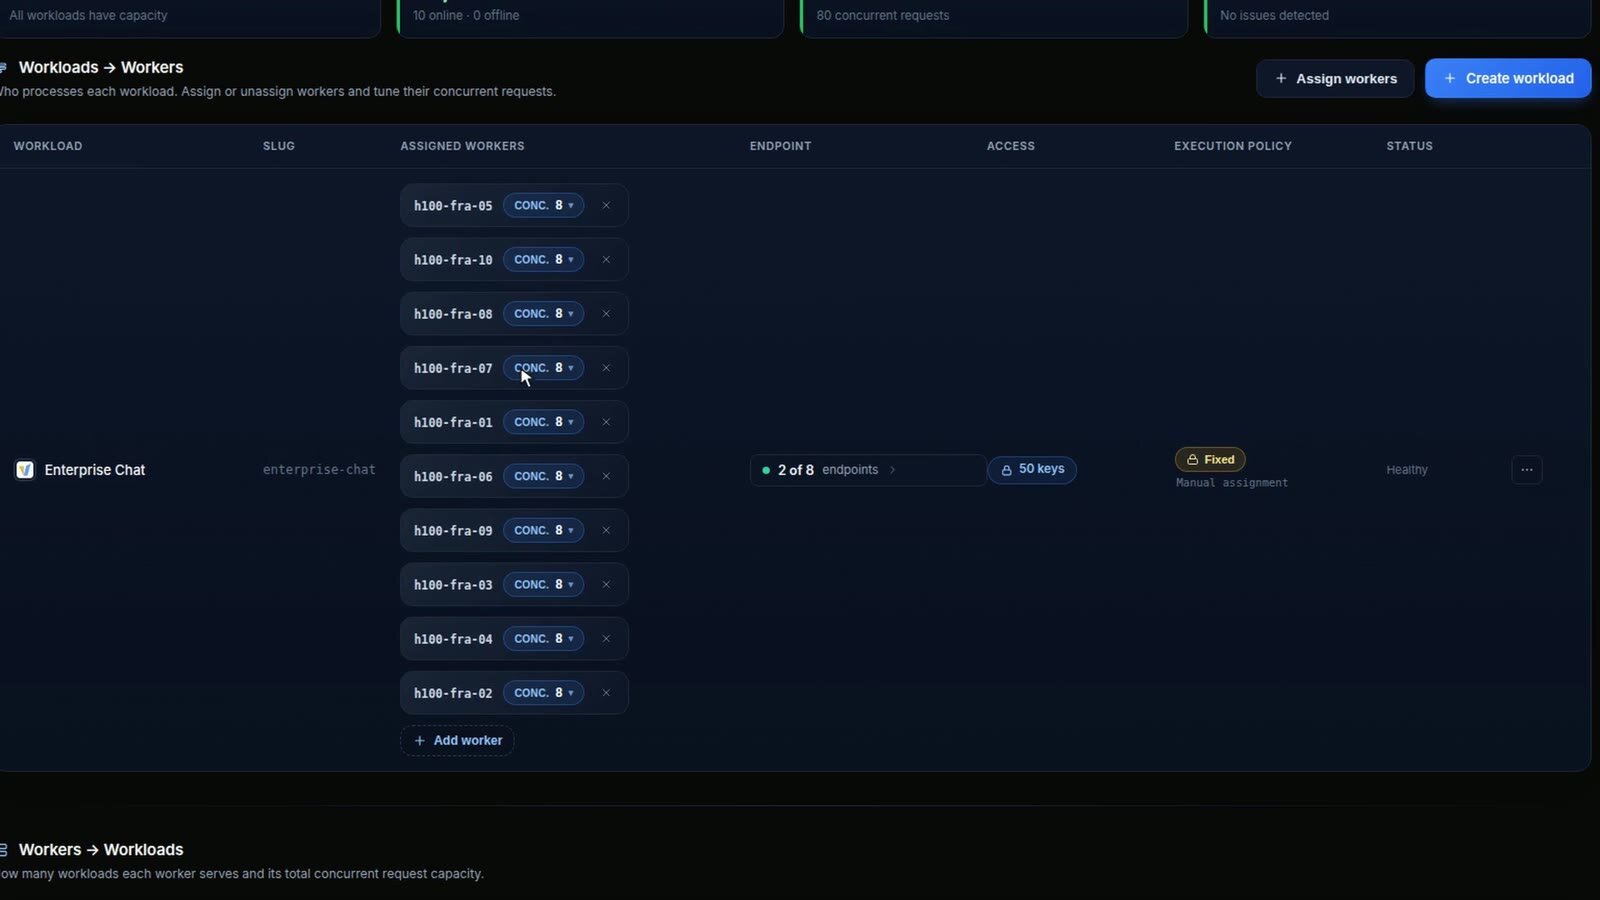
En esta fila es donde se crece. El primer día podría ser un equipo, una clave y una o dos máquinas. Cada equipo nuevo suma una clave y una casilla. Cuando la cola empieza a crecer, el botón "Add worker" que hay debajo de la lista pone una máquina más a servir el modelo: eliges una máquina ya registrada, o despliegas una GPU nueva en la nube, y le dices cuántas peticiones atiende a la vez. Otra máquina como estas diez suma ocho peticiones simultáneas más por otros 1.750 dólares al mes. Los equipos conservan su clave y su dirección. La factura crece a saltos que decides tú, de máquina en máquina, y solo cuando la cola lo pide. En esta toma no pulsamos ese botón. Añadir una máquina con tráfico en marcha es un vídeo que todavía tenemos que grabar.
La carga se reparte sola
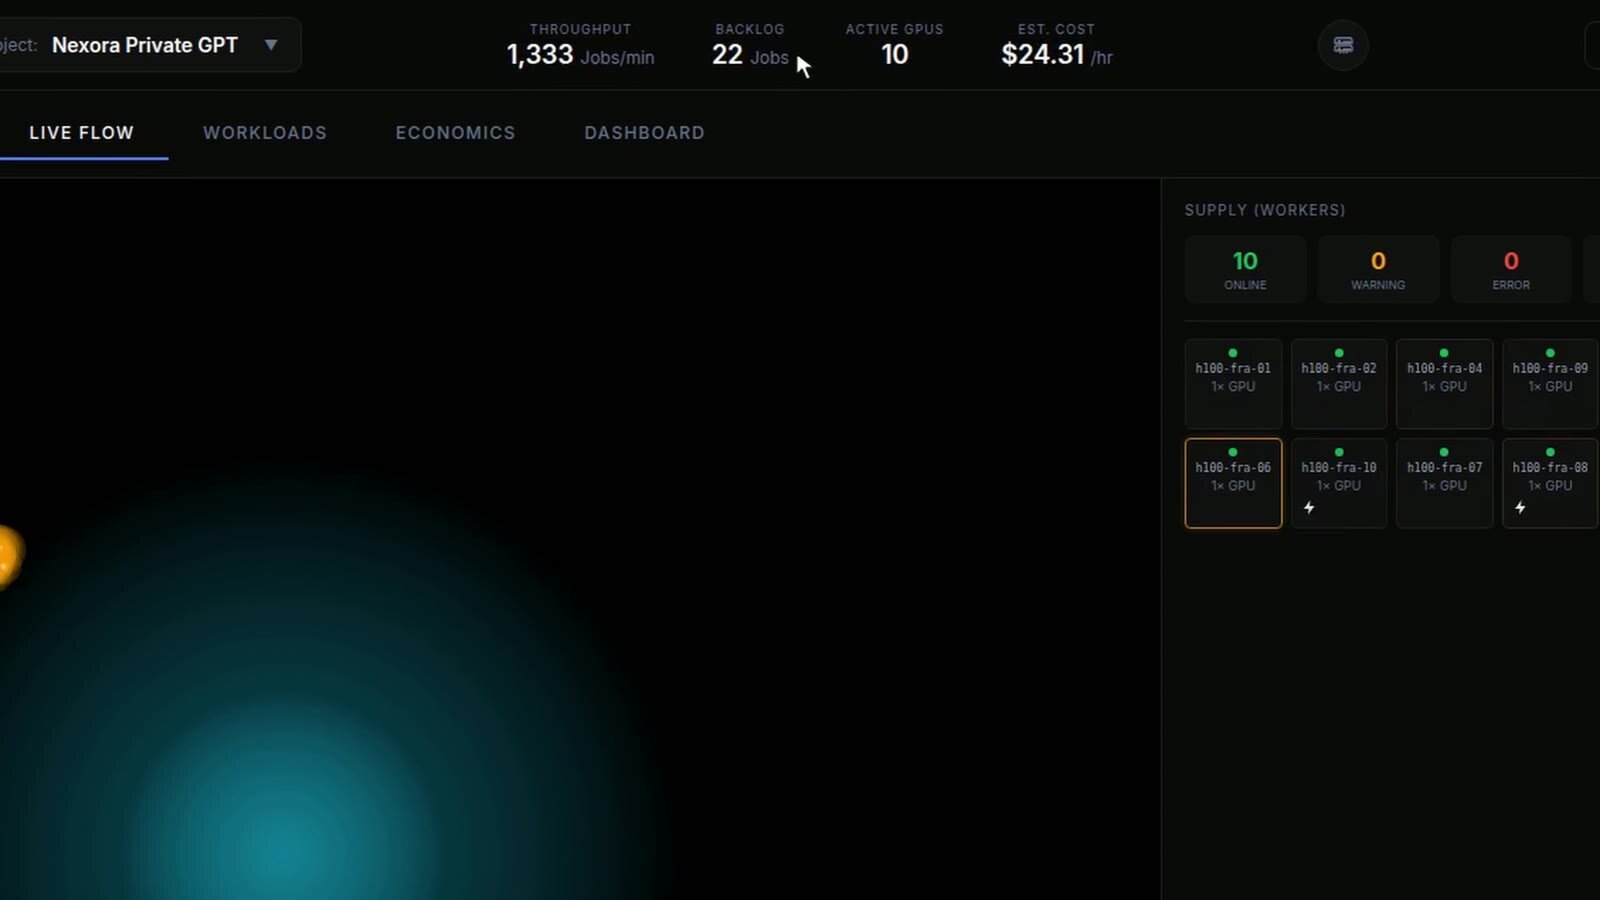
El script de prueba mantuvo una carga constante de unas 70 peticiones por segundo, unas 4.200 por minuto, repartidas entre las cincuenta claves, con unos pocos equipos mucho más activos que el resto. El contador de la barra superior marca menos en esta captura porque empieza de cero cada vez que se abre una página. Al lado: entre 8 y 28 peticiones esperando turno, diez máquinas activas y 24,31 dólares la hora.
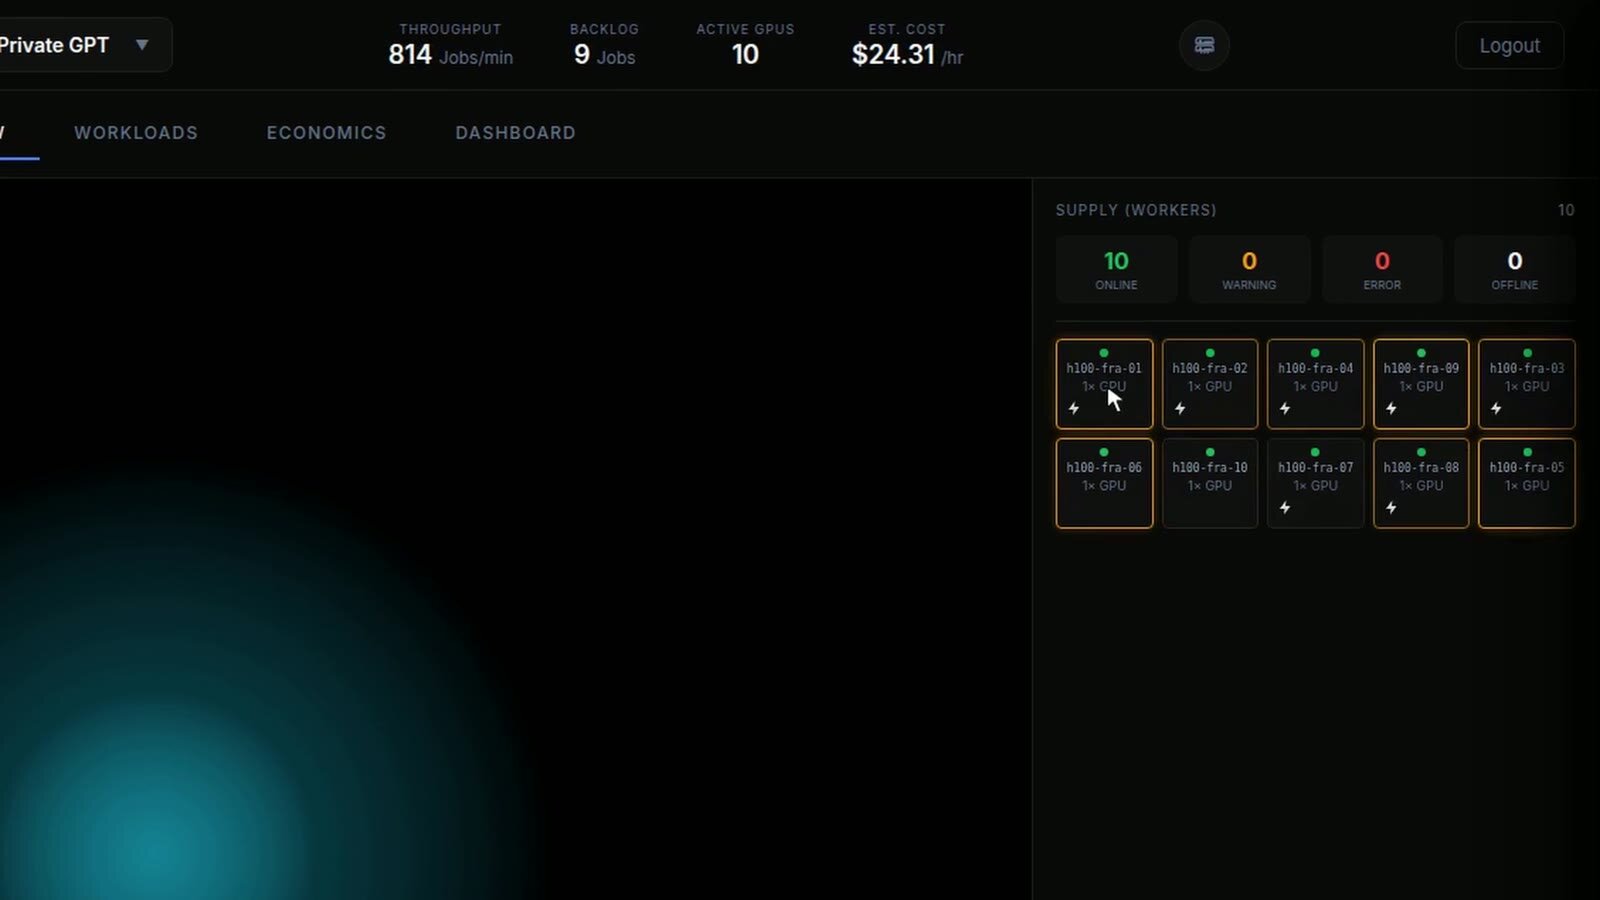
El panel de supply enseña las diez máquinas. Las resaltadas están atendiendo una petición en ese momento, y el resaltado salta de una a otra según llegan peticiones. Tú eliges qué máquinas sirven el modelo, pero no qué máquina coge cada petición: las peticiones de los cincuenta equipos entran en una sola cola, y la primera máquina que tiene un hueco libre coge la siguiente.
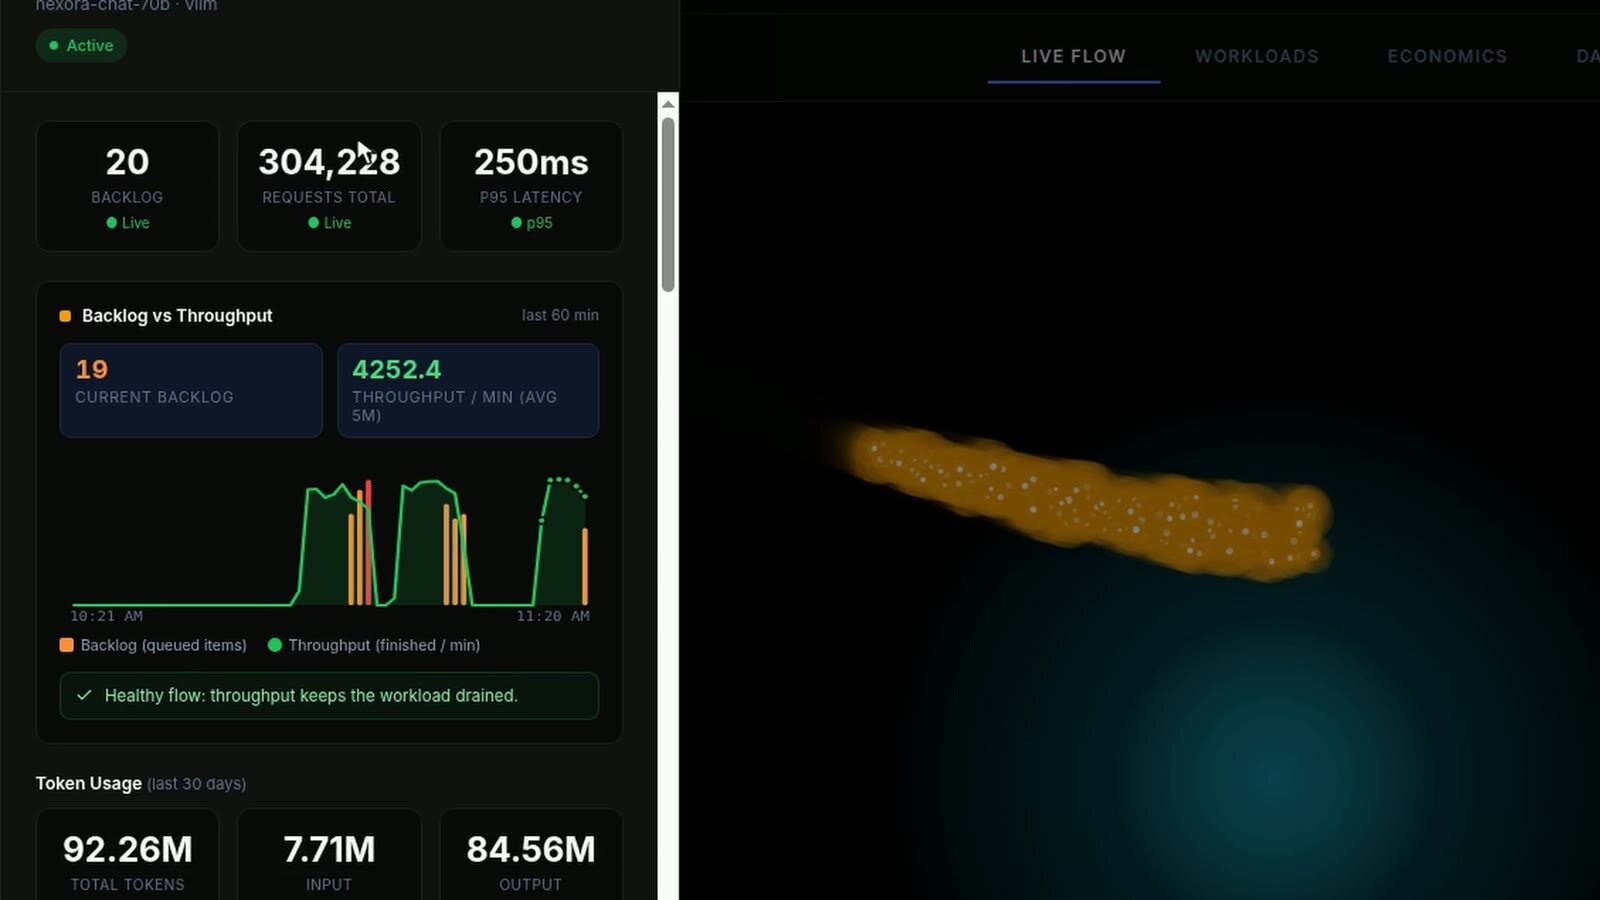
Si abres el modelo, el panel responde a lo primero que pregunta quien lo opera: ¿está la cola bajo control? La gráfica enseña dos cosas: cuántas peticiones esperan (barras) y cuántas se terminan cada minuto (línea), 4.252 de media en los últimos cinco minutos. Debajo, una etiqueta dice "Healthy flow" mientras la cola no haya crecido en los últimos minutos. Si empieza a crecer, la etiqueta pasa a "At risk" o "Critical", la señal de que el modelo necesita otra máquina.
La factura, por equipos
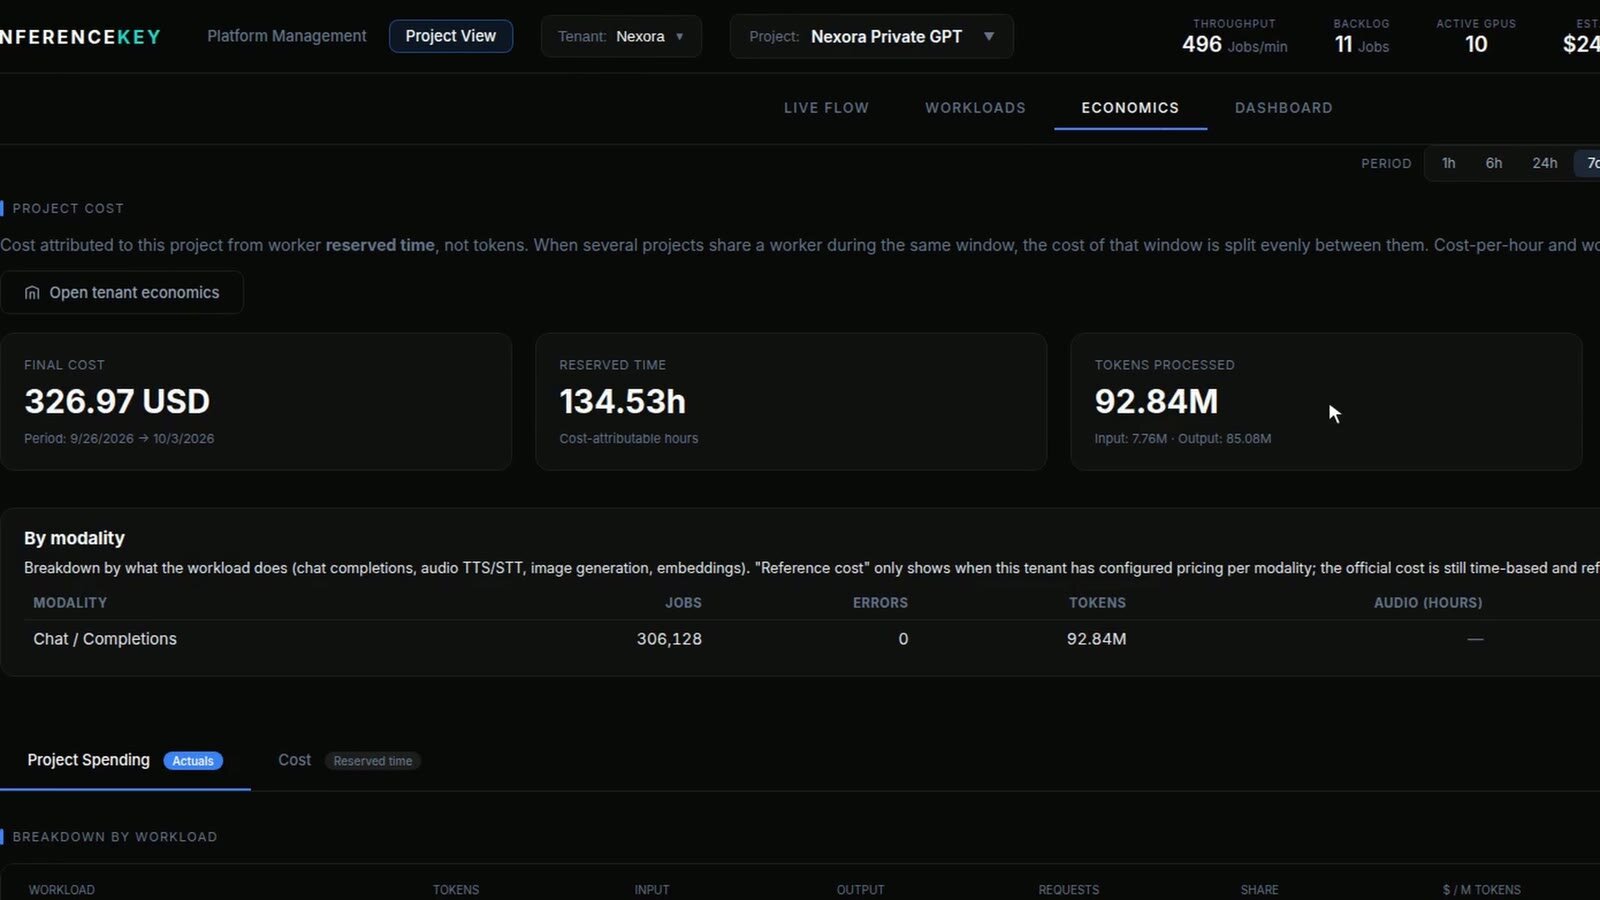
Economics es la pantalla que le importa a finanzas. El panel coge las horas que cada máquina ha estado reservada para este proyecto y las multiplica por el precio de esa máquina. No se estima nada a partir de las palabras.
El selector de periodo dice siete días, pero la flota de la demo solo existió durante parte de uno: 134,53 horas de máquina, unas trece horas y media por máquina. Esas horas costaron 326,97 dólares. En ellas, el tráfico de prueba generó 306.128 peticiones y 92,84 millones de tokens (un token es, más o menos, tres cuartos de una palabra). Dividido entre su ritmo constante, el tráfico suma algo más de una hora de esas trece y media, así que la mayoría de las horas pagadas estuvieron paradas. Por eso los 3,51 dólares por millón de tokens del panel miden sobre todo tiempo parado, y no son un precio que se pueda comparar con una API pública. Si mantienes ocupadas las mismas máquinas, las mismas horas se reparten entre muchas más palabras: esa es la palanca que gestionas.
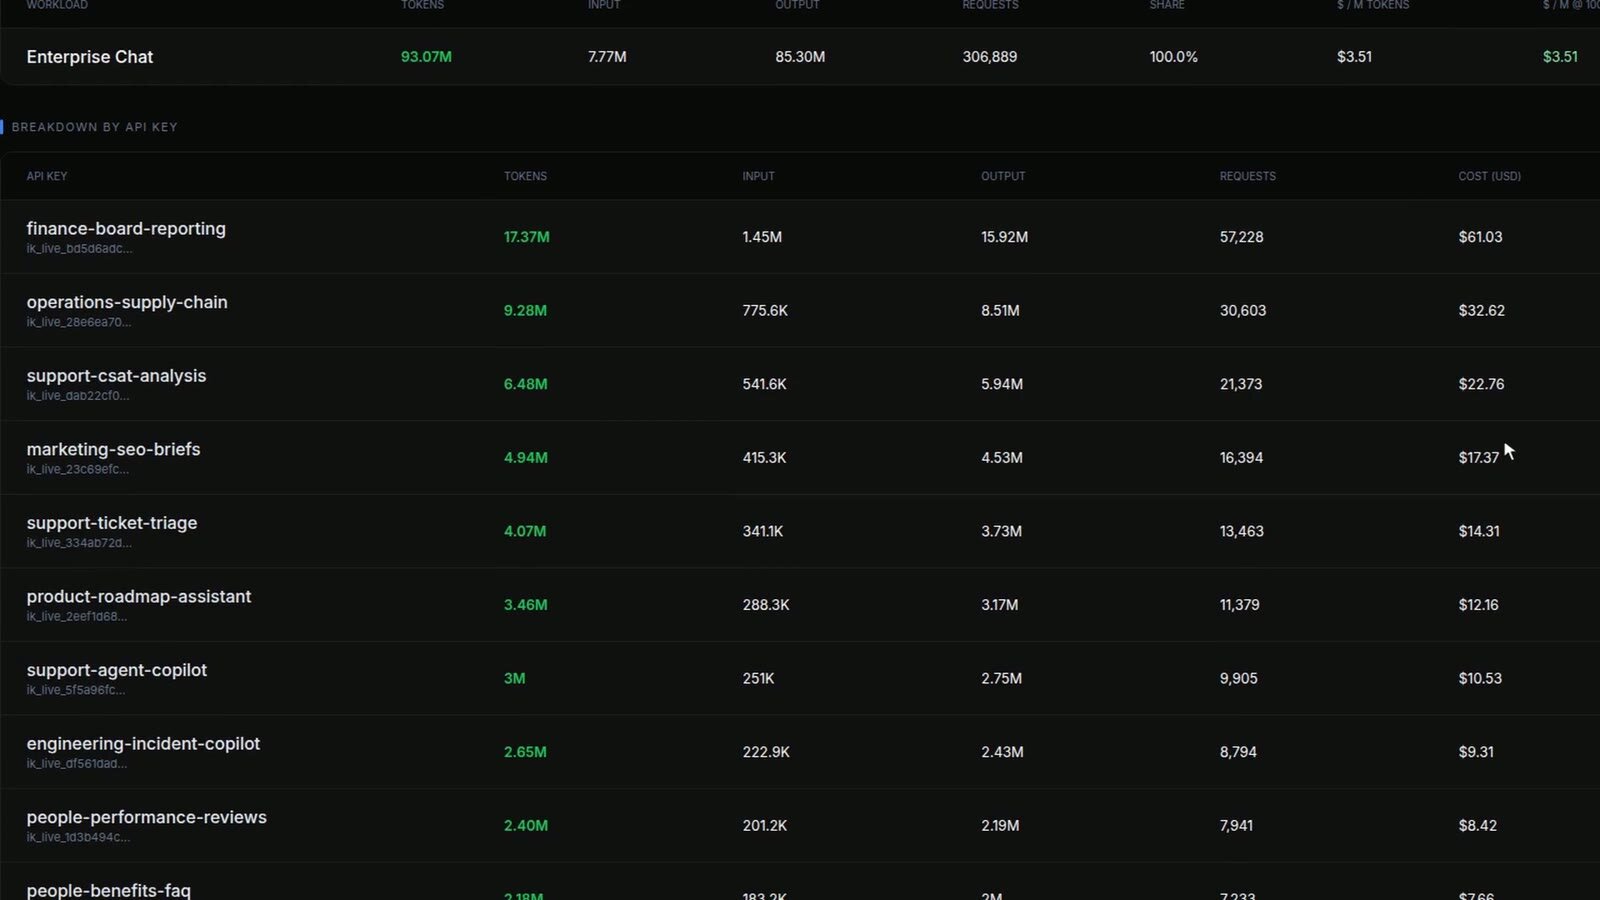
Después el coste se reparte por clave, en proporción a los tokens que ha usado cada una. Los informes para el consejo de finanzas usaron el 18,7 % de los tokens, así que cargan con el 18,7 % del coste: 61,03 dólares en ese momento. Cadena de suministro, 32,62. Análisis de satisfacción de clientes, 22,76. Marketing, 17,37. Son cincuenta líneas, una por clave, y se actualizan mientras corre el tráfico. Si la flota funcionara todo el mes con el mismo reparto, los informes de finanzas cargarían con unos 3.300 de los 17.500 dólares.
Funciona como la mesa de mezclas de un concierto: cincuenta canales entran en un máster, y aun así ves qué micro está demasiado alto. Finanzas no necesita entender de GPUs para leerlo. Es una lista de equipos con un número al lado de cada uno.
Qué demuestra esto, y qué no
Demuestra las partes que no dependen de la GPU. Cada una de las cincuenta claves solo podía llegar al chat de la empresa. Diez workers se repartieron la carga desde una sola cola sin que nadie enrutara peticiones a mano. El panel mantuvo sus cifras en directo con unas 4.200 peticiones por minuto, y la factura salió de las horas de máquina y se repartió por clave sin que nadie exportara una hoja de cálculo.
No demuestra lo rápido que responde un modelo de verdad ni a cuánta gente pueden atender diez H100 reales. Las diez "H100" eran diez procesos en modo de prueba en un único ordenador normal. Los 250 ms de tiempo de respuesta que se ven en pantalla salen de ese modo de prueba, igual que la velocidad de cada respuesta y los 0 errores: estos workers no pueden fallar como falla una GPU de verdad. Los tokens se cuentan sobre texto de relleno, así que la parte de cada equipo sigue el reparto de tráfico del script, no la longitud de respuestas reales. El script nunca envió más de 32 peticiones a la vez, así que la flota nunca llegó a sus 80. Nexora es inventada, y los 1.750 dólares al mes por máquina son un precio de alquiler que configuramos nosotros, no un presupuesto.
A cuánta gente puede atender una máquina de verdad depende del modelo, de la longitud de las respuestas y de cómo lo use cada uno. Eso necesita una medición con GPUs reales, y esta demo no lo es.
Para ingenieros
- Montaje. Un proyecto, un workload (
enterprise-chat, etiquetado en el panel como workload de vLLMnexora-chat-70b, aunque en modo de prueba no corre ningún vLLM), asignado a diez workers (h100-fra-01ah100-fra-10) con asignación manual fija y concurrencia 8 cada uno, 80 huecos en total. Cincuenta claves del plano de datos (ik_live_), cada una limitada al endpointnexora-private-gpt/enterprise-chat. El endpoint es compatible con OpenAI (.../enterprise-chat/v1). - Tráfico. Un script envía peticiones de chat desde las cincuenta claves con pesos Zipf (unas pocas claves dominan, cola larga), 32 flujos con 0,2 s de pausa, unas 70 peticiones por segundo. El panel del workload marcó 4.252 terminadas por minuto (media de 5 minutos). El contador de la cabecera cuenta los eventos
finishedque recibe la pestaña abierta en los últimos 60 s y se reinicia en cada carga de página, así que sus valores en la toma (de 0 a unas 3.700) son rampas, no la carga. Cola en la cabecera: de 8 a 28. - Workers. Workers en modo de prueba en un solo host (el driver aparece como
0.0.mock): registro real, reparto real de trabajos desde la cola compartida, telemetría por el camino real y salida generada. La latencia (p95 de 250 ms), la velocidad (142 tokens por segundo por petición), el recuento de tokens y los 0 errores son propiedades del modo de prueba. - Healthy flow. El panel marca el workload como sano mientras la cola no haya crecido más de max(2, 25 %) en los últimos minutos completos (hasta 5) y el rendimiento sea mayor que cero. Una cola que baja con rendimiento que sube se marca "Recovering", una cola que crece se marca "At risk", o "Critical" si además baja el rendimiento.
- Modelo de coste. Coste del proyecto = horas reservadas de cada worker × su precio por hora configurado. El tiempo reservado es tiempo de calendario mientras el worker está asignado al proyecto, y las ventanas que comparten varios proyectos se reparten a partes iguales. Aquí: 134,53 h × 2,4306 $/h (1.750 $ / 720 h) = 326,97 $. Diez workers cuestan 24,31 $/h, unos 17.500 $ al mes si no se paran nunca. Las horas reservadas siguen sumando mientras los workers están asignados, un céntimo cada 1,5 segundos a 24,31 $/h, así que dos capturas separadas por unos segundos difieren en unos céntimos.
- Por clave. El coste de cada clave es su parte de los tokens del proyecto por el coste del proyecto: finance-board-reporting tenía 17,37M de 93,07M tokens en la captura 09, el 18,7 % del coste del proyecto en ese momento, 61,03 $.
- Coste unitario. 3,51 $ por millón de tokens en la tabla del workload, en una ventana en la que el tráfico, a su ritmo constante, suma unos 72 minutos de 13,5 horas por worker. Con precio por hora, esa cifra baja a medida que sube la ocupación. Con modelos reales, lo que la decide es el ritmo de tokens de cada máquina.
- Lo que no sale en el vídeo. Añadir un undécimo worker con tráfico, un worker que cae a media carga, y desactivar una clave y ver cómo su línea de coste deja de crecer.
Las claves, sus permisos y las variables de entorno están documentadas en Tokens y API keys.