Der Draft-Head von Mellum2.1 lohnt sich auf einer geteilten GPU: 1,45x mit acht Anfragen, 1,11x mit einer
Der MTP-Head von Mellum2.1 machte acht parallele Anfragen auf einer RTX A6000 1,45x schneller, eine nur 1,11x. Läuft auch auf einer RTX 5080 mit 16 GB.
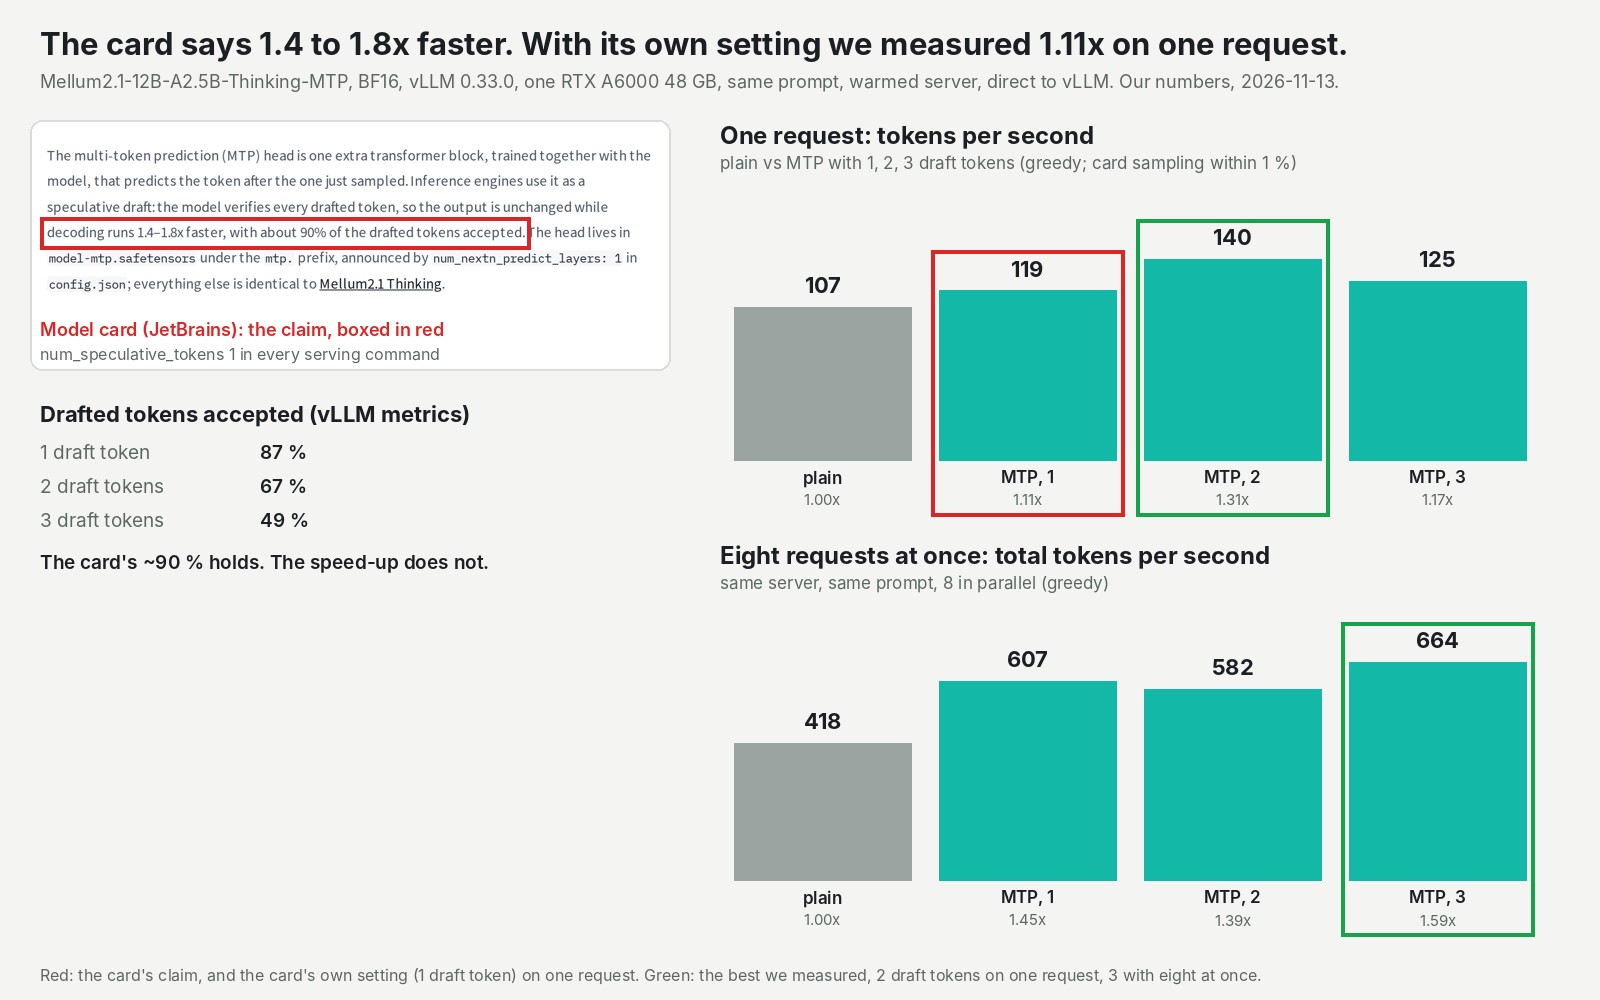
Sollten Sie den Draft-Head einschalten, den JetBrains gerade für Mellum2.1 veröffentlicht hat, sein offenes Modell für Code? Auf einer GPU, die mehrere Anfragen gleichzeitig bedient, ja. Mit acht gleichzeitigen Anfragen auf einer RTX A6000 mit 48 GB in unserer Cloud stieg die Gesamtausgabe von 418 auf 607 Tokens (Wortstücke) pro Sekunde: 1,45x, direkt am vLLM-Server gemessen. Mit einer Anfrage und der von JetBrains empfohlenen Einstellung betrug der Gewinn 1,11x, von 107 auf 119 Tokens pro Sekunde. Die Modellseite von JetBrains verspricht 1,4 bis 1,8x. Für alle, die Modelle betreiben, kostet der Schalter ein Flag und weniger als ein Gigabyte zusätzliche Gewichte. Was Sie heute damit anfangen können: ihn für eine geteilte GPU einschalten, für einen einzelnen Nutzer zwei Vermutungen pro Schritt ausprobieren und wissen, dass das Modell in 8 Bit auch auf einer echten RTX 5080 mit 16 GB läuft.
Ein kleiner Rater, den das volle Modell prüft
Mellum2.1 Thinking ist das offene Modell von JetBrains für Code und Reasoning. Es hat 12B Parameter, aber nur 2,5B davon arbeiten an jedem Wort, was es leicht und schnell macht. Es erschien im September, der Draft-Head war als "coming soon" markiert. Der Head kam am 30. Oktober als separate Datei mit 0,86 GB, und laut JetBrains ist das Modell selbst unverändert. Entdeckt haben wir ihn in einem Beitrag von pmttyji auf r/LocalLLaMA.
Der Head rät das Wort nach dem gerade geschriebenen. Das volle Modell prüft dann die Vermutung. Stimmt es zu, bekommen Sie zwei Wörter ungefähr zum Preis eines Schritts. Wenn nicht, wird die Vermutung verworfen. Es ist wie ein Schlagzeuger, der den nächsten Song einzählt: fast umsonst, wenn die Band mitgeht, vergeudet, wenn nicht.
Auf der Seite von JetBrains heißt es, das Modell "verifies every drafted token, so the output is unchanged", wobei rund 90 % der Vermutungen angenommen werden. Auf welcher GPU und mit wie vielen Anfragen es seine Spanne von 1,4 bis 1,8x gemessen hat, steht dort nicht. Also haben wir es gemessen und zwischen den Läufen nur dieses eine Flag geändert, mit vLLM 0.33, der Serving-Software, die JetBrains empfiehlt.
Eine Anfrage: Die Vermutungen treffen, die Prüfung frisst den Gewinn
Mit der Einstellung von JetBrains, einer Vermutung pro Schritt, stieg eine Anfrage von 106,8 auf 118,9 Tokens pro Sekunde. Laut den eigenen Zählern von vLLM wurden 87,2 % der Vermutungen angenommen, nah an den 90 % von JetBrains. Das Modell rät gut; die Prüfung der Vermutung kostet fast so viel, wie sie spart.
Unsere beste Erklärung, nicht gemessen: vLLM führt Mellum über generischen Code aus, noch ohne eine für dieses Modell optimierte Version. Und ein Modell, das pro Wort so leicht ist, ist so schnell, dass die Prüfung im Vergleich nicht billig ist.
Im Alltag heißt das: Eine Code-Antwort von etwa 600 Tokens brauchte über unseren Endpunkt 5,9 Sekunden ohne Head und 4,9 Sekunden mit ihm. Bei einer langen Antwort sparen Sie eine Sekunde.
Zwei Vermutungen pro Schritt schnitten bei einer einzelnen Anfrage besser ab. Nur zwei von drei trafen, aber die Geschwindigkeit stieg auf 140,2 Tokens pro Sekunde, 1,31x. Drei Vermutungen fielen auf 124,8 zurück.
Acht Anfragen gleichzeitig: innerhalb der Spanne von JetBrains
| RTX A6000, volle Größe, Tokens pro Sekunde | Ohne Head | 1 Vermutung | 2 Vermutungen | 3 Vermutungen |
|---|---|---|---|---|
| Eine Anfrage | 106,8 | 118,9 (1,11x) | 140,2 (1,31x) | 124,8 (1,17x) |
| Acht gleichzeitig | 418,4 | 607,3 (1,45x) | 581,8 (1,39x) | 663,5 (1,59x) |
Mit acht gleichzeitigen Anfragen war dieselbe Arbeit in etwa zwei Dritteln der Zeit erledigt, und jede Anzahl von Vermutungen lohnte sich. Das widerspricht dem üblichen Muster, bei dem diese Art des Ratens weniger bringt, je mehr Anfragen sich stauen. Wir haben es einmal gemessen und können es nicht erklären.
Der Preis des Heads ist Speicher. vLLM führt einen Notizblock für jedes laufende Gespräch, und der Head nimmt ihm Platz weg. Auf der A6000 schrumpfte der Notizblock von 1.122.580 Tokens auf 1.027.634, etwa 8,5 % weniger. Auf einer GPU mit 48 GB ist das fast umsonst.
16 GB reichten, mit 8-Bit-Gewichten
Die kleinste GPU, die funktionierte, war eine echte RTX 5080 mit 16 GB. vLLM lud eine komprimierte 8-Bit-Kopie, halb so groß wie die veröffentlichte, mit Gesprächen von bis zu 16.384 Tokens. Sie schrieb 217,2 Tokens pro Sekunde ohne Head und 288,7 mit einer Vermutung, 1,33x, bei 97 % ihres Speichers. In voller Größe startete das Modell mit einer Grenze von 24 GB nicht.
Auf einer kleinen GPU zählt der Notizblock mehr. Auf der RTX 5080 ging er mit eingeschaltetem Head von 52.400 Tokens auf 29.019 zurück: Aus Platz für drei volle Gespräche wurde Platz für eines.
Die Qualität hielt überall. Das Modell fand den Fehler im eigenen Beispiel von JetBrains jedes Mal, seine Funktion zum Zusammenführen von Intervallen bestand unsere vier Prüfungen in 13 von 13 Ausgaben, und bei der Matheaufgabe antwortete es in jedem Lauf mit 400. "Output is unchanged" galt allerdings nicht Byte für Byte, und ohne Head ebenso wenig. Vergleichen Sie in Ihren Tests Ergebnisse, nicht Bytes.
Auf InferenceKey schaltet eine Einstellung im SDK-Beispiel den Head ein oder aus, und eine kalte A6000 war in etwa 8 Minuten bereit. Ein Haken: Unsere Plattform gibt jedem Modell jeweils nur eine Anfrage, über unseren Endpunkt bekommen Sie heute also die 1,11x einer einzelnen Anfrage. Das ist bei uns offen.
Für wen das wichtig ist
- Ein Team oder mehrere Agenten, die sich eine GPU teilen: Schalten Sie den Head ein; beim parallelen Gewinn hält das Versprechen von JetBrains.
- Ein Entwickler, eine Anfrage nach der anderen: Stellen Sie zwei Vermutungen pro Schritt ein und messen Sie mit Ihrem eigenen Traffic.
- Eine GPU mit 16 GB: Nutzen Sie 8-Bit-Gewichte und rechnen Sie mit weniger Platz für parallele Gespräche.
- Tests, die Modellausgaben Byte für Byte vergleichen: Sie brechen, mit oder ohne Head.
Die ehrliche Grenze: Jede Einstellung lief einmal, mit fünf kurzen Prompts von uns, also behandeln Sie kleine Abstände als Rauschen.
Alle Läufe, die Speicherrechnung und die GPU-Stufen finden Sie in dem vollständigen Mellum2.1-MTP-Test.