El cabezal de borrador de Mellum2.1 sale a cuenta en una GPU compartida: 1,45x con ocho peticiones, 1,11x con una
El cabezal MTP de Mellum2.1 hizo 1,45x más rápidas ocho peticiones en paralelo en una RTX A6000; una sola, solo 1,11x. Funciona en una RTX 5080 de 16 GB.
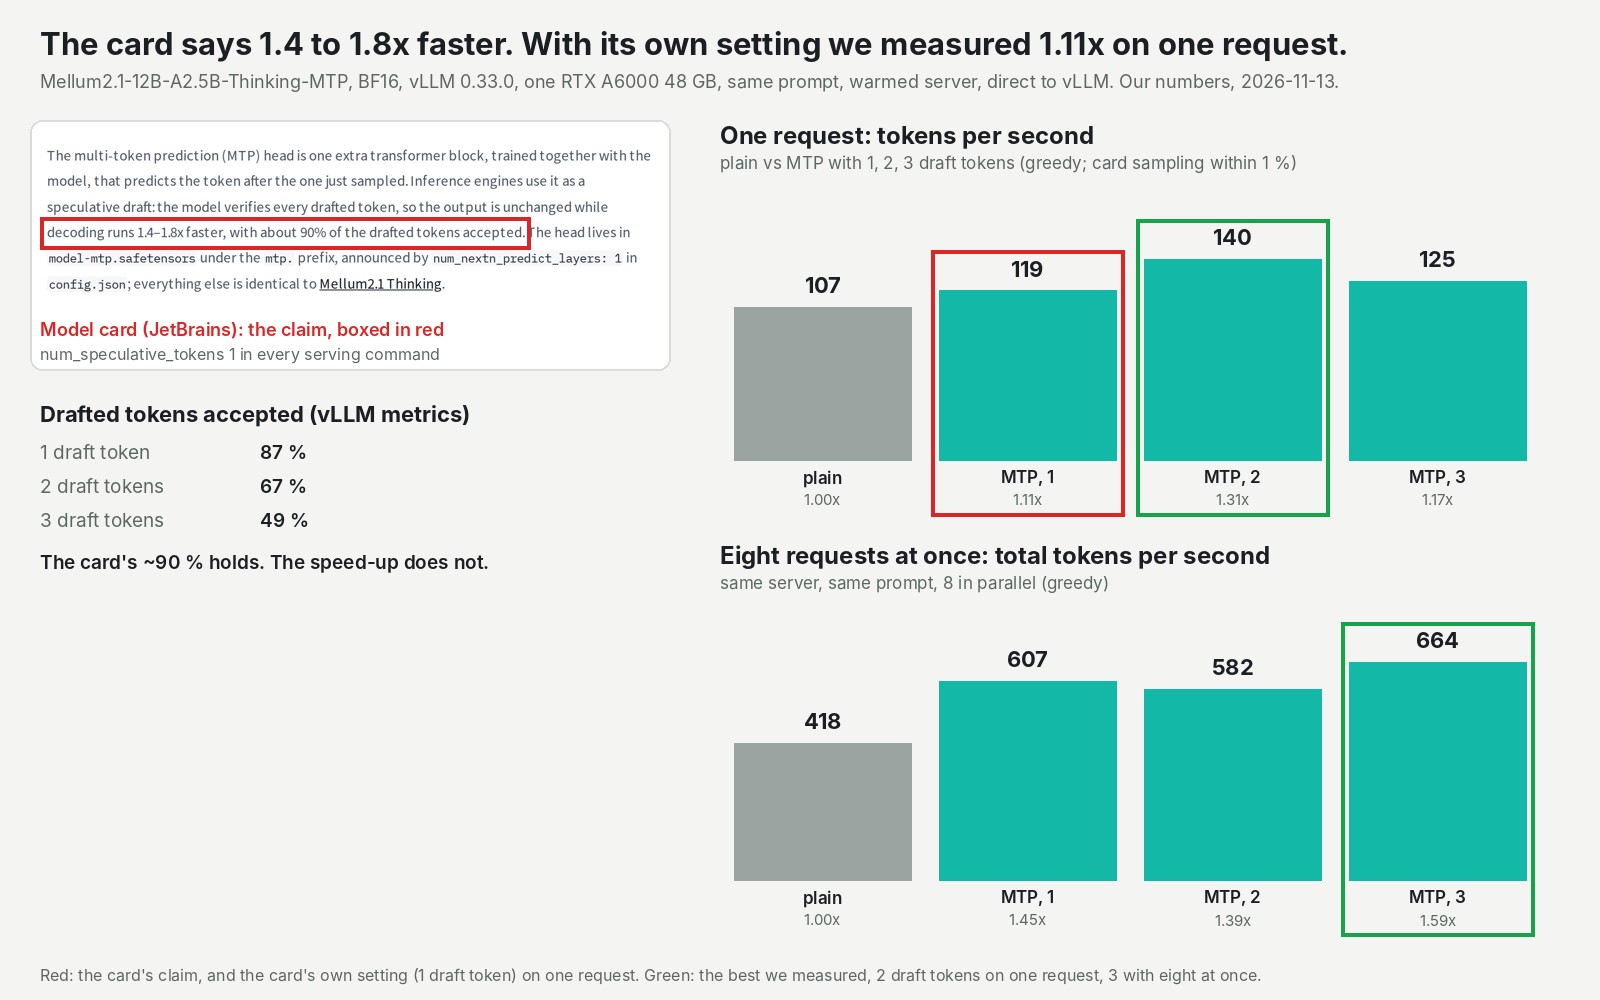
¿Merece la pena activar el cabezal de borrador que JetBrains acaba de publicar para Mellum2.1, su modelo abierto de código? En una GPU que atiende varias peticiones a la vez, sí. Con ocho peticiones simultáneas en una RTX A6000 de 48 GB de nuestra nube, la salida total pasó de 418 a 607 tokens (trozos de palabras) por segundo: 1,45x, medido directamente en el servidor vLLM. Con una sola petición y el ajuste que recomienda JetBrains, la ganancia fue de 1,11x, de 107 a 119 tokens por segundo. La página del modelo de JetBrains promete de 1,4 a 1,8x. Para quien despliega modelos, activarlo cuesta un flag y menos de un gigabyte de pesos extra. Lo que puedes hacer hoy con él: activarlo en una GPU compartida, probar dos apuestas por paso para un solo usuario, y saber que el modelo también funciona en 8 bits en una RTX 5080 real de 16 GB.
Un pequeño adivino al que el modelo completo revisa
Mellum2.1 Thinking es el modelo abierto de JetBrains para código y razonamiento. Tiene 12B parámetros, pero solo 2,5B trabajan en cada palabra, lo que lo hace ligero y rápido. Salió en septiembre con el cabezal de borrador marcado como "coming soon". El cabezal llegó el 30 de octubre como un fichero aparte de 0,86 GB, y JetBrains dice que el modelo en sí no cambia. Lo vimos en un post de pmttyji en r/LocalLLaMA.
El cabezal adivina la palabra que va después de la que se acaba de escribir. Luego el modelo completo revisa esa apuesta. Si está de acuerdo, te llevas dos palabras por más o menos el precio de un paso. Si no, la apuesta se descarta. Funciona como un batería que marca la entrada de la siguiente canción: casi gratis cuando el grupo está de acuerdo, tiempo perdido cuando no.
La página de JetBrains dice que el modelo "verifies every drafted token, so the output is unchanged", con cerca del 90% de las apuestas aceptadas. No dice en qué GPU, ni con cuántas peticiones, midió su rango de 1,4 a 1,8x. Así que lo medimos nosotros, cambiando solo ese flag entre ejecuciones, con vLLM 0.33, el software de servicio que recomienda JetBrains.
Una petición: las apuestas aciertan, la revisión se come la ganancia
Con el ajuste de JetBrains de una apuesta por paso, una petición pasó de 106,8 a 118,9 tokens por segundo. Los contadores del propio vLLM dicen que se aceptó el 87,2% de las apuestas, cerca del 90% de JetBrains. El modelo adivina bien; revisar la apuesta cuesta casi lo mismo que ahorra.
Nuestra mejor explicación, sin medir: vLLM ejecuta Mellum con código genérico, todavía sin una versión optimizada para este modelo. Y un modelo tan ligero por palabra es tan rápido que, en comparación, la revisión no sale barata.
En el día a día, una respuesta de código de unos 600 tokens tardó 5,9 segundos sin el cabezal y 4,9 segundos con él, a través de nuestro endpoint. Ahorras un segundo en una respuesta larga.
Dos apuestas por paso funcionaron mejor para una sola petición. Solo acertaron dos de cada tres, pero la velocidad subió a 140,2 tokens por segundo, 1,31x. Con tres apuestas volvió a bajar a 124,8.
Ocho peticiones a la vez: dentro del rango de JetBrains
| RTX A6000, tamaño completo, tokens por segundo | Sin cabezal | 1 apuesta | 2 apuestas | 3 apuestas |
|---|---|---|---|---|
| Una petición | 106,8 | 118,9 (1,11x) | 140,2 (1,31x) | 124,8 (1,17x) |
| Ocho a la vez | 418,4 | 607,3 (1,45x) | 581,8 (1,39x) | 663,5 (1,59x) |
Con ocho peticiones a la vez, el mismo trabajo terminó en unos dos tercios del tiempo, y salió a cuenta con cualquier número de apuestas. Eso va contra lo habitual, donde este tipo de adivinación gana menos cuanto más se acumulan las peticiones. Lo medimos una vez y no sabemos explicarlo.
El coste del cabezal es memoria. vLLM guarda una libreta con cada conversación en curso, y el cabezal le quita sitio. En la A6000 la libreta bajó de 1.122.580 tokens a 1.027.634, cerca de un 8,5% menos. En una GPU de 48 GB, eso es casi gratis.
Con 16 GB bastó, con pesos de 8 bits
La GPU más pequeña que funcionó fue una RTX 5080 real de 16 GB. vLLM cargó una copia comprimida de 8 bits, la mitad del tamaño publicado, con conversaciones de hasta 16.384 tokens. Escribió 217,2 tokens por segundo sin cabezal y 288,7 con una apuesta, 1,33x, al 97% de su memoria. A tamaño completo, con un tope de 24 GB no llegó a arrancar.
En una GPU pequeña la libreta importa más. En la RTX 5080 pasó de 52.400 tokens a 29.019 con el cabezal activado: el sitio para tres conversaciones completas se quedó en una.
La calidad se mantuvo en todos los casos. El modelo encontró el bug del propio ejemplo de JetBrains todas las veces, su función de fusión de intervalos pasó nuestras cuatro comprobaciones en 13 de 13 salidas, y respondió 400 al problema de matemáticas en todas las ejecuciones. Pero lo de "output is unchanged" no se cumplió byte a byte, y tampoco sin el cabezal. Compara resultados en tus tests, no bytes.
En InferenceKey, un solo ajuste en el ejemplo del SDK activa o desactiva el cabezal, y una A6000 en frío estuvo lista en unos 8 minutos. Una pega: nuestra plataforma pasa una petición a la vez a cada modelo, así que hoy, a través de nuestro endpoint, obtienes el 1,11x de una petición. Eso está pendiente por nuestra parte.
A quién le importa
- Un equipo o varios agentes que comparten una GPU: activa el cabezal; la ganancia en paralelo es donde se cumple la promesa de JetBrains.
- Un desarrollador, una petición cada vez: pon dos apuestas por paso y mide con tu propio tráfico.
- Una GPU de 16 GB: usa pesos de 8 bits y cuenta con menos sitio para conversaciones en paralelo.
- Tests que comparan la salida del modelo byte a byte: se romperán con o sin el cabezal.
El límite honesto: cada ajuste se ejecutó una vez, con cinco prompts cortos nuestros, así que toma las diferencias pequeñas como ruido.
Consulta cada ejecución, las cuentas de memoria y la escalera de GPUs en la prueba completa del MTP de Mellum2.1.