La tête de brouillon de Mellum2.1 paie sur un GPU partagé : 1,45x avec huit requêtes, 1,11x avec une
La tête MTP de Mellum2.1 accélère huit requêtes parallèles de 1,45x sur une RTX A6000, une seule de 1,11x. Elle tourne aussi sur une RTX 5080 de 16 GB.
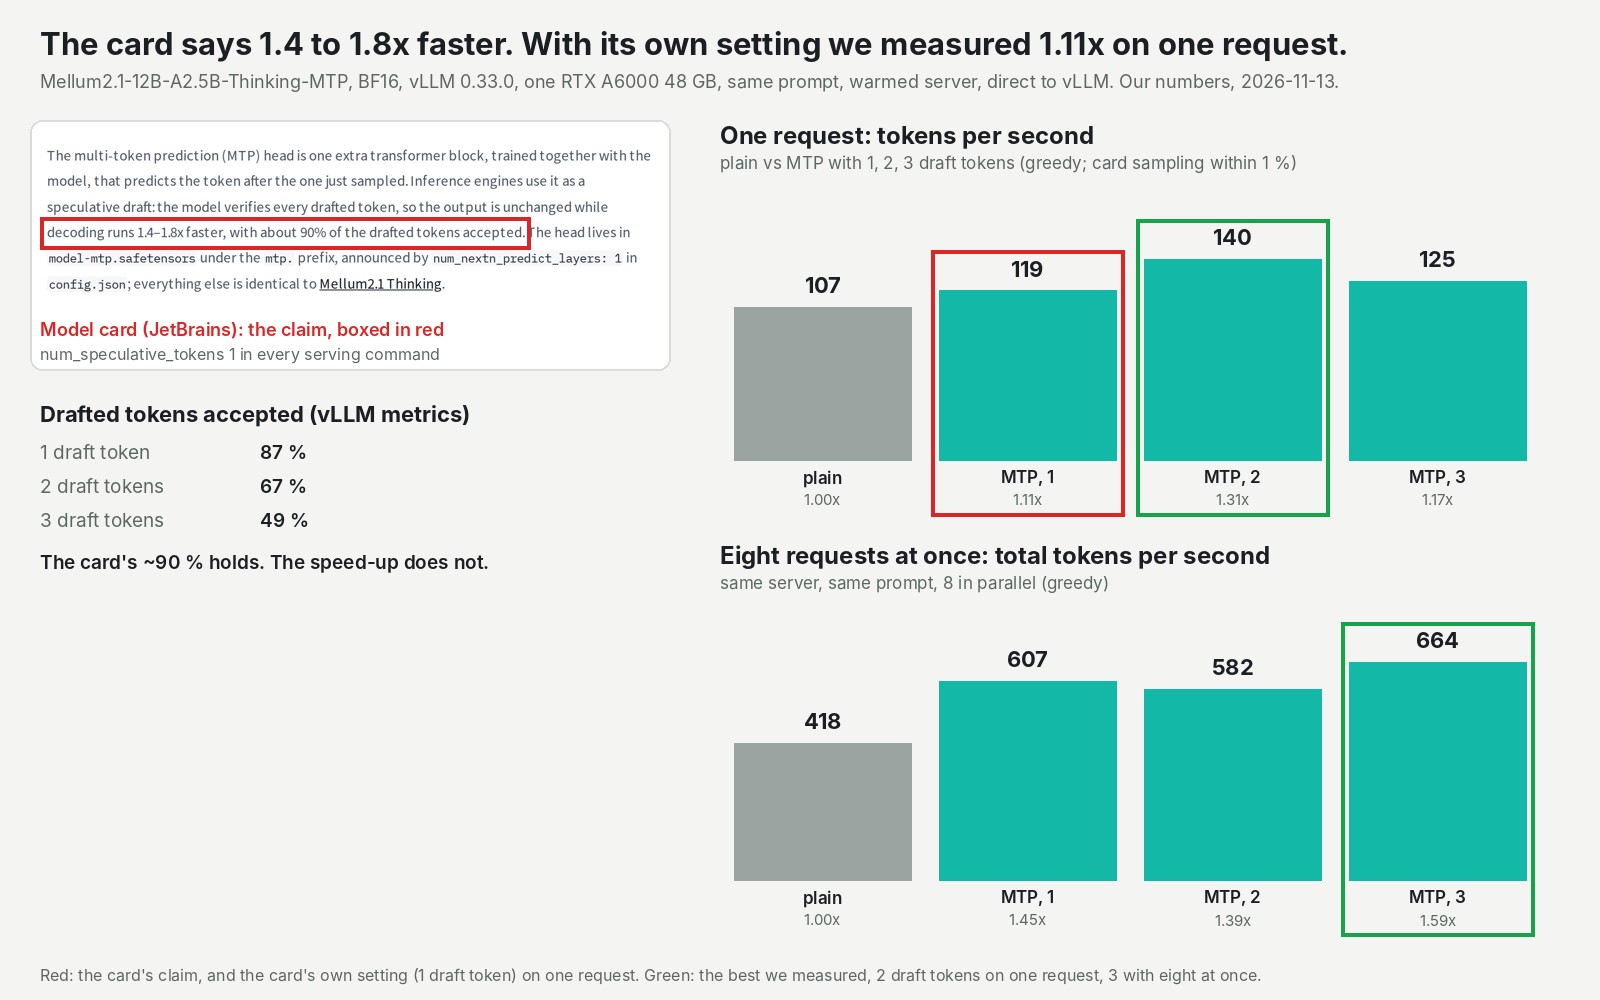
Faut-il activer la tête de brouillon que JetBrains vient de publier pour Mellum2.1, son modèle ouvert pour le code ? Sur un GPU qui sert plusieurs requêtes à la fois, oui. Avec huit requêtes simultanées sur une RTX A6000 de 48 GB de notre cloud, le débit total est passé de 418 à 607 tokens (des morceaux de mots) par seconde : 1,45x, mesuré directement sur le serveur vLLM. Avec une seule requête et le réglage recommandé par JetBrains, le gain a été de 1,11x, de 107 à 119 tokens par seconde. La page du modèle chez JetBrains promet 1,4 à 1,8x. Pour ceux qui déploient des modèles, l'activer coûte un flag et moins d'un gigaoctet de poids en plus. Ce que vous pouvez en faire aujourd'hui : l'activer sur un GPU partagé, essayer deux propositions par pas pour un seul utilisateur, et savoir que le modèle tourne aussi en 8 bits sur une vraie RTX 5080 de 16 GB.
Un petit devineur que le modèle complet vérifie
Mellum2.1 Thinking est le modèle ouvert de JetBrains pour le code et le raisonnement. Il a 12B paramètres, mais seulement 2,5B d'entre eux travaillent sur chaque mot, ce qui le rend léger et rapide. Il est sorti en septembre avec la tête de brouillon marquée "coming soon". La tête est arrivée le 30 octobre sous forme d'un fichier séparé de 0,86 GB, et JetBrains dit que le modèle lui-même n'a pas changé. Nous l'avons repérée dans un post de pmttyji sur r/LocalLLaMA.
La tête devine le mot qui suit celui qui vient d'être écrit. Le modèle complet vérifie ensuite la proposition. S'il est d'accord, vous obtenez deux mots pour à peu près le prix d'un pas. Sinon, la proposition part à la poubelle. C'est comme un batteur qui compte l'entrée du morceau suivant : presque gratuit quand le groupe suit, du temps perdu quand il ne suit pas.
La page de JetBrains dit que le modèle "verifies every drafted token, so the output is unchanged", avec environ 90 % des propositions acceptées. Elle ne dit pas sur quel GPU, ni avec combien de requêtes, elle a mesuré sa fourchette de 1,4 à 1,8x. Nous l'avons donc mesurée, en ne changeant que ce flag entre les essais, avec vLLM 0.33, le logiciel de service que recommande JetBrains.
Une requête : les propositions tombent juste, la vérification mange le gain
Avec le réglage de JetBrains d'une proposition par pas, une requête est passée de 106,8 à 118,9 tokens par seconde. Les compteurs de vLLM indiquent que 87,2 % des propositions ont été acceptées, proche des 90 % de JetBrains. Le modèle devine bien ; vérifier la proposition coûte presque autant que ce qu'elle fait gagner.
Notre meilleure explication, non mesurée : vLLM fait tourner Mellum avec du code générique, sans version optimisée pour ce modèle pour l'instant. Et un modèle aussi léger par mot est si rapide que la vérification n'est pas bon marché en comparaison.
Concrètement, une réponse de code d'environ 600 tokens a pris 5,9 secondes sans la tête et 4,9 secondes avec, à travers notre endpoint. Vous gagnez une seconde sur une longue réponse.
Deux propositions par pas ont fait mieux pour une requête seule. Seules deux sur trois sont tombées juste, mais la vitesse est montée à 140,2 tokens par seconde, 1,31x. Trois propositions sont retombées à 124,8.
Huit requêtes à la fois : dans la fourchette de JetBrains
| RTX A6000, taille complète, tokens par seconde | Sans tête | 1 proposition | 2 propositions | 3 propositions |
|---|---|---|---|---|
| Une requête | 106,8 | 118,9 (1,11x) | 140,2 (1,31x) | 124,8 (1,17x) |
| Huit à la fois | 418,4 | 607,3 (1,45x) | 581,8 (1,39x) | 663,5 (1,59x) |
Avec huit requêtes à la fois, le même travail s'est terminé en environ deux tiers du temps, et chaque nombre de propositions a payé. Cela va à l'encontre du schéma habituel, où ce genre de devinette gagne moins à mesure que les requêtes s'accumulent. Nous l'avons mesuré une fois et ne savons pas l'expliquer.
Le coût de la tête, c'est la mémoire. vLLM garde un bloc-notes de chaque conversation en cours, et la tête lui prend de la place. Sur l'A6000, le bloc-notes est passé de 1 122 580 tokens à 1 027 634, environ 8,5 % de moins. Sur un GPU de 48 GB, c'est presque gratuit.
16 GB ont suffi, avec des poids en 8 bits
Le plus petit GPU qui a fonctionné est une vraie RTX 5080 de 16 GB. vLLM a chargé une copie compressée en 8 bits, la moitié de la taille publiée, avec des conversations jusqu'à 16 384 tokens. Elle a produit 217,2 tokens par seconde sans tête et 288,7 avec une proposition, 1,33x, à 97 % de sa mémoire. En taille complète, une limite de 24 GB n'a pas démarré.
Sur un petit GPU, le bloc-notes compte davantage. Sur la RTX 5080, il est passé de 52 400 tokens à 29 019 avec la tête activée : la place pour trois conversations complètes est tombée à une.
La qualité a tenu partout. Le modèle a trouvé le bug de l'exemple de JetBrains à chaque fois, sa fonction de fusion d'intervalles a passé nos quatre vérifications dans 13 sorties sur 13, et il a répondu 400 au problème de maths à chaque essai. "Output is unchanged" ne s'est pas vérifié octet par octet, en revanche, et pas non plus sans la tête. Comparez les résultats dans vos tests, pas les octets.
Sur InferenceKey, un seul réglage dans l'exemple du SDK active ou désactive la tête, et une A6000 à froid était prête en environ 8 minutes. Un bémol : notre plateforme passe une requête à la fois à chaque modèle, donc à travers notre endpoint vous obtenez aujourd'hui le 1,11x d'une requête seule. C'est un chantier ouvert de notre côté.
Qui devrait s'y intéresser
- Une équipe ou plusieurs agents qui partagent un GPU : activez la tête ; c'est dans le gain en parallèle que la promesse de JetBrains tient.
- Un développeur, une requête à la fois : réglez deux propositions par pas et mesurez sur votre propre trafic.
- Un GPU de 16 GB : utilisez des poids en 8 bits et attendez-vous à moins de place pour les conversations en parallèle.
- Les tests qui comparent la sortie du modèle octet par octet : ils casseront avec ou sans la tête.
La limite, honnêtement : chaque réglage a tourné une fois, sur cinq courtes consignes à nous, donc prenez les petits écarts pour du bruit.
Chaque essai, le décompte de la mémoire et l'échelle des GPU se trouvent dans le test complet de Mellum2.1 MTP.