Ein 80B-Coding-Modell auf einer gemieteten A100, gesteuert von Claude Code
Qwen3 Coder Next (80B, AWQ 4-bit) auf vLLM, eine A100 80 GB für $1.79/h, ein API-Key für einen Entwickler und Claude Code. Befehle, Zahlen, Grenzen.
Ein Coding-Modell mit 80 Milliarden Parametern. Eine gemietete NVIDIA A100 SXM mit 80 GB. $1.79 pro Stunde laut Katalog am Tag der Aufnahme. Ein Entwickler tippt in Claude Code, und antworten tut ein Modell, das wir ausgesucht haben, auf einer GPU, die nur unserem Projekt gehört.
Das ist das ganze Video (3:29). Dieser Beitrag ist die lange Fassung: der genaue Befehl, die Umgebungsvariablen, die Falle, in die du beim ersten Request tappst, und was die Demo nicht beweist.
Warum sich die eigene Inferenz lohnt
Ein großer Teil meines Codes läuft inzwischen über einen Coding-Agent, und Agents sind gesprächig. Eine einzige Session schickt dein Repo, deine Prompts und deine halbfertigen Ideen an die Modell-API eines anderen, Token für Token, abgerechnet pro Token.
Die eigene Inferenz dreht einiges um:
- Privatsphäre. Das Modell läuft auf einer GPU, die nur deinem Projekt gehört, und kein Modellanbieter sieht deine Prompts oder deinen Code. Wer trotzdem im Pfad liegt: Die Requests gehen über den InferenceKey-Endpoint, und in dieser Demo ist die GPU ein Pod in einer Secure Cloud eines Drittanbieters. Das Vertrauen verschiebt sich, es verschwindet nicht. Wer den eigenen Server als Worker anbindet, nimmt den GPU-Vermieter aus dem Spiel.
- Kostenstruktur. Du zahlst pro GPU-Stunde, nicht pro Token. Ein Agent, der dieselben Dateien fünfzigmal neu liest, treibt keine Rechnung pro Token in die Höhe; er hält nur eine GPU beschäftigt, die du ohnehin bezahlst. Die Kehrseite: Der Zähler läuft, ob jemand tippt oder nicht. $1.79/h rund um die Uhr sind etwa $1,300 im Monat. Abrechnung pro Stunde gewinnt bei dauerhafter Last, wenn ein Agent den ganzen Tag auf den Endpoint einhämmert; Abrechnung pro Token gewinnt, wenn die GPU nachts brachliegen würde.
- Kontrolle. Du wählst das Modell, die Quantisierung, die Kontextlänge, den Tool-Parser. Niemand kündigt dein Modell an einem beliebigen Dienstag ab.
Ich denke, Open-Weights-Coding-Modelle sind inzwischen gut genug, um eine Claude-Code-Session durch einen Plan, einen Build und eine Runde Änderungen zu tragen, und genau das zeigt das Video. Wie weit das bei schwierigerer Arbeit reicht, ist noch offen. Die andere Frage ist die Verkabelung: ein großes Modell auf eine GPU bringen und es einem Entwickler sicher zugänglich machen, ohne einen Tag in SSH zu verbringen. Das haben wir ausprobiert.
Das Modell
cyankiwi/Qwen3-Coder-Next-AWQ-4bit, eine 4-Bit-AWQ-Quantisierung von Qwen3 Coder Next. Laut Model Card: 80B Parameter insgesamt, 3B aktiv pro Token (Mixture of Experts, 512 Experts, 10 aktiv), 262,144 Token nativer Kontext, Apache 2.0. Zwei verschiedene Dinge sorgen dafür, dass eine einzige Karte reicht. Die 4-Bit-Quantisierung sorgt dafür, dass es passt: 80B Gewichte mit etwa 4 Bit sind grob 40 GB plus Overhead, was auf 80 GB Platz für den KV-Cache lässt. Das MoE-Design sorgt dafür, dass es schnell ist: Alle 80B Gewichte bleiben im Speicher, aber jedes Token wird nur durch etwa 3B davon gerechnet.
Schritt 1: ein Projekt
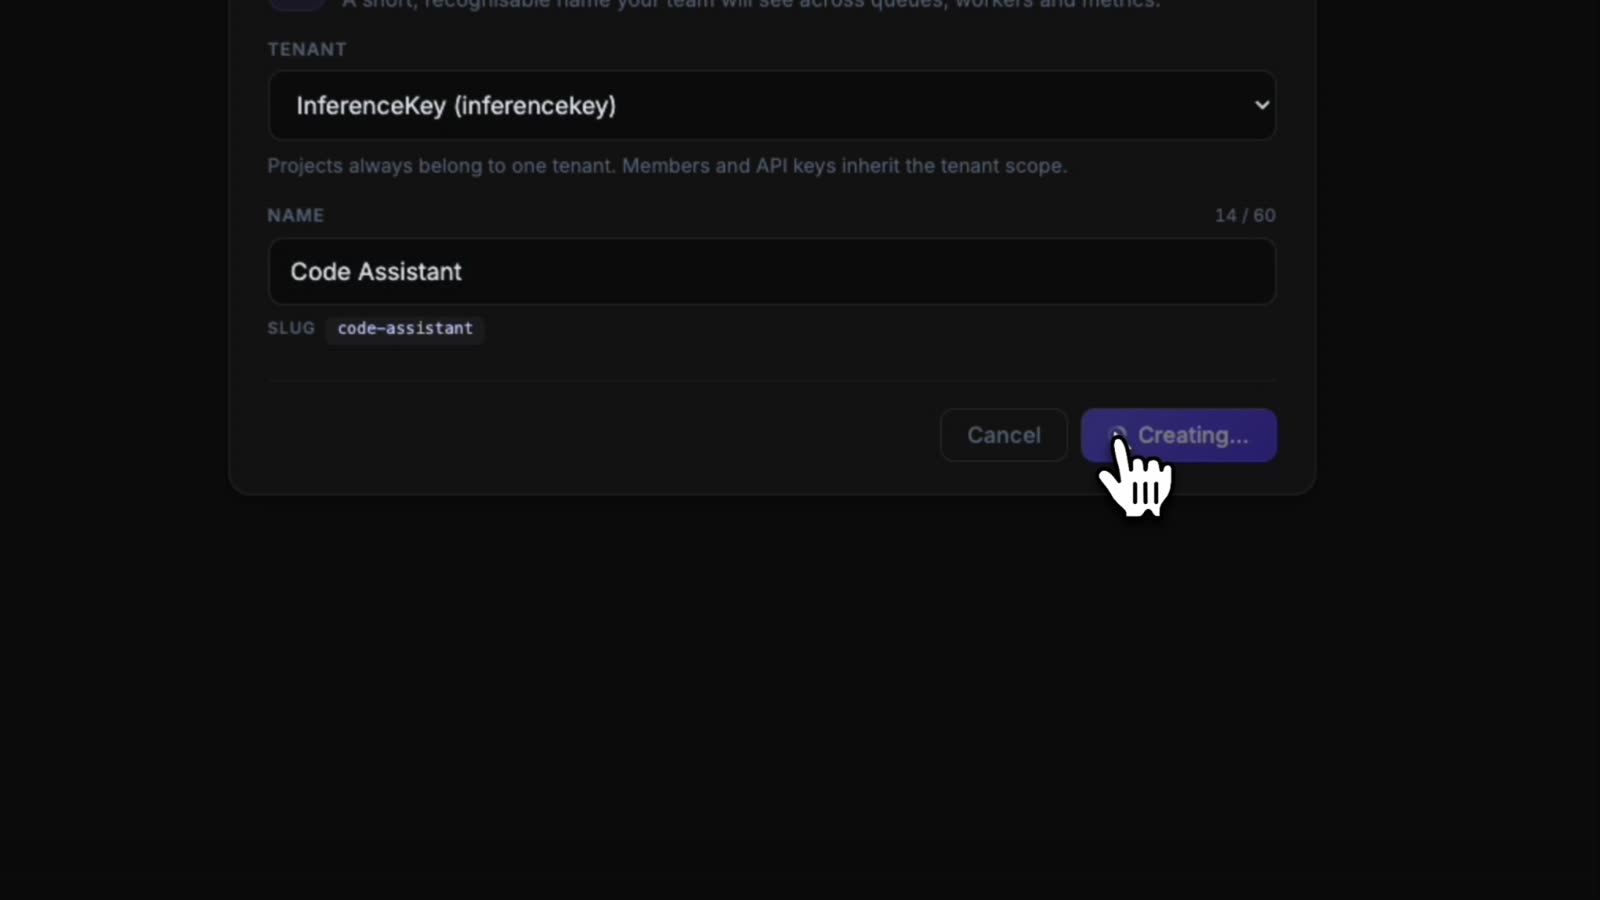
Ein Projekt ist ein Ordner für Workloads, Keys und Kosten. Unseres heißt Code Assistant, Slug code-assistant. Merk dir den Slug, er landet in der URL.
Schritt 2: ein Workload mit dem genauen vLLM-Befehl
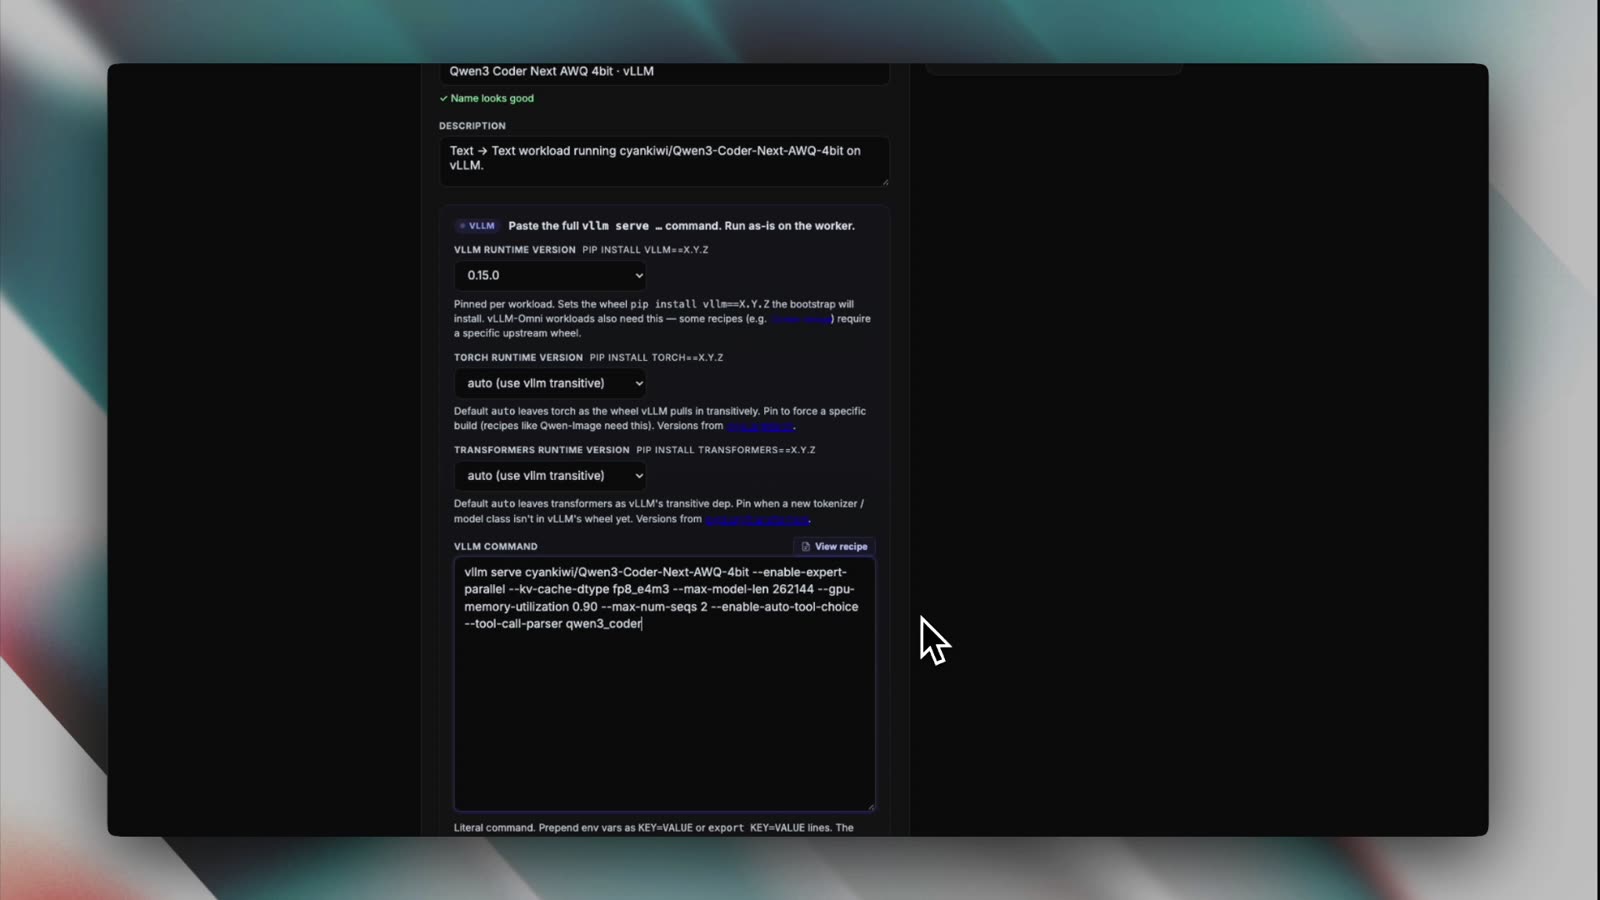
Workload anlegen, Backend wählen. Das Dropdown bietet vLLM, vLLM-Omni, SGLang, Ollama, llama.cpp (GGUF), stable-diffusion.cpp und ein API Gateway für externe Anbieter. Wir haben vLLM genommen, die Runtime auf 0.15.0 festgelegt und torch und transformers auf „auto (use vllm transitive)“ gelassen.
Das Befehlsfeld wird wörtlich genommen: Der Worker führt es genau so aus. Das haben wir eingefügt:
vllm serve cyankiwi/Qwen3-Coder-Next-AWQ-4bit \
  --enable-expert-parallel \
  --kv-cache-dtype fp8_e4m3 \
  --max-model-len 262144 \
  --gpu-memory-utilization 0.90 \
  --max-num-seqs 2 \
  --enable-auto-tool-choice \
  --tool-call-parser qwen3_coder
Was die Flags tun:
--max-model-len 262144: der volle native Kontext des Modells, 256K Token. Coding-Agents lesen viele Dateien.--kv-cache-dtype fp8_e4m3: speichert den KV-Cache in FP8, damit dieser Kontext neben die Gewichte passt.--gpu-memory-utilization 0.90: vLLM darf 90% der 80 GB belegen.--max-num-seqs 2: höchstens zwei Sequenzen gleichzeitig. Das ist ein Setup für einen Entwickler, und die Zahl sagt es auch.--enable-auto-tool-choice --tool-call-parser qwen3_coder: Tool Calls. Claude Code schickt Tool-Definitionen mit seinen Requests; ohne diese beiden Flags beantwortet vLLM Requests mit Tools mit einem 400. Der empfohlene Befehl aus der Model Card selbst nutzt dasselbe Paar.--enable-expert-parallel: stand in dem Befehl, den wir verwendet haben. Die Wirkung auf einer einzelnen GPU wurde nicht getestet.
Der Hilfetext unter dem Feld ist wissenswert: Du kannst Umgebungsvariablen als KEY=VALUE-Zeilen voranstellen, der Worker erzwingt --port 8000 für seine Health Checks, und jeder --chat-template-Pfad muss unter /opt/inferencekey/vllm/examples/ liegen.
Schritt 3: noch keine Hardware, also eine A100 mieten
An diesem Punkt existiert der Workload, aber nichts führt ihn aus: kein Worker zugewiesen, Status „No capacity“. Hier kannst du deinen eigenen Server anbinden. Für die Demo haben wir „Add worker to workload“ geöffnet, Tab „Deploy new cloud GPU“: 1 GPU pro Node, CUDA-Treiber 13.0, GPU-Modell A100 SXM · 80GB · $1.79/h, Secure Cloud.
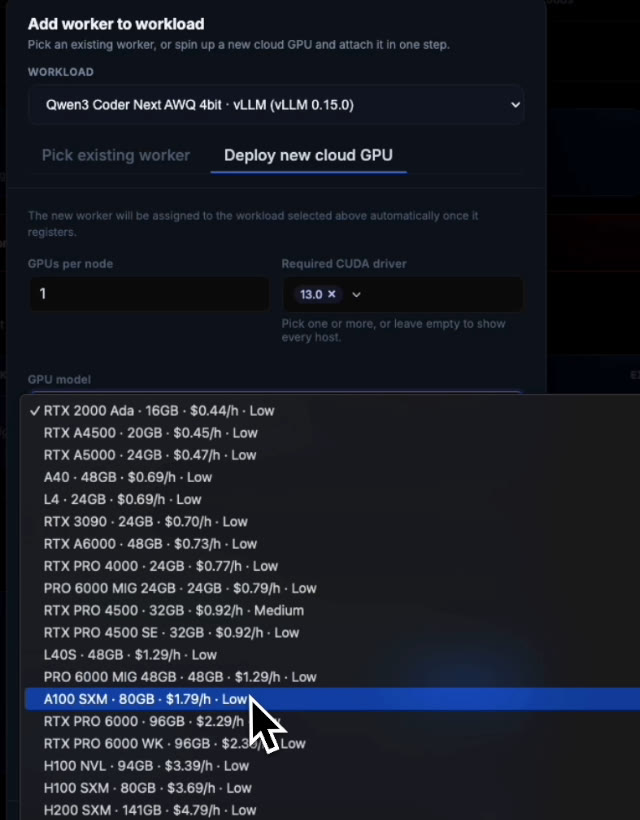
Zur Einordnung: Dasselbe Dropdown listete an diesem Tag eine L40S 48 GB für $1.29/h, eine H100 SXM 80 GB für $3.69/h und eine H200 SXM 141 GB für $4.79/h.
Eine Anmerkung zum Preis, weil das Video ihn falsch angibt. Die Sprecherstimme sagt, man könne diese GPU-Klasse für „just over one euro per hour“ mieten, also für knapp über einen Euro pro Stunde. Jeder Bildschirm in der Aufnahme zeigt $1.79/h für die A100 SXM 80 GB in der Secure Cloud: der Katalog, die Worker-Karte („COST 1.79 USD/h“) und der Projekt-Header („EST. COST $1.79/hr“). Glaub den Bildschirmen. Das ist der Katalogpreis vom 18. September 2026, dem Tag der Aufnahme, und Cloud-GPU-Preise ändern sich, also prüf das Dropdown, bevor du ein Budget darauf aufbaust. Das Panel gibt Preise inzwischen in Euro an, dort erwartet dich also eine andere Zahl und Währung.
Schritt 4: das Deployment, ohne die Teile, die ich sonst hasse
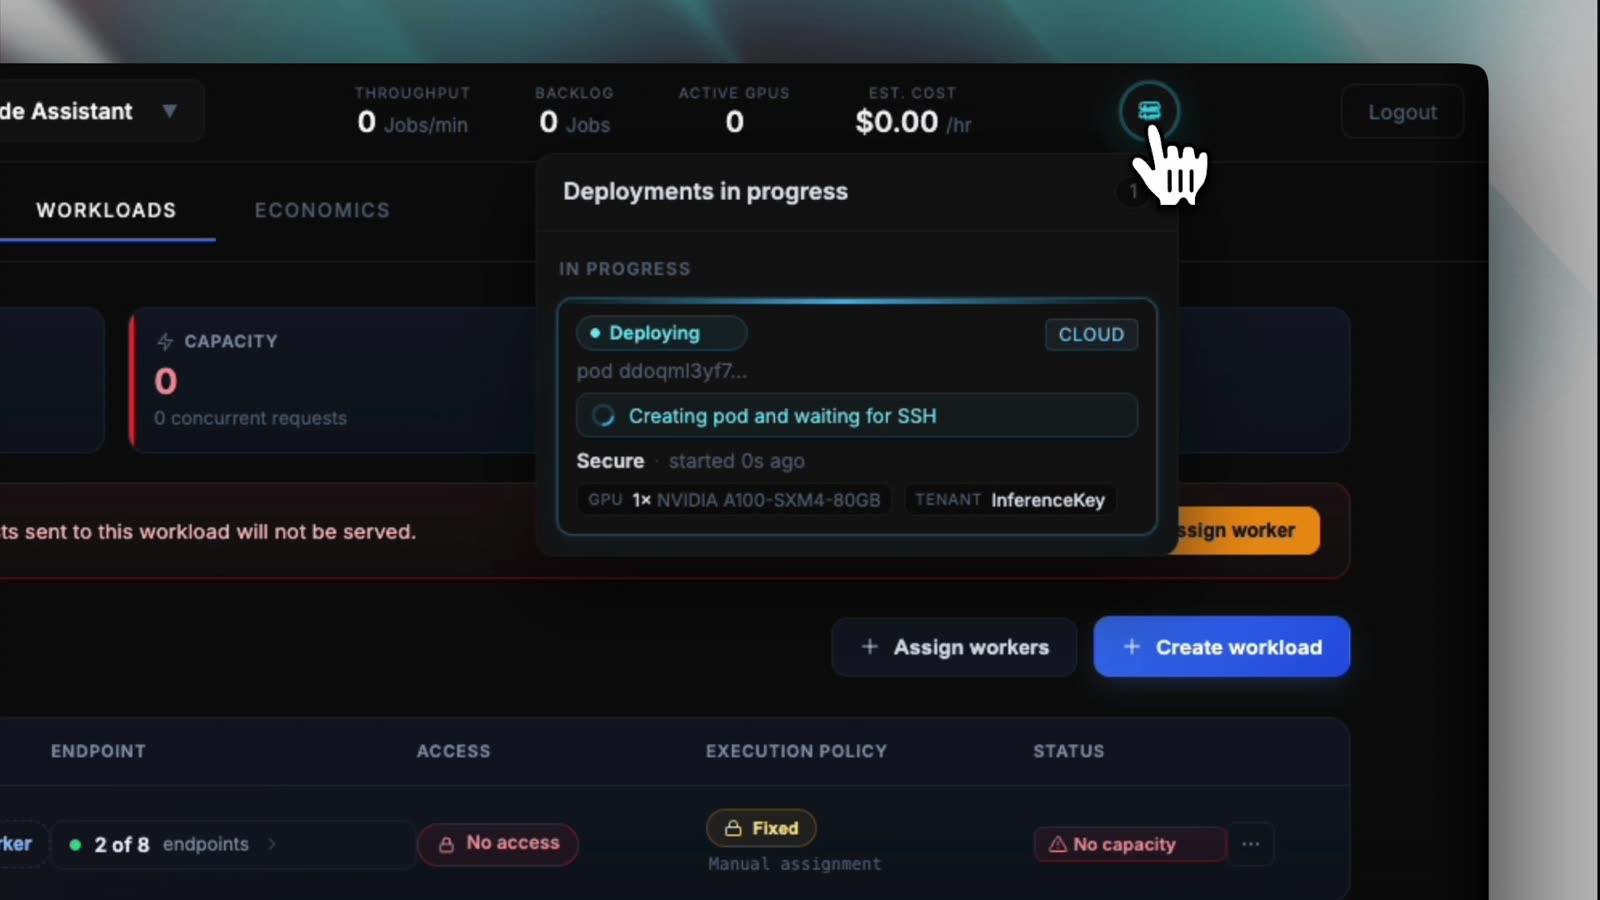
Klick auf Deploy, und ein Popup „Deployments in progress“ verfolgt den Fortschritt: Secure Cloud, 1x NVIDIA A100-SXM4-80GB, „Creating pod and waiting for SSH“. Zu der Aussage „kein SSH“ in der Sprecherstimme: Die Plattform nutzt SSH sehr wohl, um den Pod hochzufahren. Du öffnest nur nie eine Session, installierst nie CUDA-Pakete und konfigurierst nie die Umgebung.
Was du bekommst, sind die Logs des Workers, live ins Panel gestreamt: pip zieht die CUDA- und NVIDIA-Wheels, dann lädt die EngineCore von vLLM die Safetensors-Shards. Der Soundcheck, bei dem jedes Teil hochfährt, bevor irgendwer eine Note spielt.
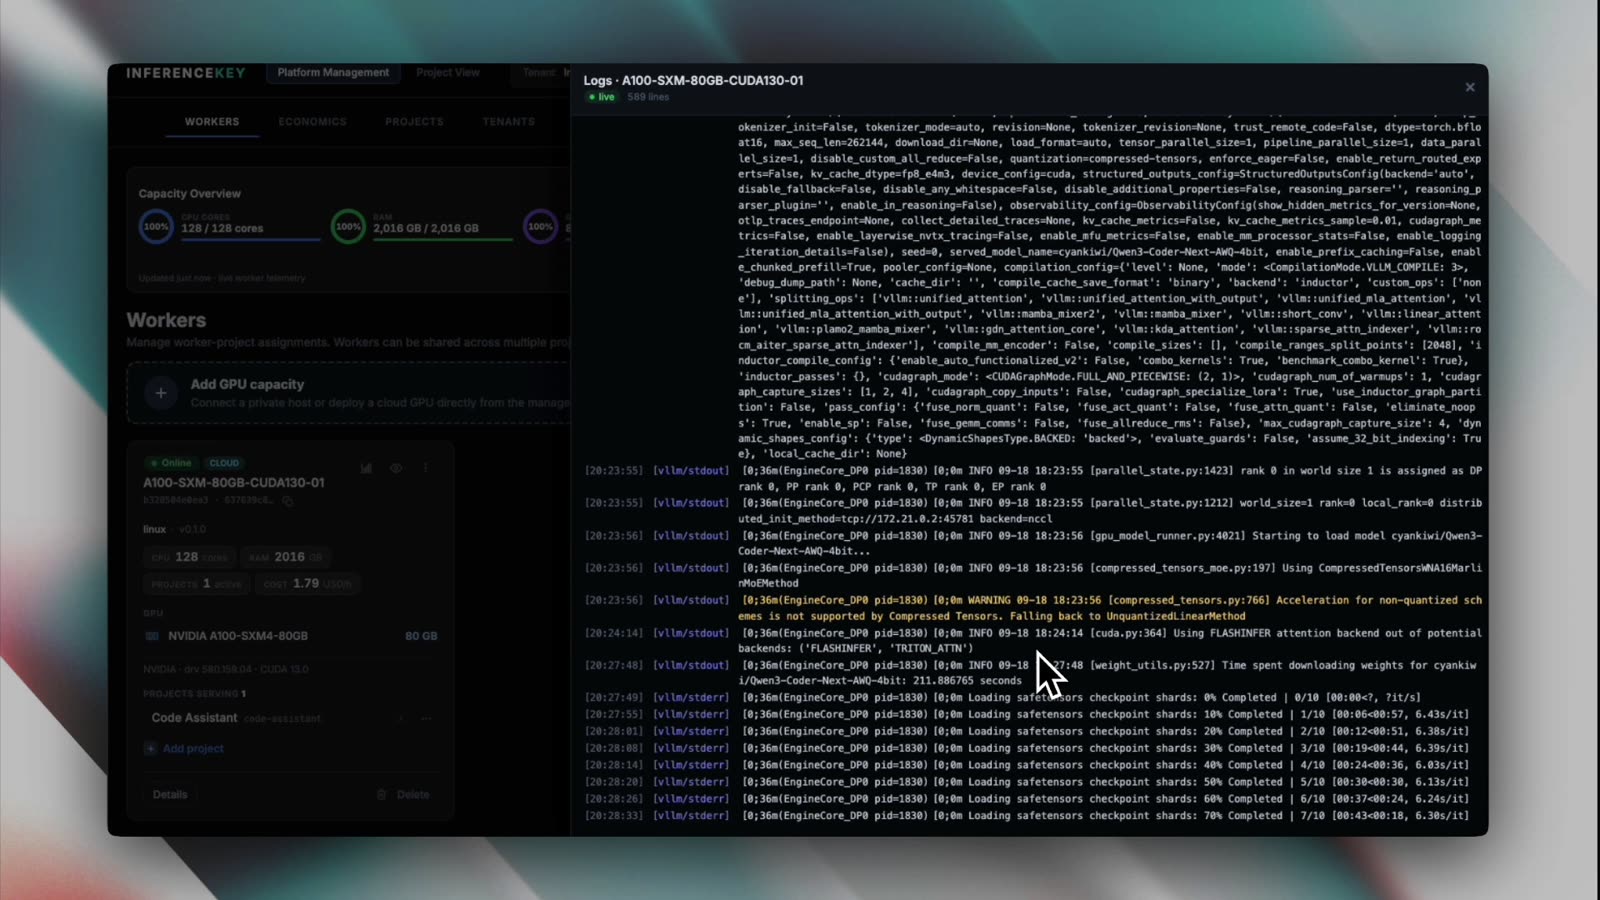
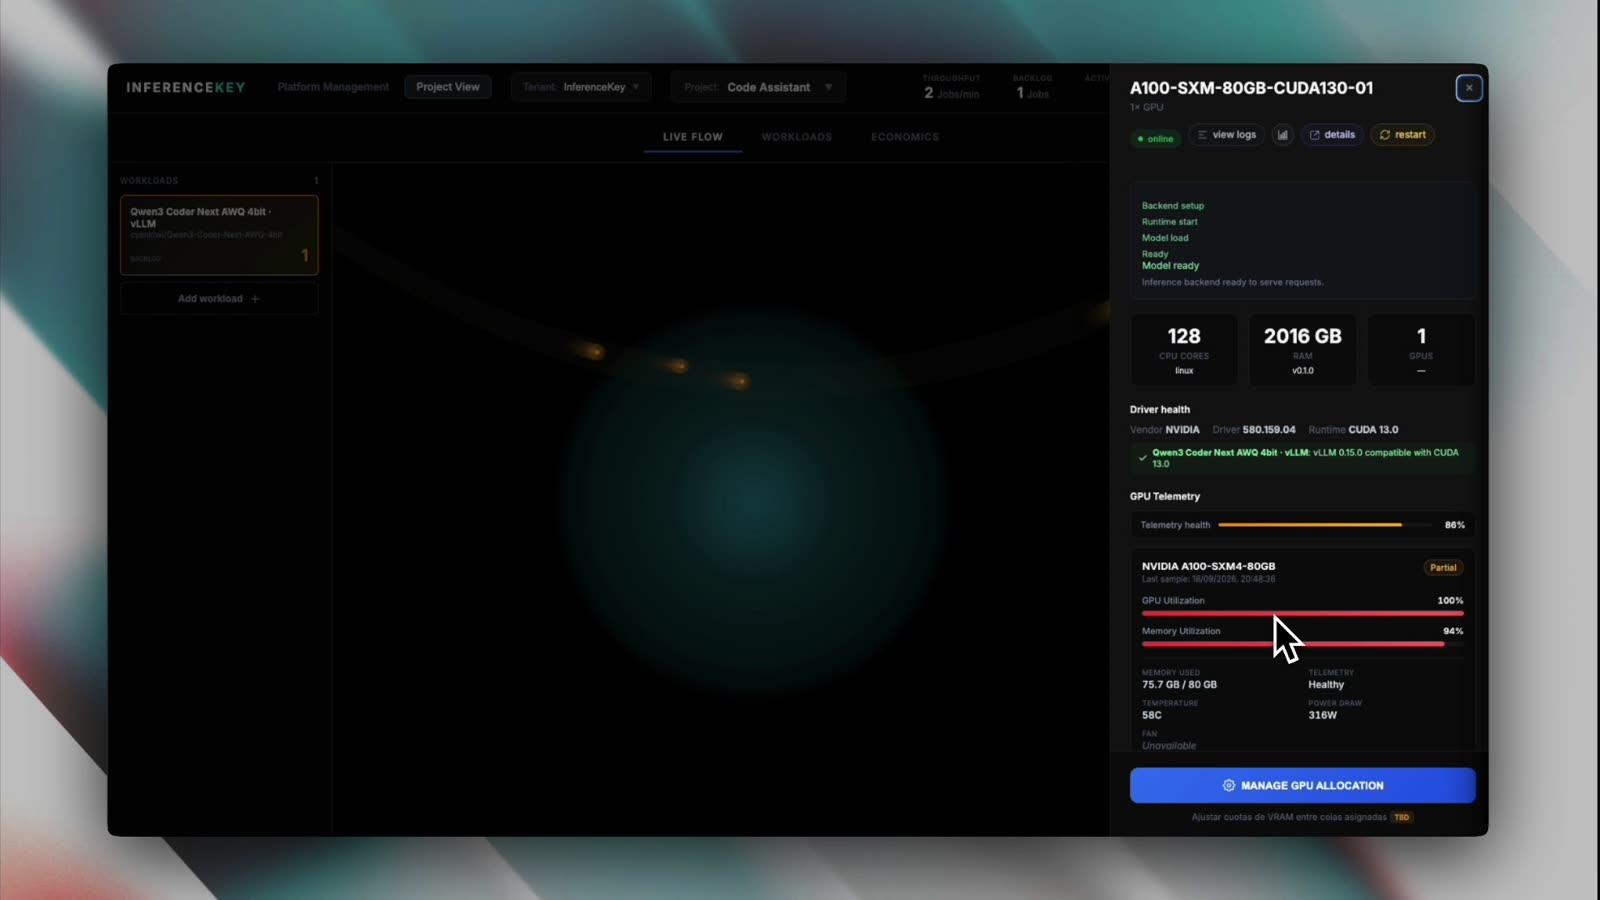
Das Video ist geschnitten, deshalb nenne ich keine Deploy-Zeit. Die gemietete Maschine sah am Ende so aus: A100-SXM4-80GB, Treiber 580.159.04, CUDA 13.0, 128 CPU-Kerne, 2016 GB RAM, dazu ein Treiber-Health-Check, der „vLLM 0.15.0 compatible with CUDA 13.0“ bestätigte.
Schritt 5: ein erster Request
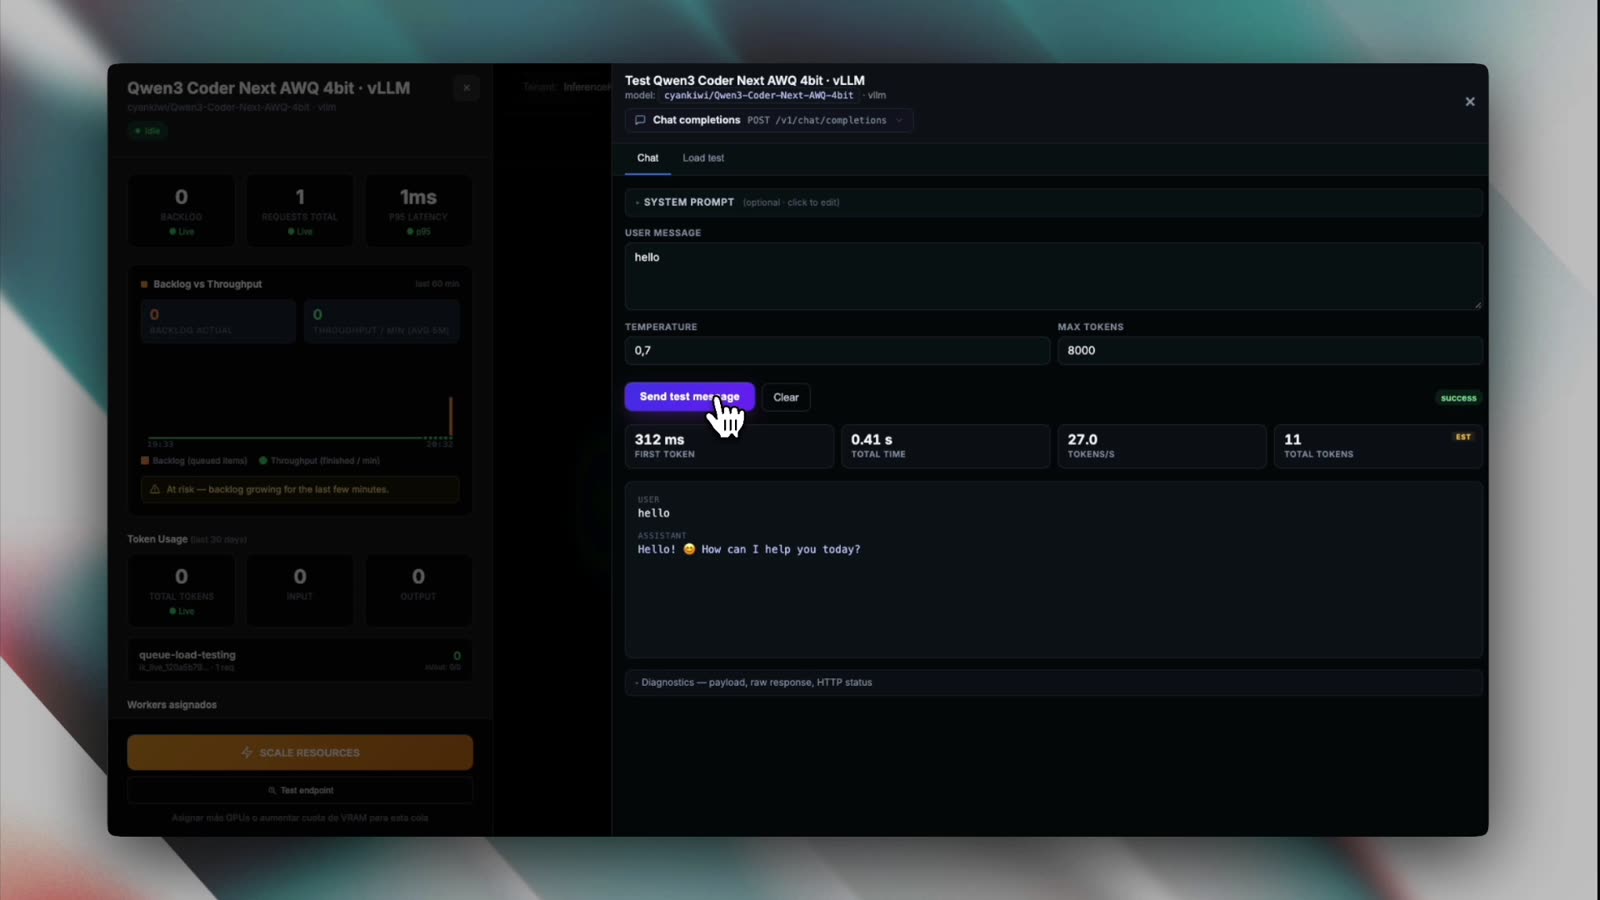
Der Workload hat ein eingebautes Test-Panel. Wir haben hello (Temperatur 0.7, max tokens 8000) an /v1/chat/completions geschickt und eine einzeilige Begrüßung zurückbekommen, die fragte, wie sie helfen könne, mit:
| Metrik | Wert |
|---|---|
| Erstes Token | 312 ms |
| Gesamtzeit | 0.41 s |
| Token gesamt | 11 (als EST markiert) |
Das ist ein Smoke Test, kein Benchmark. Elf Token Begrüßung sagen dir, dass das Modell geladen ist und der Pfad funktioniert; über den Decode-Durchsatz sagen sie nichts Ernsthaftes. Das Panel zeigte außerdem 27.0 tokens/s an, aber das teilt 11 Token durch eine Gesamtzeit, die größtenteils aus den 312 ms Warten auf das erste Token besteht, also lassen wir es weg.
Für einen Wert unter Dauerlast: Unser eigener Worker RTX-A6000-48GB-CUDA130-01 (eine RTX A6000, 48 GB, CUDA 13.0) erzeugt bei Claude-Code-Entwicklungsaufgaben mit 1M Token Kontext etwa 40 tokens/s.
Schritt 6: ein API-Key für einen Entwickler
Der Entwickler, Chad Coder, bekommt einen eigenen Key. Zugriffsbereich „Specific endpoints“ (die Alternative ist „Entire project“), und nur ein Endpoint angehakt: code-assistant/qwen3-coder-next-awq-4bit-vllm. Der Key wird nur einmal angezeigt.
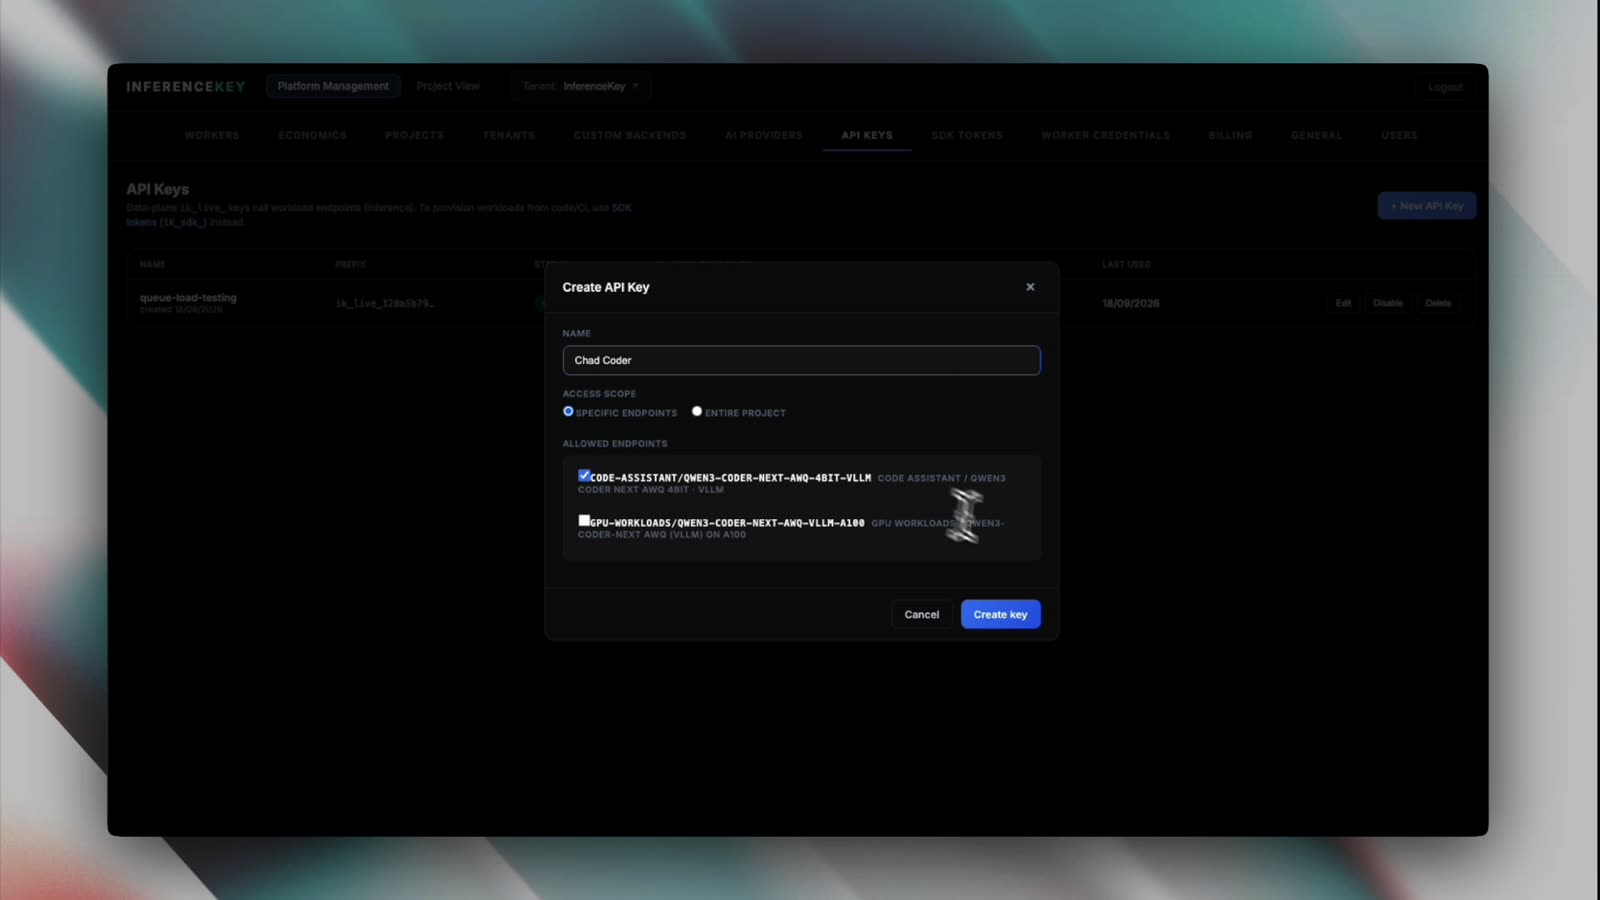
Was ich im Code des Managers geprüft habe: Ein Key kommt nur durch, wenn seine erlaubten Endpoints <project>/<workload> oder <project>/* enthalten, sonst wird der Request als endpoint_forbidden abgelehnt, und die Data Plane akzeptiert nur Keys, die mit ik_live_ beginnen. Die Nutzung wird pro Key erfasst; Chads Token siehst du weiter unten in der Live-Ansicht. Die Sprecherstimme spricht von Quotas; was ich tatsächlich im Code verifiziert habe, sind die Beschränkung auf Endpoints und die Nutzung pro Key.
Schritt 7: Claude Code darauf zeigen lassen
Der Manager stellt pro Workload eine Messages-Route im Anthropic-Stil bereit, POST /endpoint/<project>/<workload>/v1/messages, neben dem OpenAI-artigen /v1/chat/completions. Claude Code hängt /v1/messages selbst an, also endet die Base URL beim Workload:
export ANTHROPIC_BASE_URL=https://api.inferencekey.com/endpoint/code-assistant/qwen3-coder-next-awq-4bit-vllm
export ANTHROPIC_AUTH_TOKEN=ik_live_...
export ANTHROPIC_MODEL=qwen3-coder-next-awq-4bit-vllm
export ANTHROPIC_DEFAULT_HAIKU_MODEL=qwen3-coder-next-awq-4bit-vllm
export ANTHROPIC_DEFAULT_SONNET_MODEL=qwen3-coder-next-awq-4bit-vllm
export ANTHROPIC_DEFAULT_OPUS_MODEL=qwen3-coder-next-awq-4bit-vllm
claude
api.inferencekey.com ist der öffentliche Standard-Host; kopier die Base URL, die dein Panel anzeigt. ANTHROPIC_AUTH_TOKEN geht als Authorization: Bearer raus, was der Manager bevorzugt; ANTHROPIC_API_KEY (gesendet als x-api-key) funktioniert auch, überschreibt aber einen Login per Abo, und das interaktive Claude Code fragt dich einmal, ob du den eigenen Key freigeben willst (die Doku beschreibt diese Abfrage nur für ANTHROPIC_API_KEY). Kommen beide Header mit unterschiedlichen Werten an, lehnt der Manager den Request mit einem 401 authentication_error ab.
Jetzt die Falle. Der Endpoint ist an einen Workload gebunden, und der Manager prüft den Modellnamen. Er akzeptiert kein Modell, default, den Workload-Slug oder den Modellnamen des Workloads; alles andere bekommt ein HTTP 400 mit dem Fehlertyp invalid_request_error und der Meldung „Model '…' is not available on this endpoint“ (intern lautet der Code model_not_available). Claude Code schickt standardmäßig claude-*-Modellnamen und nutzt außerdem ein kleines Modell für Hintergrundarbeit. Setz also ANTHROPIC_MODEL und ANTHROPIC_DEFAULT_HAIKU_MODEL auf den Workload-Slug, sonst prallt dein erster Prompt ab. Alles, was den Alias sonnet oder opus wählt (der /model-Picker, opusplan), würde weiterhin claude-*-Namen schicken, deshalb zeigt der Block oben auch ANTHROPIC_DEFAULT_SONNET_MODEL und ANTHROPIC_DEFAULT_OPUS_MODEL auf den Slug.
Schritt 8: zuschauen, wie es arbeitet
Chad bat um eine Landingpage für „Chad Coder“: eine Liste von React-Komponenten (Navbar, Hero, Services, Projects, Testimonial, TechStack, CTA und mehr) und die Vorgabe, sie „should feel like a $20k-$50k custom agency website, not a generic Tailwind template“. Claude Code ging in den Plan-Modus, schrieb src/components/ui/Button.tsx, installierte class-variance-authority, clsx und tailwind-merge, führte npm run build aus und bearbeitete weiter Komponenten.
Währenddessen zeigt der Live Flow des Projekts, wie Requests zur GPU wandern, mit dem Header bei 2 jobs/min, 1 im Backlog, 1 aktive GPU, $1.79/hr. Zu diesem Zeitpunkt der Session, mitten im Build, zählte die Workload-Seitenleiste 5 Requests und 31.7K Token, und die Aufschlüsselung pro Key verbuchte 4 Requests und alle 31.7K Token auf Chads Key. Das ist eine Momentaufnahme, nicht die vollen Kosten der Landingpage. In der Worker-Seitenleiste sagt die GPU die Wahrheit: 100% Auslastung, 75.7 GB von 80 GB belegt, 58 C, 316 W.
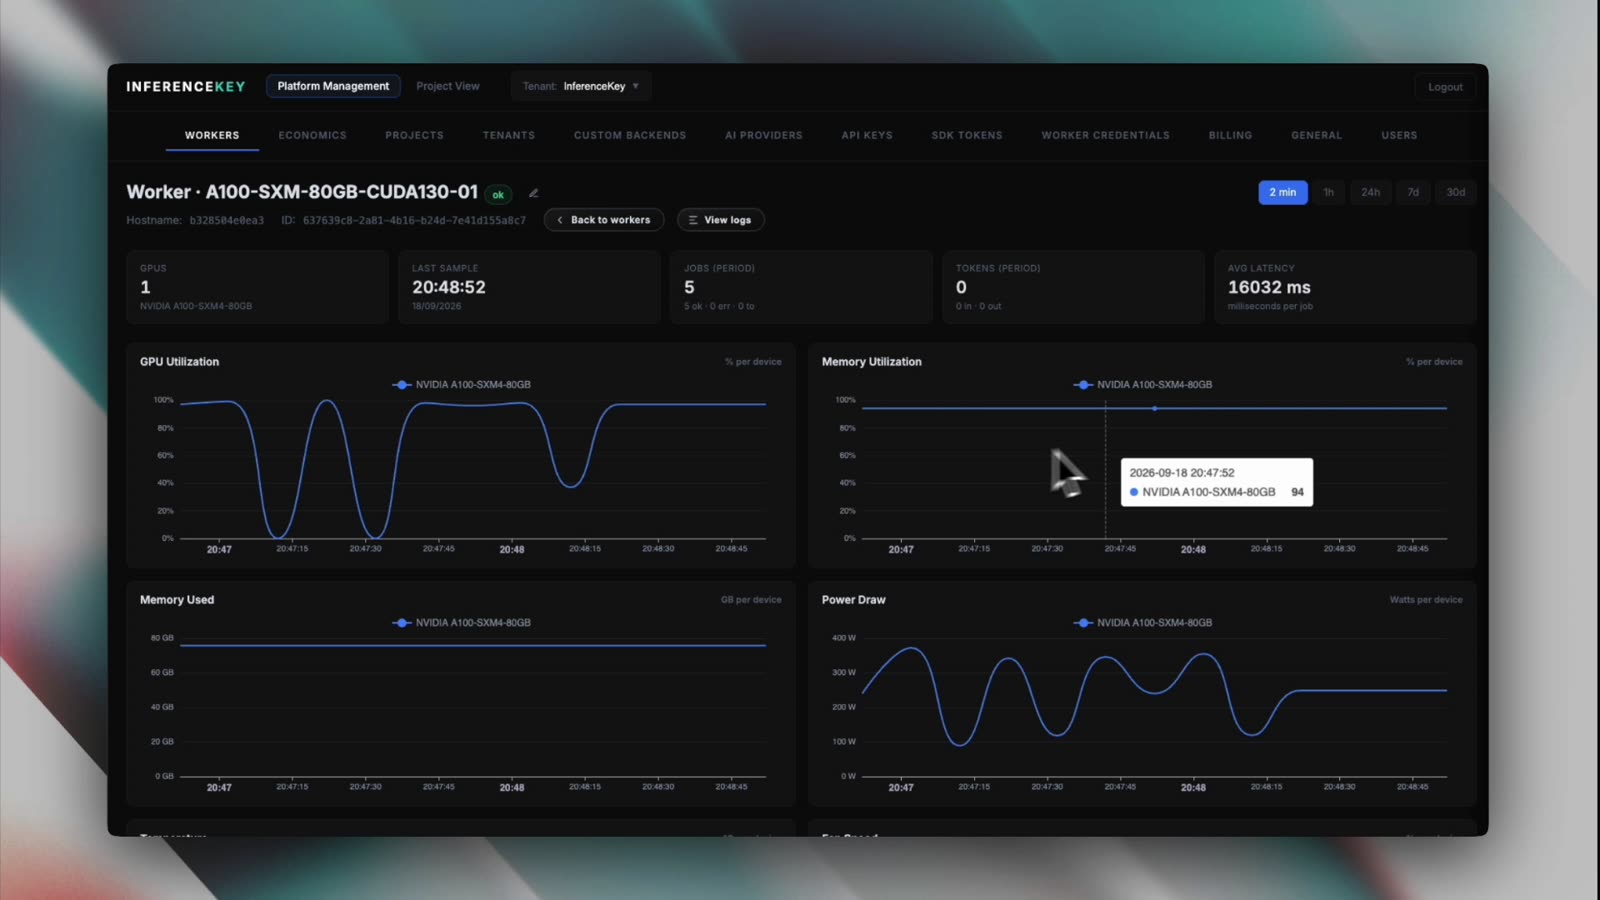
Die Worker-Seite hält die Diagramme der letzten zwei Minuten vor: belegter Speicher flach um 76 GB, Leistungsaufnahme mit Spitzen bei fast 380 W, 5 Jobs ok, 0 Fehler und 16032 ms durchschnittliche Latenz pro Job in diesem Zeitfenster. Diese Jobs sind Agent-Schritte von Claude Code, also lies den Durchschnitt als grobes Gefühl, nicht als Latenz-Benchmark.
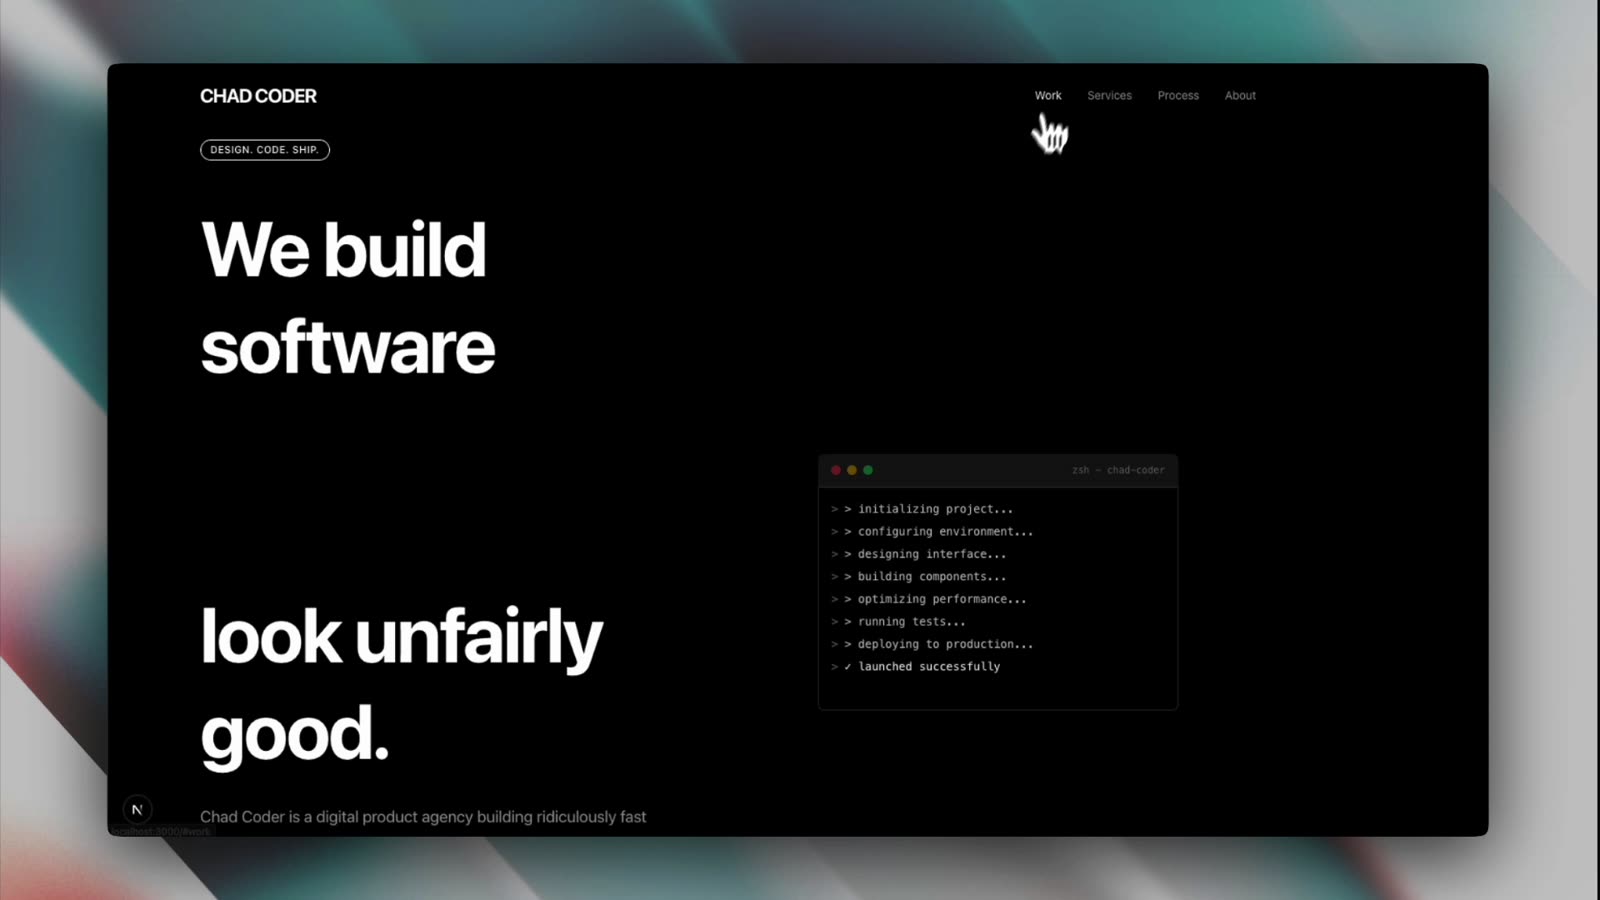
Und das Ergebnis: eine dunkle Landingpage mit einem Header „CHAD CODER“ und der Überschrift „We build software look unfairly good.“ Ja, im Hero fehlt ein Wort, höchstwahrscheinlich ein Wort-Slot, der nicht gerendert wurde. Der Projects-Bereich hat Platzhalterkarten. Es ist ein erster Entwurf eines Agents, keine fertige Website.
Was das beweist und was nicht
Zuerst die Grenzen:
- Größenordnung. Eine GPU, ein Entwickler,
--max-num-seqs 2. - Qualität. Ein auf 4 Bit quantisiertes Modell, also ist im Vergleich zu den Gewichten in voller Präzision mit etwas Qualitätsverlust zu rechnen. Wie viel, haben wir nicht gemessen.
- Die Aufgabe. Eine Landingpage ist kein harter Coding-Benchmark: kein großes Legacy-Repo, kein vertracktes Refactoring, keine Eval-Suite.
- Die Zahlen. Für den A100-Lauf gibt es nur eine Begrüßung mit 11 Token, die Geschwindigkeit ist hier also nicht gemessen; der Wert von 40 tokens/s stammt von einer anderen Karte (RTX A6000) und Konfiguration. Der 256K-Kontext ist konfiguriert, nicht ausgereizt: Die Momentaufnahme der Nutzung mitten in der Session zeigte 31.7K Input-Token.
- Kosten. Wir haben diese Session nicht mit Preisen pro Token verglichen. Mit einem Entwickler und zwei Sequenzen gleichzeitig ist das nicht das Setup, in dem sich Abrechnung pro Stunde auszahlt; dafür braucht es mehrere Entwickler oder Agents, die sich die GPU teilen.
- Der Agent. Das ist Claude Code, das Qwen steuert, nicht Claude. Claude Code ist um Claude-Modelle herum gebaut. Mit einer Base URL, die nicht von Anthropic stammt, ist die MCP-Tool-Suche standardmäßig aus, und das Verhalten des Agents hängt davon ab, wie gut das Modell dem Tool-Protokoll von Claude Code folgt. Wir haben es nicht mit gehostetem Claude bei derselben Aufgabe verglichen.
- Privatsphäre. Die Requests laufen weiterhin über den InferenceKey-Endpoint und einen gemieteten Cloud-Host.
- Multi-GPU. Die Sprecherstimme sagt, man könne GPUs hinzufügen und die Requests auf sie verteilen. Das wird in diesem Video nicht gezeigt, und ich habe es hier nicht getestet.
Was es zeigt: ein 80B-MoE-Coding-Modell, konfiguriert für seinen vollen 256K-Kontext, das eine echte Claude-Code-Session bedient, Tool Calls inklusive, auf einer einzigen A100 für $1.79/h. Keine SSH-Session, keine von Hand gebaute Umgebung, ein Key, der auf einen Endpoint beschränkt ist, Token-Abrechnung pro Key und GPU-Telemetrie, die du lesen kannst, während der Agent arbeitet. Es ist die langweilige Sorte Setup, und das ist als Kompliment gemeint.
Als Nächstes auf der Setlist: mehr GPUs hinter demselben Endpoint und ein anspruchsvollerer Coding-Workload als eine Landingpage.
Die Schritt-für-Schritt-Anleitung steht in der Doku: Deploy your own code assistant.