Un modèle de code de 80B sur une A100 louée, piloté par Claude Code
Qwen3 Coder Next (80B, AWQ 4 bits) sur vLLM, une A100 80 Go à $1.79/h, une clé d'API pour un développeur, Claude Code branché. Commandes, chiffres, limites.
Un modèle de code de 80 milliards de paramètres. Une NVIDIA A100 SXM de 80 Go, louée. $1.79 de l'heure au catalogue le jour de l'enregistrement. Un développeur qui tape dans Claude Code, avec les réponses d'un modèle que nous avons choisi, sur un GPU dédié à notre projet.
C'est toute la vidéo (3:29). Cet article en est la version longue : la commande exacte, les variables d'environnement, le piège qui vous attend dès la première requête, et ce que la démo ne prouve pas.
Pourquoi s'embêter à posséder l'inférence
Une bonne partie de mon code passe désormais par un agent de code, et les agents sont bavards. Une seule session envoie votre dépôt, vos prompts et vos idées à moitié finies à l'API de modèle de quelqu'un d'autre, token par token, facturés au token.
Posséder l'inférence change plusieurs choses :
- Confidentialité. Le modèle tourne sur un GPU dédié à votre projet, et aucun fournisseur de modèles ne voit vos prompts ni votre code. Qui reste sur le chemin : les requêtes passent par l'endpoint InferenceKey, et dans cette démo le GPU est un pod dans un secure cloud tiers. La confiance se déplace, elle ne disparaît pas. Rattacher votre propre serveur comme worker retire le loueur de GPU de l'équation.
- Forme du coût. Vous payez à l'heure de GPU, pas au token. Un agent qui relit cinquante fois les mêmes fichiers ne fait pas grimper une facture au token ; il occupe simplement un GPU que vous payez déjà. Le revers : le compteur tourne, que quelqu'un tape ou non. $1.79/h laissés allumés 24/7, c'est environ $1,300 par mois. L'heure gagne sous charge soutenue, avec un agent qui martèle l'endpoint toute la journée ; le token gagne quand le GPU resterait inactif la nuit.
- Contrôle. Vous choisissez le modèle, la quantification, la longueur de contexte, le parser d'outils. Personne ne déprécie votre modèle un mardi.
Je pense que les modèles de code à poids ouverts sont désormais assez bons pour mener une session Claude Code à travers un plan, un build et une série de modifications, ce que montre la vidéo. Jusqu'où cela tient sur un travail plus difficile reste une question ouverte. L'autre question, c'est la tuyauterie : mettre un gros modèle sur un GPU et l'exposer proprement à un développeur sans passer une journée en SSH. C'est ce que nous avons essayé.
Le modèle
cyankiwi/Qwen3-Coder-Next-AWQ-4bit, une quantification AWQ 4 bits de Qwen3 Coder Next. D'après la model card : 80B paramètres au total, 3B actifs par token (Mixture of Experts, 512 experts, 10 actifs), 262,144 tokens de contexte natif, Apache 2.0. Deux choses différentes permettent de tenir sur une seule carte. La quantification 4 bits le fait rentrer : 80B poids à environ 4 bits, c'est à peu près 40 Go plus l'overhead, ce qui laisse de la place sur 80 Go pour le KV cache. L'architecture MoE le rend rapide : les 80B poids restent tous en mémoire, mais chaque token ne passe que par environ 3B d'entre eux.
Étape 1 : un projet
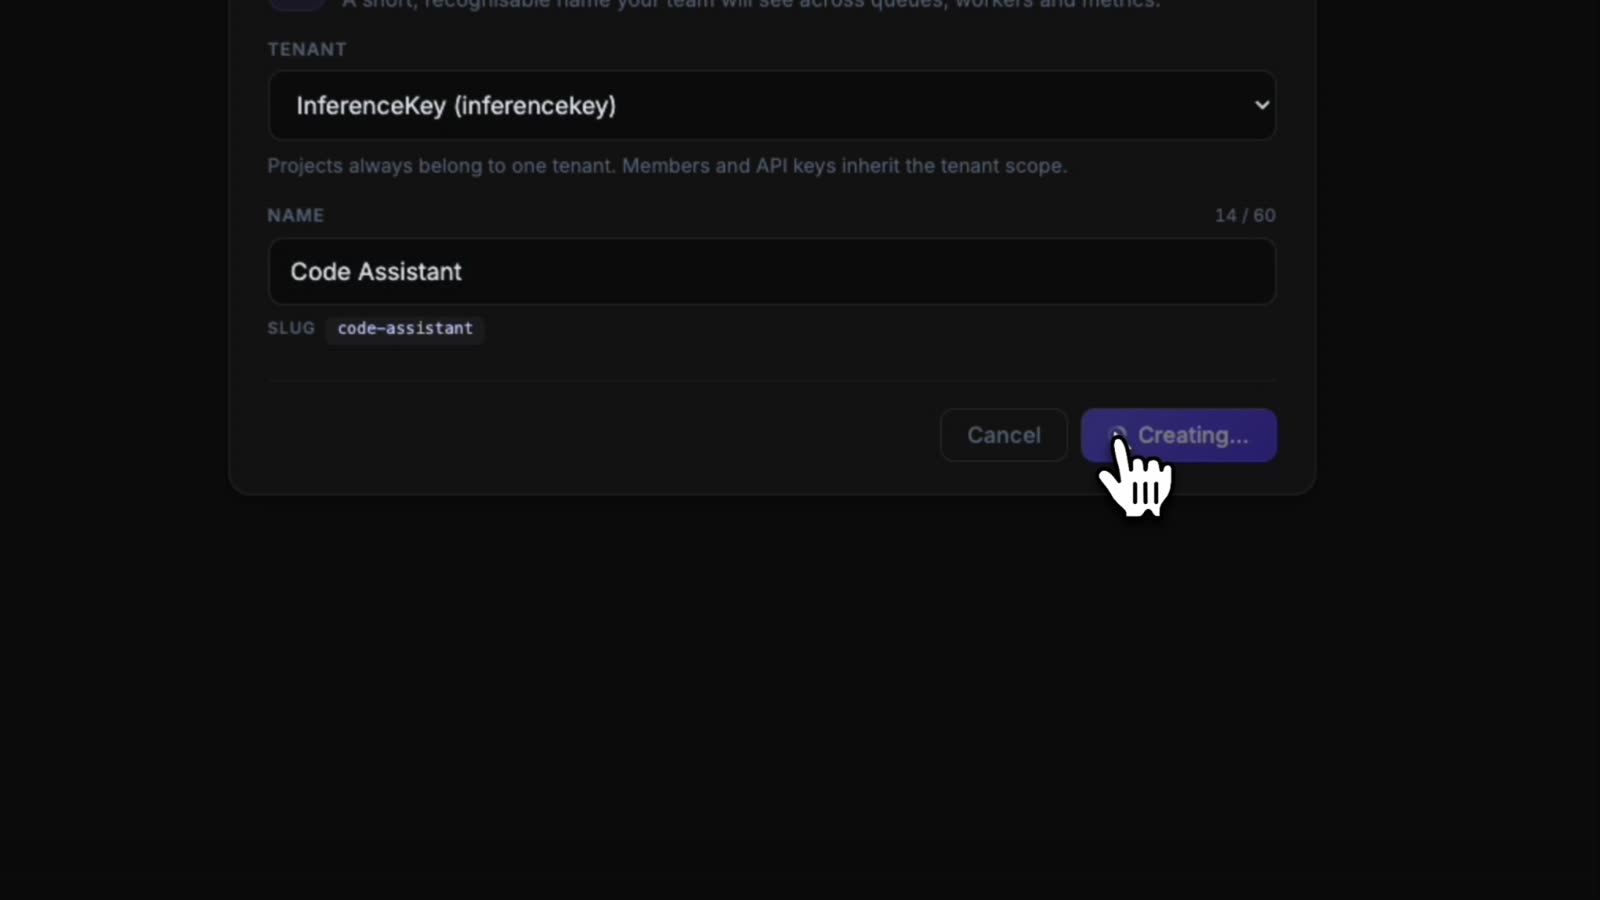
Un projet est un dossier pour les workloads, les clés et les coûts. Le nôtre s'appelle Code Assistant, slug code-assistant. Retenez le slug, il finit dans l'URL.
Étape 2 : un workload avec la commande vLLM exacte
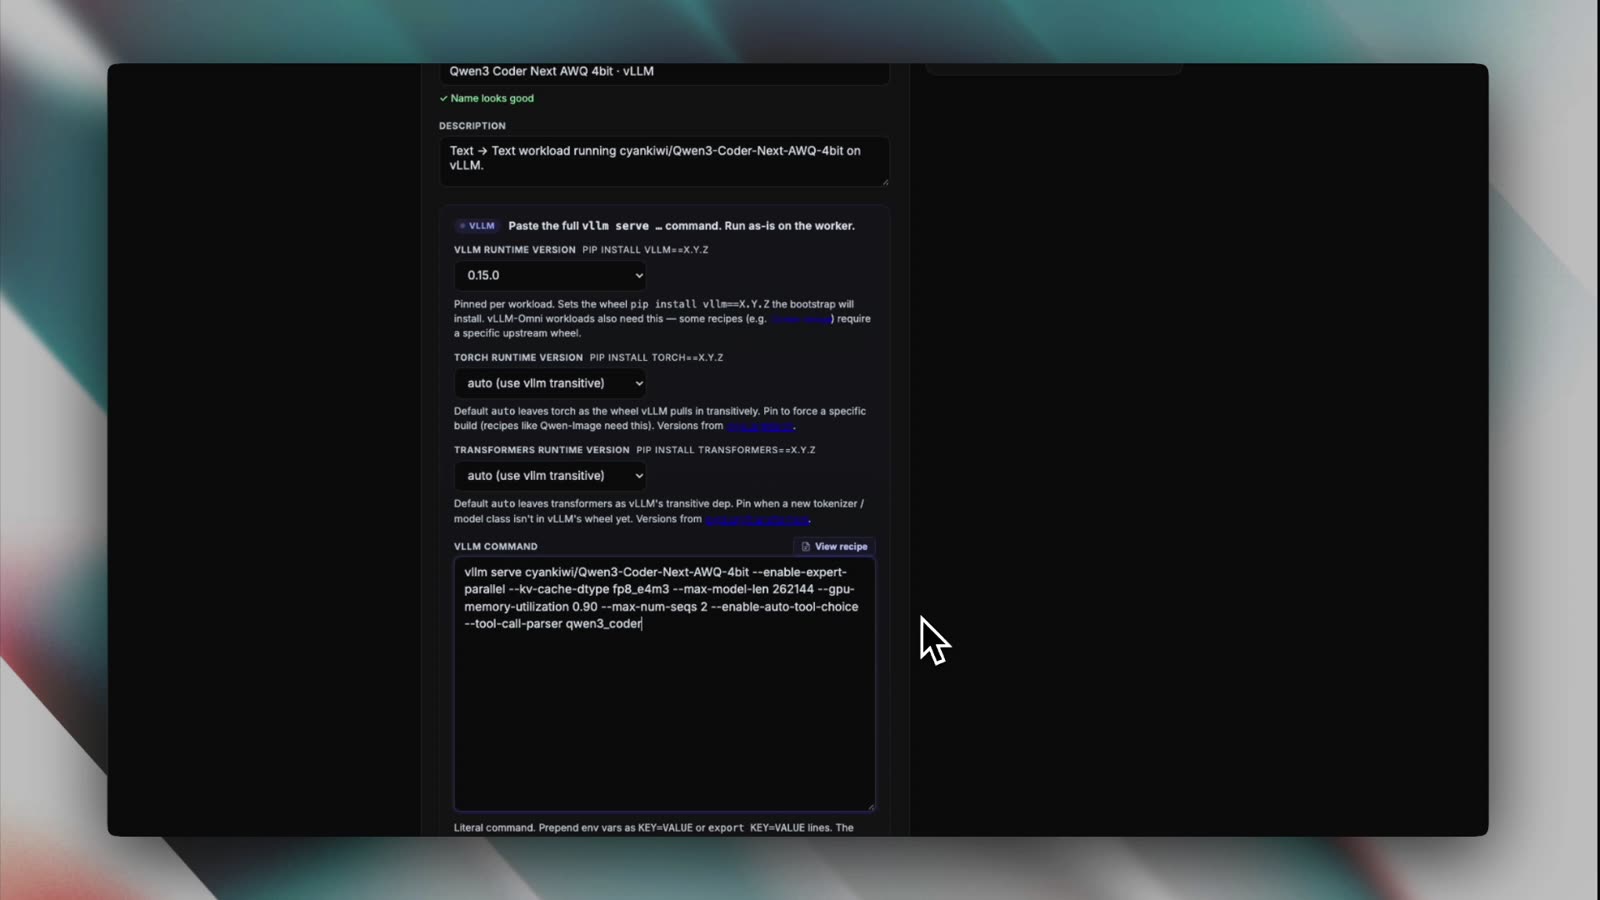
Créez un workload, choisissez un backend. La liste déroulante propose vLLM, vLLM-Omni, SGLang, Ollama, llama.cpp (GGUF), stable-diffusion.cpp et un API Gateway pour les fournisseurs externes. Nous avons pris vLLM, fixé le runtime en 0.15.0 et laissé torch et transformers sur "auto (use vllm transitive)".
Le champ de commande est littéral : le worker l'exécute tel quel. Voici ce que nous avons collé :
vllm serve cyankiwi/Qwen3-Coder-Next-AWQ-4bit \
  --enable-expert-parallel \
  --kv-cache-dtype fp8_e4m3 \
  --max-model-len 262144 \
  --gpu-memory-utilization 0.90 \
  --max-num-seqs 2 \
  --enable-auto-tool-choice \
  --tool-call-parser qwen3_coder
Ce que font les flags :
--max-model-len 262144: le contexte natif complet du modèle, 256K tokens. Les agents de code lisent beaucoup de fichiers.--kv-cache-dtype fp8_e4m3: stocke le KV cache en FP8 pour que ce contexte tienne à côté des poids.--gpu-memory-utilization 0.90: vLLM peut prendre 90 % des 80 Go.--max-num-seqs 2: au plus deux séquences en vol. C'est une configuration pour un seul développeur, et le chiffre le dit.--enable-auto-tool-choice --tool-call-parser qwen3_coder: les appels d'outils. Claude Code envoie des définitions d'outils avec ses requêtes ; sans ces deux flags, vLLM répond par un 400 aux requêtes qui portent des outils. La commande recommandée par la model card elle-même utilise la même paire.--enable-expert-parallel: il figurait dans la commande que nous avons utilisée. Son effet sur un seul GPU n'a pas été testé.
Le texte d'aide sous le champ vaut le détour : vous pouvez ajouter en tête des variables d'environnement sous forme de lignes KEY=VALUE, le worker impose --port 8000 pour ses health checks, et tout chemin --chat-template doit se trouver sous /opt/inferencekey/vllm/examples/.
Étape 3 : pas encore de matériel, donc on loue une A100
À ce stade, le workload existe et rien ne l'exécute : aucun worker assigné, statut "No capacity". Vous pouvez rattacher votre propre serveur ici. Pour la démo, nous avons ouvert "Add worker to workload", onglet "Deploy new cloud GPU" : 1 GPU par nœud, driver CUDA 13.0, modèle de GPU A100 SXM · 80GB · $1.79/h, Secure cloud.
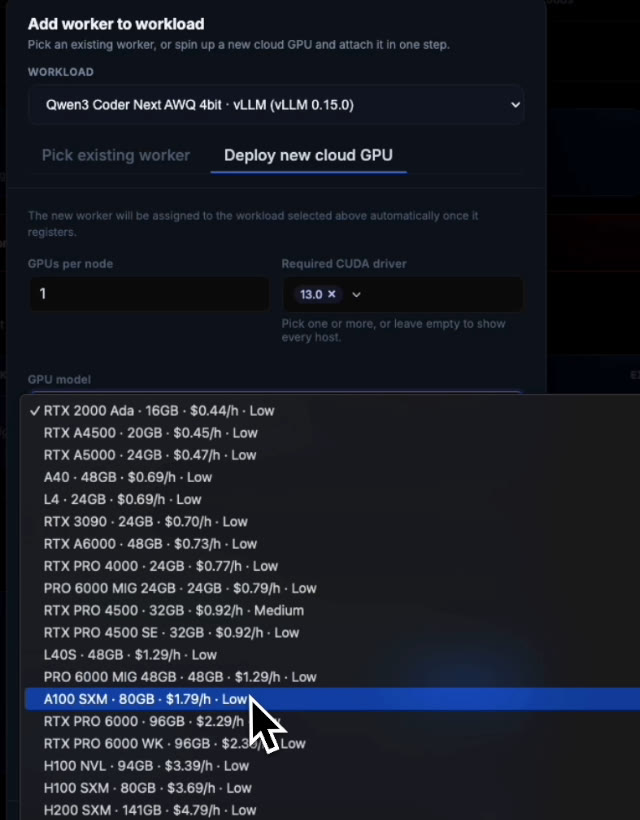
Pour situer, la même liste affichait ce jour-là une L40S 48 Go à $1.29/h, une H100 SXM 80 Go à $3.69/h et une H200 SXM 141 Go à $4.79/h.
Une remarque sur le prix, parce que la vidéo se trompe. La narration dit qu'on peut louer cette classe de GPU pour "un peu plus d'un euro de l'heure". Tous les écrans de l'enregistrement indiquent $1.79/h pour l'A100 SXM 80 Go en secure cloud : le catalogue, la carte du worker ("COST 1.79 USD/h") et l'en-tête du projet ("EST. COST $1.79/hr"). Fiez-vous aux écrans. C'est le prix catalogue du 18 septembre 2026, le jour de l'enregistrement, et les prix des GPU dans le cloud bougent, alors vérifiez la liste déroulante avant de bâtir un budget dessus. Le panel affiche depuis les prix en euros, attendez-vous donc à un autre chiffre et à une autre devise.
Étape 4 : le déploiement, sans les parties que je déteste d'habitude
Cliquez sur deploy et une popup "Deployments in progress" en suit l'avancement : secure cloud, 1x NVIDIA A100-SXM4-80GB, "Creating pod and waiting for SSH". À propos de la phrase "sans SSH" de la narration : la plateforme utilise bien SSH pour amorcer le pod. Simplement, vous n'ouvrez jamais de session, n'installez jamais de paquets CUDA, ne configurez jamais l'environnement.
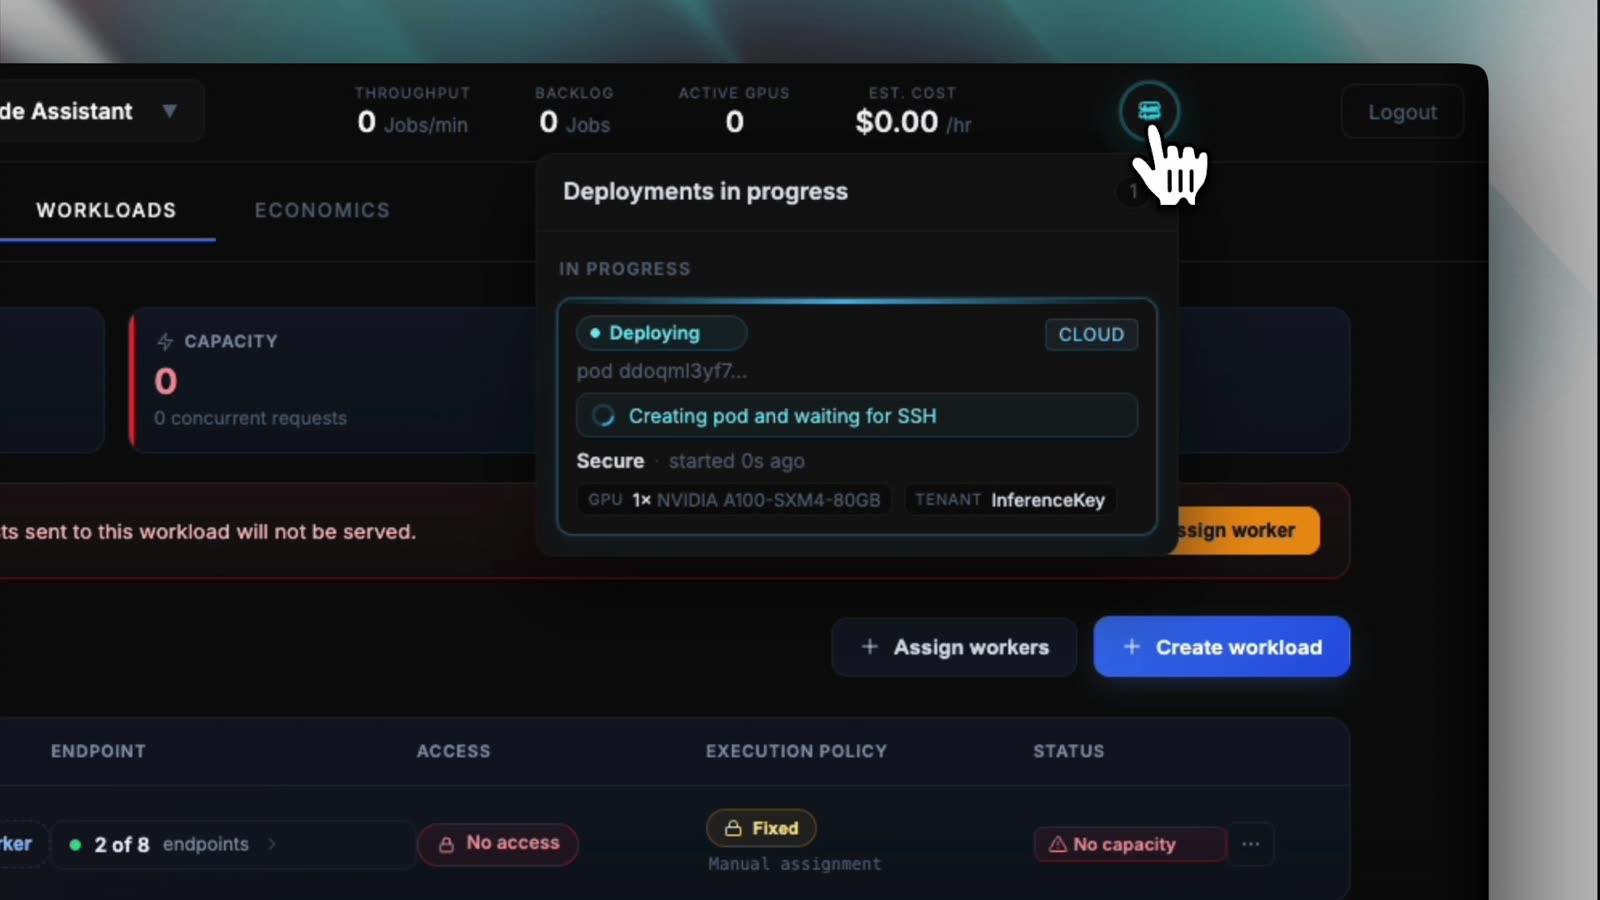
Ce que vous obtenez, ce sont les logs du worker diffusés en direct dans le panel : pip qui récupère les wheels CUDA et NVIDIA, puis l'EngineCore de vLLM qui charge les shards safetensors. C'est la balance, chaque élément qui se met en place avant que quiconque ne joue une note.
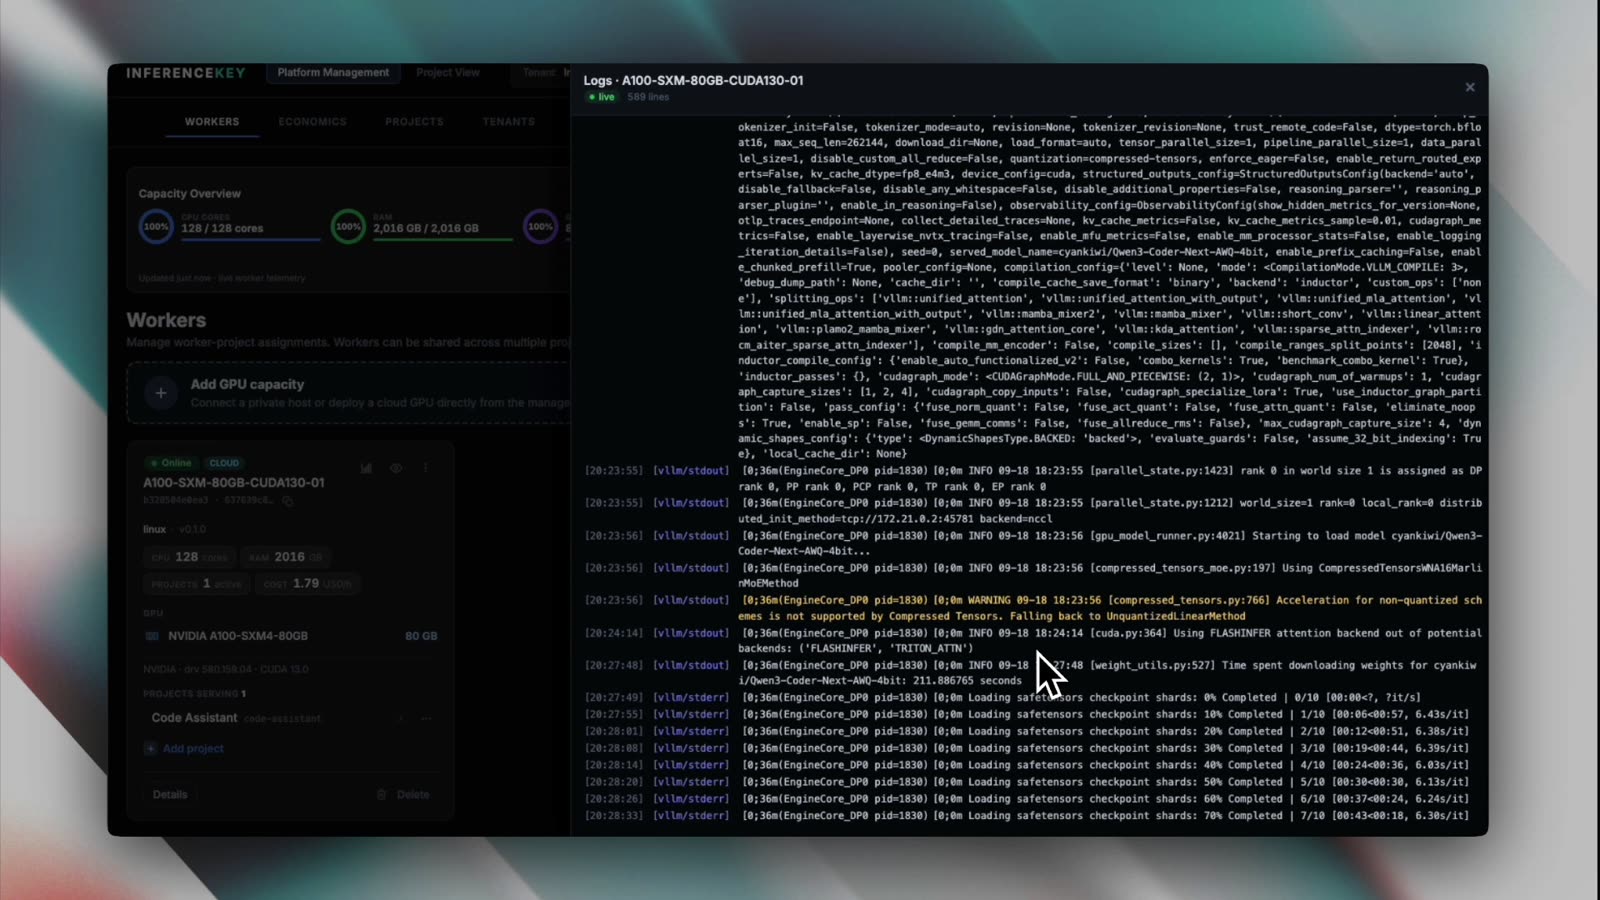
La vidéo est montée, donc je ne citerai pas de temps de déploiement. La machine louée s'est présentée ainsi : A100-SXM4-80GB, driver 580.159.04, CUDA 13.0, 128 cœurs CPU, 2016 Go de RAM, avec un health check du driver confirmant "vLLM 0.15.0 compatible with CUDA 13.0".
Étape 5 : une première requête
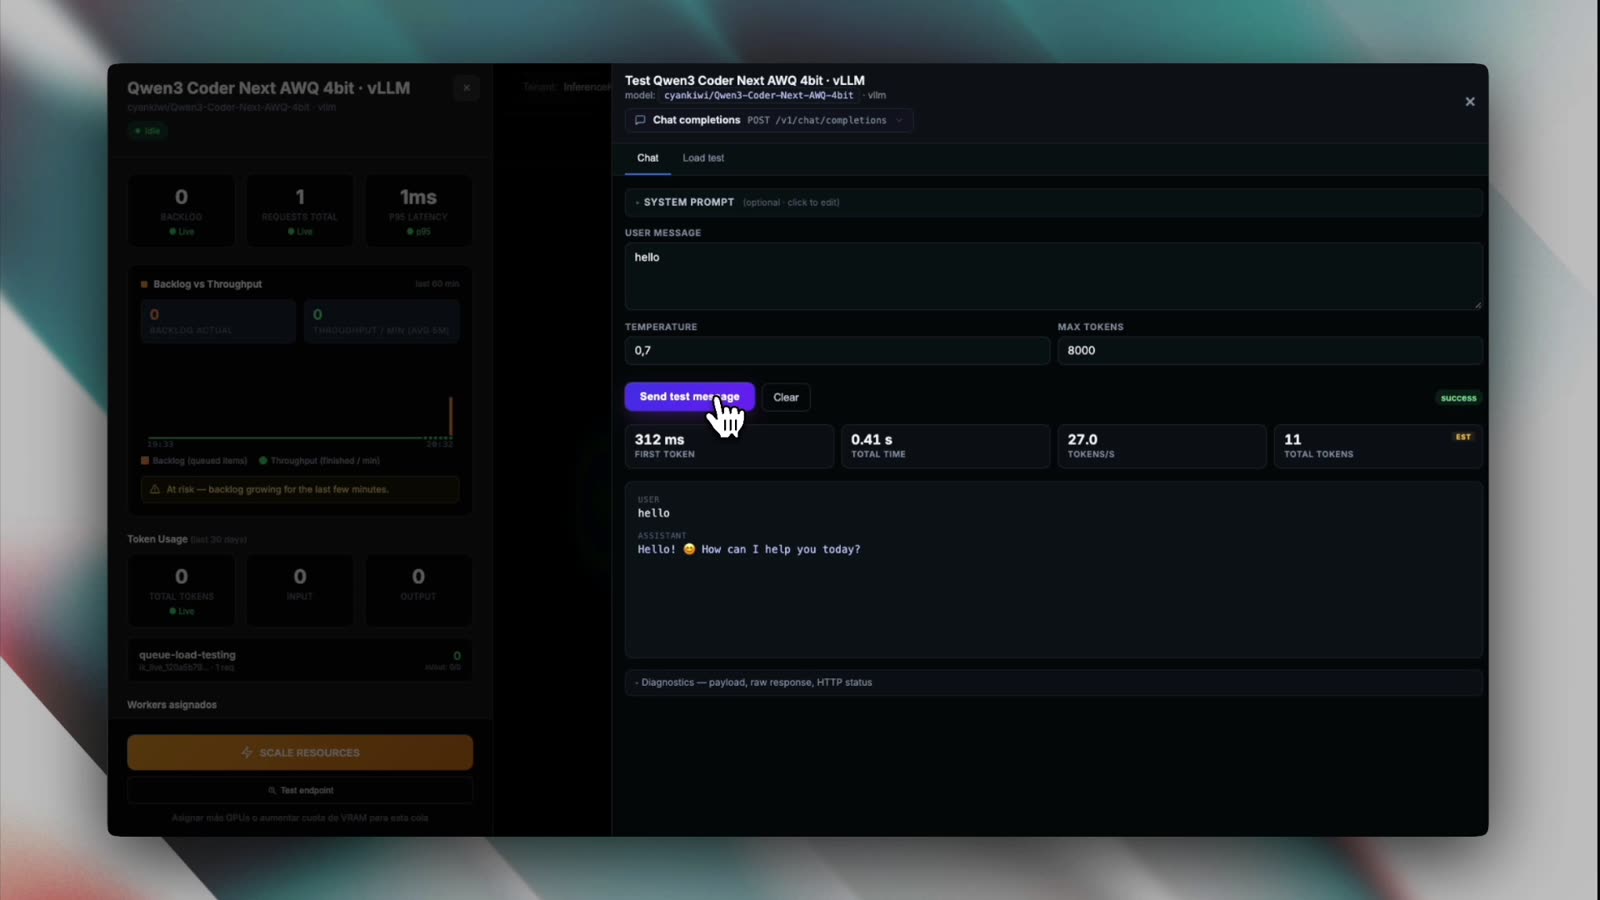
Le workload dispose d'un panel de test intégré. Nous avons envoyé hello (temperature 0.7, max tokens 8000) à /v1/chat/completions et reçu une salutation d'une ligne demandant comment il pouvait aider, avec :
| Métrique | Valeur |
|---|---|
| Premier token | 312 ms |
| Temps total | 0.41 s |
| Tokens au total | 11 (marqués EST) |
C'est un smoke test, pas un benchmark. Onze tokens de salutation vous disent que le modèle est chargé et que le chemin fonctionne ; ils ne disent rien de sérieux sur le débit de décodage. Le panel a aussi affiché 27.0 tokens/s, mais ce chiffre divise 11 tokens par un temps total composé surtout des 312 ms d'attente du premier token, donc nous l'écartons.
Pour un chiffre soutenu, notre propre worker RTX-A6000-48GB-CUDA130-01 (une RTX A6000, 48 Go, CUDA 13.0), qui sert des tâches de développement Claude Code avec un contexte de 1M tokens, génère environ 40 tokens/s.
Étape 6 : une clé d'API pour un développeur
Le développeur, Chad Coder, reçoit sa propre clé. Portée d'accès "Specific endpoints" (l'alternative est "Entire project"), et un seul endpoint coché : code-assistant/qwen3-coder-next-awq-4bit-vllm. La clé n'est affichée qu'une fois.
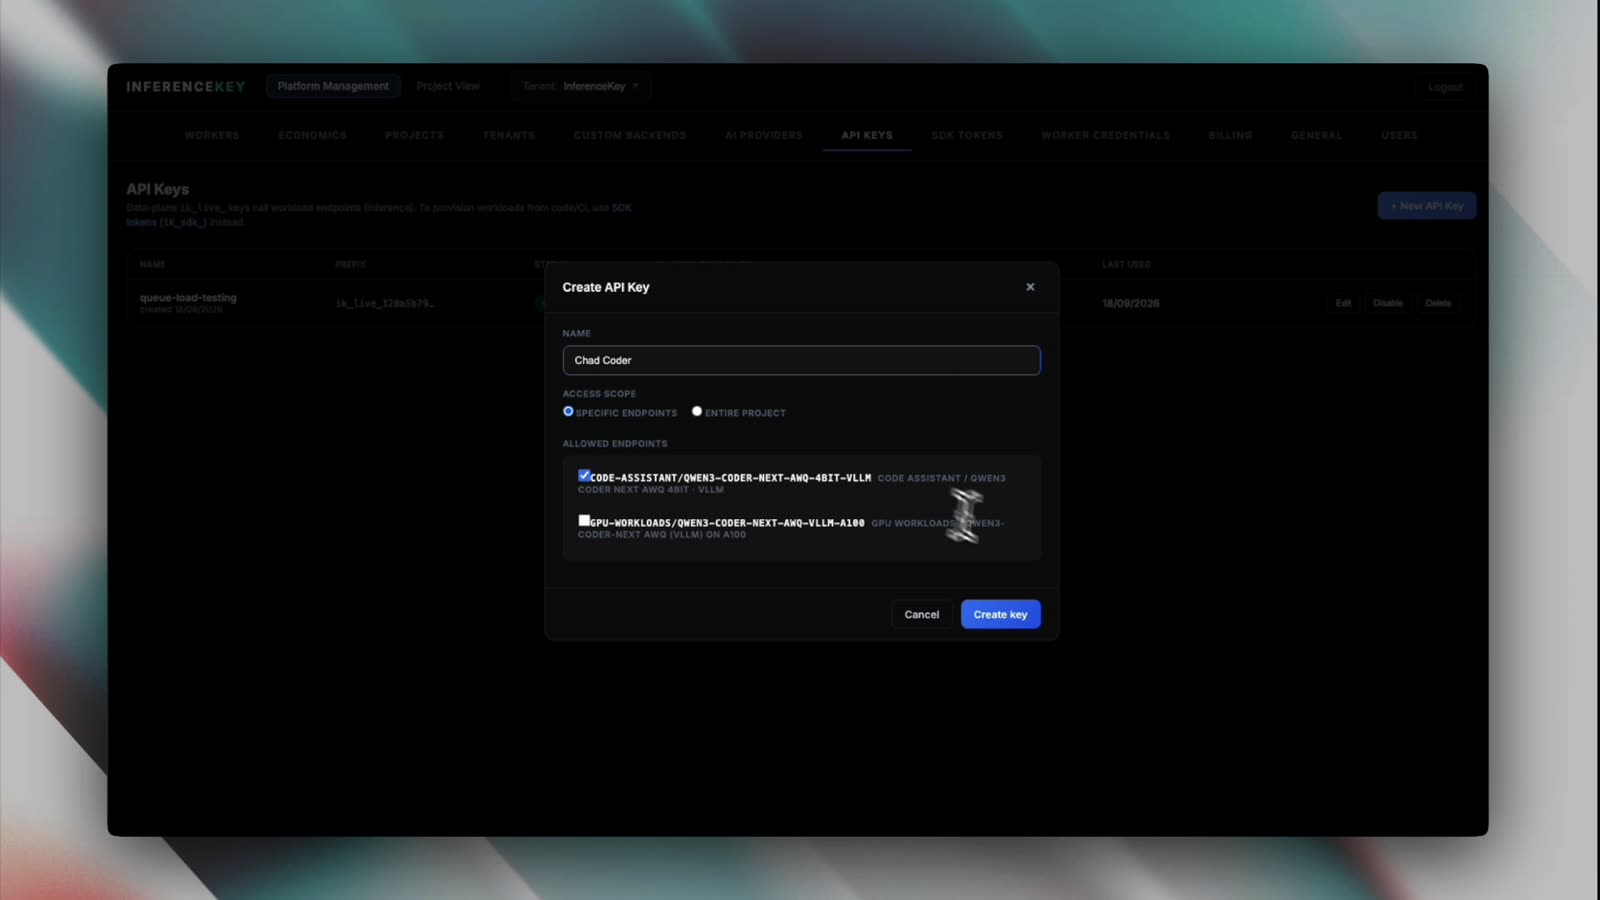
Ce que j'ai vérifié dans le code du manager : une clé ne passe que si ses endpoints autorisés contiennent <project>/<workload> ou <project>/*, sinon la requête est rejetée avec endpoint_forbidden, et le data plane n'accepte que les clés qui commencent par ik_live_. L'usage est suivi par clé ; vous verrez les tokens de Chad dans la vue en direct plus bas. La narration parle de quotas ; ce que j'ai réellement vérifié dans le code, c'est la restriction par endpoint et l'usage par clé.
Étape 7 : brancher Claude Code dessus
Le manager expose une route Messages de style Anthropic par workload, POST /endpoint/<project>/<workload>/v1/messages, à côté du /v1/chat/completions de style OpenAI. Claude Code ajoute lui-même /v1/messages, donc la base URL s'arrête au workload :
export ANTHROPIC_BASE_URL=https://api.inferencekey.com/endpoint/code-assistant/qwen3-coder-next-awq-4bit-vllm
export ANTHROPIC_AUTH_TOKEN=ik_live_...
export ANTHROPIC_MODEL=qwen3-coder-next-awq-4bit-vllm
export ANTHROPIC_DEFAULT_HAIKU_MODEL=qwen3-coder-next-awq-4bit-vllm
export ANTHROPIC_DEFAULT_SONNET_MODEL=qwen3-coder-next-awq-4bit-vllm
export ANTHROPIC_DEFAULT_OPUS_MODEL=qwen3-coder-next-awq-4bit-vllm
claude
api.inferencekey.com est l'hôte public par défaut ; copiez la base URL que montre votre panel. ANTHROPIC_AUTH_TOKEN part en Authorization: Bearer, ce que le manager préfère ; ANTHROPIC_API_KEY (envoyée en x-api-key) fonctionne aussi, mais elle prend le pas sur une connexion par abonnement et Claude Code en mode interactif vous demande une fois d'approuver la clé personnalisée (la documentation ne décrit cette demande que pour ANTHROPIC_API_KEY). Si les deux en-têtes arrivent avec des valeurs différentes, le manager rejette la requête avec un 401 authentication_error.
Maintenant, le piège. L'endpoint est lié à un workload, et le manager vérifie le nom du modèle. Il accepte l'absence de modèle, default, le slug du workload ou le nom du modèle du workload ; tout le reste reçoit un HTTP 400 avec le type d'erreur invalid_request_error et le message "Model '…' is not available on this endpoint" (en interne, le code est model_not_available). Claude Code envoie par défaut des noms de modèle claude-*, et utilise aussi un petit modèle pour les tâches de fond. Donc réglez ANTHROPIC_MODEL et ANTHROPIC_DEFAULT_HAIKU_MODEL sur le slug du workload, sinon votre premier prompt rebondit. Tout ce qui choisit l'alias sonnet ou opus (le sélecteur /model, opusplan) enverrait encore des noms claude-*, c'est pourquoi le bloc ci-dessus pointe aussi ANTHROPIC_DEFAULT_SONNET_MODEL et ANTHROPIC_DEFAULT_OPUS_MODEL vers le slug.
Étape 8 : le regarder travailler
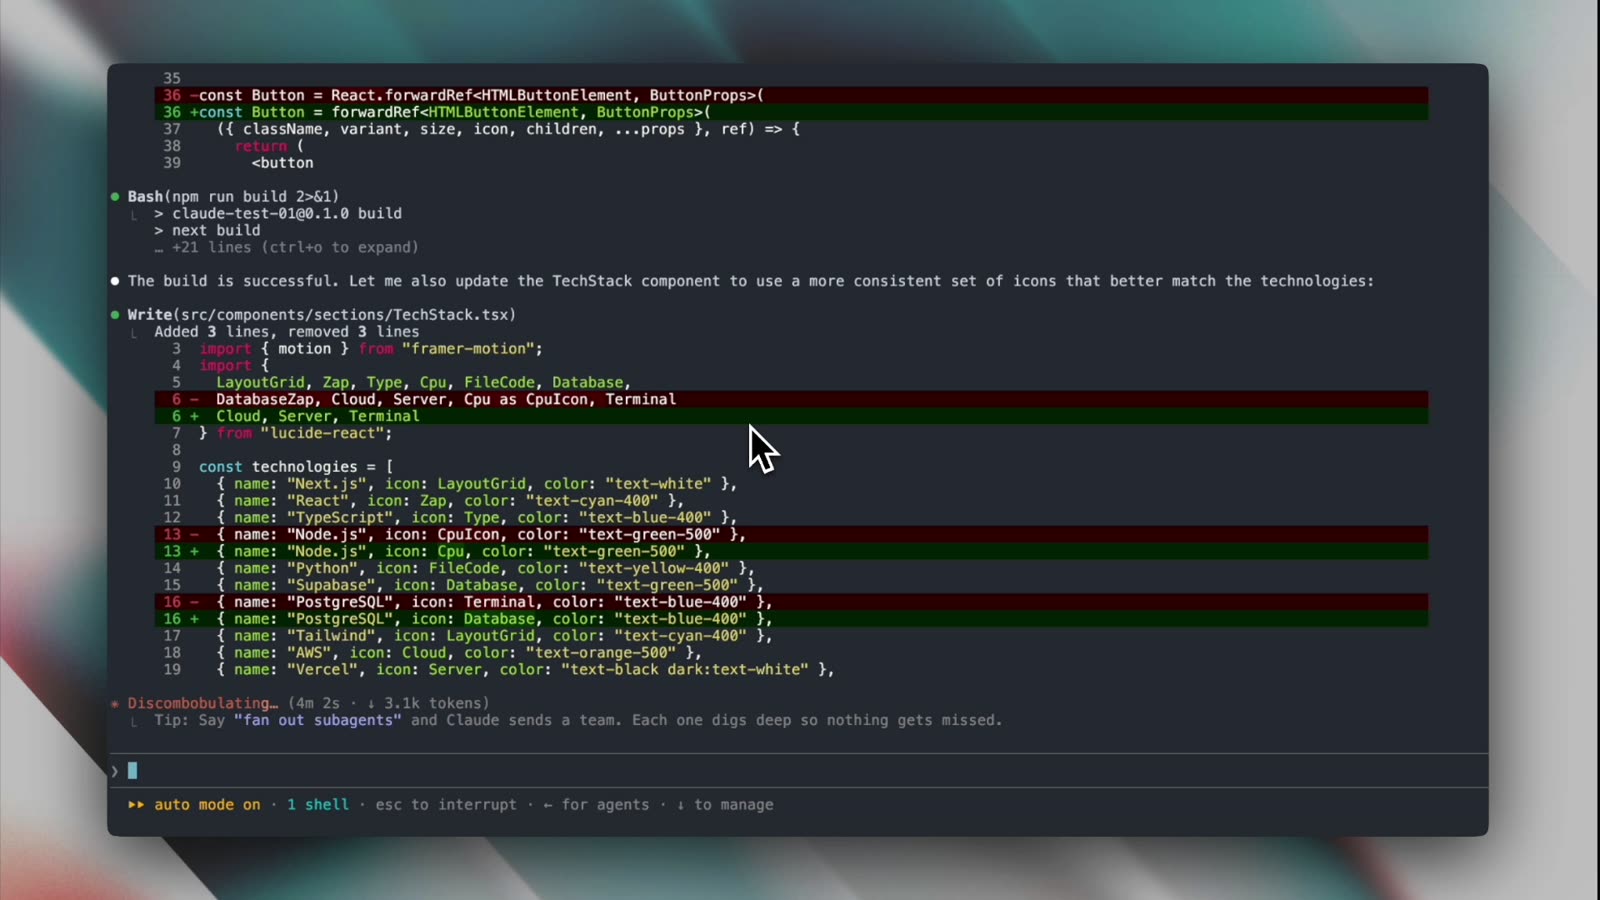
Chad a demandé une landing page pour "Chad Coder" : une liste de composants React (Navbar, Hero, Services, Projects, Testimonial, TechStack, CTA et d'autres) et la consigne qu'elle "should feel like a $20k-$50k custom agency website, not a generic Tailwind template". Claude Code est passé en plan mode, a écrit src/components/ui/Button.tsx, installé class-variance-authority, clsx et tailwind-merge, lancé npm run build et a continué à modifier les composants.
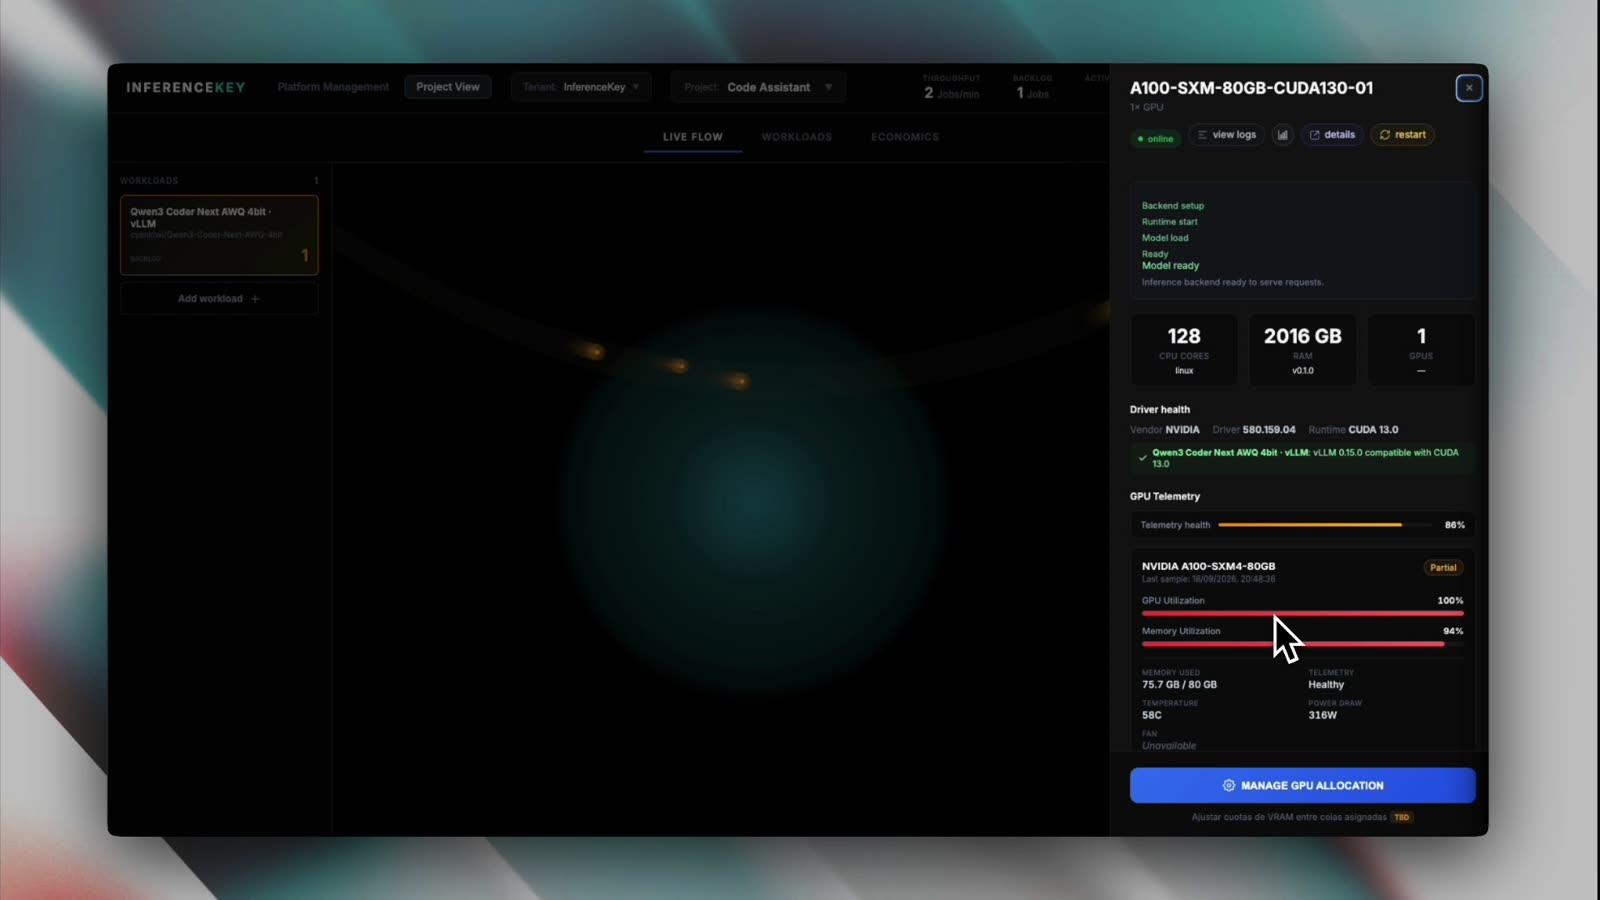
Pendant ce temps, le Live Flow du projet montre les requêtes qui voyagent vers le GPU, avec dans l'en-tête 2 jobs/min, 1 en backlog, 1 GPU actif, $1.79/hr. À ce moment de la session, au milieu du build, le panneau du workload comptait 5 requêtes et 31.7K tokens, et la ventilation par clé attribuait 4 requêtes et la totalité des 31.7K tokens à la clé de Chad. C'est un instantané, pas le coût complet de la landing page. Le panneau du worker est l'endroit où le GPU dit la vérité : 100 % d'utilisation, 75.7 Go utilisés sur 80 Go, 58 C, 316 W.
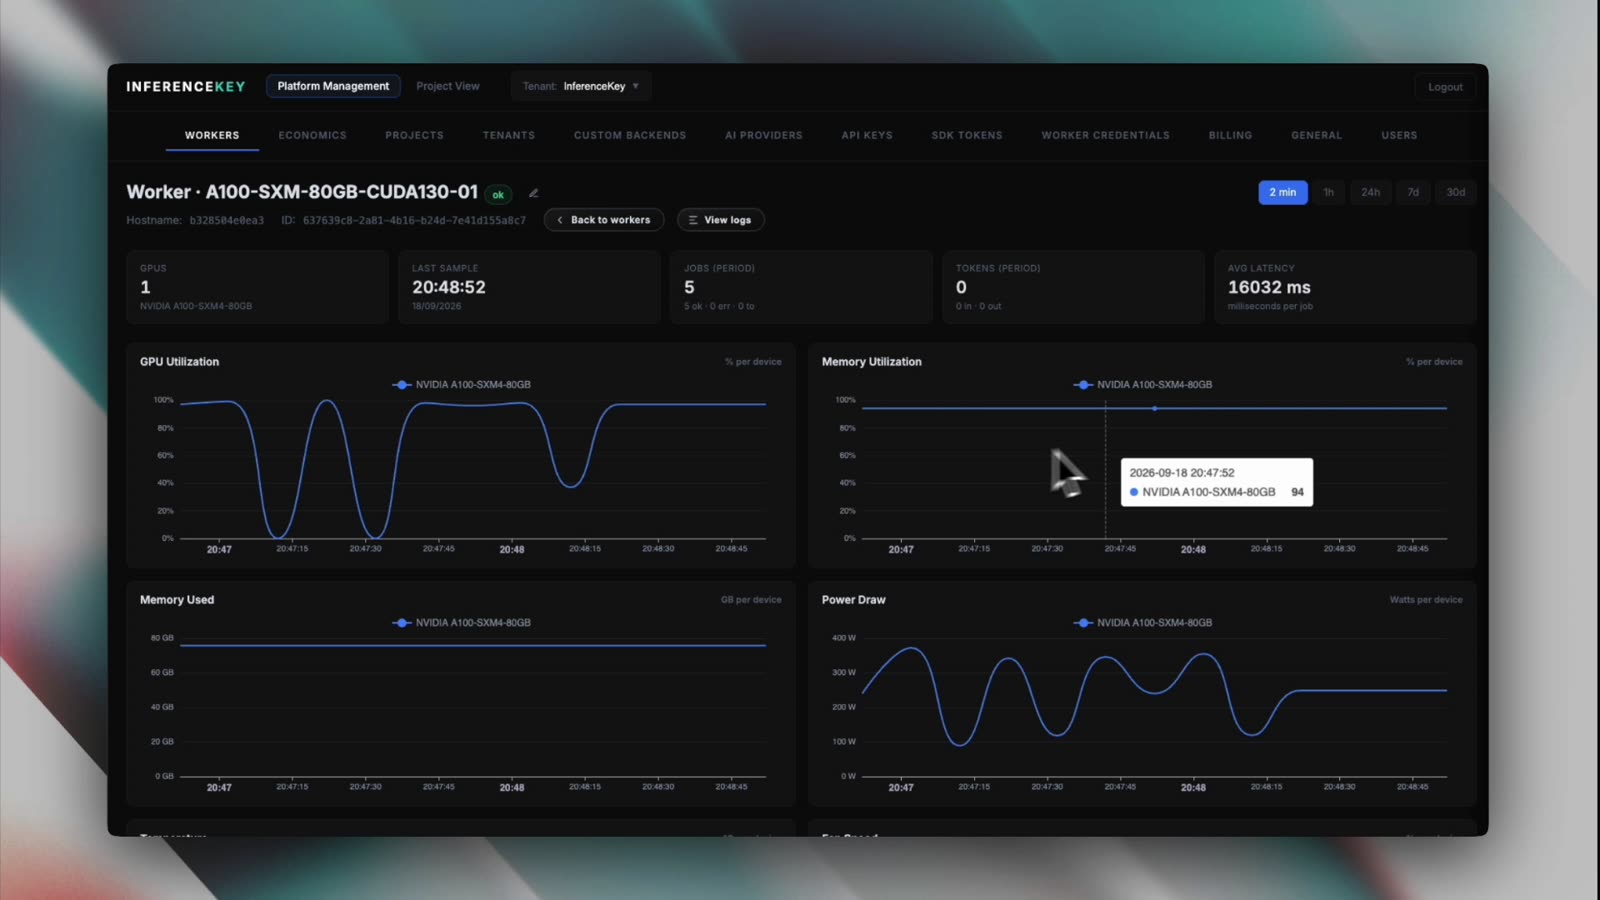
La page du worker conserve les graphiques des deux dernières minutes : mémoire utilisée stable autour de 76 Go, puissance qui culmine près de 380 W, 5 jobs ok, 0 erreur et 16032 ms de latence moyenne par job sur cette fenêtre. Ces jobs sont des étapes d'agent Claude Code, donc lisez la moyenne comme un ordre de grandeur, pas comme un benchmark de latence.
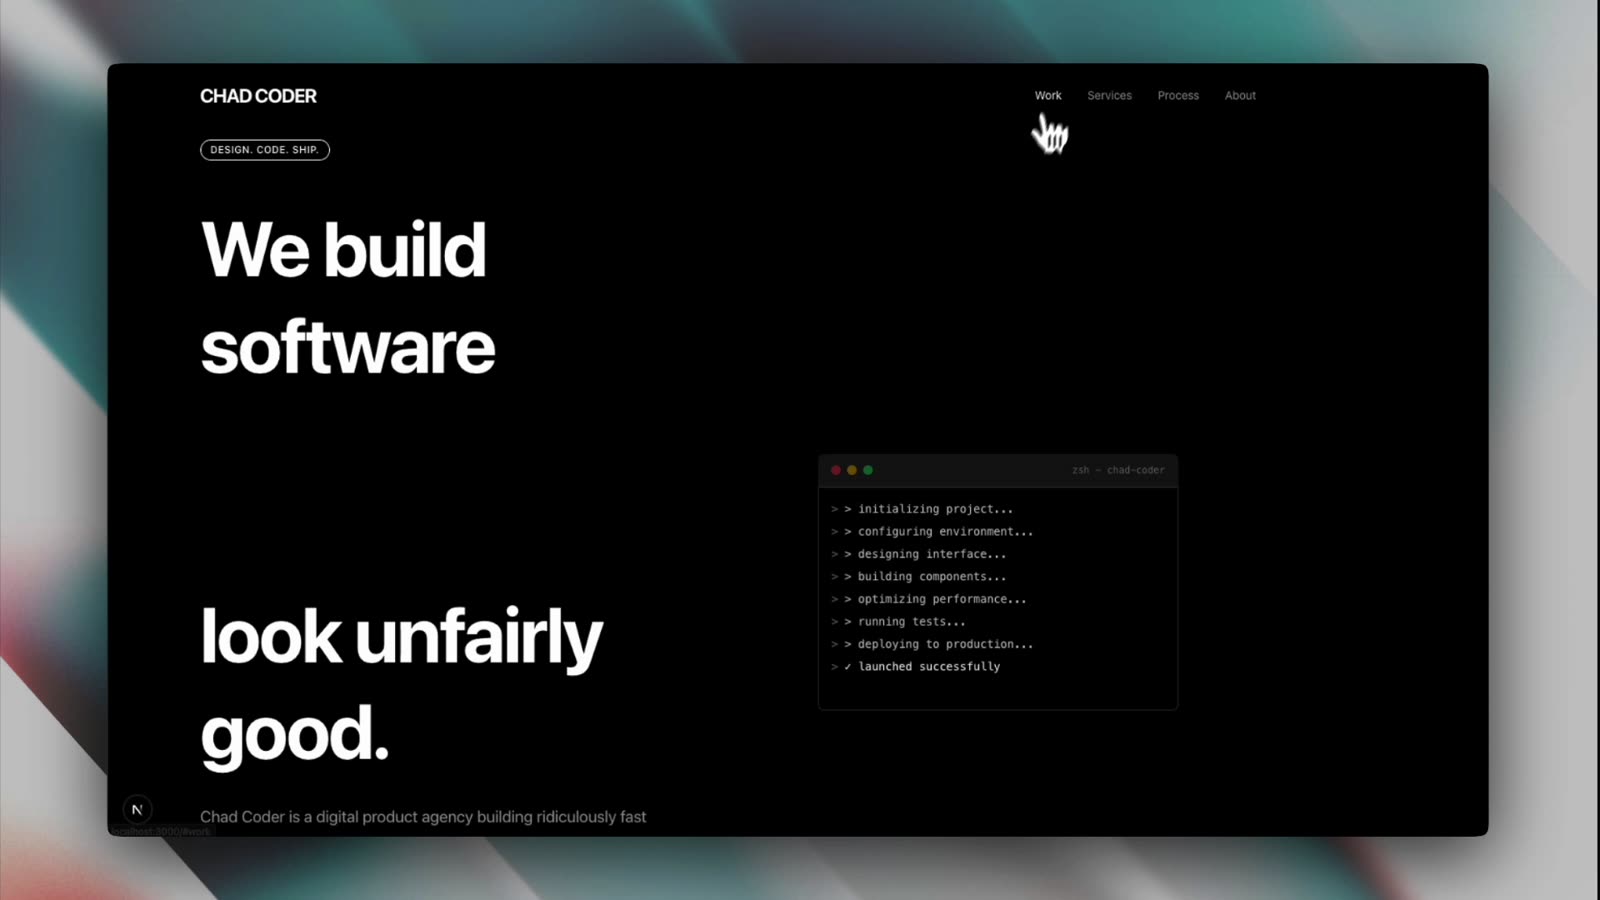
Et le résultat : une landing page sombre avec un en-tête "CHAD CODER" et le titre "We build software look unfairly good." Oui, le hero a un trou là où devrait se trouver un mot, très probablement un emplacement de mot qui ne s'est pas affiché. La section projets contient des cartes de remplissage. C'est un premier jet d'agent, pas un site livré.
Ce que cela prouve, et ce que cela ne prouve pas
Les limites d'abord :
- Échelle. Un GPU, un développeur,
--max-num-seqs 2. - Qualité. Un modèle quantifié en 4 bits, donc attendez-vous à une certaine perte de qualité par rapport aux poids en pleine précision. Nous n'avons pas mesuré de combien.
- La tâche. Une landing page n'est pas un benchmark de code difficile : pas de gros dépôt legacy, pas de refactoring retors, pas de suite d'évaluation.
- Les chiffres. Pour l'A100, nous n'avons qu'une salutation de 11 tokens, donc sa vitesse n'est pas mesurée ici ; le chiffre de 40 tokens/s vient d'une autre carte (RTX A6000) et d'une autre configuration. Le contexte de 256K est configuré, pas exercé : l'instantané d'usage pris au milieu de la session montrait 31.7K tokens d'entrée.
- Coût. Nous n'avons pas comparé cette session à une tarification au token. Avec un développeur et deux séquences en vol, ce n'est pas la configuration où payer à l'heure devient rentable ; il faut pour cela plusieurs développeurs ou agents qui partagent le GPU.
- L'agent. C'est Claude Code qui pilote Qwen, pas Claude. Claude Code est conçu autour des modèles Claude. Avec une base URL qui n'est pas first-party, sa recherche d'outils MCP est désactivée par défaut, et le comportement de l'agent dépend de la manière dont le modèle suit le protocole d'outils de Claude Code. Nous ne l'avons pas comparé à Claude hébergé sur la même tâche.
- Confidentialité. Les requêtes traversent toujours l'endpoint InferenceKey et un hôte cloud loué.
- Multi-GPU. La narration dit qu'on peut ajouter des GPU et répartir les requêtes entre eux. Ce n'est pas montré dans cette vidéo et je ne l'ai pas testé ici.
Ce que cela montre : un modèle de code MoE de 80B configuré pour son contexte complet de 256K, qui sert une vraie session Claude Code, appels d'outils compris, sur une seule A100 à $1.79/h. Aucune session SSH, aucun environnement monté à la main, une clé limitée à un endpoint, une comptabilité des tokens par clé et une télémétrie GPU lisible pendant que l'agent travaille. C'est le genre de configuration ennuyeuse, et c'est un compliment.
Prochain morceau de la setlist : plus de GPU derrière le même endpoint, et une charge de travail de code plus lourde qu'une landing page.
Le guide pas à pas se trouve dans la documentation : Deploy your own code assistant.