Un modelo de código de 80B en una A100 alquilada, manejado por Claude Code
Qwen3 Coder Next (80B, AWQ 4-bit) en vLLM, una A100 80 GB a $1.79/h, una API key para un desarrollador y Claude Code apuntando a ella. Comandos y límites.
Un modelo de código de 80.000 millones de parámetros. Una NVIDIA A100 SXM de 80 GB alquilada. $1.79 la hora en el catálogo el día que grabamos. Un desarrollador escribiendo en Claude Code, con las respuestas de un modelo que elegimos nosotros, en una GPU dedicada a nuestro proyecto.
Eso es todo el vídeo (3:29). Este post es la versión larga: el comando exacto, las variables de entorno, la trampa que te va a morder en la primera petición y lo que la demo no demuestra.
Por qué molestarse en tener tu propia inferencia
Buena parte de mi código pasa ahora por un agente de código, y los agentes hablan mucho. Una sola sesión envía tu repo, tus prompts y tus ideas a medio hacer a la API de modelos de otro, token a token, facturado por token.
Tener tu propia inferencia le da la vuelta a varias cosas:
- Privacidad. El modelo corre en una GPU dedicada a tu proyecto y ningún proveedor de modelos ve tus prompts ni tu código. Quién sigue en medio: las peticiones pasan por el endpoint de InferenceKey y, en esta demo, la GPU es un pod en una secure cloud de un tercero. La confianza se desplaza, no desaparece. Conectar tu propio servidor como worker saca de la ecuación al casero de la GPU.
- Forma del coste. Pagas por hora de GPU, no por token. Un agente que relee los mismos ficheros cincuenta veces no dispara una factura por token; simplemente mantiene ocupada una GPU que ya estás pagando. La otra cara: el taxímetro corre tanto si alguien escribe como si no. $1.79/h encendida 24/7 son unos $1,300 al mes. El precio por hora gana con carga sostenida, un agente machacando el endpoint todo el día; el precio por token gana cuando la GPU se quedaría parada toda la noche.
- Control. Eliges el modelo, la cuantización, la longitud de contexto, el parser de tools. Nadie te retira el modelo un martes cualquiera.
Creo que los modelos de código open weights ya son lo bastante buenos para llevar una sesión de Claude Code a través de un plan, un build y una ronda de ediciones, que es lo que enseña el vídeo. Hasta dónde llega eso con trabajo más difícil sigue abierto. La otra cuestión es la fontanería: meter un modelo grande en una GPU y exponérselo de forma segura a un desarrollador sin pasarte el día en SSH. Eso es lo que probamos.
El modelo
cyankiwi/Qwen3-Coder-Next-AWQ-4bit, una cuantización AWQ de 4 bits de Qwen3 Coder Next. Según la model card: 80B parámetros en total, 3B activos por token (Mixture of Experts, 512 expertos, 10 activos), 262,144 tokens de contexto nativo, Apache 2.0. Dos cosas distintas hacen que quepa en una sola tarjeta. La cuantización a 4 bits hace que entre: 80B pesos a unos 4 bits son aproximadamente 40 GB más overhead, lo que deja sitio en 80 GB para la KV cache. El diseño MoE hace que sea rápido: los 80B pesos se quedan en memoria, pero cada token solo calcula con unos 3B de ellos.
Paso 1: un proyecto
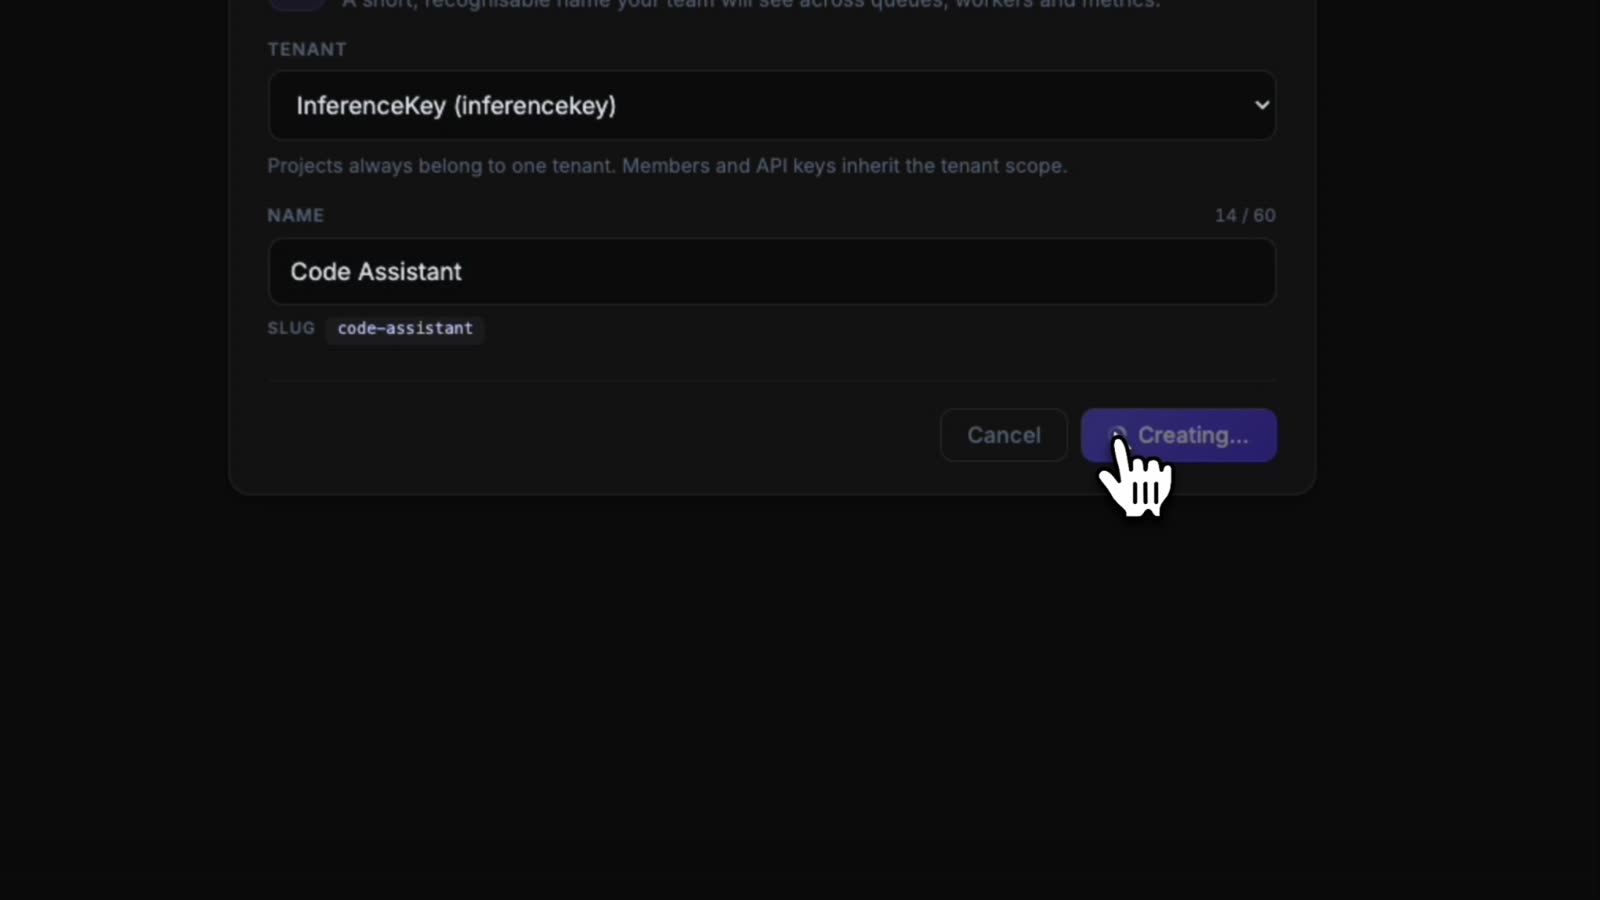
Un proyecto es una carpeta para workloads, keys y costes. El nuestro se llama Code Assistant, slug code-assistant. Apúntate el slug, acaba en la URL.
Paso 2: un workload con el comando exacto de vLLM
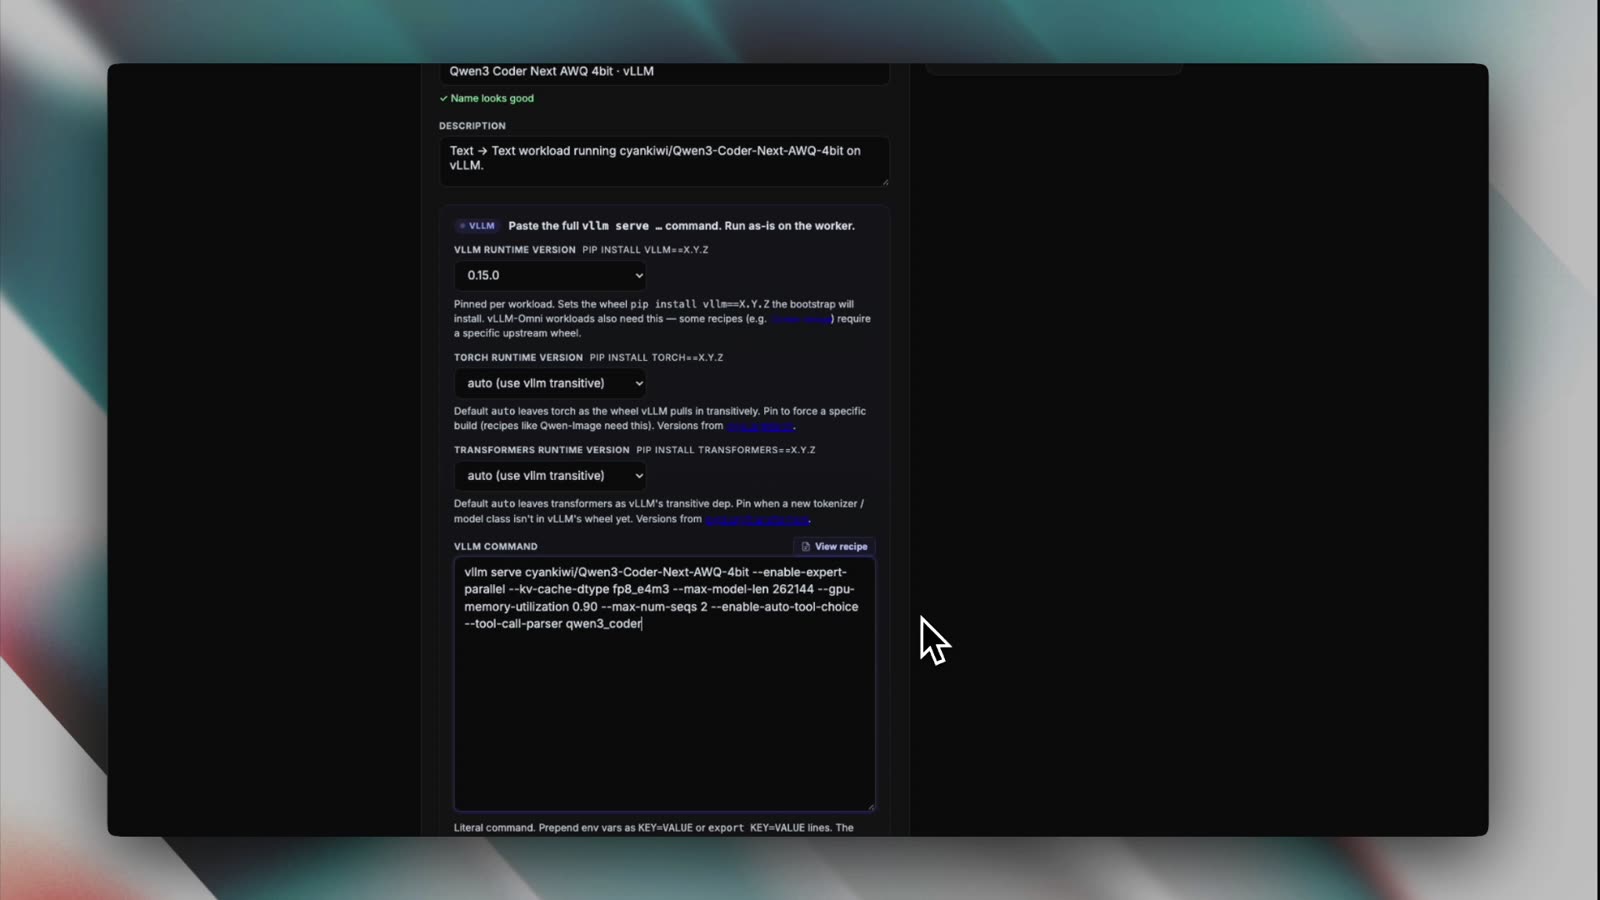
Crea un workload y elige un backend. El desplegable ofrece vLLM, vLLM-Omni, SGLang, Ollama, llama.cpp (GGUF), stable-diffusion.cpp y un API Gateway para proveedores externos. Elegimos vLLM, fijamos el runtime en 0.15.0 y dejamos torch y transformers en "auto (use vllm transitive)".
El campo de comando es literal: el worker lo ejecuta tal cual. Esto es lo que pegamos:
vllm serve cyankiwi/Qwen3-Coder-Next-AWQ-4bit \
  --enable-expert-parallel \
  --kv-cache-dtype fp8_e4m3 \
  --max-model-len 262144 \
  --gpu-memory-utilization 0.90 \
  --max-num-seqs 2 \
  --enable-auto-tool-choice \
  --tool-call-parser qwen3_coder
Qué hacen los flags:
--max-model-len 262144: el contexto nativo completo del modelo, 256K tokens. Los agentes de código leen muchos ficheros.--kv-cache-dtype fp8_e4m3: guarda la KV cache en FP8 para que ese contexto quepa junto a los pesos.--gpu-memory-utilization 0.90: vLLM puede ocupar el 90% de los 80 GB.--max-num-seqs 2: como mucho dos secuencias en vuelo. Es un montaje para un solo desarrollador y el número lo dice.--enable-auto-tool-choice --tool-call-parser qwen3_coder: tool calls. Claude Code envía definiciones de tools en sus peticiones; sin estos dos flags, vLLM responde con un 400 a las peticiones que llevan tools. El comando recomendado en la propia model card usa la misma pareja.--enable-expert-parallel: estaba en el comando que usamos. No probamos su efecto en una sola GPU.
Merece la pena conocer el texto de ayuda bajo el campo: puedes anteponer variables de entorno como líneas KEY=VALUE, el worker fuerza --port 8000 para sus health checks, y cualquier ruta de --chat-template tiene que estar bajo /opt/inferencekey/vllm/examples/.
Paso 3: todavía sin hardware, así que alquilamos una A100
En este punto el workload existe y nada lo ejecuta: sin worker asignado, estado "No capacity". Aquí puedes conectar tu propio servidor. Para la demo abrimos "Add worker to workload", pestaña "Deploy new cloud GPU": 1 GPU por nodo, driver CUDA 13.0, modelo de GPU A100 SXM · 80GB · $1.79/h, Secure cloud.
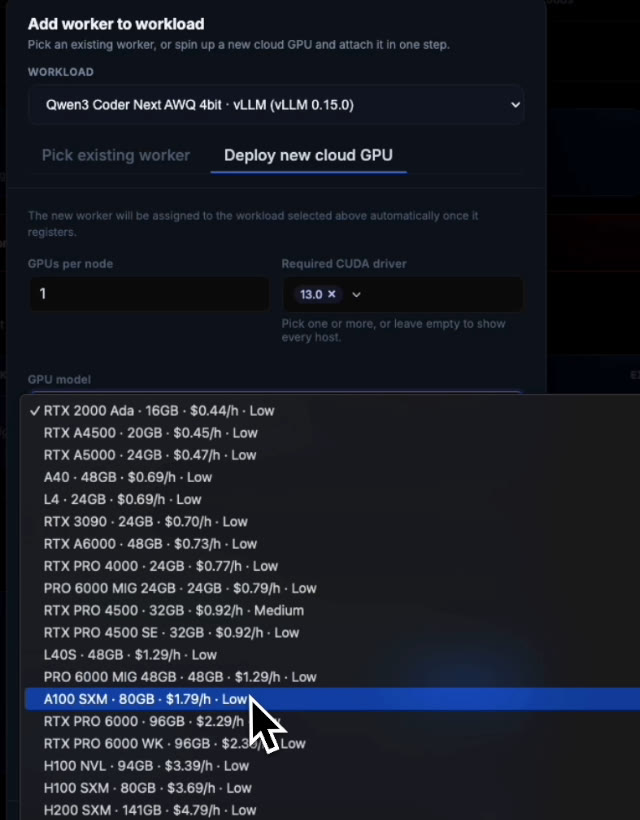
Como referencia, ese día el mismo desplegable listaba una L40S 48 GB a $1.29/h, una H100 SXM 80 GB a $3.69/h y una H200 SXM 141 GB a $4.79/h.
Una nota sobre el precio, porque el vídeo se equivoca. La narración dice que puedes alquilar esta clase de GPU por "poco más de un euro la hora". Todas las pantallas de la grabación dicen $1.79/h para la A100 SXM 80 GB en secure cloud: el catálogo, la tarjeta del worker ("COST 1.79 USD/h") y la cabecera del proyecto ("EST. COST $1.79/hr"). Fíate de las pantallas. Ese es el precio de catálogo del 18 de septiembre de 2026, el día de la grabación, y los precios de GPU en la nube se mueven, así que mira el desplegable antes de planificar un presupuesto en torno a él. Desde entonces el panel ha pasado a mostrar los precios en euros, así que espera ver ahí otra cifra y otra moneda.
Paso 4: el despliegue, sin las partes que suelo odiar
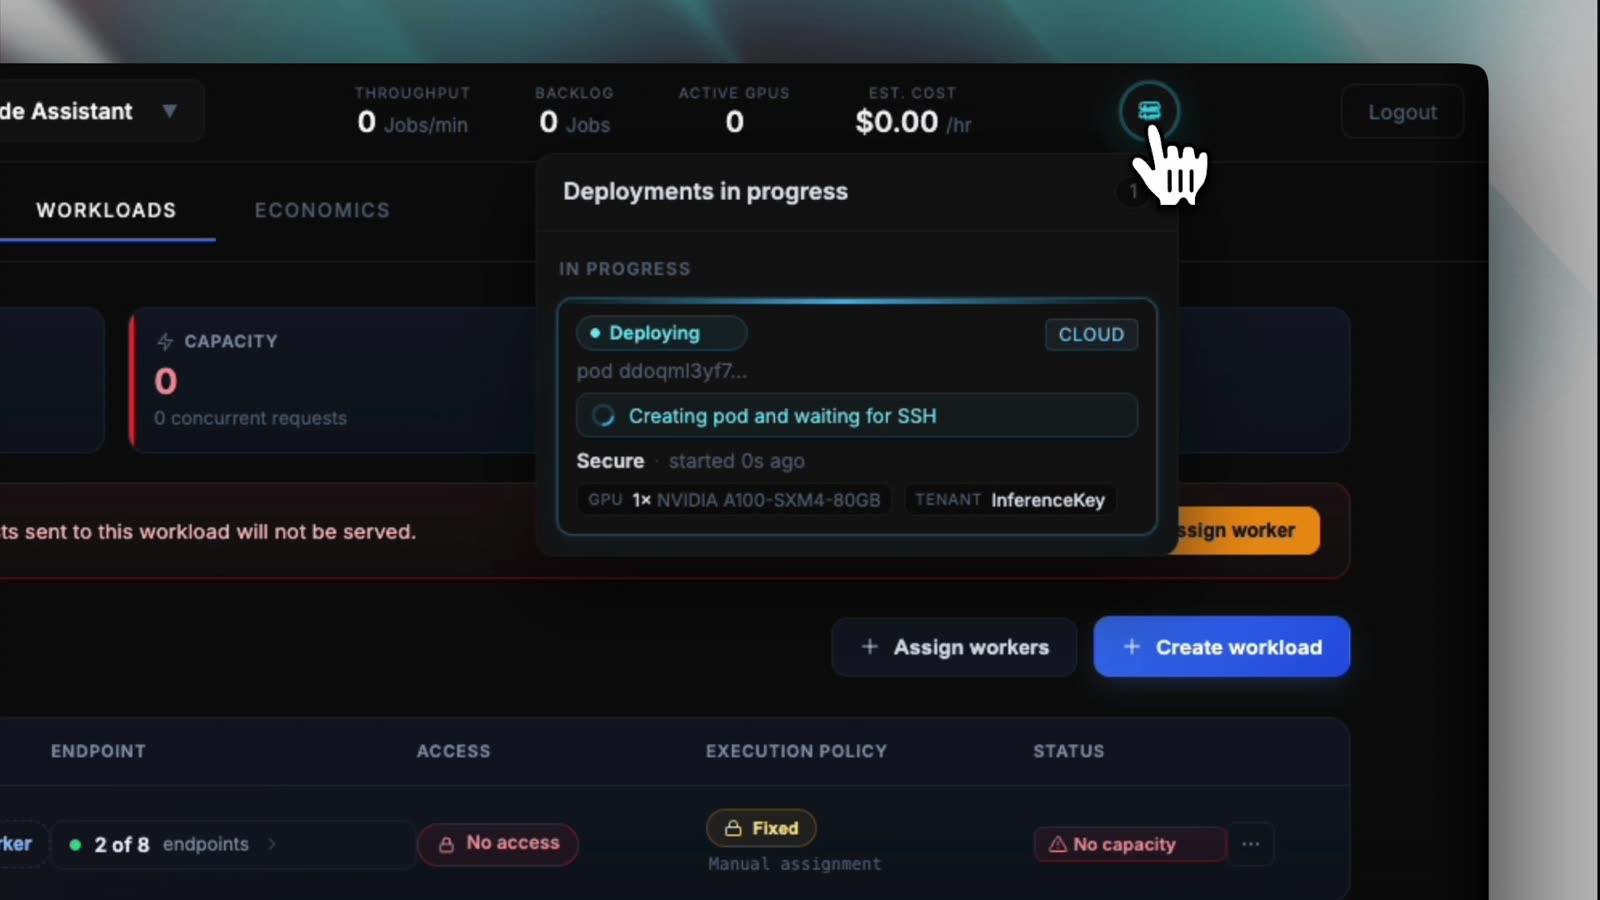
Pulsa deploy y un popup "Deployments in progress" lo va siguiendo: secure cloud, 1x NVIDIA A100-SXM4-80GB, "Creating pod and waiting for SSH". Sobre esa frase de "sin SSH" de la narración: la plataforma sí usa SSH para arrancar el pod. Tú simplemente nunca abres una sesión, nunca instalas paquetes de CUDA, nunca configuras el entorno.
Lo que sí obtienes son los logs del worker en el panel, en directo: pip bajando los wheels de CUDA y NVIDIA, y luego el EngineCore de vLLM cargando los shards de safetensors: la prueba de sonido, cada pieza arrancando antes de que nadie toque una nota.
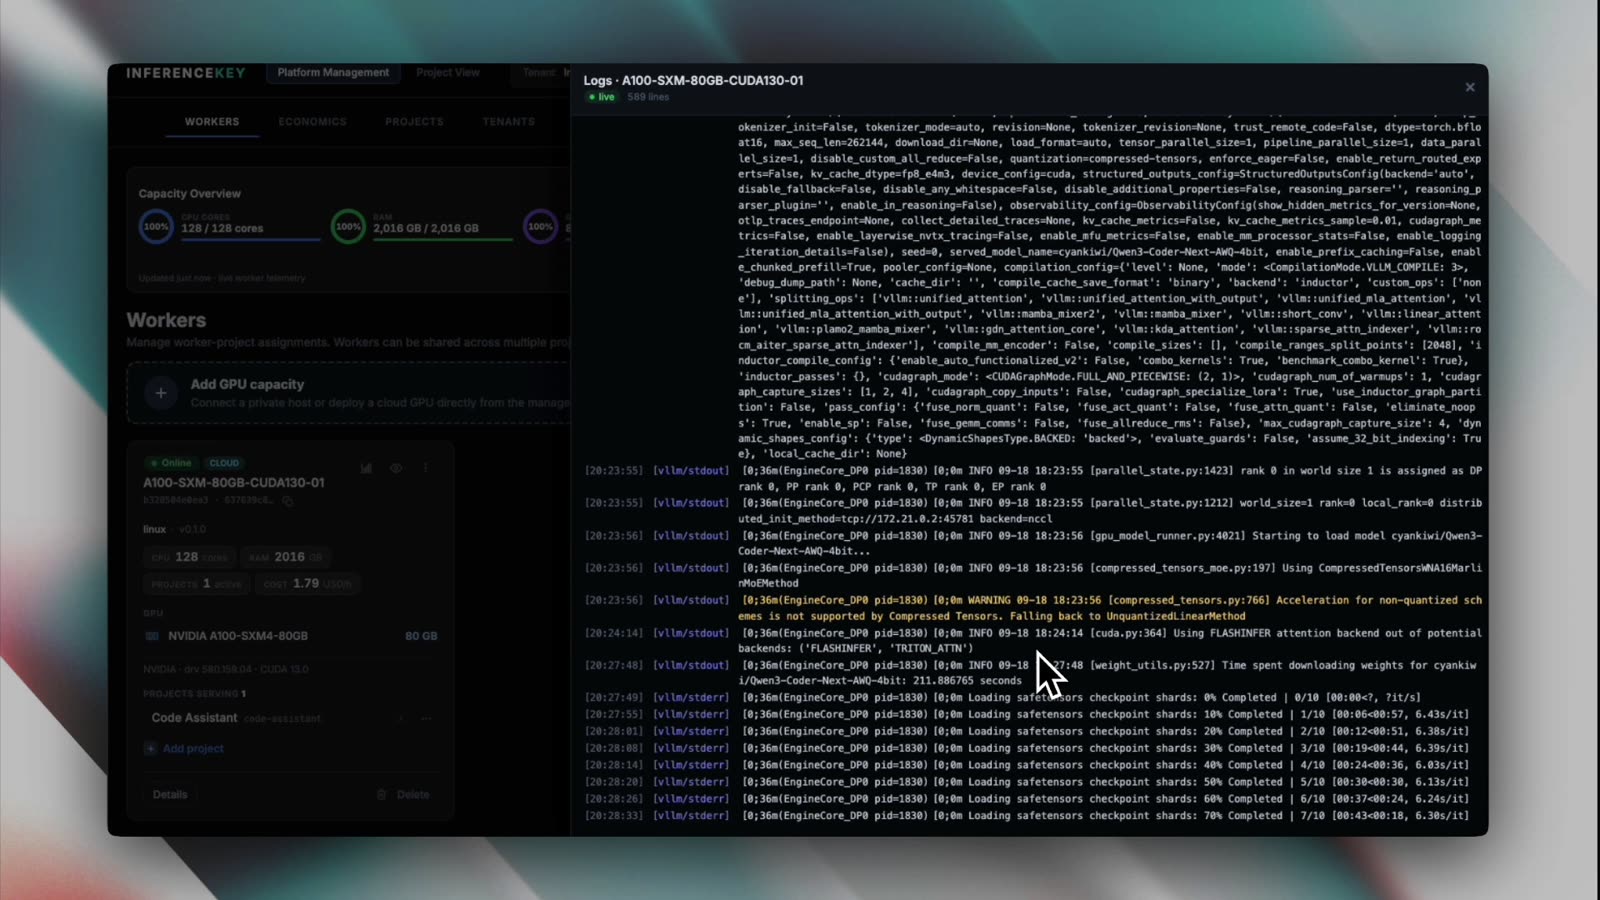
El vídeo está editado, así que no voy a dar un tiempo de despliegue. La máquina alquilada quedó así: A100-SXM4-80GB, driver 580.159.04, CUDA 13.0, 128 cores de CPU, 2016 GB de RAM, con un health check del driver confirmando "vLLM 0.15.0 compatible with CUDA 13.0".
Paso 5: una primera petición
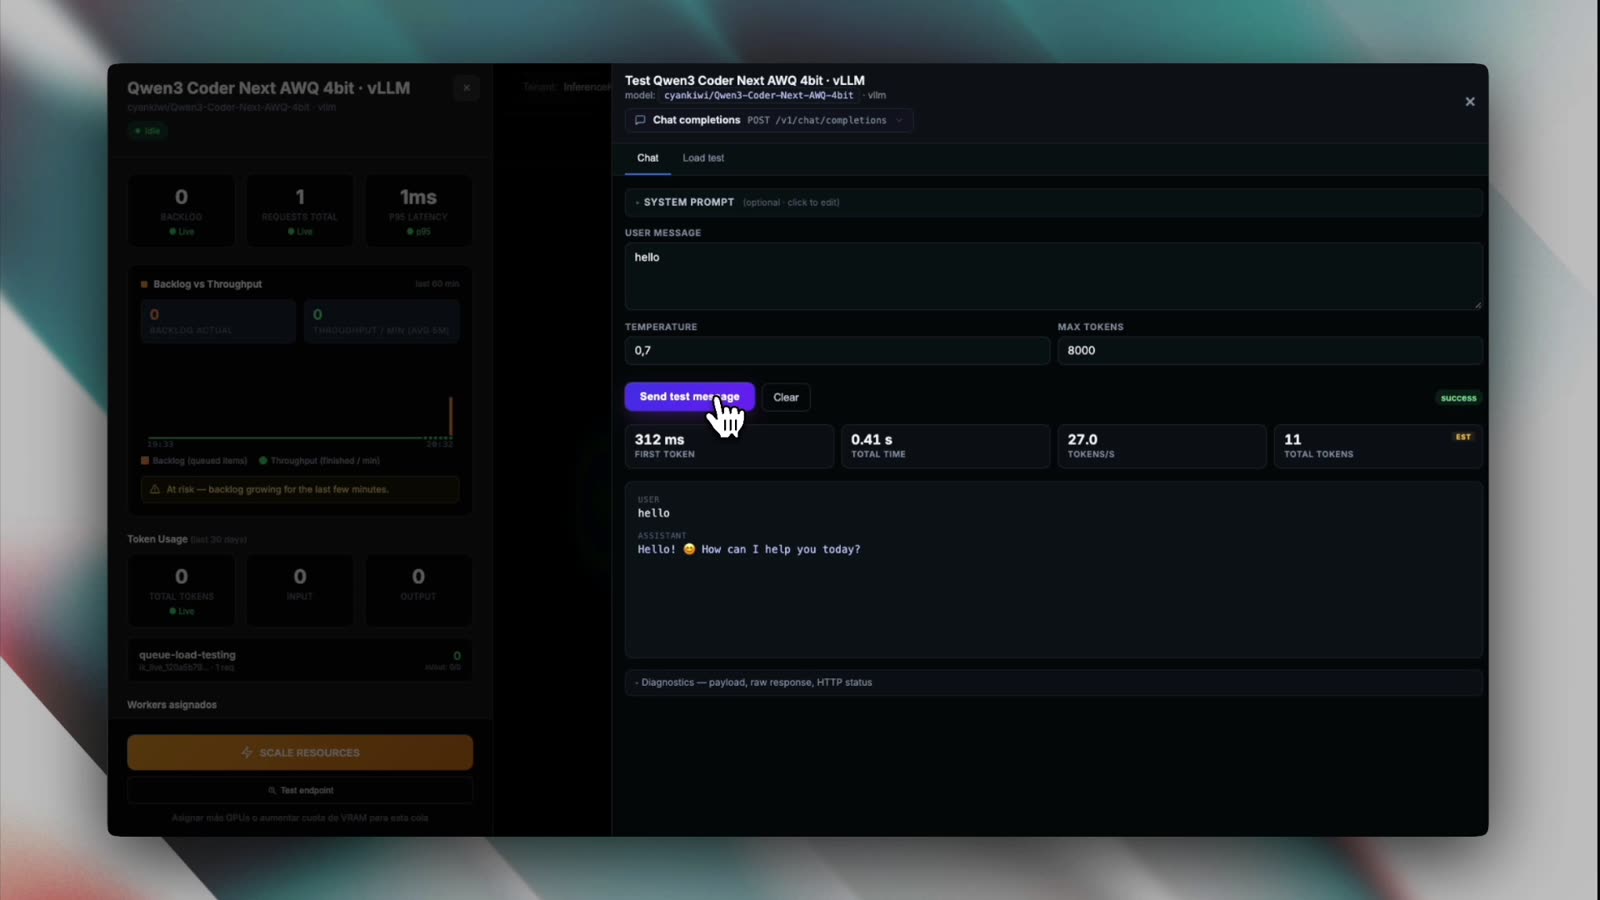
El workload tiene un panel de pruebas integrado. Enviamos hello (temperature 0.7, max tokens 8000) a /v1/chat/completions y recibimos un saludo de una línea preguntando en qué podía ayudar, con:
| Métrica | Valor |
|---|---|
| Primer token | 312 ms |
| Tiempo total | 0.41 s |
| Tokens totales | 11 (marcados EST) |
Eso es un smoke test, no un benchmark. Once tokens de saludo te dicen que el modelo está cargado y que el camino funciona; no te dicen nada serio sobre el throughput de decode. El panel también mostró 27.0 tokens/s, pero eso divide 11 tokens entre un tiempo total que es casi todo la espera de 312 ms del primer token, así que lo dejamos fuera.
Para una cifra sostenida, nuestro propio worker RTX-A6000-48GB-CUDA130-01 (una RTX A6000, 48 GB, CUDA 13.0), sirviendo tareas de desarrollo de Claude Code con un contexto de 1M tokens, genera unos 40 tokens/s.
Paso 6: una API key para un desarrollador
El desarrollador, Chad Coder, recibe su propia key. Alcance de acceso "Specific endpoints" (la alternativa es "Entire project") y un único endpoint marcado: code-assistant/qwen3-coder-next-awq-4bit-vllm. La key se muestra una sola vez.
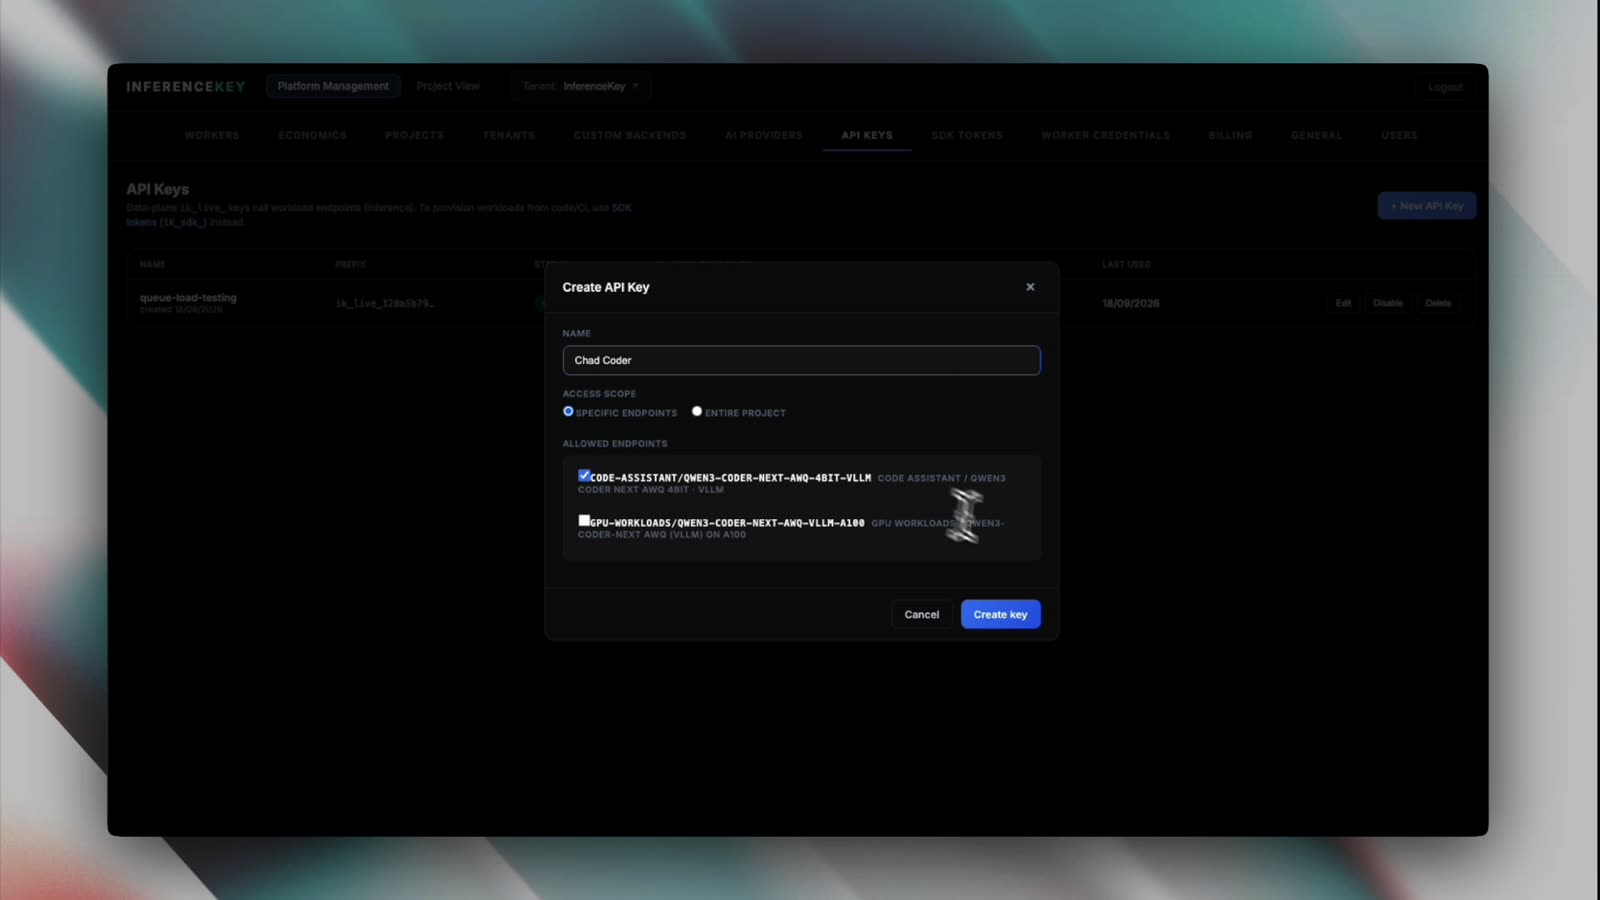
Lo que comprobé en el código del manager: una key solo pasa si sus endpoints permitidos contienen <project>/<workload> o <project>/*; si no, la petición se rechaza como endpoint_forbidden, y el data plane solo acepta keys que empiezan por ik_live_. El uso se registra por key; verás los tokens de Chad en la vista en directo más abajo. La narración habla de cuotas; lo que realmente verifiqué en el código es la restricción por endpoint y el uso por key.
Paso 7: apuntar Claude Code al endpoint
El manager expone una ruta Messages estilo Anthropic por workload, POST /endpoint/<project>/<workload>/v1/messages, junto a la /v1/chat/completions estilo OpenAI. Claude Code añade /v1/messages por su cuenta, así que la base URL termina en el workload:
export ANTHROPIC_BASE_URL=https://api.inferencekey.com/endpoint/code-assistant/qwen3-coder-next-awq-4bit-vllm
export ANTHROPIC_AUTH_TOKEN=ik_live_...
export ANTHROPIC_MODEL=qwen3-coder-next-awq-4bit-vllm
export ANTHROPIC_DEFAULT_HAIKU_MODEL=qwen3-coder-next-awq-4bit-vllm
export ANTHROPIC_DEFAULT_SONNET_MODEL=qwen3-coder-next-awq-4bit-vllm
export ANTHROPIC_DEFAULT_OPUS_MODEL=qwen3-coder-next-awq-4bit-vllm
claude
api.inferencekey.com es el host público por defecto; copia la base URL que muestre tu panel. ANTHROPIC_AUTH_TOKEN sale como Authorization: Bearer, que es lo que prefiere el manager; ANTHROPIC_API_KEY (enviada como x-api-key) también funciona, pero se impone sobre un login de suscripción y Claude Code en modo interactivo te pide una vez que apruebes la key personalizada (la documentación describe ese aviso solo para ANTHROPIC_API_KEY). Si llegan las dos cabeceras con valores distintos, el manager rechaza la petición con un 401 authentication_error.
Ahora, la trampa. El endpoint está ligado a un workload y el manager comprueba el nombre del modelo. Acepta que no haya modelo, default, el slug del workload o el nombre del modelo del workload; cualquier otra cosa recibe un HTTP 400 con tipo de error invalid_request_error y el mensaje "Model '…' is not available on this endpoint" (internamente el código es model_not_available). Claude Code envía nombres de modelo claude-* por defecto, y además usa un modelo pequeño para el trabajo en segundo plano. Así que pon ANTHROPIC_MODEL y ANTHROPIC_DEFAULT_HAIKU_MODEL con el slug del workload, o tu primer prompt rebota. Cualquier cosa que elija el alias sonnet u opus (el selector /model, opusplan) seguiría enviando nombres claude-*, y por eso el bloque de arriba apunta también ANTHROPIC_DEFAULT_SONNET_MODEL y ANTHROPIC_DEFAULT_OPUS_MODEL al slug.
Paso 8: verlo trabajar
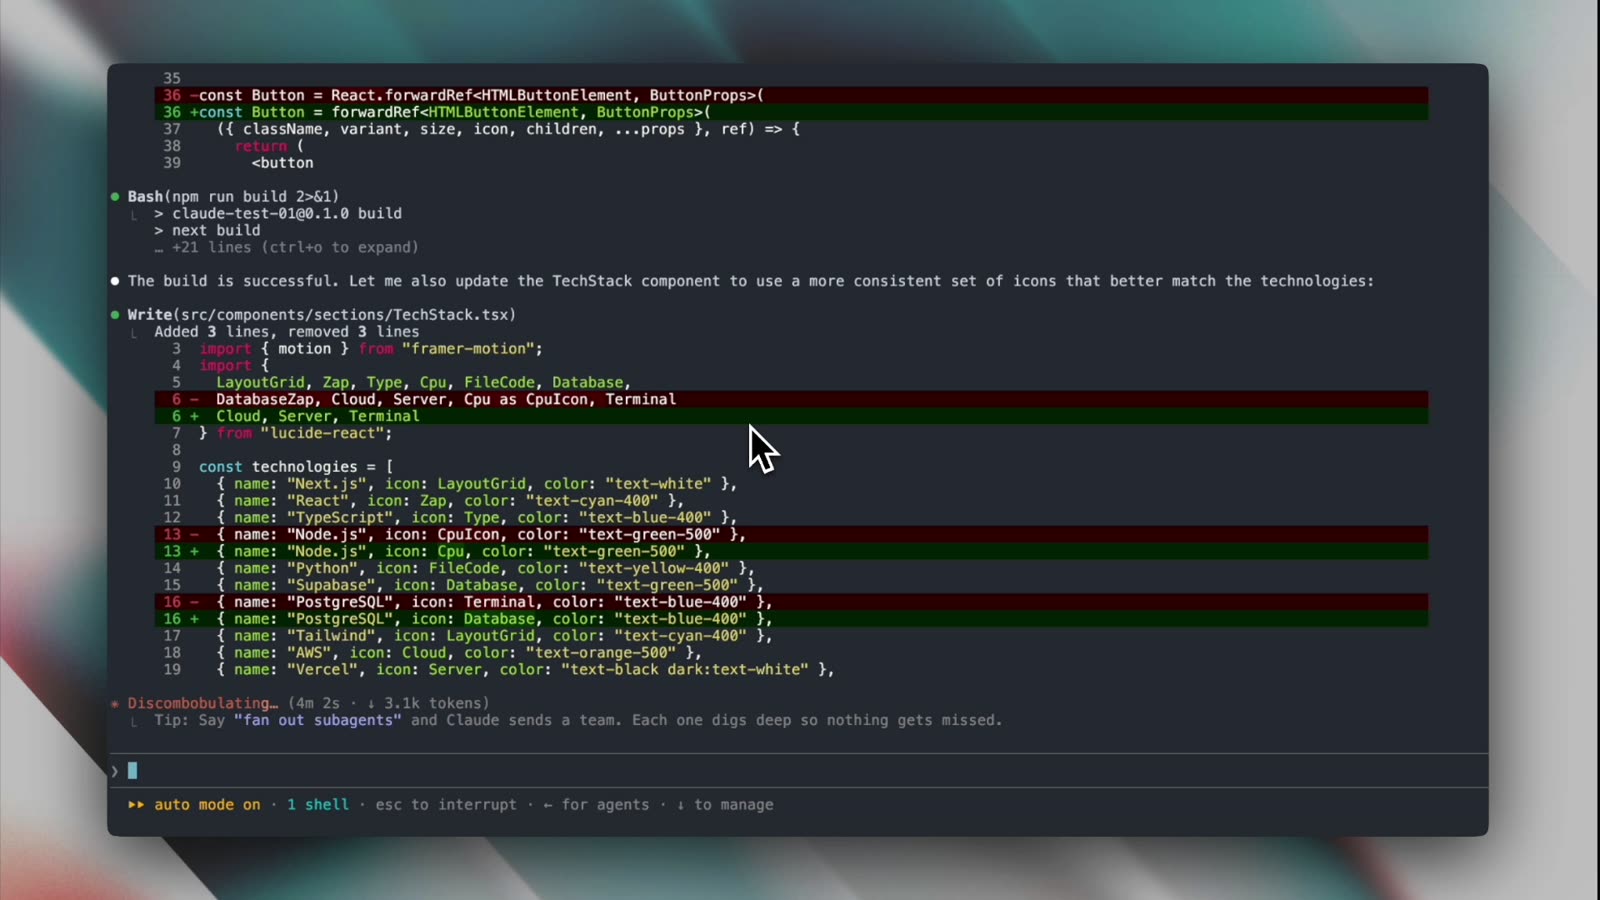
Chad pidió una landing page para "Chad Coder": una lista de componentes React (Navbar, Hero, Services, Projects, Testimonial, TechStack, CTA y más) y el encargo de que "should feel like a $20k-$50k custom agency website, not a generic Tailwind template". Claude Code entró en plan mode, escribió src/components/ui/Button.tsx, instaló class-variance-authority, clsx y tailwind-merge, ejecutó npm run build y siguió editando componentes.
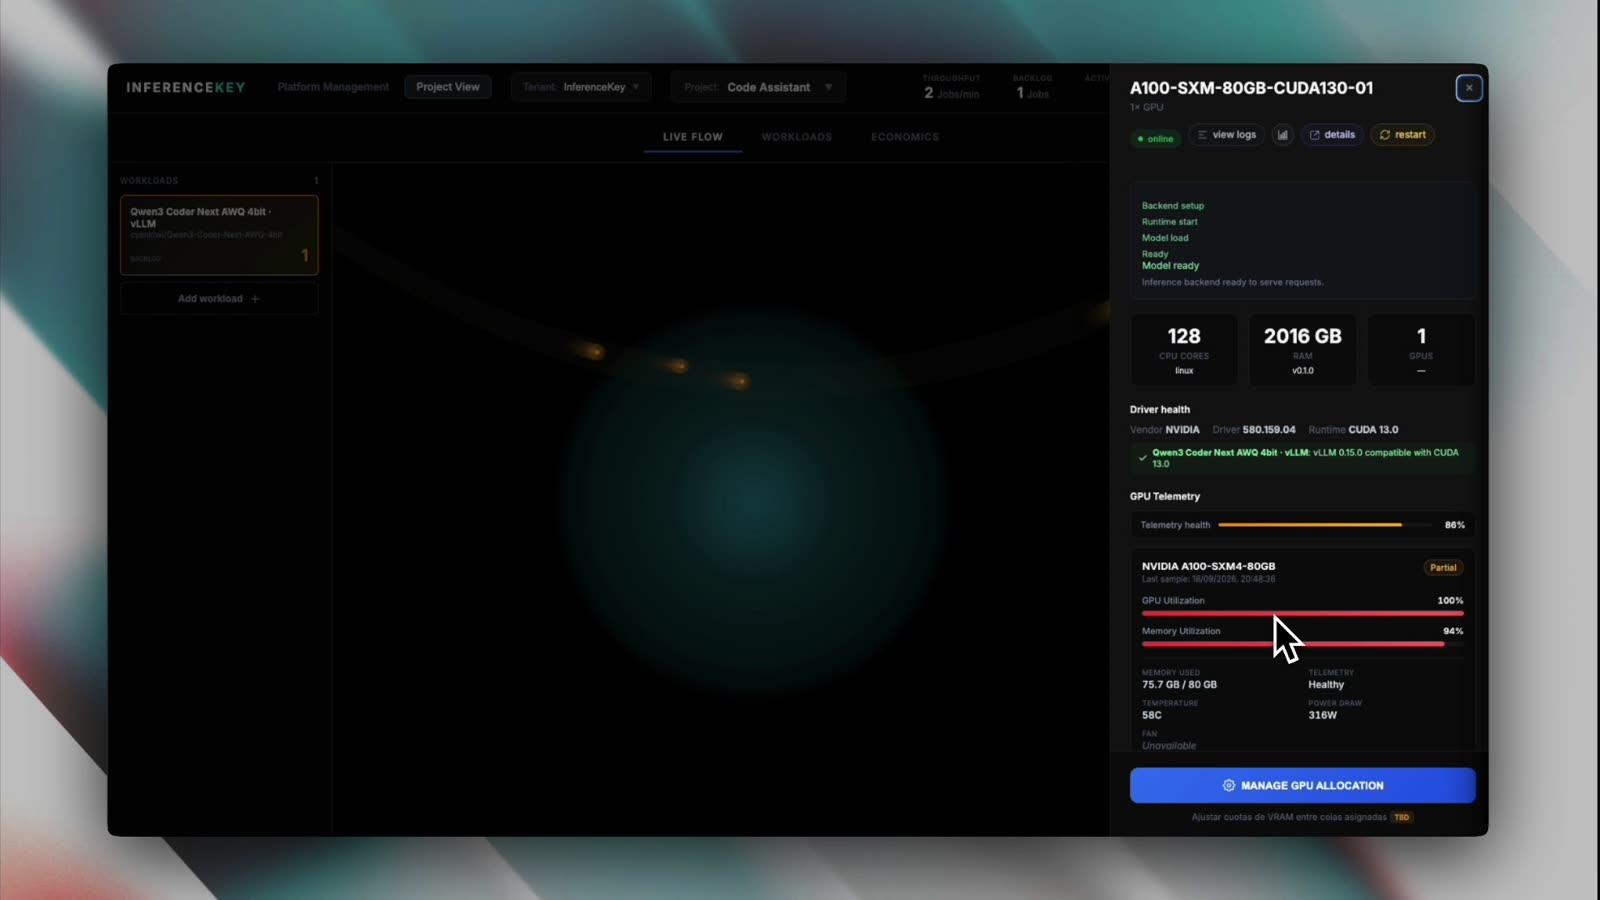
Mientras tanto, el Live Flow del proyecto muestra las peticiones viajando a la GPU, con la cabecera en 2 jobs/min, 1 en backlog, 1 GPU activa, $1.79/hr. En ese punto de la sesión, a mitad del build, el panel lateral del workload contaba 5 peticiones y 31.7K tokens, y el desglose por key ponía 4 peticiones y los 31.7K tokens en la key de Chad. Es una foto fija, no el coste completo de la landing page. El panel lateral del worker es donde la GPU dice la verdad: 100% de utilización, 75.7 GB de 80 GB usados, 58 C, 316 W.
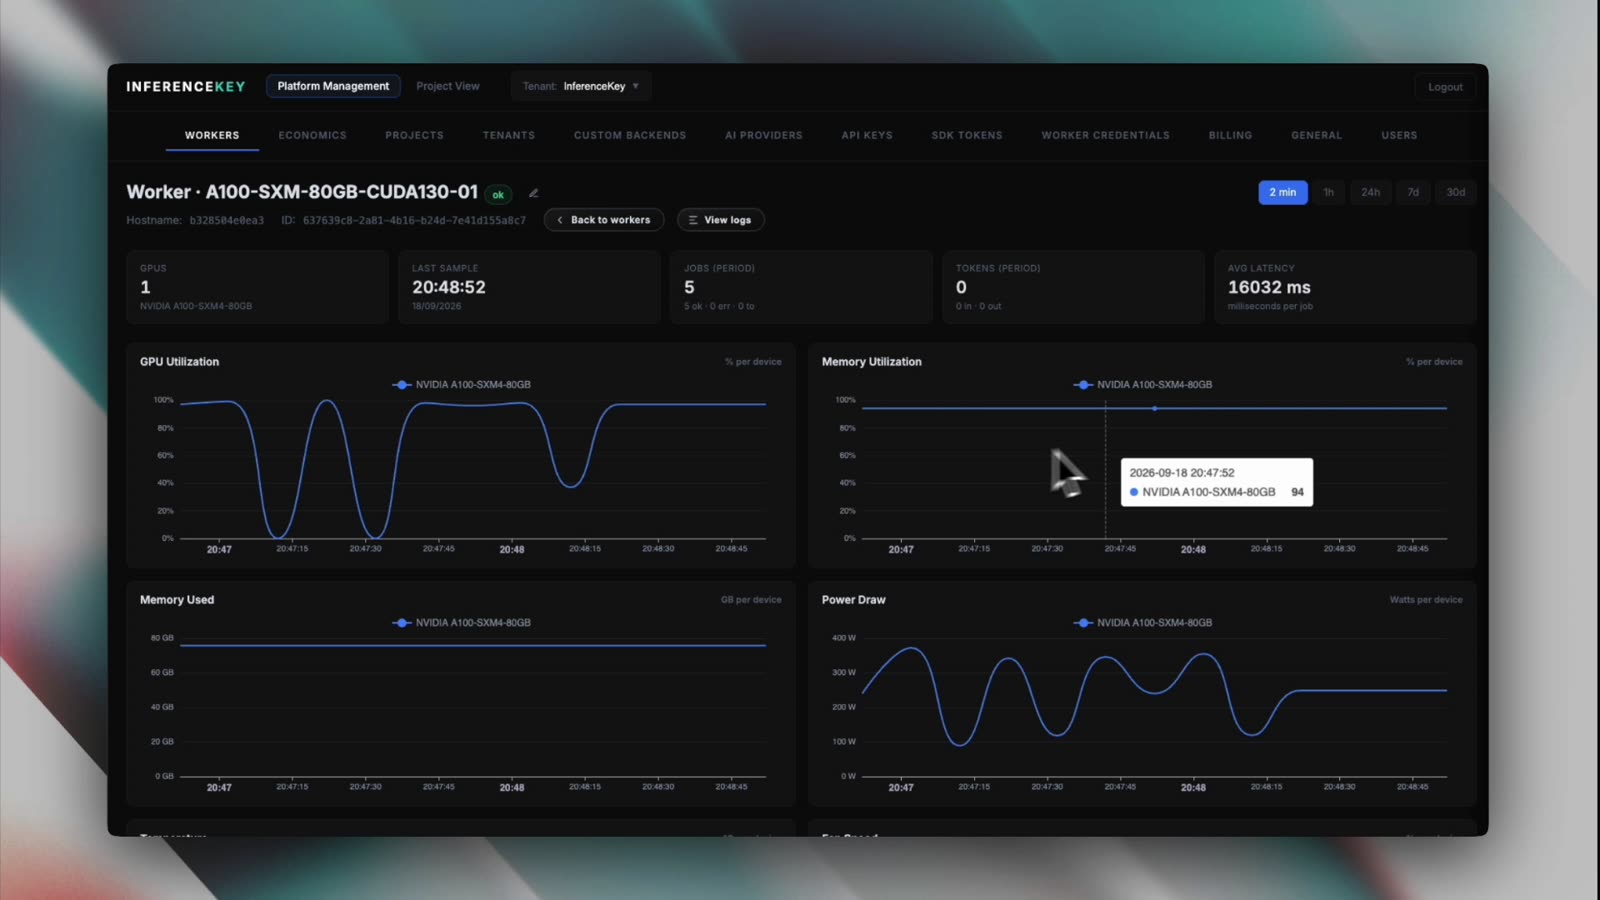
La página del worker guarda las gráficas de los dos últimos minutos: memoria usada plana en torno a 76 GB, potencia con picos cerca de 380 W, 5 jobs ok, 0 errores y 16032 ms de latencia media por job en esa ventana. Esos jobs son pasos del agente de Claude Code, así que toma la media como una sensación aproximada, no como un benchmark de latencia.
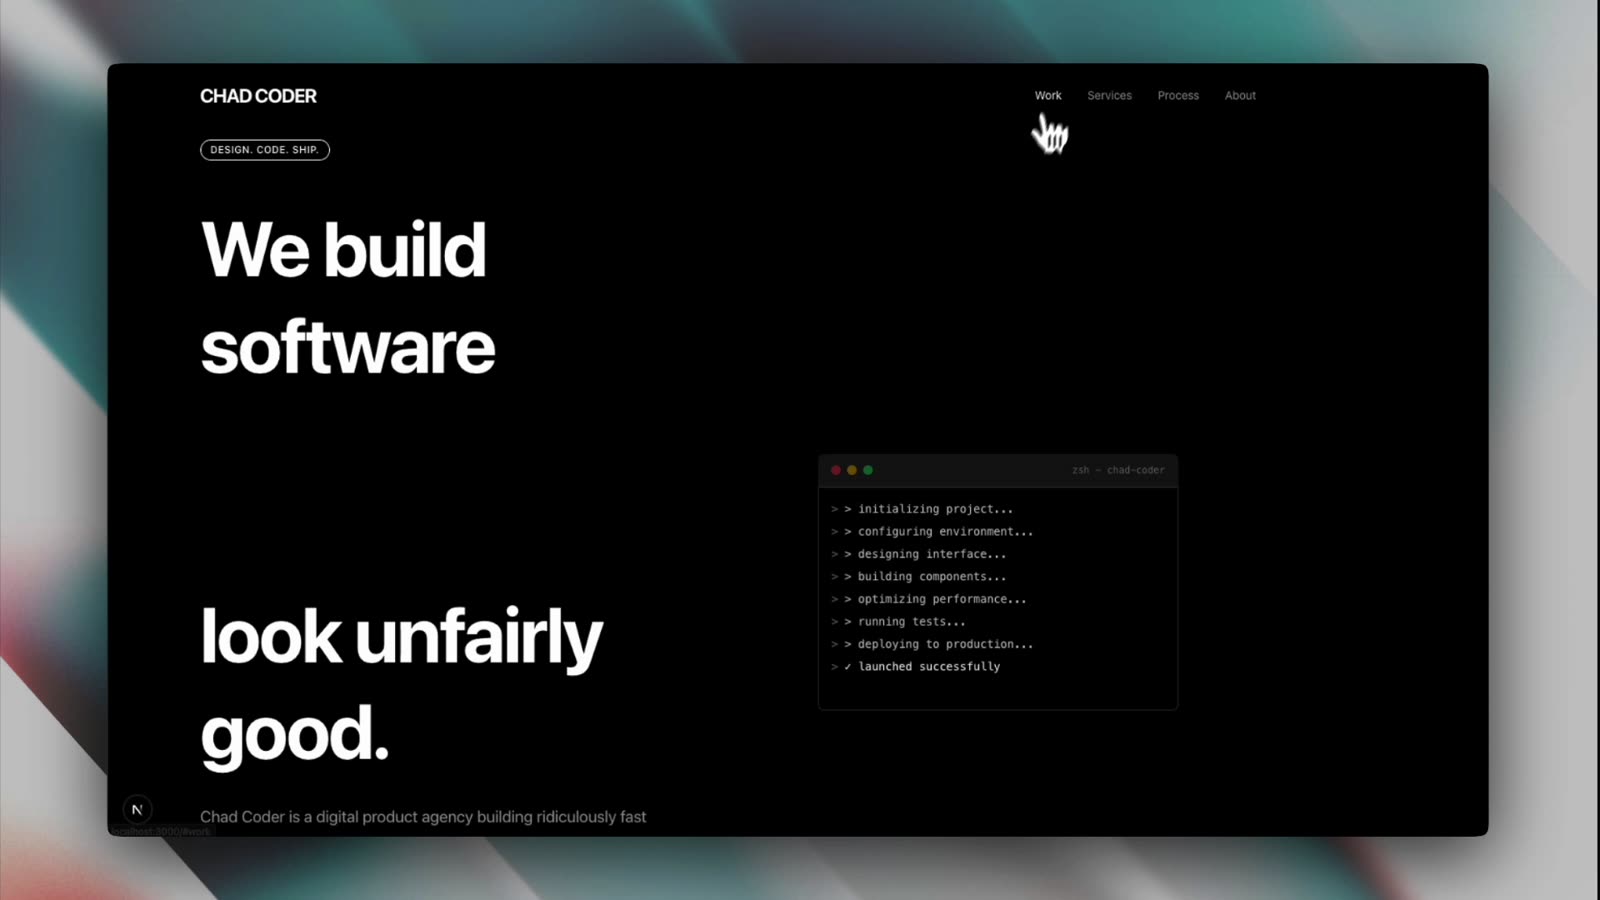
Y el resultado: una landing page oscura con una cabecera "CHAD CODER" y el titular "We build software look unfairly good." Sí, al hero le falta una palabra, muy probablemente un hueco de palabra que no se renderizó. La sección de proyectos tiene tarjetas de relleno. Es una primera pasada de un agente, no un sitio listo para publicar.
Qué demuestra esto y qué no
Primero los límites:
- Escala. Una GPU, un desarrollador,
--max-num-seqs 2. - Calidad. Un modelo cuantizado a 4 bits, así que cuenta con algo de pérdida de calidad frente a los pesos a precisión completa. No medimos cuánta.
- La tarea. Una landing page no es un benchmark de código difícil: ni un repo legacy grande, ni un refactor enrevesado, ni una suite de evals.
- Las cifras. De la ejecución en la A100 solo hay un saludo de 11 tokens, así que aquí no se mide su velocidad; la cifra de 40 tokens/s viene de otra tarjeta (RTX A6000) y otra configuración. El contexto de 256K está configurado, no puesto a prueba: la foto de uso tomada a mitad de la sesión mostraba 31.7K tokens de entrada.
- Coste. No comparamos esta sesión con el precio por token. Con un desarrollador y dos secuencias en vuelo, este no es el montaje en el que pagar por hora sale a cuenta; para eso hacen falta varios desarrolladores o agentes compartiendo la GPU.
- El agente. Esto es Claude Code manejando Qwen, no Claude. Claude Code está construido en torno a los modelos Claude. Con una base URL que no es de primera parte, su búsqueda de tools MCP está desactivada por defecto, y el comportamiento del agente depende de lo bien que el modelo siga el protocolo de tools de Claude Code. No lo comparamos con Claude alojado en la misma tarea.
- Privacidad. Las peticiones siguen pasando por el endpoint de InferenceKey y por un host alquilado en la nube.
- Multi-GPU. La narración dice que puedes añadir GPUs y repartir las peticiones entre ellas. Eso no se muestra en este vídeo y no lo probé aquí.
Lo que sí muestra: un modelo de código MoE de 80B configurado para su contexto completo de 256K, sirviendo una sesión real de Claude Code, tool calls incluidas, en una sola A100 a $1.79/h. Sin sesión SSH, sin entorno montado a mano, una key limitada a un endpoint, contabilidad de tokens por key y telemetría de la GPU que puedes leer mientras el agente trabaja. Es el tipo de montaje aburrido, y eso es un cumplido.
Lo siguiente en el setlist: más GPUs detrás del mismo endpoint y un workload de código más pesado que una landing page.
La guía paso a paso está en la documentación: Deploy your own code assistant.