Underdog Bark 3.0 Pro schreibt jedes "you know" mit und liegt knapp vor Qwen3-ASR, bei einem Viertel der Größe
Bark 3.0 Pro schrieb bei 40 englischen Clips 6,28 % der Wörter falsch, Qwen3-ASR-1.7B 7,03 %. Und es lief ohne GPU, auf vier CPU-Threads.
"Bark 3.0 schreibt, was gesagt wurde, Füllwörter eingeschlossen. Es räumt die Sprache nicht auf." Dieser Satz der Autoren erklärt das meiste von dem, was wir gesehen haben. Underdog Bark 3.0 Pro ist ein neues offenes Speech-to-Text-Modell mit 1,25 GB auf der Festplatte. Bei 40 englischen Clips schrieb es 6,28 % der Wörter falsch. Qwen3-ASR-1.7B, ein Modell mit 4,7 GB, kam auf demselben Audio und derselben RTX 3090 auf 7,03 %. Knapp, mit Bark leicht vorn. Für ein Team, das Modelle deployt, ist die Größe die eigentliche Nachricht: Bark braucht etwa 2 GB GPU-Speicher, sobald langes Audio in Stücke geschnitten wird, und vier Prozessor-Threads transkribieren eine Aufnahme schneller, als sie abläuft. Was Sie damit tun können: wortgetreue englische Transkripte von Meetings und Anrufen auf Hardware, die Sie schon haben, wenn es sein muss ganz ohne GPU.
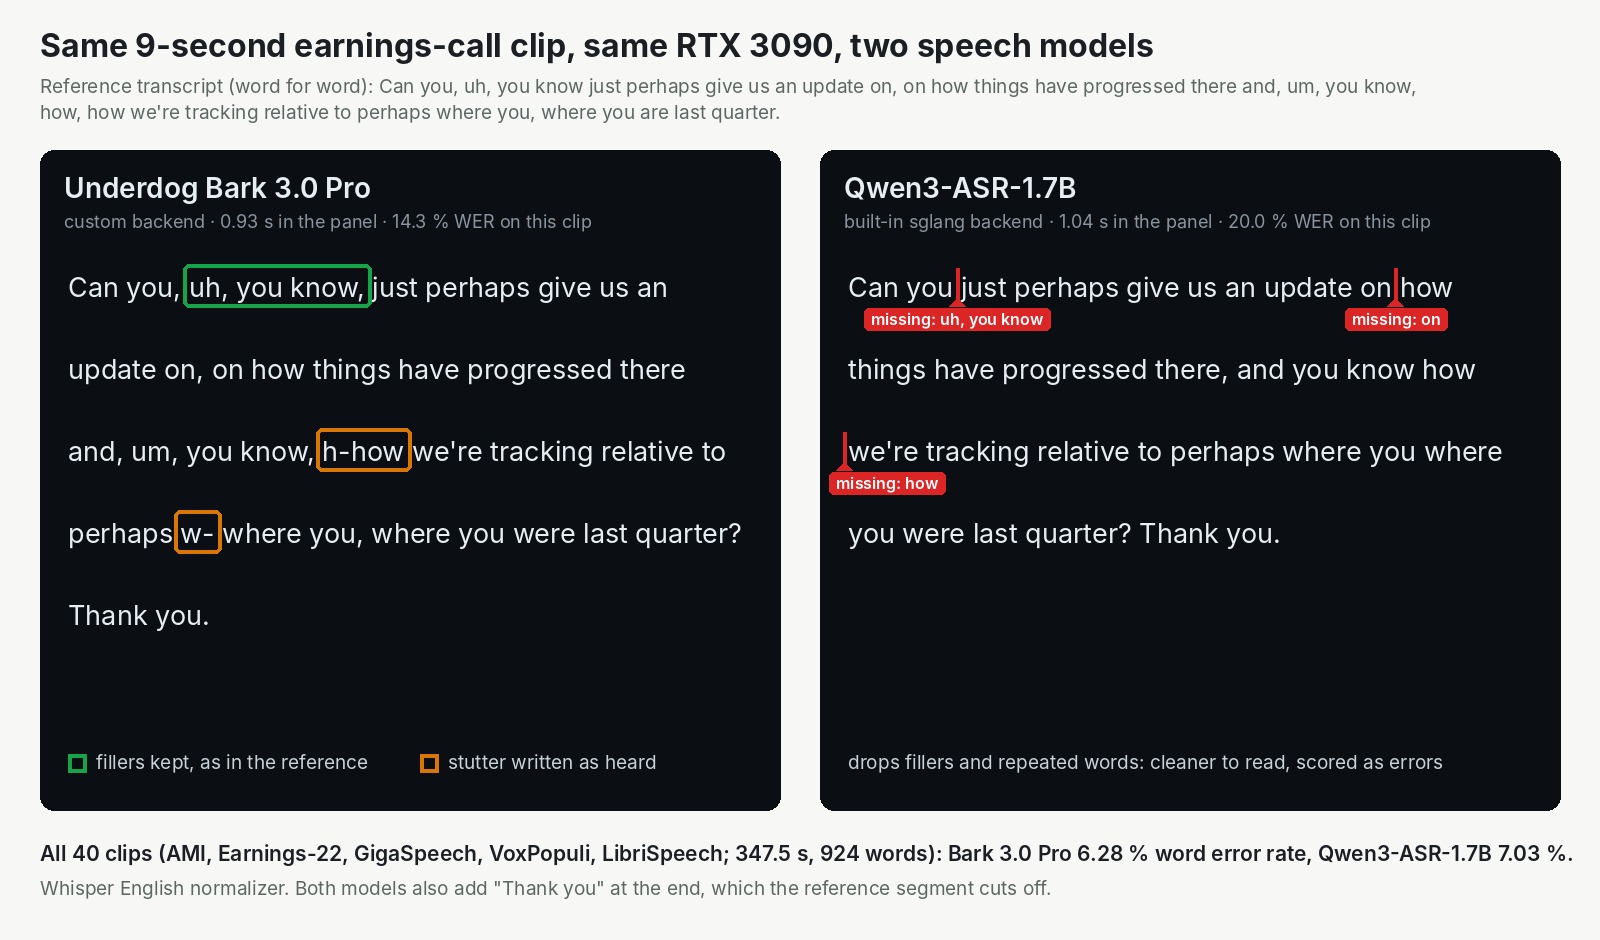
Ein Clip aus einer Quartalszahlen-Konferenz, eine Karte. Bark behält die Füllwörter und Wiederholungen, die auch die Referenz behält. Qwens aufgeräumterer Text verliert dafür Punkte.
Ein kleines Modell, gebaut von vier Teams
Bark hat einen Stammbaum. NVIDIA hat das Basismodell trainiert, Parakeet TDT 0.6B v3. Moondream hat eine verbesserte Version davon gebaut. Conway Research hat sie dann nachtrainiert und zu Bark 3.0 Pro verkleinert und am 15. Oktober auf Hugging Face veröffentlicht. Das Underdog-Team hat den Release-Beitrag geschrieben. Alle drei Modelle der Kette stehen unter CC-BY-4.0, was kommerzielle Nutzung erlaubt, solange Sie NVIDIA, Moondream und Conway Research nennen.
Entdeckt haben wir es im News-Video von AI Search vom 25. Oktober. Die Angabe, die uns hinschauen ließ, steht auf der Modellseite: eine durchschnittliche Wortfehlerrate von 4,29 % auf dem Open ASR Leaderboard, einer öffentlichen Rangliste für Speech-to-Text, nach eigener Zählung die niedrigste aller offenen Modelle. Die Wortfehlerrate ist der Anteil der Wörter, die ein Modell falsch hat, niedriger ist also besser. Dieser Wert ist selbst gemeldet, und wir haben nicht versucht, ihn nachzustellen. Unser Teil war kleiner und praktischer: Bark für das Deployment verpacken, neben Qwen3-ASR auf eine Karte stellen und die Fehler zählen.
Der Abstand ist vor allem "you know"
Wir haben je acht Clips aus fünf Standard-Testsets gezogen: Büro-Meetings, Telefonkonferenzen zu Quartalszahlen, Podcasts, Reden im Europäischen Parlament und Hörbücher. Das sind fast sechs Minuten und 924 Wörter. Beide Modelle liefen in unserer Cloud, über einen lokalen Test-Build von InferenceKey, bewertet nach denselben Regeln.
| Auf unseren 40 Clips | Bark 3.0 Pro | Qwen3-ASR-1.7B |
|---|---|---|
| Falsche Wörter | 6,28 % | 7,03 % |
| Ausgelassene Wörter | 11 | 29 |
| Falsch gehörte Wörter | 32 | 28 |
| Größe auf der Festplatte | 1.254 MB | 4.699 MB |
Die mittleren Zeilen erzählen die Geschichte. Die menschlichen Referenztranskripte sind wortgetreu: Sie schreiben, was die Leute gesagt haben, mit allen Fehlstarts. Stellen Sie sich das Live-Bootleg mit allem Husten vor, gegen die Studiofassung. Bark schreibt das Bootleg. Qwen neigt zur Studiofassung, und die meisten der 29 ausgelassenen Wörter waren Füllwörter und Wiederholungen wie "you know", "on, on" und "how, how". Bei tatsächlich falsch gehörten Wörtern lag Qwen leicht vorn. Barks Vorsprung kommt also davon, dass es behält, was gesagt wurde, nicht von besseren Ohren.
Deshalb war Barks Vorsprung bei Meetings und Quartalszahlen-Konferenzen am größten, wo die Referenzen die meisten Füllwörter und Wiederholungen behalten. Qwen schnitt bei den Parlamentsreden und Hörbüchern besser ab, und warum, haben wir nicht herausgefunden.
So schnell, dass das Netzwerk der langsame Teil ist
Ein typischer Clip kam in einer halben Sekunde zurück, den Weg über das Netzwerk mitgezählt. Fünf Minuten Audio aus einer Quartalszahlen-Konferenz brauchten in einer einzigen Anfrage 2,8 Sekunden GPU-Arbeit, 4,5 Sekunden mit Upload und Antwort, und Bark lieferte das ganze Transkript. Qwen3-ASR lieferte bei derselben Datei 212 Wörter und hörte auf. Woran das lag, haben wir nicht untersucht.
Dann der Teil, der zählt, wenn Sie Hardware auswählen. Mit nur Bark geladen ging die 3090 nie über etwa 2,8 GB ihrer 24 GB. Wir haben den Speicher begrenzt, den Bark nutzen durfte, um kleinere Karten nachzubilden: Unter etwa 2 GB lief alles durch, sobald langes Audio in Stücke von 60 Sekunden geschnitten wurde. Und ganz ohne Grafikkarte schafften vier Threads eines Server-Prozessors die Fünf-Minuten-Datei in 31 Sekunden, sechzehn Threads in 14. Die Transkripte stimmten auf allen 40 Clips Wort für Wort mit denen der GPU überein.
Für wen das interessant ist
- Teams, die englische Meetings, Anrufe oder Interviews transkribieren und jedes Wort so brauchen, wie es gesagt wurde. Bark machte auf unseren Meetings und Quartalszahlen-Konferenzen weniger wortgetreue Fehler als Qwen3-ASR-1.7B.
- Teams ohne freie GPU. Ein paar Prozessor-Threads schaffen eine Aufnahme schneller, als sie abläuft, also kann eine Maschine, die Sie schon betreiben, die Arbeit übernehmen.
- Alle, die es in einem Produkt ausliefern. Die Lizenz erlaubt das, mit Namensnennung.
Wenn Sie Text wollen, den Menschen ohne Nachbearbeitung lesen, planen Sie einen Aufräumschritt ein: Die Autoren liefern ein separates Bark 3.0 Clean, das Füllwörter weglässt und das wir nicht getestet haben. Wenn Ihr Audio nicht auf Englisch ist, suchen Sie woanders. Bark kann nur Englisch und hat laut seinen Autoren noch keine Zeitstempel pro Wort und keine Sprechernamen.
Die ehrliche Grenze, einmal gesagt: 924 Wörter sind eine kleine Stichprobe auf einer einzigen echten GPU. Lesen Sie das Ergebnis also als "knapp, mit Bark vorn", nicht als Rangliste, und betrachten Sie kleinere Karten als ungetestet, denn keiner der sieben Typen, die wir mieten wollten, war verfügbar.
Der vollständige Test
Der Research-Beitrag hat die Tabelle Set für Set, beide Transkripte des Quartalszahlen-Clips, die Speicherleiter, die CPU-Läufe und die zwei Ecken und Kanten, auf die wir auf der Plattform gestoßen sind. Lesen Sie den vollständigen Test von Underdog Bark 3.0 Pro.