MemT-1.0-Nano speichert, was sich ein Chat merkt, in einer Datei, und braucht dafür eine 80-GB-Karte
MemTensors MemT-1.0-Nano lud eine 41,9 MB große Speicherdatei in eine leere Sitzung und lag auf einer A100 mit 80 GB bei 9 von 9 Fakten richtig.
Die meisten Chatmodelle vergessen einen Menschen in dem Moment, in dem die Sitzung endet. Die App hebt den Verlauf als Text auf, und das Modell liest beim nächsten Mal alles noch einmal. MemT-1.0-Nano, ein neues offenes Modell von MemTensor, geht einen anderen Weg: Es faltet die Turns, die Sie markieren, in einen Speicher fester Größe und lässt Sie diesen Speicher als Datei sichern. Wir haben es auf einer A100 mit 80 GB in unserer Cloud laufen lassen, um zu sehen, ob die Datei die Fakten wirklich mitnimmt. Sie tut es. Wir haben die Datei gespeichert, die Sitzung geschlossen und sie in eine neue Sitzung mit null Nachrichten geladen. Danach beantwortete das Modell 9 von 9 Fragen zu dem, was man ihm erzählt hatte. Für ein Team, das Modelle deployt, wird das Gedächtnis jeder Person zu einer Datei, die Sie ablegen, sichern, verschieben und löschen können, und sie ist in unter zwei Sekunden wieder geladen. Was Sie heute tun können: einen Pilotversuch mit Ihren eigenen langen Verläufen fahren, auf einer 80-GB-Karte.
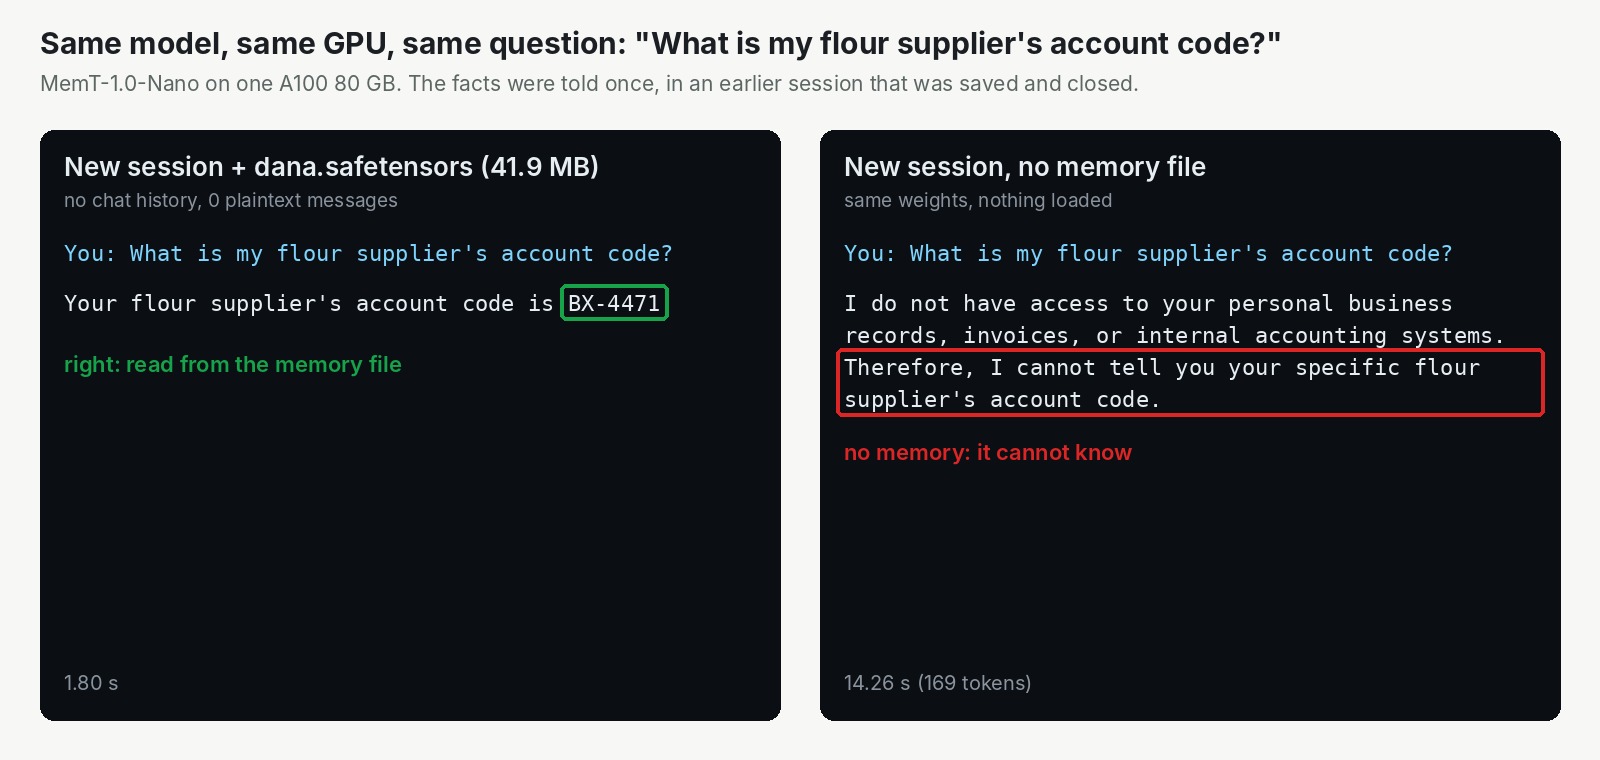
Beide Sitzungen starten leer. Der einzige Unterschied ist die 41,9 MB große Datei links.
Ein Notizbuch statt eines Tonbands
Ein normales Chatmodell arbeitet wie ein Tonband: Jede Nachricht bleibt, und das Band wird mit jedem Turn länger. MemT-1.0-Nano führt ein Notizbuch fester Größe. Wenn die App einen Turn als "remember" markiert, faltet das Modell ihn ins Notizbuch und verwirft den Text. Das Notizbuch wird nie dicker, und Sie können es speichern, alles schließen und es morgen wieder hineinreichen.
Der Preis der festen Größe sind Details. Das Notizbuch behält, was Sie markiert haben, nicht jedes Wort. Und nur markierte Turns kommen hinein: Gewöhnliche Fragen bleiben als einfacher Text in der Sitzung. Was ins Gedächtnis wandert, entscheidet also Ihre App, nicht das Modell.
MemTensor hat das Modell auf Qwen3.6-35B-A3B vom Qwen-Team aufgebaut. Die Gewichte stehen unter Apache-2.0, Sie dürfen sie also kommerziell nutzen.
Neun Fakten zurück aus einer Datei, und eine leere Sitzung, die nichts wusste
Wir haben eine Kundin erfunden, Dana, die eine Bäckerei in Porto führt. In zwei Turns erzählte sie dem Modell den Namen ihrer Bäckerei, ihren Ofen, die Kundennummer bei ihrem Mehllieferanten, eine Sesamallergie und den Tag, an dem ihre Tochter eingeschult wird. Nach dem Neuladen kamen alle vier Fragen richtig zurück, auch die Lieferantennummer BX-4471. Dann haben wir es schwerer gemacht: eine Notiz mit 1.467 Tokens (Tokens sind Wortstücke), vierzig Sätze Bäckereialltag mit fünf darin versteckten Fakten. Alle fünf kamen zurück.
Die Kontrolle war eine neue Sitzung ohne die Datei, gefragt nach der Lieferantennummer. Sie sagte, sie habe keinen Zugriff auf Danas Unterlagen. Das zeigt nur, dass die Datei die Information trägt, aber genau darum geht es.
| Was wir gemessen haben | Ergebnis |
|---|---|
| Größe der Speicherdatei, nach dem kurzen Chat und nach der langen Notiz | beide Male 41.944.024 Bytes |
| Speichern der Datei | 0,66 bis 1,02 s |
| Laden in eine frische Sitzung | 1,35 bis 1,99 s |
| Kurze Antworten nach dem Neuladen | 1,55 bis 2,45 s |
| Spitzenverbrauch auf der Karte | etwa 66,5 GiB |
Die Datei wächst nicht. Das ist der ganze Trick, und zugleich der Grund, warum sie keinen Speicherplatz auf der Festplatte spart: Danas Verlauf als Text waren 107 Tokens, ein paar hundert Bytes.
Wo sich die Datei lohnt
Was die Datei einsparen kann, ist das erneute Lesen. Ein Modell, das vom Tonband arbeitet, baut seinen Arbeitsspeicher auf der Karte vor jeder Antwort aus dem gesamten Verlauf neu auf, und dieser Speicher wächst mit jedem Token. Nach unserer Rechnung wird die Datei erst ab etwa 2.000 Tokens Verlauf kleiner als dieser Arbeitsspeicher. Bei 128K Tokens ist sie etwa 64-mal kleiner.
Beim Tempo liegt der Gleichstand viel später. Laut Paper ist Nano bei kurzen Verläufen langsamer, bei 32.000 Tokens etwa gleichauf und bei 128K etwa 1,86-mal schneller. Wir haben keines von beiden gemessen: Die Größenangaben sind unsere Rechnung, die Tempoangaben stammen aus dem Paper. Wie eine Setlist verdient sich das Notizbuch seinen Platz auf einer langen Tour, nicht bei einem Open Mic mit einem einzigen Song.
Für wen das interessant ist
Wenn Sie einen Assistenten bauen, der eine Person über Wochen begleitet, lohnt sich ein Pilotversuch. Ein Gedächtnis, das Sie als Datei weiterreichen können, ist sauberer zu verwalten als ein wachsender Stapel Transkripte.
Wenn Ihre Gespräche kurz sind, lassen Sie es.
Wenn Sie exakte Details aus langen Verläufen brauchen, behalten Sie einen Textspeicher. Das sagen die Autoren selbst. Über 11 Gedächtnis-Benchmarks in ihrem Paper erreichen die besten Textgedächtnis-Systeme, und auch das einfache Aufheben des ganzen Gesprächs, etwa das 1,4- bis 1,5-Fache von Nanos 47,0. In einem Test mit langen Chatverläufen kommt Nano auf 32,6, gegenüber 76,8, wenn man das ganze Gespräch behält.
Wenn Ihre größte Karte 48 GB hat, haben wir keinen Weg hinein gefunden. MemTensor veröffentlicht keine komprimierte Version. Unser 8-Bit-Versuch lief unter einer Grenze von 48 GB auf der A100 aus dem Speicher, und auf der vollen Karte stürzte das erste "remember" ab.
Wenn Sie Tempo brauchen: Der mitgelieferte Code ist heute langsam, etwa 9 bis 10 Tokens pro Sekunde und etwa 13 Sekunden für eine Antwort mit 128 Tokens auf einen "remember"-Turn. Wir haben die schnelleren optionalen Komponenten nicht installiert und nichts optimiert.
Auf InferenceKey läuft das Modell als Custom Backend, ein kleiner Python-Wrapper um den Code der Autoren auf Ihrer GPU-Maschine. Es sitzt hinter einem Standard-Chat-Endpoint mit einem zusätzlichen Feld, das remember, ask, save, close oder load sagt. Sobald die 70,3 GB an Gewichten auf der Platte lagen, war ein Neustart in 20 Sekunden bereit.
Die ehrliche Grenze: Unsere neun Fragen waren kurze Fakten, die das Modell gerade erst gehört hatte, ein Nutzer nach dem anderen. Sie beweisen also, dass Speichern und Neuladen funktionieren, nicht das Erinnern über Monate neuer Erinnerungen hinweg.
Den vollständigen Test von MemT-1.0-Nano lesen Sie in unserem Research-Beitrag, mit jeder Zeitmessung, der Speicherleiter und dem Deployment-Beispiel.