MemT-1.0-Nano enregistre dans un fichier ce dont un chat se souvient, et il lui faut une carte de 80 GB pour ça
MemT-1.0-Nano de MemTensor a rechargé un fichier mémoire de 41,9 MB dans une session vide et retrouvé 9 faits sur 9, sur une A100 de 80 GB.
La plupart des modèles de chat oublient une personne dès que la session se ferme. L'application garde l'historique en texte et le modèle relit tout la fois suivante. MemT-1.0-Nano, un nouveau modèle ouvert de MemTensor, fonctionne autrement : il intègre les tours que vous signalez dans une mémoire de taille fixe et vous permet d'enregistrer cette mémoire dans un fichier. Nous l'avons fait tourner sur une A100 de 80 GB de notre cloud pour voir si le fichier transporte vraiment les faits. C'est le cas. Nous avons enregistré le fichier, fermé la session et l'avons chargé dans une nouvelle session sans aucun message. Le modèle a ensuite répondu juste à 9 questions sur 9 sur ce qu'on lui avait dit. Pour une équipe qui déploie des modèles, la mémoire de chaque personne devient un fichier que l'on peut stocker, sauvegarder, déplacer et supprimer, et qui se recharge en moins de deux secondes. Ce que vous pouvez faire aujourd'hui : lancer un pilote sur vos propres longs historiques, sur une carte de 80 GB.
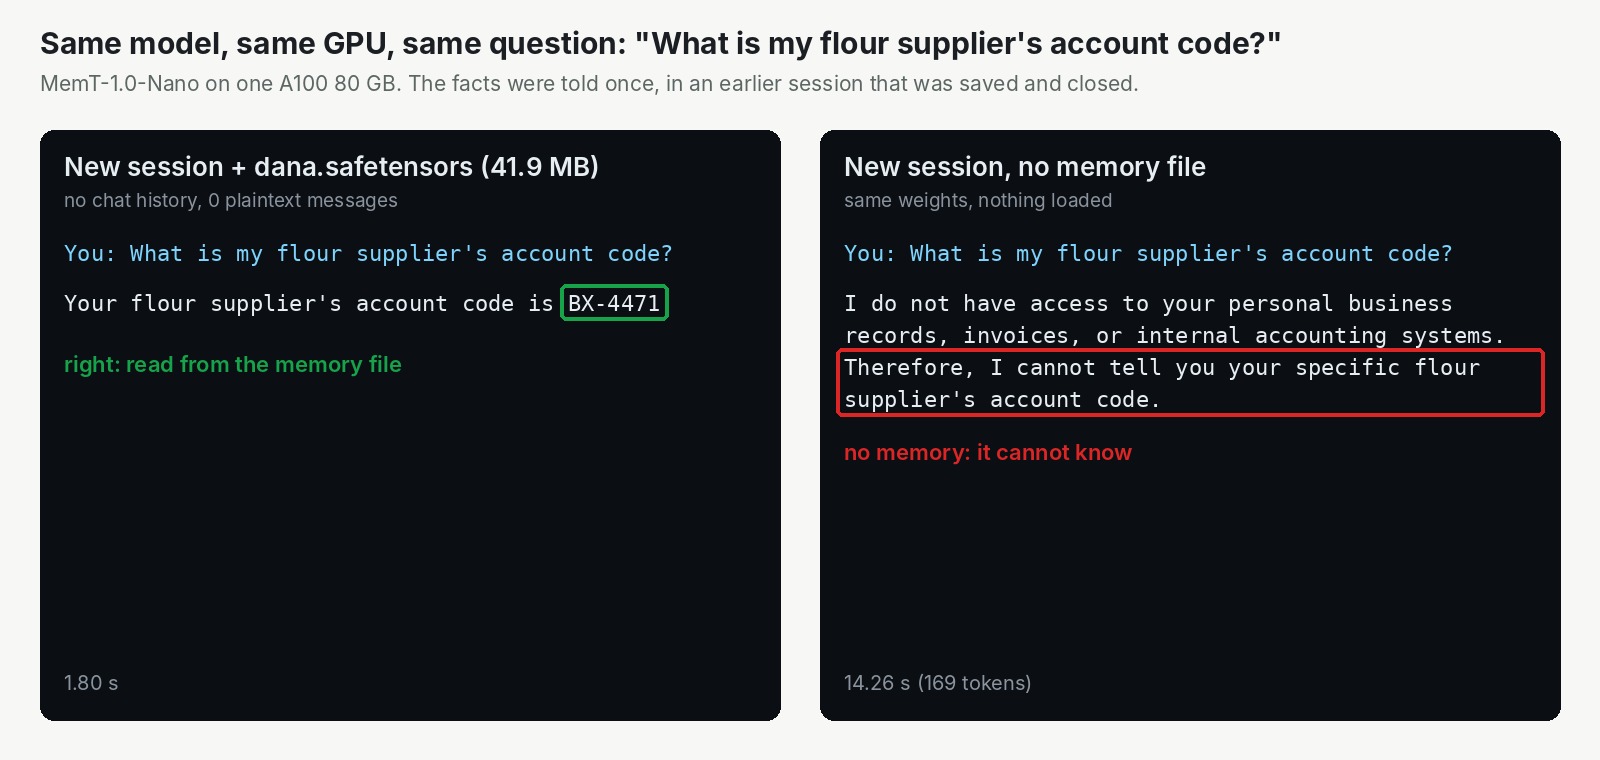
Les deux sessions démarrent vides. La seule différence est le fichier de 41,9 MB à gauche.
Un carnet plutôt qu'une bande
Un modèle de chat classique fonctionne comme une bande magnétique : chaque message reste, et la bande s'allonge à chaque tour. MemT-1.0-Nano tient un carnet de taille fixe. Quand l'application marque un tour comme "à retenir", le modèle l'intègre au carnet et jette le texte. Le carnet ne s'épaissit jamais, et vous pouvez l'enregistrer, tout fermer et le lui rendre le lendemain.
Le prix d'une taille fixe, c'est le détail. Le carnet garde ce que vous avez signalé, pas chaque mot. Et seuls les tours signalés y entrent : les questions ordinaires restent dans la session en texte brut. C'est donc votre application qui décide de ce qui passe en mémoire, pas le modèle.
MemTensor a construit le modèle sur Qwen3.6-35B-A3B, de l'équipe Qwen. Les poids sont sous Apache-2.0, vous pouvez donc les utiliser commercialement.
Neuf faits retrouvés depuis un fichier, et une session vierge qui ne savait rien
Nous avons inventé une cliente, Dana, qui tient une boulangerie à Porto. En deux tours, elle a donné au modèle le nom de sa boulangerie, son four, son code client chez son fournisseur de farine, une allergie au sésame et le jour où sa fille entre à l'école. Après le rechargement, les quatre questions ont reçu une réponse juste, y compris le code fournisseur, BX-4471. Puis nous avons corsé l'exercice : une seule note de 1 467 tokens (les tokens sont des morceaux de mots), quarante phrases de routine de boulangerie avec cinq faits cachés dedans. Les cinq sont revenus.
Le témoin était une nouvelle session sans le fichier, à qui l'on demandait le code fournisseur. Elle a répondu qu'elle n'avait pas accès à ses dossiers. Cela montre seulement que le fichier transporte l'information, mais c'est justement le propos.
| Ce que nous avons mesuré | Résultat |
|---|---|
| Taille du fichier mémoire, après le chat court et après la note longue | 41 944 024 octets les deux fois |
| Enregistrement du fichier | 0,66 à 1,02 s |
| Chargement dans une session neuve | 1,35 à 1,99 s |
| Réponses courtes après le rechargement | 1,55 à 2,45 s |
| Pic de mémoire sur la carte | environ 66,5 GiB |
Le fichier ne grossit pas. C'est tout le principe, et c'est aussi pour cela que ce n'est pas un gain de disque : l'historique de Dana en texte faisait 107 tokens, quelques centaines d'octets.
Là où le fichier est rentable
Ce que le fichier peut économiser, c'est la relecture. Un modèle qui travaille à partir de la bande reconstruit son espace de travail sur la carte à partir de tout l'historique avant de répondre, et cet espace grossit à chaque token. D'après nos calculs, le fichier ne devient plus petit que cet espace de travail qu'au-delà d'environ 2 000 tokens d'historique. À 128K tokens, il est environ 64 fois plus petit.
En vitesse, le point d'équilibre arrive bien plus tard. L'article des auteurs trouve Nano plus lent sur les historiques courts, à peu près à égalité à 32 000 tokens et environ 1,86 fois plus rapide à 128K. Nous n'avons mesuré ni l'un ni l'autre : les chiffres de taille sont nos calculs, les chiffres de vitesse sont ceux de l'article. Comme une setlist, le carnet se justifie sur une longue tournée, pas sur une scène ouverte d'un seul morceau.
Qui devrait s'y intéresser
Si vous construisez un assistant qui suit une personne pendant des semaines, cela vaut un pilote. Une mémoire que l'on peut se passer sous forme de fichier est une chose plus propre à gérer qu'une pile de transcriptions qui ne cesse de grossir.
Si vos conversations sont courtes, passez votre chemin.
Si vous avez besoin de détails exacts sur de longs historiques, gardez un stockage en texte. Les auteurs le disent eux-mêmes. Sur 11 benchmarks de mémoire de leur article, les meilleurs systèmes de mémoire en texte, et le simple fait de garder toute la conversation, obtiennent environ 1,4 à 1,5 fois le score de Nano, 47,0. Sur un test de longs historiques de chat, Nano obtient 32,6 contre 76,8 quand on garde la conversation complète.
Si votre plus grosse carte a 48 GB, nous n'avons trouvé aucun moyen d'entrer. MemTensor ne publie aucune version compressée. Notre essai en 8 bits a manqué de mémoire avec un plafond de 48 GB sur l'A100, et sur la carte complète le premier "à retenir" a planté.
Si vous avez besoin de vitesse, le code d'origine est lent aujourd'hui : environ 9 à 10 tokens par seconde, et environ 13 secondes pour une réponse de 128 tokens à un tour "à retenir". Nous n'avons ni installé les composants optionnels plus rapides ni optimisé quoi que ce soit.
Sur InferenceKey, le modèle tourne comme backend personnalisé, une petite surcouche Python autour du code des auteurs, sur votre machine GPU. Il se trouve derrière un endpoint de chat standard avec un champ en plus qui dit retenir, demander, enregistrer, fermer ou charger. Une fois les 70,3 GB de poids sur le disque, un redémarrage était prêt en 20 secondes.
La limite honnête : nos neuf questions portaient sur des faits courts qu'on venait de donner au modèle, un utilisateur à la fois. Elles prouvent donc que l'enregistrement et le rechargement fonctionnent, pas le rappel sur des mois de nouveaux souvenirs.
Lisez le test complet de MemT-1.0-Nano dans notre article Research, avec tous les temps mesurés, l'échelle de mémoire et l'exemple de déploiement.