MemT-1.0-Nano guarda en un fichero lo que recuerda un chat, y para hacerlo necesita una tarjeta de 80 GB
MemT-1.0-Nano de MemTensor recargó un fichero de memoria de 41,9 MB en una sesión vacía y acertó 9 de 9 datos en una A100 de 80 GB.
La mayoría de los modelos de chat se olvidan de una persona en cuanto se cierra la sesión. La aplicación guarda el historial como texto y el modelo lo vuelve a leer entero la siguiente vez. MemT-1.0-Nano, un nuevo modelo abierto de MemTensor, funciona de otra forma: mete los turnos que marcas en una memoria de tamaño fijo y te deja guardar esa memoria como un fichero. Lo ejecutamos en una A100 de 80 GB de nuestra nube para ver si el fichero lleva de verdad los datos. Los lleva. Guardamos el fichero, cerramos la sesión y lo cargamos en una nueva con cero mensajes. El modelo respondió entonces bien a 9 de 9 preguntas sobre lo que le habían contado. Para un equipo que despliega modelos, la memoria de cada persona se convierte en un fichero que puedes guardar, copiar, mover y borrar, y que se recarga en menos de dos segundos. Lo que puedes hacer hoy: un piloto con tus propios historiales largos, en una tarjeta de 80 GB.
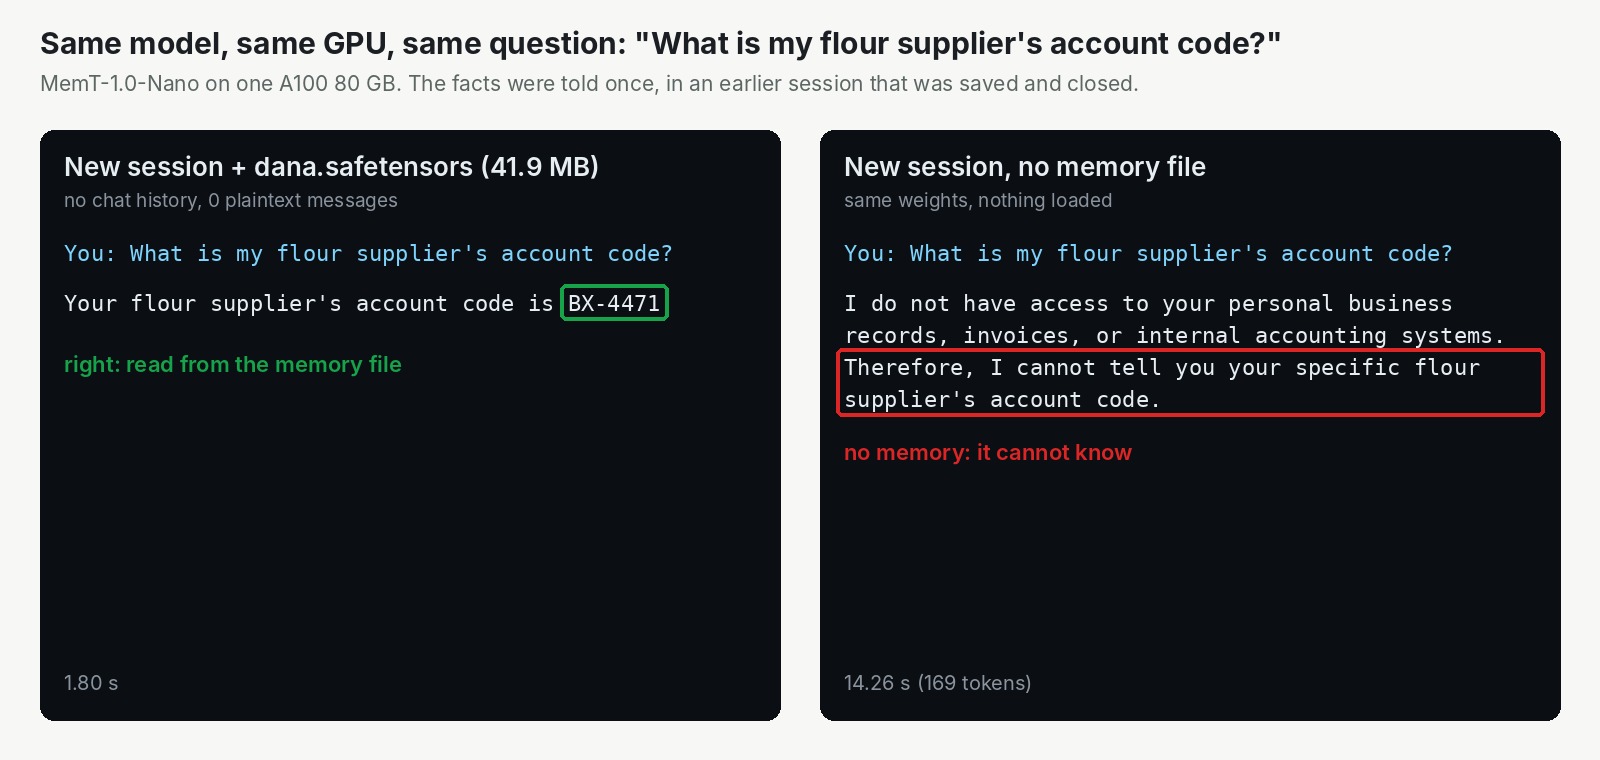
Las dos sesiones empiezan vacías. La única diferencia es el fichero de 41,9 MB de la izquierda.
Una libreta en lugar de una cinta
Un modelo de chat normal funciona como una cinta: cada mensaje se queda y la cinta crece en cada turno. MemT-1.0-Nano lleva una libreta de tamaño fijo. Cuando la aplicación marca un turno como "recordar", el modelo lo mete en la libreta y descarta el texto. La libreta nunca engorda, y puedes guardarla, cerrarlo todo y devolvérsela mañana.
El precio del tamaño fijo es el detalle. La libreta guarda lo que marcaste, no cada palabra. Y solo entran los turnos marcados: las preguntas normales se quedan en la sesión como texto. Así que quien decide qué pasa a la memoria es tu aplicación, no el modelo.
MemTensor construyó el modelo sobre Qwen3.6-35B-A3B, del equipo de Qwen. Los pesos son Apache-2.0, así que puedes usarlos con fines comerciales.
Nueve datos recuperados de un fichero, y una sesión en blanco que no sabía nada
Nos inventamos una clienta, Dana, que tiene una panadería en Oporto. En dos turnos le contó al modelo el nombre de su panadería, su horno, el código de cliente con su proveedor de harina, una alergia al sésamo y el día en que su hija empieza el colegio. Tras la recarga, las cuatro preguntas salieron bien, incluido el código del proveedor, BX-4471. Luego lo pusimos más difícil: una sola nota de 1.467 tokens (los tokens son trozos de palabra), cuarenta frases de rutina de panadería con cinco datos escondidos dentro. Salieron los cinco.
El control fue una sesión nueva sin el fichero, a la que preguntamos el código del proveedor. Dijo que no tenía acceso a sus registros. Eso solo demuestra que la información va en el fichero, pero es justo lo que queríamos ver.
| Qué medimos | Resultado |
|---|---|
| Tamaño del fichero de memoria, tras el chat corto y tras la nota larga | 41.944.024 bytes las dos veces |
| Guardar el fichero | 0,66 a 1,02 s |
| Cargarlo en una sesión nueva | 1,35 a 1,99 s |
| Respuestas cortas tras la recarga | 1,55 a 2,45 s |
| Pico de memoria en la tarjeta | unos 66,5 GiB |
El fichero no crece. Ese es todo el truco, y también la razón de que no ahorre disco: el historial de Dana en texto ocupaba 107 tokens, unos cientos de bytes.
Dónde sale a cuenta el fichero
Lo que el fichero puede ahorrar es la relectura. Un modelo que trabaja con la cinta reconstruye en la tarjeta su espacio de trabajo a partir de todo el historial antes de responder, y ese espacio crece con cada token. Según nuestras cuentas, el fichero solo pasa a ser más pequeño que ese espacio de trabajo a partir de unos 2.000 tokens de historial. Con 128K tokens es unas 64 veces más pequeño.
En velocidad, el empate llega mucho más tarde. El paper vio que Nano es más lento con historiales cortos, más o menos igual a 32.000 tokens y unas 1,86 veces más rápido a 128K. No medimos ninguna de las dos cosas: las cifras de tamaño son cuentas nuestras y las de velocidad son del paper. Como un setlist, la libreta se gana su sitio en una gira larga, no en un micro abierto de una sola canción.
A quién le interesa
Si construyes un asistente que acompaña a una persona durante semanas, merece un piloto. Una memoria que puedes pasar de un sitio a otro como un fichero es algo más limpio de gestionar que un montón creciente de transcripciones.
Si tus conversaciones son cortas, olvídate.
Si necesitas detalles exactos de historiales largos, quédate con un almacén de texto. Los propios autores lo dicen. En 11 benchmarks de memoria de su paper, los mejores sistemas de memoria en texto, y simplemente guardar la conversación entera, sacan entre 1,4 y 1,5 veces el 47,0 de Nano. En una prueba de historiales de chat largos, Nano saca 32,6 frente a 76,8 de guardar la conversación completa.
Si tu tarjeta más grande tiene 48 GB, no encontramos forma de hacerlo entrar. MemTensor no publica ninguna versión comprimida. Nuestro intento en 8 bits se quedó sin memoria con un tope de 48 GB en la A100, y con la tarjeta completa el primer "recordar" se cayó.
Si necesitas velocidad, el código de serie es lento hoy: unos 9 a 10 tokens por segundo, y unos 13 segundos para una respuesta de 128 tokens a un turno de "recordar". No instalamos los componentes opcionales más rápidos ni lo ajustamos.
En InferenceKey, el modelo funciona como custom backend, un pequeño wrapper en Python alrededor del código de los autores en tu máquina con GPU. Queda detrás de un endpoint de chat estándar con un campo extra que dice recordar, preguntar, guardar, cerrar o cargar. Con los 70,3 GB de pesos ya en disco, un reinicio estaba listo en 20 segundos.
El límite, sin rodeos: nuestras nueve preguntas eran datos cortos que acababan de contarle al modelo, a un usuario cada vez, así que demuestran que guardar y recargar funciona, no que recuerde a lo largo de meses de memorias nuevas.
Lee la prueba completa de MemT-1.0-Nano en nuestro post de Research, con todos los tiempos, la escalera de memoria y el ejemplo de despliegue.