WeVisOne-VL-4B hace siete trabajos de visión en una sola tarjeta de 16 GB, y su motor rápido contó mal un tablero de ajedrez
WeVisOne-VL-4B de Tencent encuadró, contó, leyó y recortó en una RTX 5080 real de 16 GB en nuestra prueba, y recortó en un segundo en una RTX 4090.
Una función de visión en un producto suele ser tres modelos en fila: uno dibuja recuadros alrededor de lo que nombras, otro convierte cada recuadro en un contorno y un tercero hace un recorte limpio que respeta el pelo. El nuevo WeVisOne-VL-4B de Tencent hace todo eso en un solo modelo abierto de 4B parámetros, y lo ejecutamos en nuestra nube para ver si es verdad. Lo es. En una RTX 5080 real de 16 GB superó las 14 peticiones de nuestra prueba, repartidas en siete tipos de trabajo, con un pico de 12,8 GiB en la tarjeta. En una RTX 4090, recortar un retrato a resolución completa tardó alrededor de un segundo. Para un equipo que despliega modelos, eso es una descarga, una tarjeta y un endpoint donde antes había tres. La pega: la forma rápida de ejecutarlo contó 15 piezas de ajedrez donde hay 16, así que comprueba sus recuentos antes de fiarte de ellos.
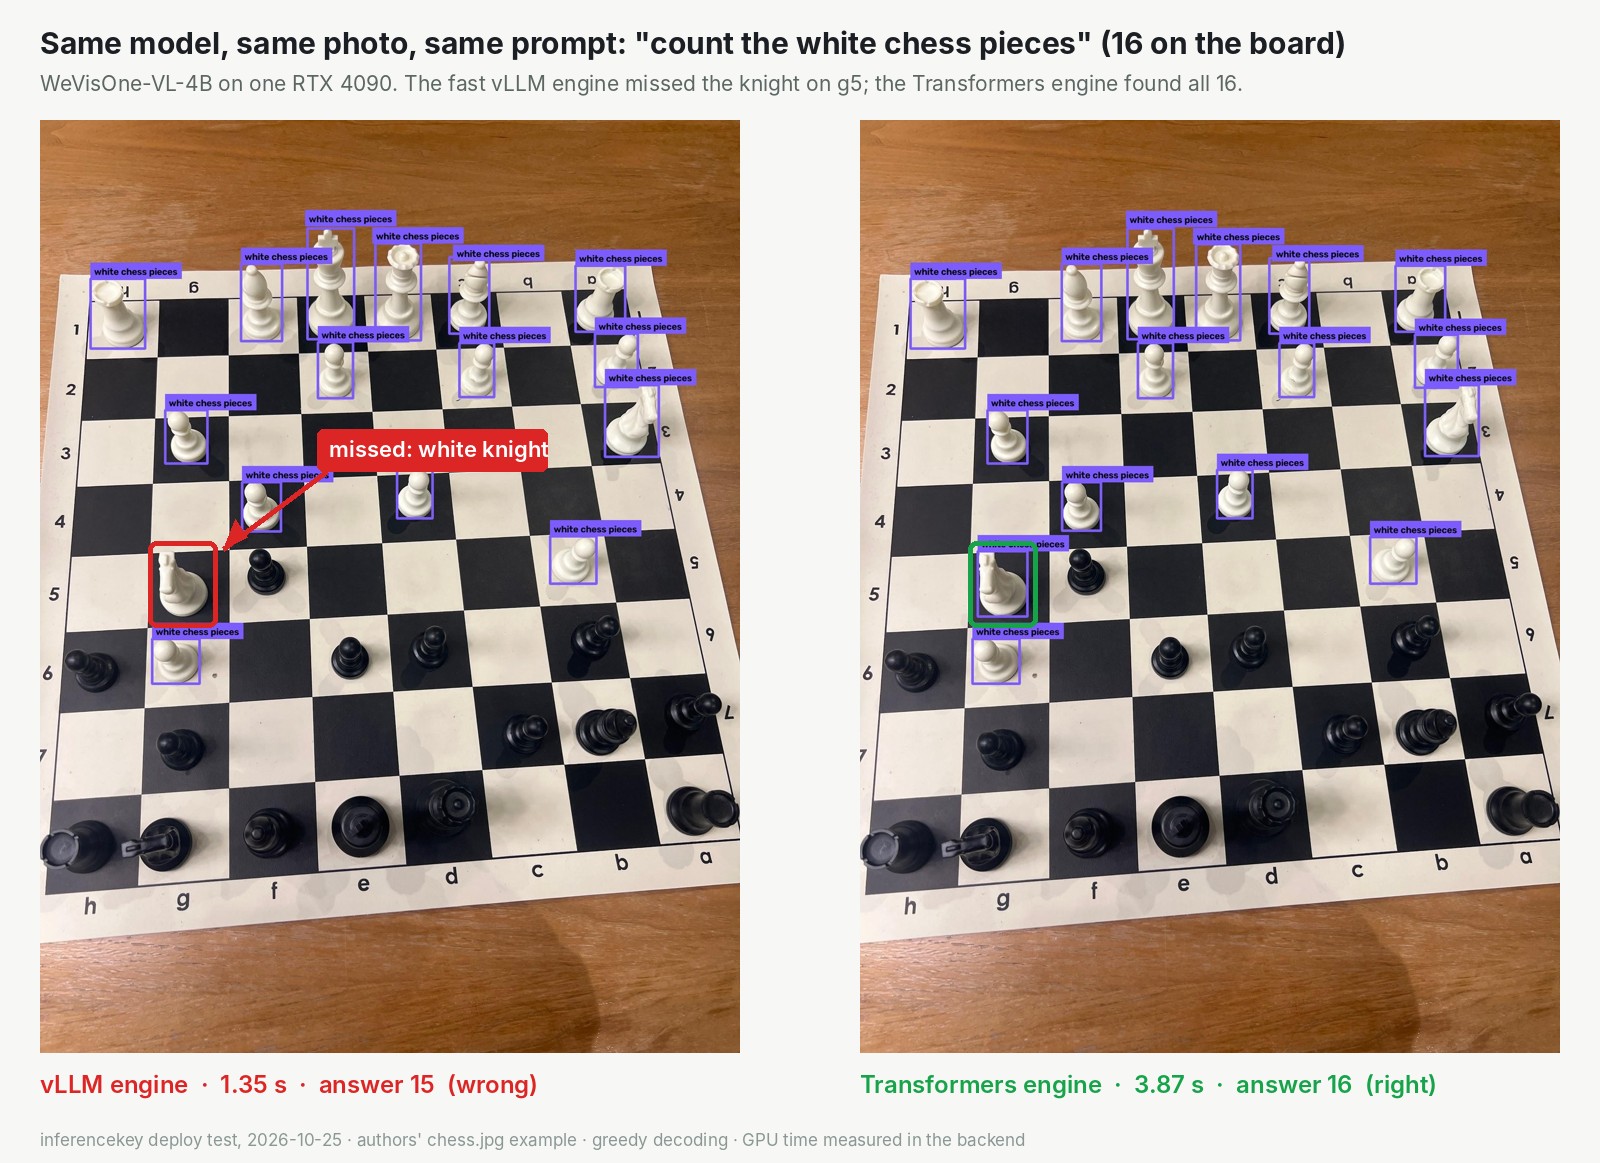
Mismo modelo, misma foto y misma instrucción en una RTX 4090. El motor rápido (izquierda) respondió en 1,35 segundos y se dejó el caballo de g5. El motor de referencia (derecha) tardó 3,87 segundos y contó 16.
Qué es el modelo
WeVisOne-VL ("WeChat Vision All-in-One") viene del equipo WeChat Vision de Tencent y está construido sobre un modelo abierto de Alibaba. Según su ficha, encuentra cualquier cosa que puedas nombrar, o una cosa concreta descrita, como "the cat on the right". También cuenta, señala puntos, lee texto con su posición, dibuja contornos y hace recortes.
El truco es fácil de imaginar. El modelo responde con texto, y una posición en la imagen es simplemente más texto: un recuadro son cuatro palabras especiales y un punto son dos. Para los contornos y los recortes, un recortador aparte y diminuto de 9,6 millones de parámetros, unas 500 veces más pequeño que el modelo, lee lo que vio el modelo y pinta los píxeles. No hay ninguna herramienta de contornos aparte funcionando a su lado.
Los autores dicen que el 4B va en cabeza en más de 30 benchmarks. En su prueba de encontrar objetos nombrados saca 55,3 sobre 100, frente a 38,8 de GroundingDINO, un modelo habitual para dibujar recuadros. Son sus tablas, no una comparación que hayamos hecho nosotros. Los pesos son Apache 2.0, que permite el uso comercial, y la ficha añade que no está pensado para identificar a personas. Esa línea importa si tu producto trabaja con caras.
Lo que encontramos: todo entra en 16 GB, y los dos motores no coinciden
El paquete de código de los autores puede ejecutar el modelo de dos formas: con un motor rápido pensado para servir y con el motor de referencia, el sencillo. Mandamos las mismas 14 peticiones, una imagen cada vez, a cada configuración. Cubrían encontrar varias cosas nombradas, contar, encontrar una cosa descrita (y negarse cuando no está), señalar puntos, leer texto, sacar contornos y recortar.
| Trabajo | RTX 4090, rápido | RTX 5080 16 GB, referencia |
|---|---|---|
| Recortar a una persona, 1620 x 1080 | 1,0 s | 2,1 s |
| Encontrar "the cat on the right" | 0,21 s | 0,68 s |
| Contar 12 personas | 0,78 s | 2,8 s |
| Pico de memoria en la tarjeta (GiB) | 23,0 | 12,8 |
El motor rápido es unas tres veces más rápido en la mayoría de los trabajos con objetos, pero carga el modelo dos veces y necesita una tarjeta de 24 GB. El motor de referencia se quedó en un pico de 12,3 GiB en esa misma tarjeta, así que la tarjeta de 24 GB es una elección por velocidad, no un requisito.
La velocidad trajo una respuesta equivocada. Los dos motores usaron decodificación greedy, así que el fallo del tablero no es ruido del muestreo. Los motores también discreparon en un cartel de la calle (29 palabras leídas frente a 21) y en unas ollas y sartenes colgadas (19 frente a 20). Un fallo en 14 peticiones no es una tasa. Es un motivo para hacer la prueba de sonido en el equipo con el que vas a tocar: prueba tus propias imágenes en el motor que vas a poner en producción.
Un resultado que nos gustó: cuando le pedimos "the dog" en una foto de gatos, respondió que no había ninguno, en todas las configuraciones que probamos. Un detector que se inventa un perro es justo el fallo que hace que un equipo de producto deje de confiar en la función.
A quién le interesa
Si hoy pones en producción detección, contornos o recortes, aquí tienes un modelo en una tarjeta haciendo trabajos que normalmente necesitan una cadena. Si tienes una tarjeta de 16 GB, todas las tareas funcionaron en una RTX 5080 real. Si necesitas recuentos correctos, usa el motor de referencia o comprueba antes el rápido con tus propias imágenes. Si necesitas velocidad, una tarjeta de 24 GB con el motor rápido dio recortes en un segundo y búsquedas por debajo del segundo, después de una petición de calentamiento: la primera detección tras arrancar tardó unos 15 segundos.
En nuestra plataforma funciona como custom backend, un pequeño programa en Python que ejecutamos en tu máquina con GPU en lugar de un servidor de modelos estándar, porque el recortador queda fuera de lo que devuelve un servidor estándar. Una RTX 5080 recién arrancada que nunca había visto el modelo ya respondía a los 87 segundos, descarga incluida.
El límite, sin rodeos: mandamos una petición cada vez con imágenes sueltas, y con un tope de memoria emulado estricto de 12 GB fallaron todos los contornos y recortes, así que por debajo de 16 GB cuenta solo con recuadros y texto.
Lee la prueba completa de WeVisOne-VL-4B en nuestro post de Research, con la escalera de memoria, todos los tiempos y el ejemplo de despliegue.