WeVisOne-VL-4B erledigt sieben Bildaufgaben auf einer 16-GB-Karte, und seine schnelle Engine hat sich bei einem Schachbrett verzählt
Tencents WeVisOne-VL-4B fand, zählte, las und stellte frei, im Test auf einer echten RTX 5080 mit 16 GB; ein Freisteller auf einer RTX 4090 dauerte 1 s.
Eine Bildfunktion in einem Produkt besteht oft aus drei Modellen hintereinander: Eines zeichnet Kästen um die Dinge, die Sie benennen, eines macht aus jedem Kasten eine Kontur, und eines erstellt einen sauberen Freisteller, der die Haare behält. Tencents neues WeVisOne-VL-4B erledigt das alles in einem offenen Modell mit 4 Milliarden Parametern, und wir haben es in unserer Cloud laufen lassen, um zu sehen, ob das hält. Es hält. Auf einer echten RTX 5080 mit 16 GB hat es alle 14 unserer Anfragen über sieben Arten von Aufgaben bestanden, mit einer Spitze von 12,8 GiB auf der Karte. Auf einer RTX 4090 dauerte ein Freisteller eines Porträts in voller Auflösung etwa eine Sekunde. Für ein Team, das Modelle deployt, heißt das: ein Download, eine Karte und ein Endpoint, wo es vorher drei waren. Der Haken: Die schnelle Art, es auszuführen, zählte 15 Schachfiguren, wo 16 stehen. Prüfen Sie also seine Zählungen, bevor Sie ihnen vertrauen.
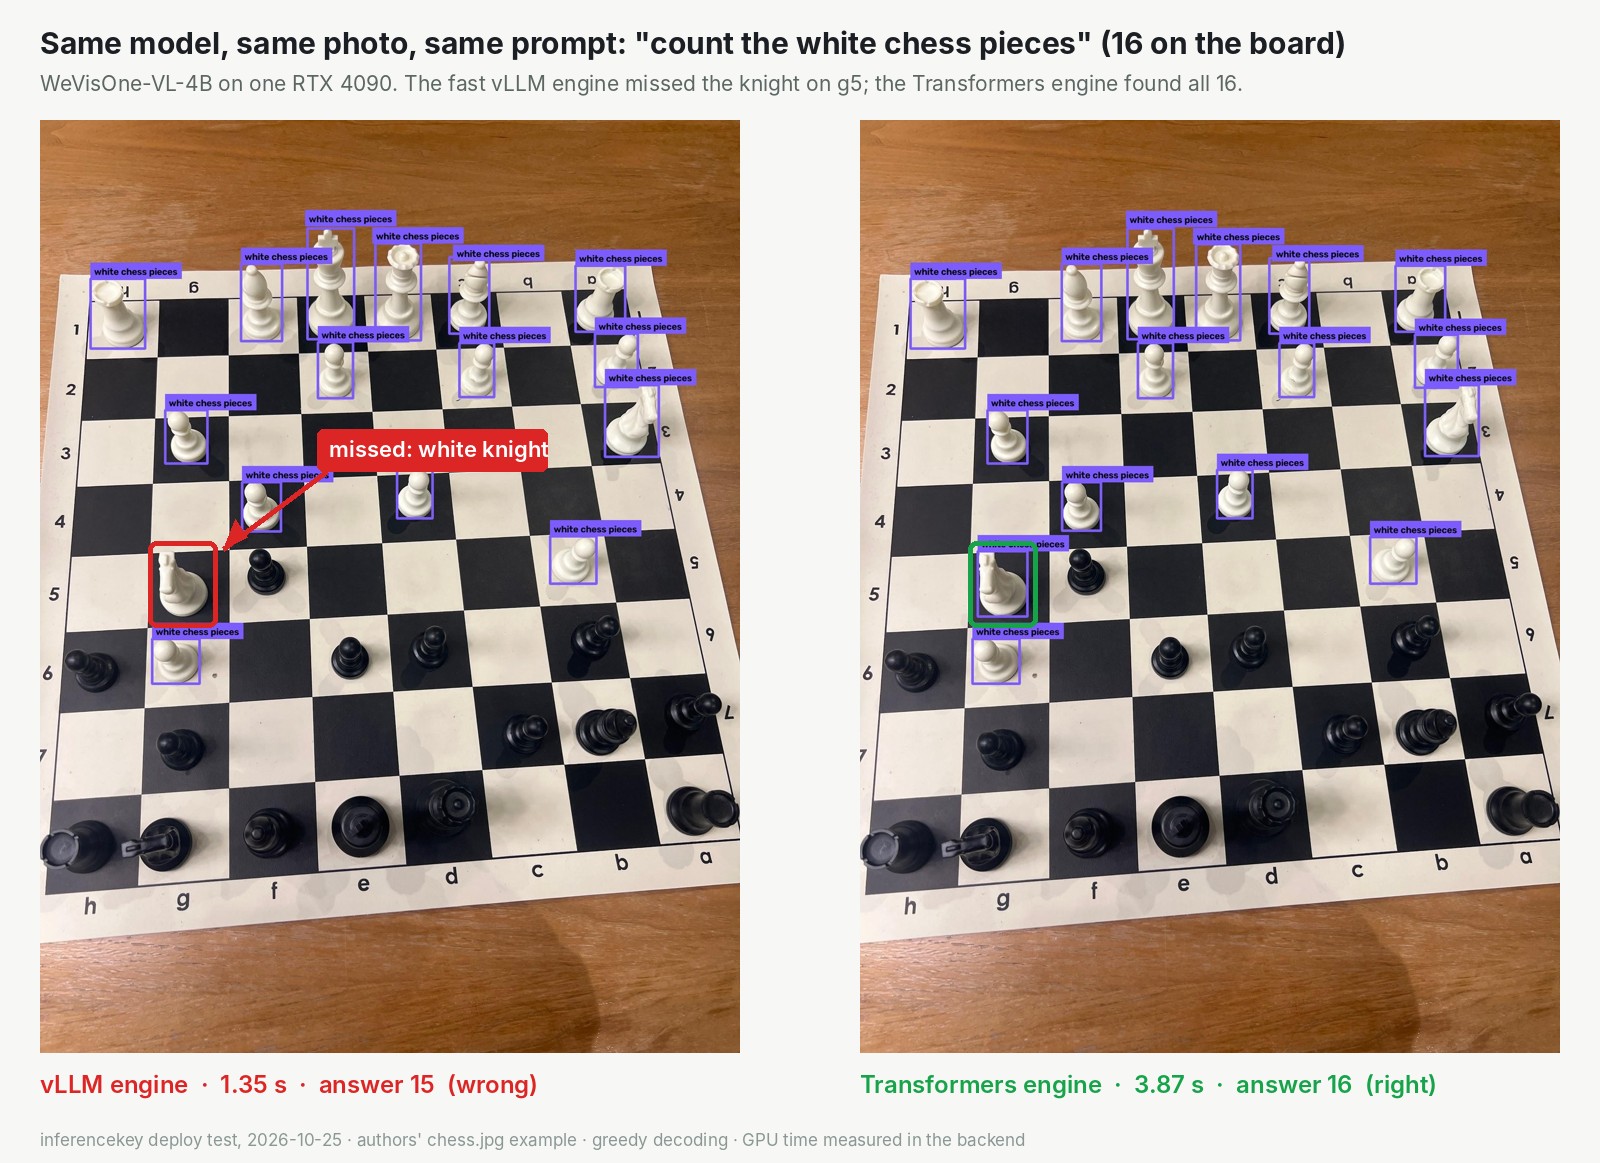
Gleiches Modell, gleiches Foto und gleiche Anweisung auf einer RTX 4090. Die schnelle Engine (links) antwortete in 1,35 Sekunden und übersah den Springer auf g5. Die Referenz-Engine (rechts) brauchte 3,87 Sekunden und kam auf 16.
Was das Modell ist
WeVisOne-VL ("WeChat Vision All-in-One") stammt vom WeChat-Vision-Team bei Tencent und baut auf einem offenen Modell von Alibaba auf. Laut seiner Model Card findet es alles, was Sie benennen können, oder ein einzelnes beschriebenes Ding wie "the cat on the right". Außerdem zählt es, zeigt auf Stellen, liest Text mitsamt Position, zeichnet Konturen und erstellt Freisteller.
Der Trick ist leicht vorstellbar. Das Modell antwortet in Text, und eine Position im Bild ist einfach weiterer Text: Ein Kasten sind vier spezielle Wörter, ein Punkt zwei. Für Konturen und Freisteller liest ein winziger separater Schneider mit 9,6 Millionen Parametern, etwa 500-mal kleiner als das Modell, was das Modell gesehen hat, und malt die Pixel. Daneben läuft kein eigenes Konturwerkzeug.
Die Autoren melden, dass das 4B-Modell bei mehr als 30 Benchmarks vorne liegt. In ihrem Test zum Finden benannter Objekte erreicht es 55,3 von 100, gegenüber 38,8 für GroundingDINO, ein verbreitetes Modell zum Zeichnen von Kästen. Das sind ihre Tabellen, kein direkter Vergleich, den wir gefahren haben. Die Gewichte stehen unter Apache 2.0, das kommerzielle Nutzung erlaubt, und die Model Card ergänzt, dass es nicht dafür gedacht ist, Personen zu identifizieren. Dieser Satz ist wichtig, wenn Ihr Produkt mit Gesichtern arbeitet.
Was wir gefunden haben: alles passt auf 16 GB, und die zwei Engines sind sich uneinig
Das Code-Paket der Autoren kann das Modell auf zwei Arten ausführen: mit einer schnellen Engine, die fürs Serving gebaut ist, und mit der schlichten Referenz-Engine. Wir haben dieselben 14 Anfragen, ein Bild nach dem anderen, an jedes Setup geschickt. Sie deckten das Finden mehrerer benannter Dinge ab, Zählen, das Finden eines beschriebenen Dings (und das Ablehnen eines nicht vorhandenen), Zeigen, Text lesen, Konturen und Freisteller.
| Aufgabe | RTX 4090, schnell | RTX 5080 16 GB, Referenz |
|---|---|---|
| Eine Person freistellen, 1620 x 1080 | 1,0 s | 2,1 s |
| "the cat on the right" finden | 0,21 s | 0,68 s |
| 12 Personen zählen | 0,78 s | 2,8 s |
| Spitze Kartenspeicher (GiB) | 23,0 | 12,8 |
Die schnelle Engine ist bei den meisten Objektaufgaben etwa dreimal schneller, aber sie hält das Modell doppelt und braucht eine Karte mit 24 GB. Die Referenz-Engine kam auf derselben Karte auf eine Spitze von 12,3 GiB, die 24-GB-Karte ist also eine Entscheidung für Geschwindigkeit, keine Voraussetzung.
Die Geschwindigkeit kam mit einer falschen Antwort. Beide Engines nutzten Greedy Decoding, der Fehler beim Schachbrett ist also kein Sampling-Rauschen. Die Engines unterschieden sich außerdem bei einem Straßenschild (29 gelesene Wörter gegenüber 21) und bei hängenden Töpfen und Pfannen (19 gegenüber 20). Ein Fehler in 14 Anfragen ist keine Quote. Es ist ein Grund, den Soundcheck auf der Anlage zu machen, über die Sie wirklich spielen werden: Testen Sie Ihre eigenen Bilder auf der Engine, die Sie ausliefern.
Ein Ergebnis hat uns gefallen: Nach "the dog" auf einem Foto von Katzen gefragt, antwortete es, dass es keinen gibt, in jedem Setup, das wir laufen ließen. Ein Detektor, der einen Hund erfindet, ist genau der Bug, nach dem ein Produktteam der Funktion nicht mehr traut.
Für wen es interessant ist
Wenn Sie heute Erkennung, Konturen oder Freisteller ausliefern, ist das hier ein Modell auf einer Karte für Aufgaben, die normalerweise eine Kette brauchen. Wenn Sie eine Karte mit 16 GB haben: Jede Aufgabe lief auf einer echten RTX 5080. Wenn Sie Zählungen brauchen, die stimmen, nehmen Sie die Referenz-Engine oder prüfen Sie die schnelle vorher mit Ihren eigenen Bildern. Wenn Sie Geschwindigkeit brauchen, lieferte eine 24-GB-Karte mit der schnellen Engine Freisteller in einer Sekunde und Funde in unter einer Sekunde, nach einer Aufwärmanfrage: Die allererste Erkennung nach einem Start dauerte etwa 15 Sekunden.
Auf unserer Plattform läuft es als Custom Backend, ein kleines Python-Programm, das wir auf Ihrer GPU-Maschine statt eines Standard-Modellservers ausführen, weil der Schneider außerhalb dessen liegt, was ein Standard-Server zurückgibt. Eine frische RTX 5080, die das Modell nie gesehen hatte, antwortete nach 87 Sekunden, Download inklusive.
Die ehrliche Grenze: Wir haben eine Anfrage nach der anderen mit einzelnen Bildern geschickt, und unter einer strikt emulierten Speichergrenze von 12 GB schlug jede Kontur und jeder Freisteller fehl. Planen Sie unter 16 GB also nur mit Kästen und Text.
Den vollständigen Test von WeVisOne-VL-4B lesen Sie in unserem Research-Beitrag, mit der Speicherleiter, jeder Zeitmessung und dem Deployment-Beispiel.