Limite 1B löste 27 von 30 Wettbewerbsaufgaben in Mathe auf einer RTX 4090, solange Sie es nur Mathe fragen
Paradigmas 2,1-GB-Mathemodell löste 27 von 30 AIME-2026-Aufgaben mit je einem Versuch auf einer RTX 4090 und lief auch auf einer 16-GB-Karte.
Die Datei ist 2,1 GB groß. Die Prüfung ist AIME 2026, der amerikanische Einladungswettbewerb für die besten Schülerinnen und Schüler der Oberstufe. Wir haben Limite 1B Violetto, dem neuen Mathemodell von Paradigma, alle 30 Aufgaben auf einer RTX 4090 in unserer Cloud gegeben, mit je einem Versuch. 27 waren richtig. Auch eine echte Workstation-Karte mit 16 GB hat es geschafft. Wenn Sie Modelle deployen, heißt das: Mathe auf Wettbewerbsniveau braucht keine große Karte mehr. Wer alle 30 Aufgaben auf einmal laufen lässt, zahlt für den ganzen Durchgang etwa 22 Euro-Cent GPU-Zeit. Das Modell steht unter Apache 2.0, Sie dürfen es also in ein Produkt einbauen. Der Haken ist genauso klar: Es kann Mathe und nur Mathe, eine Frage pro Unterhaltung, und es denkt vor jeder Antwort lange nach. Wenn Sie einen Stapel Aufgaben mit je einem Endergebnis haben, lohnt sich ein Versuch.
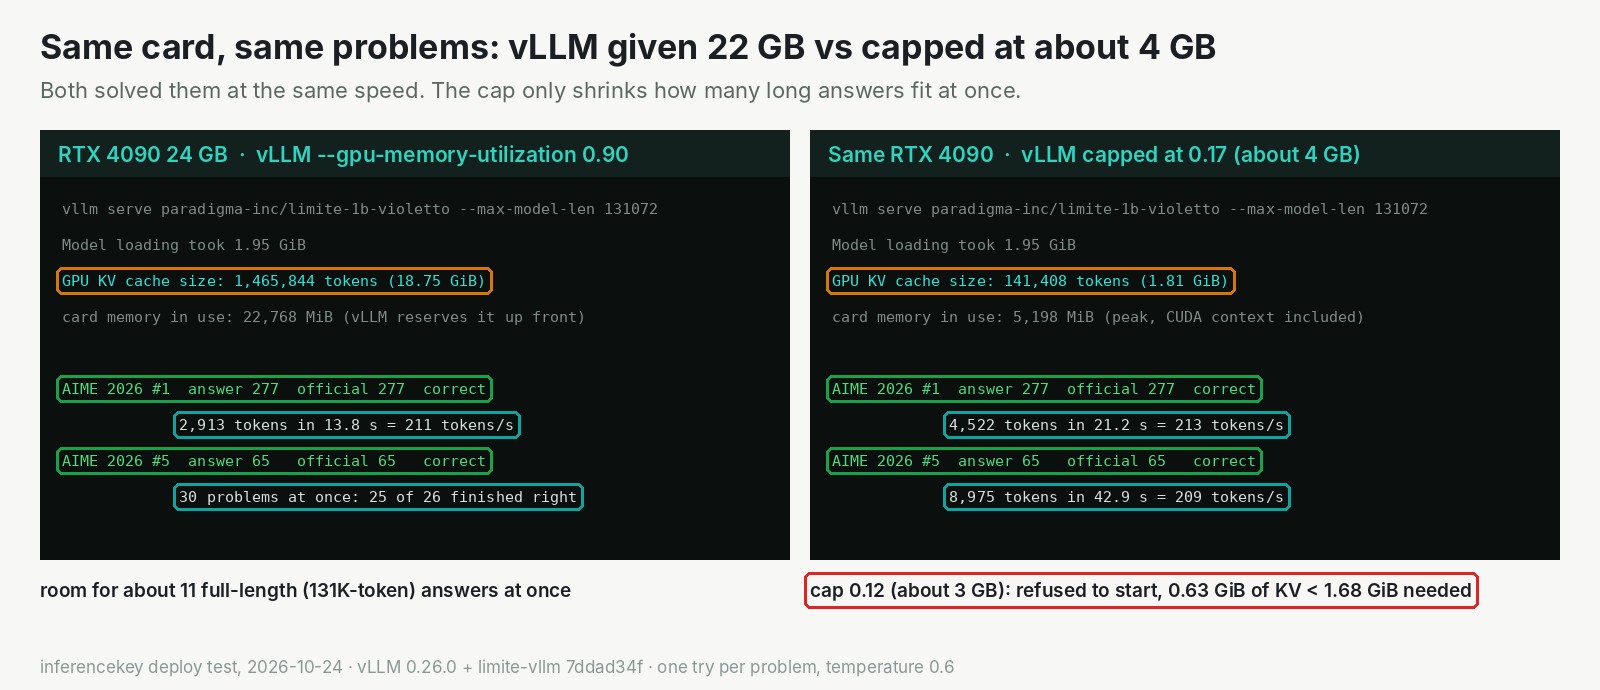
Gleiche Karte, gleiche Aufgaben. Eine kleinere Speichergrenze hat keine Antwort langsamer gemacht; sie verringert nur, wie viele lange Antworten gleichzeitig hineinpassen.
Ein kleines Modell mit einer Aufgabe
Limite 1B Violetto ist das erste Modell von Paradigma. Es hat etwa eine Milliarde Parameter, also die Zahlen, die ein Modell im Training lernt, und das Team hat es in rund sechs Wochen von Grund auf trainiert. In Paradigmas eigener Tabelle erreicht es 94,01 % bei AIME 2026. Die zentrale Behauptung betrifft einen zweiten Satz Wettbewerbsaufgaben, BeyondAIME: Dort meldet es 74,25 % gegenüber 70 % für MUSE-Glimmer-30B, ein Modell, das dreißigmal so groß ist.
Ganz oben steht es in dieser Tabelle nicht überall. BeyondAIME ist der einzige seiner sieben Tests, bei dem es den höchsten gemeldeten Wert hat. Es ist nicht das beste Mathemodell, das es gibt. Es ist ein sehr kleines Modell zwischen Modellen, die zigmal größer sind, und gerade weil es so klein ist, lässt es sich billig überprüfen.
Die Anerkennung gehört den Leuten, die es gebaut haben: Prignano, Cirillo, Morosini, Cerovaz, Bartolocci, Rodolà, Starace und Pappone. Sie haben die Gewichte unter Apache 2.0 zusammen mit ihrem Evaluationscode veröffentlicht und ein Plugin geschrieben, damit vLLM, das Open-Source-Programm, das Modelle bereitstellt, es ausführen kann. Die Aufgaben, die wir bewertet haben, stammen von MathArena. Auf Limite sind wir in einem News-Video von AI Search gestoßen. Unser Teil war, das Plugin so zu verpacken, dass es sich deployen lässt, es auf zwei Karten laufen zu lassen und jede Antwort zu bewerten.
27 von 30 mit einem Versuch, damit liegt es in Paradigmas Bereich
Wir haben Paradigmas Evaluations-Setup übernommen: dieselben 30 Aufgaben in der Version des Datensatzes, die ihr Evaluator festschreibt, dieselbe Anweisung, dieselben Sampling-Einstellungen, dasselbe Schreibbudget von knapp 127.000 Tokens. Unser Skript hat die letzte eingerahmte Antwort mit der offiziellen verglichen.
| Ergebnis | Aufgaben |
|---|---|
| Richtig | 27 |
| Falsch | 2 (#9 und #15) |
| Keine Antwort | 1 (#28 brach nach etwa 111.000 Tokens mitten im Satz ab) |
Das sind 90 % in einem einzigen Durchgang. Paradigmas 94,01 % sind ein Mittelwert über 32 Versuche pro Aufgabe, unsere Zahl bestätigt also den Bereich, nicht die Nachkommastelle.
Vor jeder Antwort stehen Seiten voller Rechenweg
Ein Modell wie dieses rechnet auf dem Papier, so wie Sie es tun würden. Es probiert einen Ansatz, prüft ihn, geht zurück und probiert einen anderen, und Sie warten auf jedes einzelne Wort davon. Die kürzeste richtige Antwort brauchte 3.203 Tokens. Die längste etwa 101.000. Die Hälfte der Aufgaben kam mit weniger als etwa 21.000 aus.
Allein läuft eine Antwort auf der 4090 mit etwa 211 Tokens pro Sekunde. Eine typische Aufgabe dauert trotzdem unter zwei Minuten, die längste acht. Auf der RTX 2000 Ada mit 16 GB lief es 2,5-mal langsamer, mit denselben zwei Testaufgaben richtig.
Man nutzt es also am besten im großen Stapel. Mit allen 30 Aufgaben auf einmal schrieb die 4090 in der Spitze etwa 17-mal schneller als bei einer einzelnen Antwort. Der ganze Stapel dauerte 16 Minuten, offen gehalten von der einen längsten Antwort. Bei etwa 0,80 Euro pro Stunde für die Karte waren das etwa 22 Euro-Cent für 25 richtige Antworten, weniger als ein Euro-Cent pro gelöster Aufgabe. Gezählt ist nur die Zeit, in der die Karte beschäftigt war, nicht Start- oder Leerlaufzeit.
Es macht aus allem Mathe
Limite beantwortet eine Mathefrage pro Unterhaltung, mit einer festen Eröffnungsanweisung. Sein Eingabeformat lehnt eine eigene Eröffnungsanweisung oder Tools ab. Fragen Sie etwas anderes, antwortet es trotzdem mit Mathe. In Paradigmas eigenem Blog kam auf "What is photosynthesis?" eine Aufgabe über sich teilende Zellen zurück. Bei einem Mathemodell ist das charmant, für alles andere ein K.-o.-Kriterium. Es ist kein Chat-Assistent und kein Tool für einen Agenten.
Unser Deployment-Code verwirft jede Eröffnungsanweisung, die nicht die Standardanweisung ist, damit eine App, die für ein Chat-Modell gebaut wurde, ihre Anfrage nicht abgelehnt bekommt.
Für wen es interessant ist
- Teams, die ausgearbeitete Lösungen für Wettbewerbsaufgaben mit einem Endergebnis brauchen: lohnt sich. Prüfen Sie die eingerahmte Antwort, bevor Sie ihr vertrauen.
- Teams mit einer kleinen Karte: Eine echte Karte mit 16 GB hat funktioniert, und mit vLLM auf etwa 4 GB der 4090 begrenzt waren zwei kurze Aufgaben trotzdem richtig. Echte Karten mit 8 GB und 12 GB haben wir nicht ausprobiert.
- Alle, die schnelle Antworten für eine einzelne Person, einen Chat-Assistenten oder Tools brauchen: Suchen Sie woanders.
Auf InferenceKey lief es als Custom Backend, eine kurze Python-Datei, die genau die Versionen installiert, die Paradigma verifiziert hat, und vLLM mit ihrem Plugin startet. Mit allem schon auf der Karte war ein Neustart in 31 Sekunden bereit. Eine Baustelle ist noch offen: Unser veröffentlichtes SDK kann noch keine Chat-Anfragen beantworten, und den Workaround bis zum nächsten Release finden Sie im Research-Beitrag.
Die ehrliche Grenze: Wir haben einen Versuch pro Aufgabe bewertet, und zwar auf einem Satz, der schon vor dem Training öffentlich war. Das passt zu Paradigmas Zahl, ist aber kein Beweis, dass das Modell mit Mathe zurechtkommt, die es nie gesehen hat.
Den vollständigen Test mit der Speicherleiter, der Länge jeder Antwort und den Schritten fürs Deployment lesen Sie in unserem Research-Beitrag.